

Python数据分析初学者常犯的5个错误及纠正方法

for index, row in df.iterrows(): 循环代码去计算折扣金额。终端的光标闪烁了十多分钟仍未结束,中途还弹出了刺眼的 SettingWithCopyWarning 警告;最终模型输出的结果极佳,但在新数据上预测时准确率却断崖式下跌。这并非算法失效,而是掉入了初学者极易踩中的编码陷阱。本文将直接聚焦初学者在数据处理与分析全流程中最常犯的 5 个典型错误,剖析底层成因并给出标准规范的纠偏方案。
错误一:用原生循环遍历逐行处理 DataFrame
初学者从 Python 基础语法转向 Pandas 时,往往习惯保留 for 循环思维。面对批量数值运算、条件赋值或字符串清洗时,常使用 df.iterrows() 或 for i in range(len(df)) 逐行迭代。
这种做法会带来灾难性的性能瓶颈。Pandas 的 DataFrame 在底层是由连续的 NumPy 数组(即 C 语言级别内存块)组织的。使用原生 Python 循环遍历时,每一行数据都会被额外打包封装成一个独立的 Pandas Series 对象,触发 Python 解释器的动态类型检查与对象拆箱开销,完全放弃了底层底层的并行指令优化。
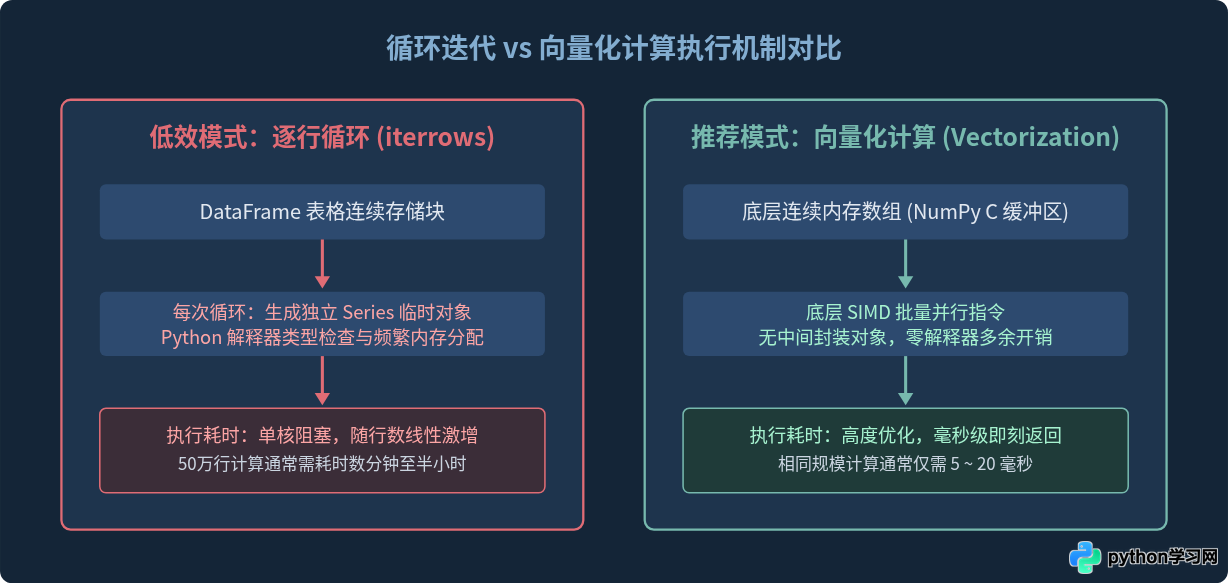
低效代码示例与向量化纠正
import pandas as pd
import numpy as np

# 构造模拟数据(50万行)
df = pd.DataFrame({
    'price': np.random.uniform(10, 500, size=500000),
    'discount': np.random.uniform(0.7, 0.95, size=500000)
})

# 【错误做法】:使用 iterrows 循环逐行计算
# 耗时约 25~40 秒
total_discounted = []
for index, row in df.iterrows():
    total_discounted.append(row['price'] * row['discount'])
df['final_price_bad'] = total_discounted

# 【正确做法】:直接采用整列向量化运算
# 耗时约 2 毫秒,提速超过 10,000 倍
df['final_price_good'] = df['price'] * df['discount']

# 针对复杂多条件分支,使用 np.select 或 np.where 代替循环
conditions = [
    df['price'] > 300,
    df['price'] > 100
]
choices = ['High', 'Medium']
df['level'] = np.select(conditions, choices, default='Low')Series.map() 或基于 NumPy 数组操作,尽可能避免对整个 DataFrame 调用无限制的单行迭代。
错误二:忽略数据类型的隐式推断与内存管理
使用 pd.read_csv() 读取外部数据时,Pandas 会尝试自动推断每列的数据类型。如果某些数字字段中夹杂了缺失标记(如 "N/A" 或全角空格),或者包含了未解析的时间字符串,Pandas 就会将其判定为通用的 object 类型。
object 类型本质上存储的是 Python 对象的原生指针,不仅带来 4 到 10 倍的内存浪费,而且后续无法直接进行矢量化数学运算或日期运算,容易在后续调用统计函数时抛出意料之外的类型异常。
典型表现与规范修复
# 【错误表现】:直接读取后未检查数据类型
df = pd.read_csv('sales_data.csv')
print(df.dtypes)
# order_date: object
# revenue: object (因为存在未清洗的特殊字符或脏数据)
# status: object (只有 'Paid', 'Pending', 'Failed' 三种取值)

# 【纠正方法】:显式类型转换与清洗
# 1. 强制解析日期时间格式
df['order_date'] = pd.to_datetime(df['order_date'], errors='coerce')

# 2. 安全转换为数值类型,将非法字符转为 NaN 便于统一处理
df['revenue'] = pd.to_numeric(df['revenue'], errors='coerce')

# 3. 对低基数(少量重复分类)字符串转换为 category 类型,大幅压缩内存
df['status'] = df['status'].astype('category')

# 4. 在读取阶段直接声明主要类型约束
dtypes_spec = {
    'user_id': 'int32',
    'status': 'category'
}
df_optimized = pd.read_csv('sales_data.csv', dtype=dtypes_spec)
错误三:混淆视图与副本,触发 SettingWithCopyWarning
绝大多数初学者都遇到过 SettingWithCopyWarning 警告。这通常发生在使用连续中括号进行链式索引赋值时,例如 df[df['age'] > 30]['score'] = 100。
之所以产生警告,是因为第一个切片 df[df['age'] > 30] 返回的对象在底层可能是原 DataFrame 的一个视图(View),也可能是一个新分配的副本(Copy)。Pandas 无法确认第二次取值赋值是写入了原始数据还是写入了临时对象,从而可能导致赋值彻底丢失或修改了不该修改的数据。
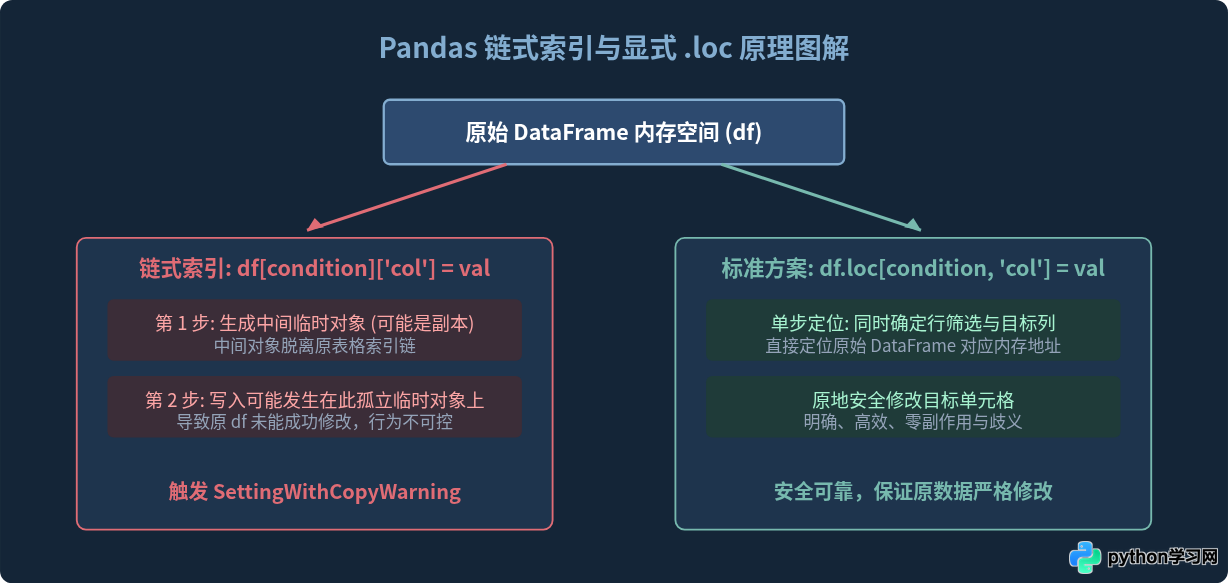
标准修复规范
df = pd.DataFrame({
    'name': ['Alice', 'Bob', 'Charlie'],
    'score': [75, 88, 60]
})

# 【错误写法】:链式索引(产生警告且存在不可预期结果)
# df[df['score'] < 70]['score'] = 70

# 【正确做法一】:在原表上修改,统一使用单一 .loc 访问器
df.loc[df['score'] < 70, 'score'] = 70

# 【正确做法二】:若需要提取子集独立分析,显式调用 .copy()
sub_df = df[df['score'] >= 70].copy()
sub_df.loc[:, 'grade'] = 'Passed'  # 此时对 sub_df 的修改完全独立,不会影响原 df
错误四:机械式处理缺失值(一刀切 dropna 或无脑均值填充)
初学者遇到数据中的 NaN 时,往往采取两种极端的“一刀切”策略:要么开局直接调用 df.dropna() 将所有带缺失的行全部删除,要么不论字段含义统一用整列的均值 df.fillna(df.mean()) 填充。
这种做法对数据质量具有极大的破坏性:
- 样本偏差放大:若数据本身是非完全随机缺失(例如高收入人群更倾向于不填写收入),盲目删除会导致样本严重偏向低收入群体,使分析结论彻底失真。
- 破坏特征方差与相关性:用全局均值填充偏态分布(如长尾分布的消费金额)会人为削弱原始变量的方差,降低特征与标签之间的真实相关系数。
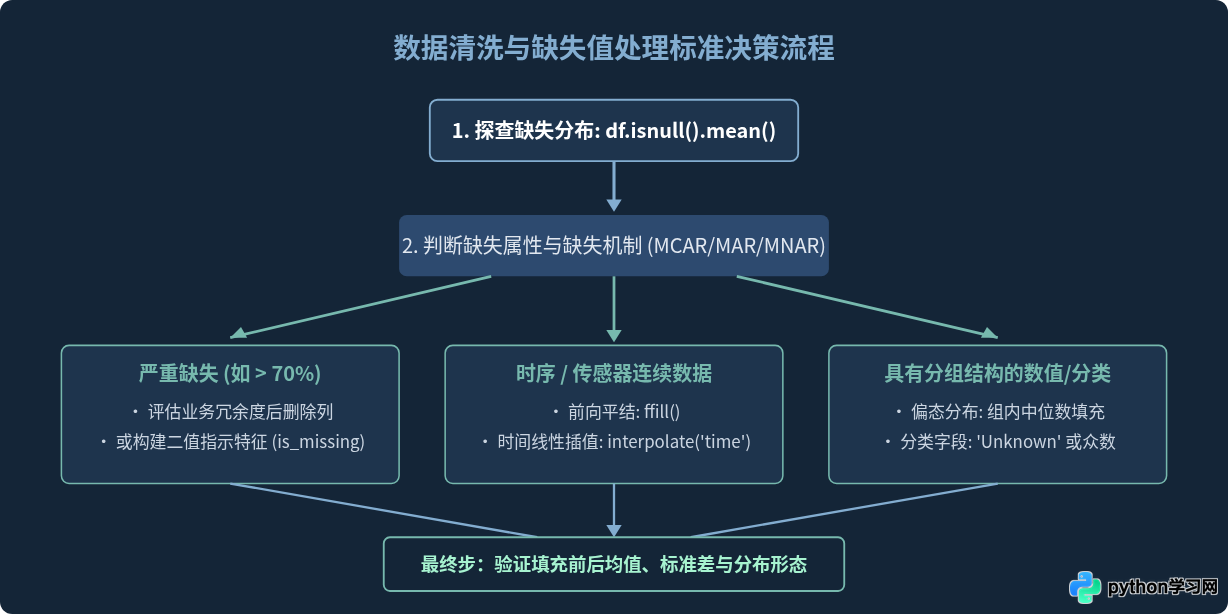
可落地的优雅处理示例
# 1. 结构化诊断每列缺失占比
missing_ratio = df.isnull().mean()
print("高缺失字段(>50%):")
print(missing_ratio[missing_ratio > 0.5])

# 2. 偏态数值特征:使用组内中位数(Group Median)进行细粒度插补
# 例如按不同“城市”和“职位”分别填补“薪水”缺失
df['salary'] = df.groupby(['city', 'job_title'])['salary'].transform(
    lambda x: x.fillna(x.median())
)

# 3. 如果仍有零星无法匹配的组,用全局中位数垫底兜底
df['salary'] = df['salary'].fillna(df['salary'].median())

# 4. 保留缺失信息:创建指示列(Missing Indicator),让下游模型感知“曾有缺失”
df['salary_was_missing'] = df['salary'].isnull().astype(int)
错误五:在数据预处理阶段发生数据泄露(Data Leakage)
数据分析与机器学习建模中最隐蔽却最严重的错误莫过于数据泄露。初学者常在尚未切分训练集与测试集之前,就对全量数据执行标准化(如 StandardScaler)、缺失值统计填充或目标编码。
当我们在全量数据上计算均值和标准差时,测试集的信息(未来分布)就已经悄悄渗透进了特征工程中。这会导致本地交叉验证指标异常虚高,但一旦部署到真实业务环境接收全新数据时,模型效果会严重崩塌。
错误对比与 Pipeline 规范流程
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import Pipeline
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LogisticRegression

# 【错误做法】:先对全量 X 执行预处理,再切分数据
# scaler = StandardScaler()
# X_scaled = scaler.fit_transform(X) # 泄露!测试集均值/方差已被包含在计算内
# X_train, X_test, y_train, y_test = train_test_split(X_scaled, y, test_size=0.2)

# 【正确做法一】:严格先切分,仅在训练集上 fit,在测试集上 transform
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)  # 仅学习训练集参数
X_test_scaled = scaler.transform(X_test)        # 严禁在测试集上调用 fit!

# 【最佳实践】:使用 Scikit-Learn Pipeline 封装,根除泄露隐患
pipeline = Pipeline([
    ('imputer', SimpleImputer(strategy='median')),  # 缺失值中位数填充
    ('scaler', StandardScaler()),                  # 标准化缩放
    ('classifier', LogisticRegression())           # 分类模型
])

# 一键拟合,Pipeline 内部自动保证变换器只在训练集上拟合
pipeline.fit(X_train, y_train)
accuracy = pipeline.score(X_test, y_test)
总结:初学者编写工业级数据分析代码的进阶路径
纠正上述 5 个常见错误的过程,本质上是从“面向语法操作”升级为“面向数据工程”的思维转变。掌握底层运行机制,不仅能让你的数据分析任务运行速度提升数千倍,更能确保每一步分析结论和预测模型的坚实与可信。
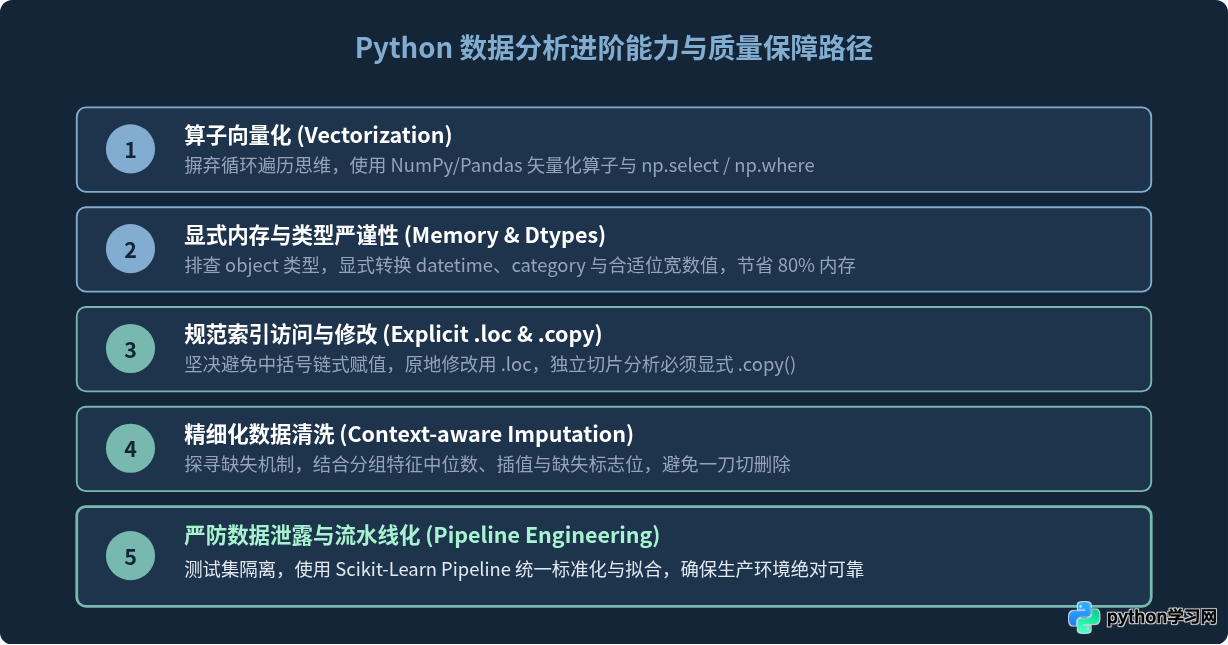
日常自查清单
| 检查项 | 高危信号 | 稳健实践 |
|---|---|---|
| 运算效率 | 出现 for row in df.iterrows(): |
改用矢量运算、np.select 或 Series.map |
| 内存与字段 | 非文本列全部显示为 object |
指定 pd.to_datetime、category 及合适数字位宽 |
| 赋值规范 | 控制台出现 SettingWithCopyWarning |
统一改用 df.loc[mask, col] = val 或 .copy() |
| 缺失处理 | 盲目调用全局 dropna() 或 fillna(mean) |
根据缺失机制分组填补、时序插值并保留缺失指示列 |
| 建模评估 | 切分测试集前先对全量数据执行 scaler.fit() |
严格先划分数据集,使用 Pipeline 串联整个预处理流 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









