

解决Python读取命令行参数时的IndexError与解析错误
深入解析Python读取命令行参数时出现IndexError与解析错误的根本原因,提供轻量脚本的len(sys.argv)长度守卫、异常类型防御及标准库argparse的工业级重构方案。
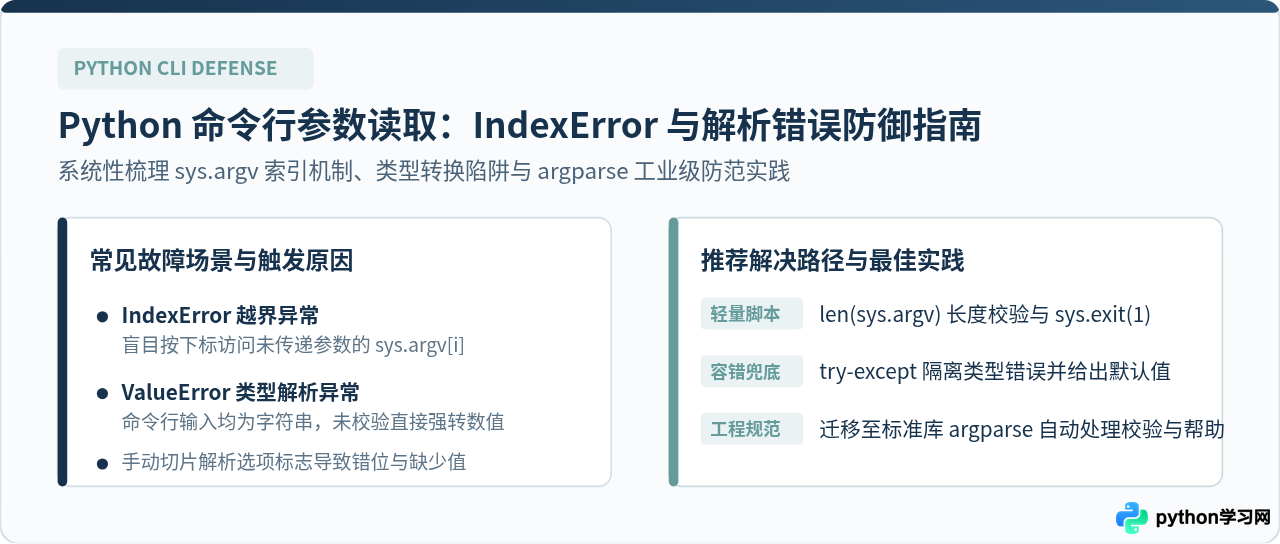
sys.argv 读取命令行参数时,若调用方未传递足够的参数,通过固定索引(例如 sys.argv[1])访问列表就会直接抛出 IndexError: list index out of range;若直接对参数进行类型转换(如 int())或手动切片解析选项标志,则极易引发 ValueError 或错位赋值。针对轻量单文件脚本,解决方式是在访问前严格检查参数列表长度 len(sys.argv),并在缺少参数时输出标准用法提示及非零退出码;对于需要接收多个参数、可选标志(flags)或特定类型的通用工具,规范的解决方式是直接采用 Python 标准库内置的 argparse,由解析器自动管理类型校验、参数缺省值和错误提示。
一、故障重现与根源剖析:为什么直接索引必然触发 IndexError?
很多初学者在编写自动化脚本时,习惯直接导入 sys 模块,并写下如下代码:
import sys

# 尝试获取目标文件名与行数限制
input_filename = sys.argv[1]
limit_count = int(sys.argv[2])

print(f"正在读取文件: {input_filename}, 限制条数: {limit_count}")
当在终端中完整提供参数(如 python faulty_script.py data.csv 100)时,代码能够正常运行。但只要使用者直接在终端运行 python faulty_script.py,终端就会抛出经典错误:
Traceback (most recent call last):
  File "faulty_script.py", line 4, in <module>
    input_filename = sys.argv[1]
IndexError: list index out of range
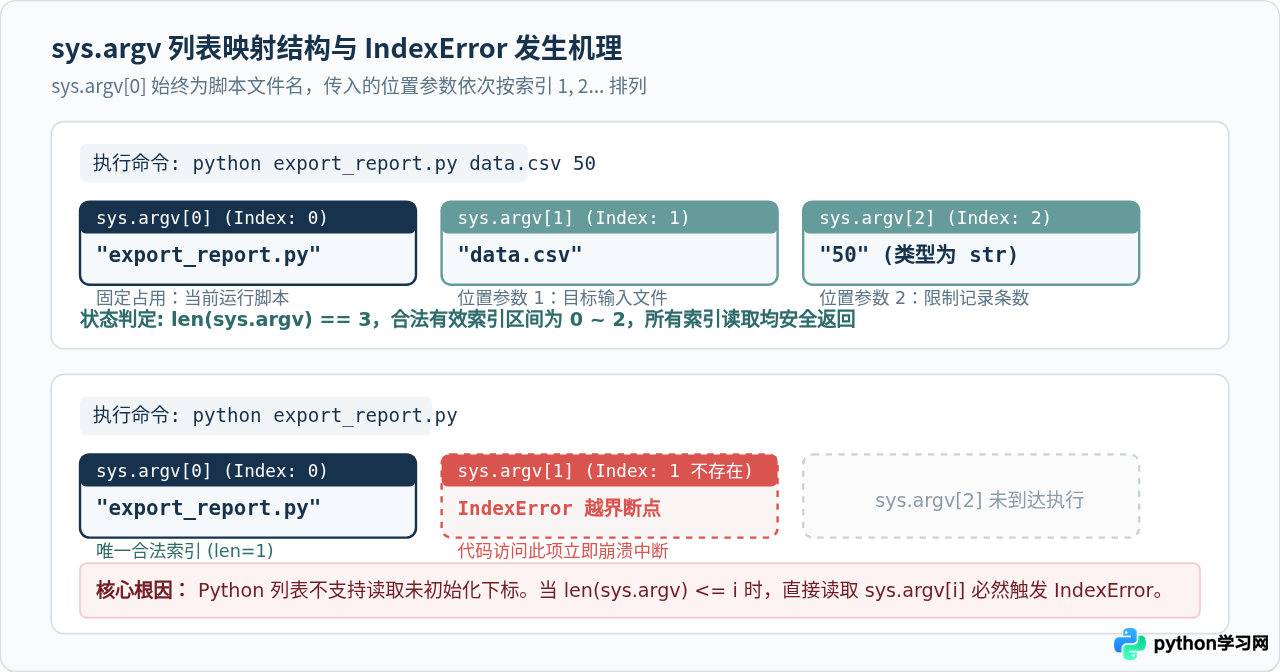
这个报错的根本原因在于 Python 运行时对命令行参数的组织方式:sys.argv 本质上是一个普通的 Python 列表(list)。操作系统在启动 Python 解释器时,会将命令行拆解为字符串填入该列表中:
sys.argv[0]永远存在,它是当前正在运行的 Python 脚本文件名或执行路径。- 后续传入的参数从下标
1开始依次向后追加。 - 在没有附加任何参数直接运行脚本时,
sys.argv列表中只有 1 个元素(即sys.argv[0]),其长度len(sys.argv)为 1。
根据 Python 的列表语法规范,当列表长度为 1 时,唯一合法的正向索引只有 0。此时代码只要尝试读取 sys.argv[1],解释器就会因为索引超出列表实际边界而立即中断并抛出 IndexError。
二、轻量脚本的基础防护:len(sys.argv) 校验与退出码规范
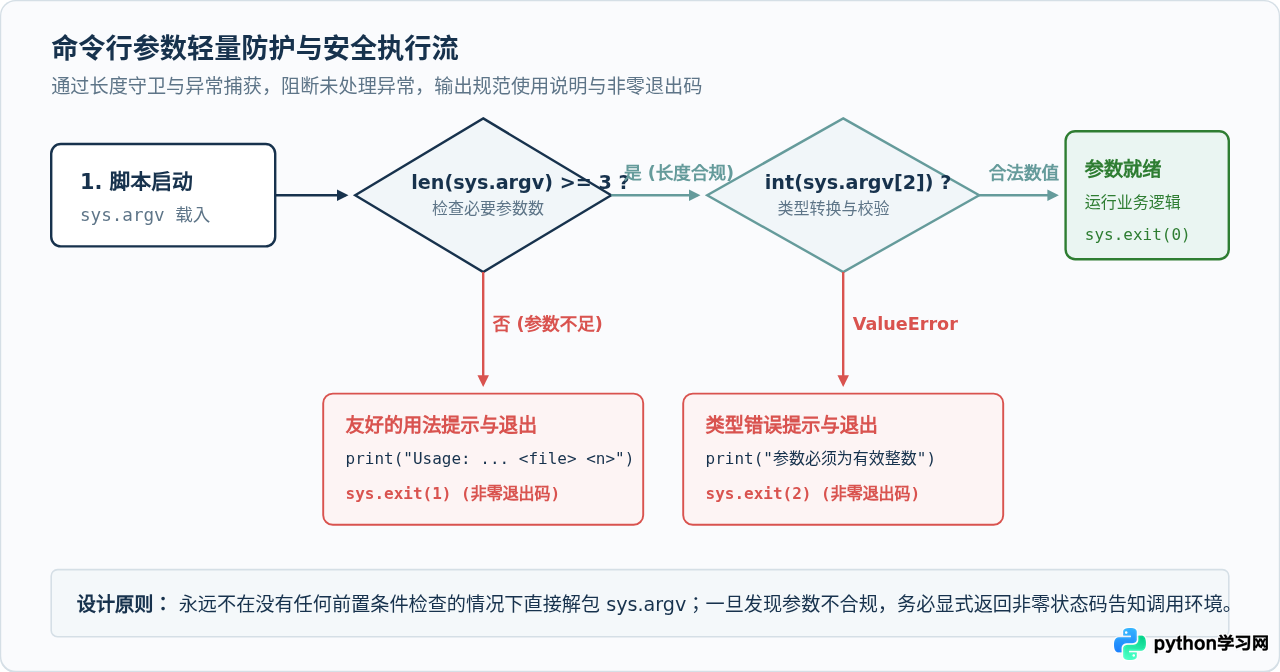
对于只包含一个或两个简单参数、不希望引入复杂解析逻辑的轻量脚本,最直接的防御手段是在解包参数之前,通过判断 len(sys.argv) 设立“参数守卫”(Guard Clause)。
1. 完整的防御实现示例
以下示例展示了如何在读取位置参数前进行前置验证,并在参数缺失时输出清晰的调用指南:
import sys

def main():
    # 期望至少传入 1 个必选文件名,第 2 个参数为可选行数
    # sys.argv[0] 占 1 位,因此至少需要 2 个元素
    if len(sys.argv) < 2:
        print("错误: 缺少必填的目标文件路径参数!", file=sys.stderr)
        print(f"用法: python {sys.argv[0]} <文件路径> [处理行数]", file=sys.stderr)
        print("示例: python safe_argv_script.py ./report.csv 50", file=sys.stderr)
        sys.exit(1)

    # 安全提取必填参数
    input_file = sys.argv[1]

    # 安全处理可选参数:提供默认值并拦截类型转换错误
    limit_count = 100  # 默认处理 100 行
    if len(sys.argv) >= 3:
        try:
            limit_count = int(sys.argv[2])
            if limit_count <= 0:
                print("错误: 处理行数必须为正整数!", file=sys.stderr)
                sys.exit(2)
        except ValueError:
            print(f"错误: 第二个参数 '{sys.argv[2]}' 不是合法的整数!", file=sys.stderr)
            sys.exit(2)

    print(f"开始执行任务 -> 目标文件: {input_file}, 处理条数: {limit_count}")
    # 此处放置核心业务逻辑...

if __name__ == "__main__":
    main()
2. 操作要点与注意事项
- 使用
sys.exit(非零状态码):当参数不合法退出时,必须调用sys.exit(1)或其他非零状态码,切勿直接让函数return。非零退出码能让调用此脚本的 Shell、Makefile 或 CI/CD 流水线敏锐感知到任务失败并及时中断。 - 将错误信息输出到
sys.stderr:使用print(..., file=sys.stderr),确保错误提示与标准业务输出分开,避免管道命令(如python script.py | grep ...)误将报错文本当作正常数据处理。
三、解析错误的成因与应对:类型转换与选项解析陷阱
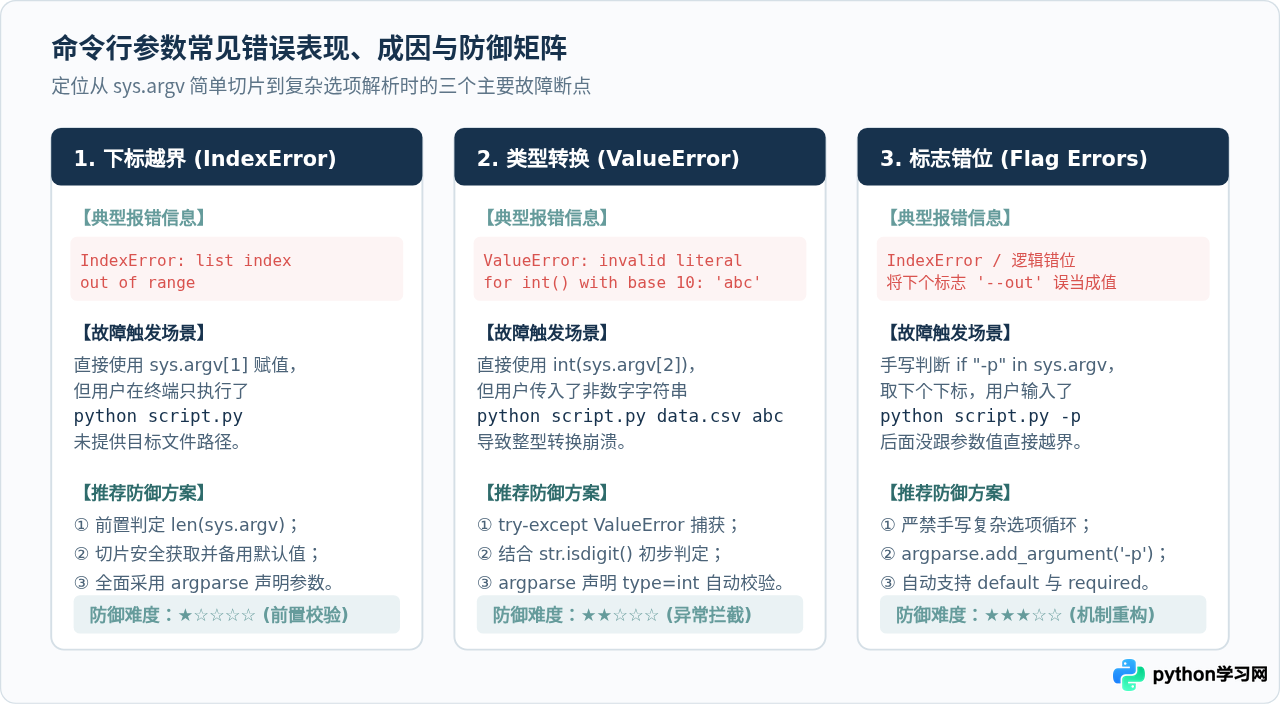
除了下标越界引发的 IndexError 外,命令行输入在进入业务逻辑前还普遍面临“解析错误”(Parsing Errors)。这是由于命令行在操作系统层面是以纯文本字符流传递的。
1. 陷阱一:命令行参数全为字符串(ValueError)
无论在命令行输入数字 100 还是布尔值 True,Python 从 sys.argv 接收到的都是字符串类型('100' 或 'True')。
- 直接执行
int(sys.argv[2]):若使用者输入了python app.py file.txt all,解释器便会抛出ValueError: invalid literal for int() with base 10: 'all'。 - 布尔转换陷阱:直接使用
bool(sys.argv[2])会带来逻辑灾难——在 Python 中,非空字符串bool('False')计算结果依然为True。
2. 陷阱二:手写标志位切片错位
一些脚本需要支持 -o output.csv 或 --verbose 这样的选项。部分开发者尝试使用 sys.argv.index('-o') 手动查找:
# 反面示例:极其脆弱的手写选项检索
if "-o" in sys.argv:
    idx = sys.argv.index("-o")
    # 如果用户在命令结尾输入了 -o 却忘记跟文件名,idx + 1 再次触发 IndexError!
    output_path = sys.argv[idx + 1]
当用户运行 python app.py -o(忘记填写输出文件名)时,idx + 1 超出列表长度,脚本再次以 IndexError 崩溃;或者当用户输入了 python app.py -o --verbose 时,脚本会将下一个选项标志 '--verbose' 错误当作输出路径。
四、规范工程解法:使用标准库 argparse 彻底规避错误
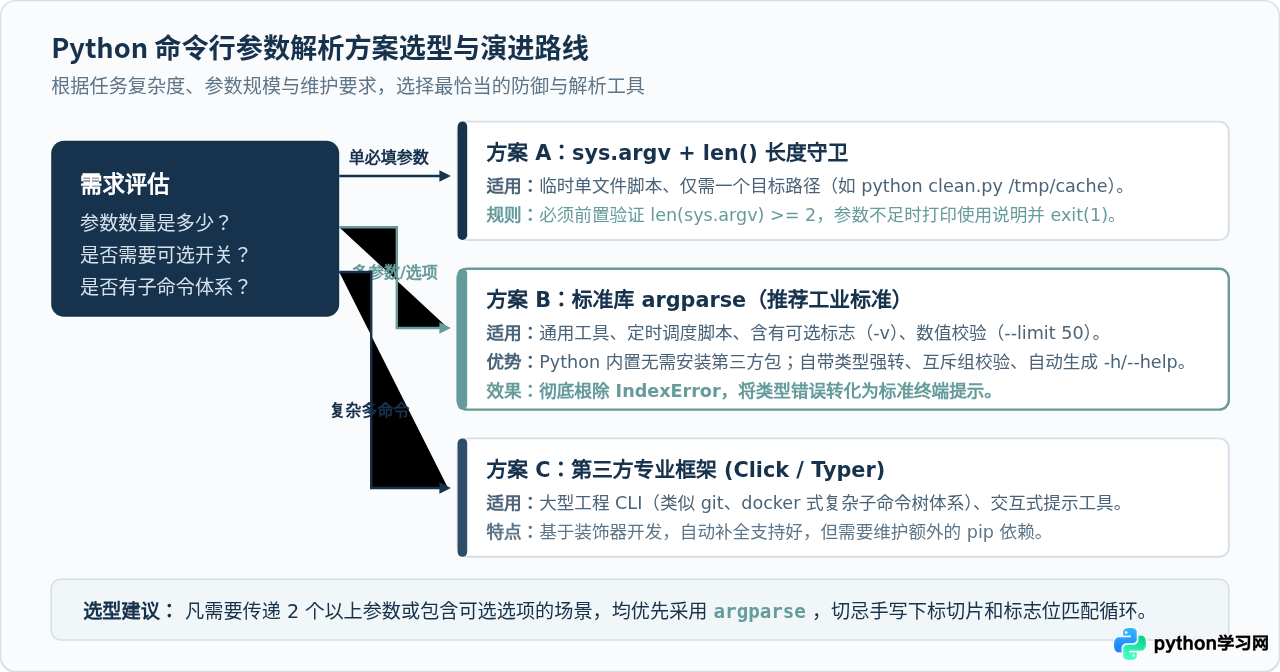
虽然 len(sys.argv) 能够解决极简脚本的越界问题,但随着参数增多(包含必填参数、可选标志、默认值、类型校验),手写校验逻辑会迅速膨胀且极易遗漏边缘情况。Python 标准库自带的 argparse 模块是解决这一问题的工业级标准方案。
1. argparse 为何能彻底根治两类错误
- 告别手动下标与 IndexError:参数通过有语义的属性名访问(如
args.filename),由库底层完成位置和选项的映射,开发者无需接触任何列表索引。 - 自动类型转换与自动报错:通过指定
type=int或type=pathlib.Path,当传入非数字时,argparse会自动向终端输出标准友好的错误说明,并以退出码 2 中断,完全不需要手动编写try-except。 - 免费生成标准帮助信息:当用户输入
-h、--help或传入错误参数时,自动打印完整的参数列表与用法格式。
2. 工业级 argparse 范例实现
import argparse
import sys
import os

def build_parser():
    parser = argparse.ArgumentParser(
        prog="robust_cli",
        description="数据导出与处理脚本,用于批量整理报表数据。",
        epilog="使用遇到问题请联系运维支持团队。"
    )

    # 1. 位置必选参数 (Positional Argument)
    parser.add_argument(
        "input_file",
        metavar="INPUT_FILE",
        type=str,
        help="待处理的输入数据文件路径(例如 ./raw_data.csv)"
    )

    # 2. 可选数值参数 (带类型约束与缺省默认值)
    parser.add_argument(
        "-l", "--limit",
        dest="limit",
        type=int,
        default=50,
        help="限制导出的记录条数,必须为正整数 (默认: 50)"
    )

    # 3. 可选布尔开关 (Flag / Switch)
    parser.add_argument(
        "-v", "--verbose",
        action="store_true",
        help="是否开启详细调试日志输出"
    )

    # 4. 可选字符串选项
    parser.add_argument(
        "-o", "--output",
        dest="output_file",
        default="output.json",
        help="输出结果的目标文件路径 (默认: output.json)"
    )

    return parser

def main():
    parser = build_parser()
    args = parser.parse_args()

    # 业务层附加约束检查
    if args.limit <= 0:
        parser.error("参数 --limit 必须大于 0!")

    if not os.path.exists(args.input_file):
        parser.error(f"指定的文件不存在: {args.input_file}")

    if args.verbose:
        print(f"[DEBUG] 调试模式已开启")
        print(f"[DEBUG] 参数详情: {args}")

    print(f"正在读取: {args.input_file} ...")
    print(f"处理条数: {args.limit}, 输出文件: {args.output_file}")
    print("执行完成。")

if __name__ == "__main__":
    main()
3. 实际运行效果验证
我们可以观察在使用 argparse 重构后,终端在各种异常输入下的优雅表现:
$ python robust_cli.py
usage: robust_cli [-h] [-l LIMIT] [-v] [-o OUTPUT_FILE] INPUT_FILE
robust_cli: error: the following arguments are required: INPUT_FILE
可以看到,程序没有报出刺眼的堆栈崩溃,而是直接提示缺少必选参数 INPUT_FILE 并展示使用语法,退出状态码为标准错误码 2。
$ python robust_cli.py data.csv --limit not_a_number
usage: robust_cli [-h] [-l LIMIT] [-v] [-o OUTPUT_FILE] INPUT_FILE
robust_cli: error: argument -l/--limit: invalid int value: 'not_a_number'
$ python robust_cli.py --help
usage: robust_cli [-h] [-l LIMIT] [-v] [-o OUTPUT_FILE] INPUT_FILE

数据导出与处理脚本,用于批量整理报表数据。

positional arguments:
  INPUT_FILE            待处理的输入数据文件路径(例如 ./raw_data.csv)

options:
  -h, --help            show this help message and exit
  -l LIMIT, --limit LIMIT
                        限制导出的记录条数,必须为正整数 (默认: 50)
  -v, --verbose         是否开启详细调试日志输出
  -o OUTPUT_FILE, --output OUTPUT_FILE
                        输出结果的目标文件路径 (默认: output.json)

使用遇到问题请联系运维支持团队。
五、生产环境开发避坑与关键备忘
操作系统的 Shell(如 Bash、Zsh 或 Windows CMD)是以空格拆分参数的。如果目标文件路径中含有空格(例如 My Documents/data.csv),不加引号会被 Shell 拆分成两个独立的参数传入,从而打乱整个位置参数的对应关系。在脚本提示和说明文档中,应当提醒用户对包含空格的路径使用双引号包裹:python script.py "My Documents/data.csv"。
在 Jupyter Notebook 或 IPython 交互环境中执行包含 sys.argv 或 parser.parse_args() 的代码时,Jupyter 自身启动内核时携带了诸如 -f .../kernel-xxx.json 的专属参数,这会导致 argparse 报错:unrecognized arguments: -f ...。在交互式笔记本环境中进行测试时,应显式传入参数列表进行测试:args = parser.parse_args(['test_data.csv', '--limit', '10'])。
在云原生与容器化部署(如 Docker、Kubernetes)场景下,命令行参数常与环境变量配合使用。可以利用 os.getenv 为命令行参数提供缺省回退,例如:parser.add_argument('--db-url', default=os.getenv('DATABASE_URL', 'localhost:5432')),既支持命令行显式覆盖,又能在自动化环境中免去显式传参的麻烦。
六、方案对比与核心规则速查
| 方案类型 | 适用典型场景 | IndexError 防御机制 | 类型解析错误防御 | 维护与扩展成本 |
|---|---|---|---|---|
| 裸 sys.argv 索引 | 不可在生产环境使用 | 无防御,必现崩溃 | 无防御,极易抛 ValueError | 极高,隐患巨大 |
| sys.argv + len 守卫 | 单文件临时脚本、仅 1 个必填参数 | 显式判断 len >= 期望值 |
需手动写 try-except 拦截 |
低(但只适用于极简需求) |
| 标准库 argparse | 工程脚本、CLI 工具、批处理任务 | 自动校验必填项,不依赖索引 | 声明 type=int/float 自动拦截并提示 |
最优(标准库内置,无外部依赖) |
| 第三方 Click / Typer | 企业级复杂多子命令命令行系统 | 装饰器与类型注解自动解析 | 自动强类型校验与交互式提问 | 需安装第三方 pip 包 |
总结而言,在 Python 中处理命令行参数时,应当彻底弃用不带边界检查的裸 sys.argv[i] 代码。单参数极简脚本务必前置检查 len(sys.argv);涉及两个以上参数或选项开关时,应毫不犹豫地采用 argparse。通过规范的参数管理,能够彻底消除 IndexError 与意外解析错误,使自动化脚本在各种边界条件下都能保持健壮与优雅。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









