

Python主流自然语言处理库对比:NLTK、spaCy与Transformers选型指南
深度对比Python三大主流自然语言处理库NLTK、spaCy与Transformers的技术架构、吞吐性能、中文支持与工程落地差异,提供多维度选型决策框架与可运行代码示例。
一、核心设计理念与底层计算范式
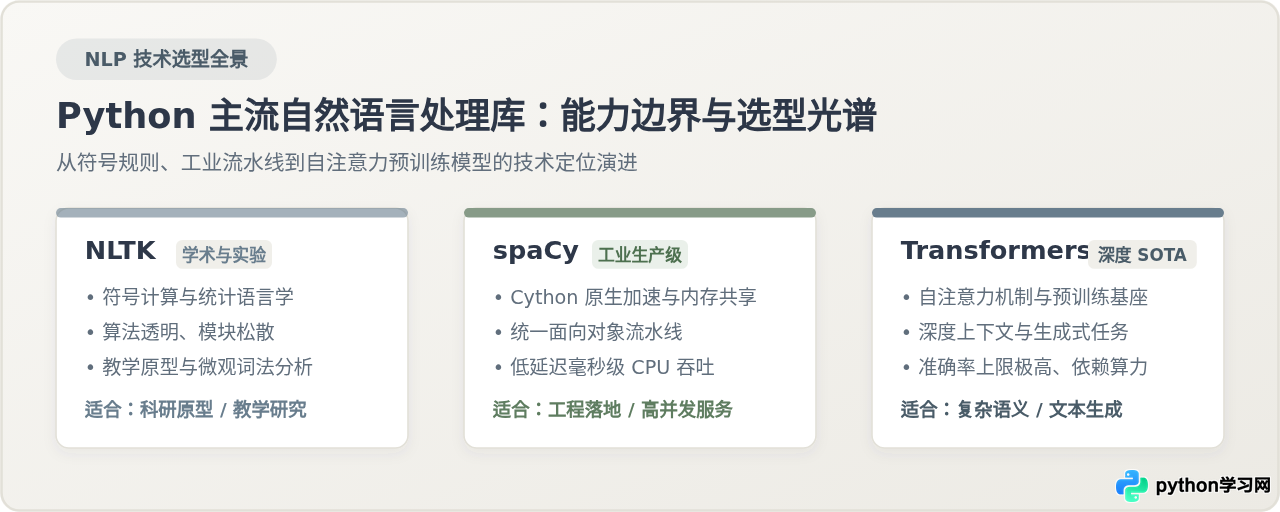
评估自然语言处理库,首先要理解其底层数据流与内存架构的设计初衷。三者在抽象层级与运行效率上的巨大差异,直接根源于它们针对不同历史阶段与应用目标的工程权衡:
1. NLTK(Natural Language Toolkit):基于纯Python的松散算法工具箱
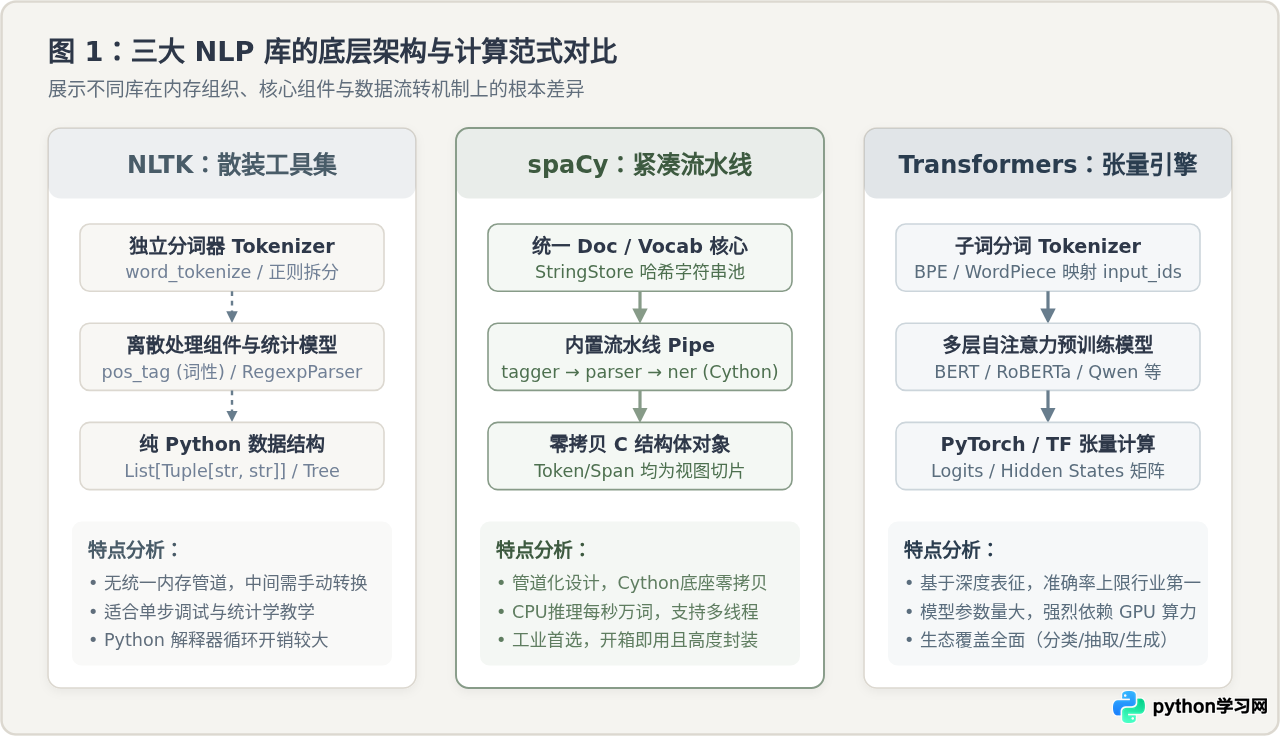
NLTK诞生于宾夕法尼亚大学的计算机与信息科学系,核心目标是服务于计算语言学的教学与学术科研。它将文本处理过程拆解为数十个独立的Python模块(例如分词、词干提取、词性标注、文法解析)。每个算法独立封装为一个类或函数,数据在各个组件之间通常以纯Python的list、tuple或自定义树结构(nltk.Tree)传递。
这种设计的优势在于极高的算法透明度与灵活性,开发者可以任意替换子模块中的统计概率模型。但其劣势同样明显:由于完全运行在Python解释器之上,缺少底层的连续内存管理与并行优化,在大规模工业语料上循环调用会导致显著的GIL争用与解释器开销。
2. spaCy:针对高并发工业落地设计的紧凑流水线
spaCy的设计哲学是“一件事情只提供一种最佳工业实践”。为了追求极致的速度与低内存占用,spaCy的核心模块全部采用Cython编写,直接操作C语言结构体与裸指针。
在spaCy中,一段原始字符串被摄入后,全局词表通过双向哈希表(StringStore)将字符串映射为64位整型哈希ID,整个处理流程仅在内存中维护一个连续存储的Doc单例对象。随后的词性标注(Tagger)、依存句法解析(Parser)和实体识别(NER)流水线组件只是在C级数组上写入标记视图,避免了字符串重复分配与对象浅拷贝,从而在CPU上实现了每秒数万词的高吞吐。
3. Transformers:以深度注意力机制为核心的张量表征引擎
Hugging Face Transformers建立在现代深度学习计算框架(PyTorch / TensorFlow / JAX)之上。它打破了传统NLP将词汇视为离散符号的处理方式,采用子词分词器(WordPiece、BPE或SentencePiece)将文本转换为高维连续词向量(Token Embeddings),并通过堆叠的自注意力(Self-Attention)机制捕获词与词之间的双向长程上下文关系。
Transformers的核心是密集的矩阵乘法与多层感知机计算。虽然其语义表征能力相比传统统计模型产生了质的飞跃,但代价是计算复杂度激增,通常需要专用GPU/TPU硬件以及数GB的显存支持。
二、关键工程差异深度剖析
脱离具体的工程约束讨论工具优劣没有意义。在实际项目选型时,团队必须在吞吐延迟、计算硬件、中文语言特性与维护成本四个维度建立量化标准。
1. 推理延迟与吞吐能力
在单台标准8核CPU云主机上,处理100万条标准短文本(平均长度50字):
- spaCy(CPU模式):利用
nlp.pipe(texts, batch_size=2000, n_process=-1)充分调度多核,整体耗时通常在数秒至几十秒之间,单句平均延迟稳定在0.5~2毫秒,非常适合线上同步API响应。 - NLTK:需要编写显式循环或自行借助
multiprocessing封装,因为涉及大量的Python对象创建与垃圾回收,整体耗时通常是spaCy的5~10倍以上。 - Transformers(CPU模式 vs GPU模式):若在纯CPU环境下运行标准BERT基础模型,单句推理延迟通常在30~80毫秒之间,处理百万文本需要数小时;而一旦接入NVIDIA GPU并配合批处理与FP16半精度加速,吞吐量可提升数十倍,但部署硬件门槛与计费成本显著增加。
2. 中文分词与语言学特性支持
与英语等屈折语天然带有空格分隔不同,中文处理的基石是中文分词与未登录词识别:
- NLTK:核心代码库本身并不包含高质量的中文分词模型。处理中文时,必须手动在外部引入
jieba分词,将分词结果再转换为NLTK的输入格式,无法直接开箱获得成体系的中文句法依存解析。 - spaCy:官方自v3.0起全面提供了中文预训练模型(如
zh_core_web_sm与zh_core_web_trf),底层集成了成熟的分词适配器(如pkuseg与jieba),开箱即可直接输出词性、命名实体与依存句法树。 - Transformers:中文模型生态极为繁荣。开源社区提供了诸如
chinese-roberta-wwm-ext、chinese-macbert-base等海量优质基座。分词器原生支持字符级与子词级映射,有效规避了因传统分词切分错误而引起的下游任务级联误差。
三、端到端工程实施操作步骤
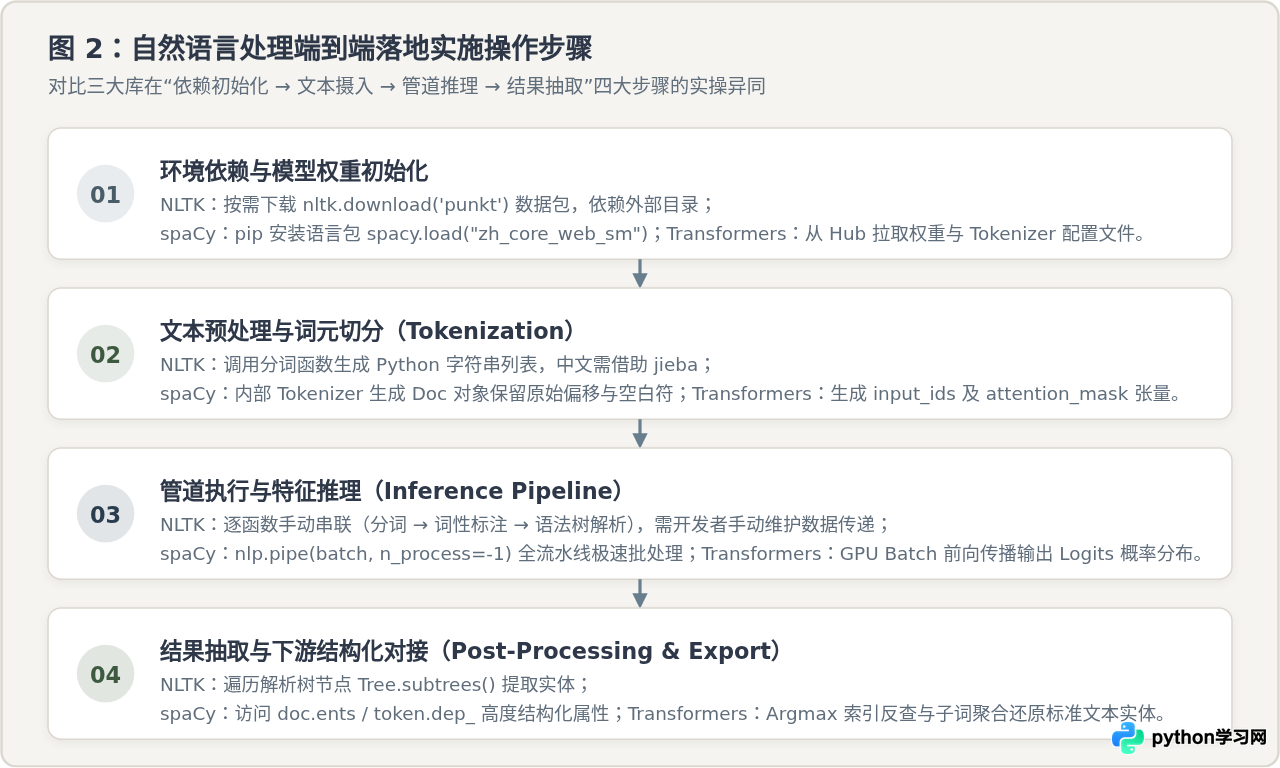
无论选用哪一个库,一个标准的NLP离线或在线处理管道通常包含四个标准步骤。理解各库在这些步骤中的具体操作方式,有助于规范工程实施代码。
步骤一:环境配置与模型资产下载
三者在资源分发机制上有显著区别:
- NLTK:通过库内置交互函数下载数据包。需注意在Docker容器构建时显式预下载,避免运行时触发动态网络请求:
import nltk # 在构建镜像阶段执行预下载 nltk.download('punkt', download_dir='/usr/share/nltk_data') nltk.download('averaged_perceptron_tagger', download_dir='/usr/share/nltk_data') - spaCy:采用Python轮子(wheel)打包语言模型,与pip体系无缝结合:
# 终端执行安装 pip install spacy python -m spacy download zh_core_web_sm - Transformers:基于Hugging Face Hub统一管理。生产环境建议设置本地缓存目录或直接挂载离线权重文件:
export HF_HOME="/opt/models/huggingface"
步骤二:文本摄入与统一分词
分词是决定上下文切分精度的第一道关卡。NLTK输出扁平字符串列表;spaCy构建结构化文档切片;Transformers生成张量张角索引。
步骤三:特征提取与管道推理
在批量处理业务数据时,务必使用各库推荐的高效批处理API,避免单条逐行调用的性能反模式。
步骤四:结果序列化与接口输出
将抽取的实体、词性标签或分类概率转换为规范的JSON字典,提供给下游数据库或Web服务调用。
四、典型任务代码实操与对比验证
为了直观对比三者在API风格与工程复杂度上的差异,下面以最常见的命名实体识别(NER)任务为例,展示完整可运行的Python代码实现。
1. spaCy 实现方案:工业级管道与极简调用
import spacy

# 1. 加载轻量级中文模型(CPU高度优化)
nlp = spacy.load("zh_core_web_sm")

# 2. 待分析文本
text = "华为技术有限公司在深圳发布了新一代智能终端芯片,计划下周销往北京和上海。"

# 3. 执行管道推理
doc = nlp(text)

# 4. 抽取命名实体结果
entities = []
for ent in doc.ents:
    entities.append({
        "text": ent.text,
        "label": ent.label_,
        "start": ent.start_char,
        "end": ent.end_char
    })

print("spaCy 实体识别结果:", entities)
# 示例输出:
# [{'text': '华为技术有限公司', 'label': 'ORG', 'start': 0, 'end': 8},
#  {'text': '深圳', 'label': 'GPE', 'start': 9, 'end': 11},
#  {'text': '下周', 'label': 'DATE', 'start': 24, 'end': 26},
#  {'text': '北京', 'label': 'GPE', 'start': 29, 'end': 31},
#  {'text': '上海', 'label': 'GPE', 'start': 32, 'end': 34}]
代码评析:spaCy通过统一的nlp()对象完成全流程,返回的Span切片对象原生保留字符级偏移量(start_char / end_char),非常便于高亮显示与下游系统精确定位。
2. NLTK 实现方案:分步流水与规则组合
import nltk

# NLTK 原生主要针对英文语料,此处以标准英文实体抽取展示其分步语法块解析(Chunking)机制
sentence = "Apple Inc. is planning to open a new data center in London next October."

# 1. 词元切分
tokens = nltk.word_tokenize(sentence)

# 2. 词性标注
pos_tags = nltk.pos_tag(tokens)

# 3. 命名实体分块识别
chunks = nltk.ne_chunk(pos_tags)

# 4. 遍历语法树抽取命名实体
named_entities = []
for item in chunks:
    if isinstance(item, nltk.Tree):
        entity_name = " ".join([token for token, pos in item.leaves()])
        named_entities.append((entity_name, item.label()))

print("NLTK 实体识别结果:", named_entities)
# 示例输出:
# [('Apple', 'ORGANIZATION'), ('London', 'GPE')]代码评析:NLTK将分词、标注、分块明确暴露为独立步骤。这种模式让教学和调试变得极为直观,但开发者必须编写胶水代码来遍历语法树并处理字符偏移,工程维护成本较高。
3. Transformers 实现方案:基于高阶 Pipeline 的深度抽取
from transformers import pipeline

# 1. 初始化预训练命名实体识别流水线
# 推荐使用通用中文高精度模型,如 dslim/bert-base-NER 或国产预训练 NER 权重
ner_pipeline = pipeline(
    task="ner",
    model="hfl/chinese-roberta-wwm-ext",
    tokenizer="hfl/chinese-roberta-wwm-ext",
    aggregation_strategy="simple"  # 自动合并子词分词碎片
)

text = "华为技术有限公司在深圳发布了新一代智能终端芯片。"

# 2. 推理预测
results = ner_pipeline(text)

# 3. 提取结构化实体
entities = [
    {
        "word": item["word"],
        "entity_group": item["entity_group"],
        "score": round(float(item["score"]), 4),
        "start": item["start"],
        "end": item["end"]
    }
    for item in results
]

print("Transformers 实体识别结果:", entities)
# 示例输出:
# [{'word': '华为技术有限公司', 'entity_group': 'ORG', 'score': 0.9921, 'start': 0, 'end': 8},
#  {'word': '深圳', 'entity_group': 'LOC', 'score': 0.9875, 'start': 9, 'end': 11}]
代码评析:Transformers不仅提供了更高的实体边界识别准确率,还会输出可解释的模型置信度(score)。通过设置置信度阈值过滤,可以有效控制生产环境中的实体抽取噪声。
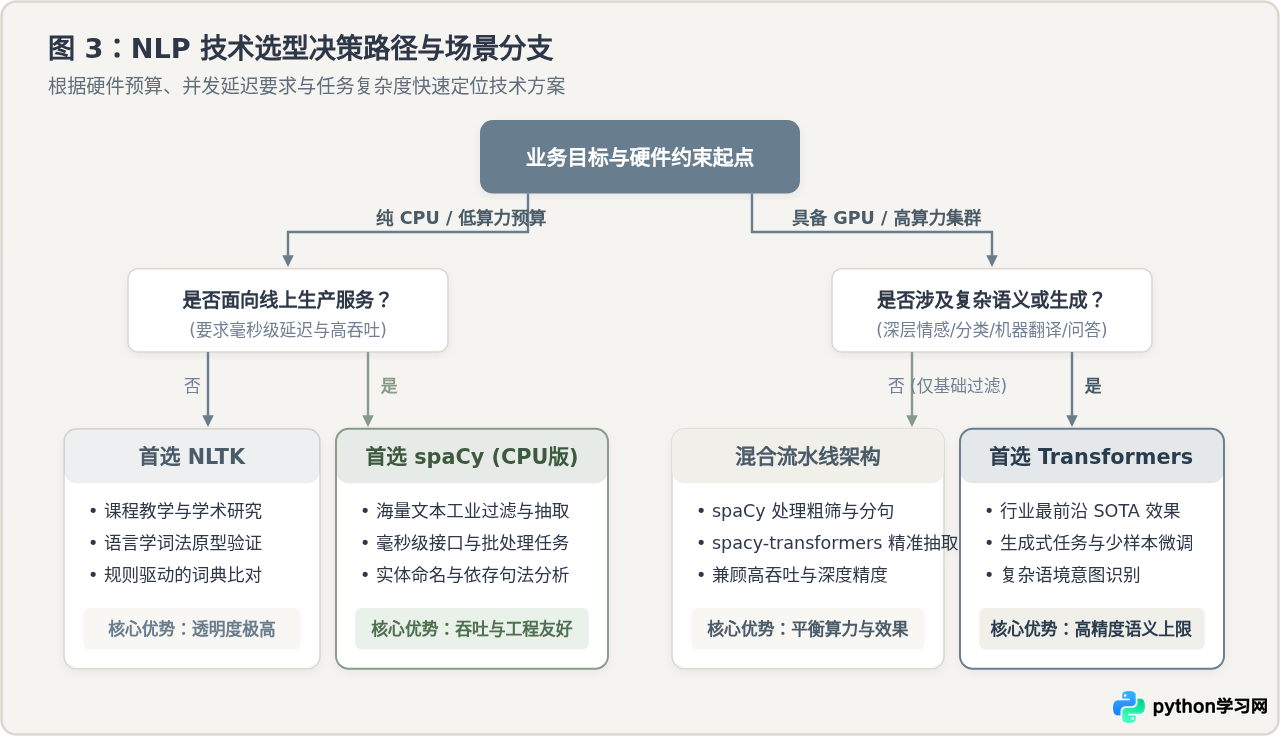
五、多维度选型决策框架与场景对照
综合性能、成本与准确率,可以按照以下四个典型工业场景快速匹配最佳方案:
场景 A:高并发微服务与海量日志文本初筛(首选:spaCy)
业务特征:QPS要求大于1000,集群仅配置常规双核/四核无GPU云服务器,任务主要是分词过滤、敏感词拦截、正规实体提取或通用词性统计。
选型结论:直接选择spaCy。单机单核即可稳定承载数百QPS,极低的内存占用(小模型仅几十MB)使得容器可以在数百毫秒内完成冷启动与横向扩容。
场景 B:金融研报深度语义解析与跨领域问答(首选:Transformers)
业务特征:文本句式复杂、专业术语密集,对抽取准确率与召回率要求极高(如合同风险识别、研报因果关系抽取),任务属于离线批量或低并发后台。
选型结论:选用Transformers基座进行领域针对性微调(Fine-tuning)。深度自注意力能够精准解析多层从句与代词指代,其带来的准确率提升足以覆盖显卡硬件投入。
场景 C:语言学微观规则验证与大学课程实验(首选:NLTK)
业务特征:学习经典文法解析算法(如Earley、CYK算法)、自定义上下文无关文法(CFG)、探索词典网络(WordNet语义相似度计算)。
选型结论:选用NLTK。NLTK拥有业内最完善的经典语言学工具集合和教科书支持,算法源码结构简洁、易于单步断点跟踪与教学展示。
场景 D:工业级双阶段混合架构(spaCy + Transformers)
在追求极致性价比的生产系统中,主流的做法并非“二选一”,而是将两者结合:
第一阶段利用 spaCy 进行轻量级的快速分句、清洗与规则过滤,剔除80%的无效杂质文本;第二阶段仅将筛选出的关键候选长难句送入 Transformers 深度网络进行高精度的语义抽取。这种组合在保证SOTA级准确率的同时,通常能降低70%以上的显卡算力开销。
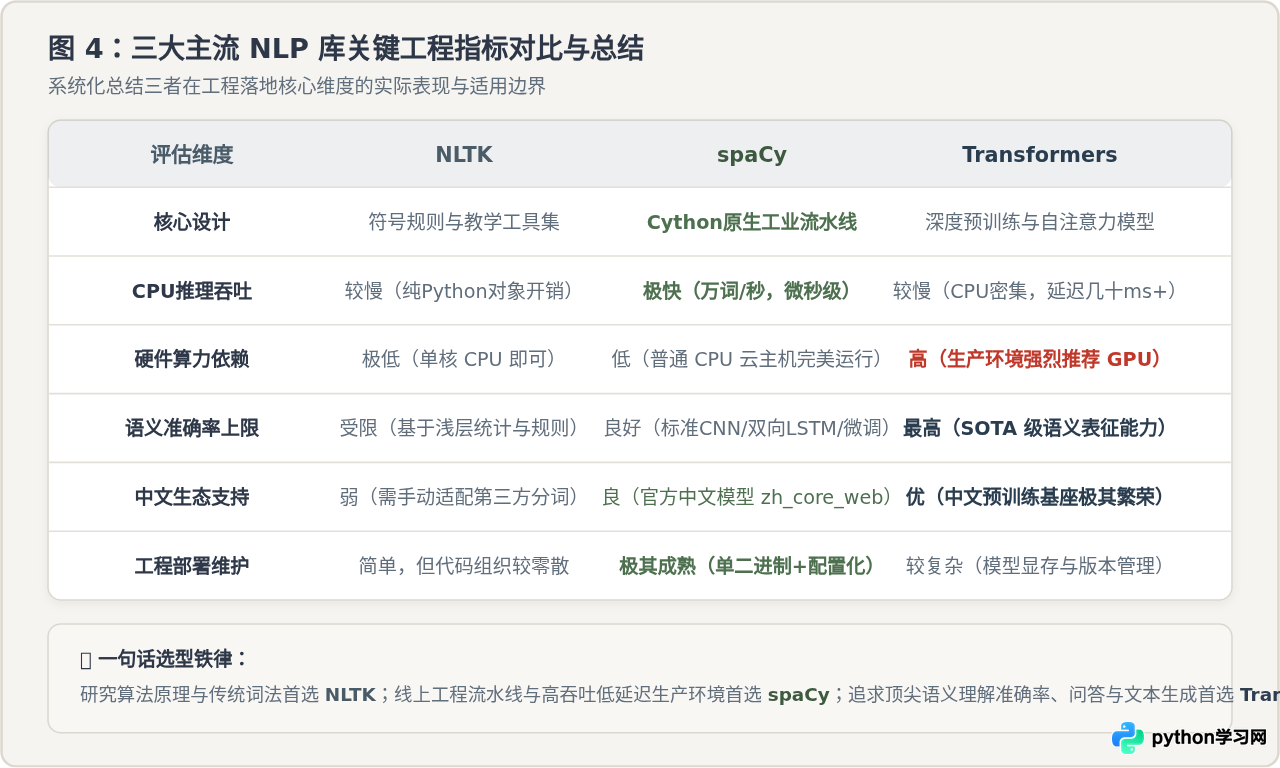
六、工程落地避坑指南
在实际项目落地过程中,避免陷入以下三类常见技术误区:
- 防范盲目“大模型化”带来的资源失控:许多团队在初创期直接将原本只需spaCy规则匹配或轻量分类的任务全面转向Transformer甚至云端LLM API。这不仅导致原本数毫秒的接口延迟恶化至数百毫秒,更使单月云服务成本成倍攀升。在任务基线验证阶段,应优先以spaCy作为速度与效果的黄金对照基线。
-
谨慎处理spaCy的多进程加载与显存泄漏:在结合Gunicorn或FastAPI等多工作进程(Multi-Worker)框架部署spaCy服务时,应避免在父进程中全局初始化大型模型后直接fork子进程。正确做法是在每个工作进程内部独立按需加载,或利用
spacy-transformers时明确设置GPU内存分配策略。 -
注意Transformers子词切分对实体边界的影响:使用BERT等模型进行命名实体识别时,分词器可能会将一个实体切分为多个Subword片段(如包含
##前缀)。若未在pipeline中配置aggregation_strategy="simple"或手动编写首尾偏移聚合逻辑,容易产生截断实体或边界不对齐的Bug。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









