

Python中文NLP库选型:jieba、HanLP、LTP代码复杂度对比

在面向中文文本进行自然语言处理开发时,选择恰当的基础库直接决定了代码架构的优雅度、依赖维护成本以及长期运行开销。jieba 以无重型依赖、极简函数式切分和低认知负担著称;HanLP 2.x 转向面向深度学习框架的统一流水线与文档化对象结构;LTP 4.x 则依托深度集成的张量管道与精准的中文句法树解析能力构建体系。评估一个库的“代码复杂度”,不仅要看分词时单行调用的长短,更要衡量工程初始化、上下文批处理、数据结构解构以及对接下游业务时所需要的胶水代码行数。
一、基础架构与运行时依赖开销
工程复杂度的第一道关卡体现在项目的环境初始化与包管理负担上。不同库底层依赖的差异,决定了初始化加载、显存控制和跨平台打包的难度。
- jieba:纯 Python 编写,仅依赖标准库和紧凑的文本词典文件。项目体量仅约 30MB,支持零预编译环境直接分发,无 GPU 依赖,冷启动耗时在 200ms 到 500ms 之间。
- HanLP 2.x:核心基于 PyTorch 或 TensorFlow 框架构建,属于现代深度学习 NLP 库。安装需配套对应的深度学习运行环境,预训练 Transformer 或联合多任务模型体积通常在几百 MB 到数 GB 不等。首次加载需拉取权重并完成计算图构建,启动开销显著。
- LTP 4.x:哈工大开发的 LTP 4.x 基于 PyTorch 深度重构,提供轻量模型(LTP-Small)及核心全功能模型。安装要求具备明确的 PyTorch 运行时版本,依赖张量批处理,初始化需显式指定设备挂载(CPU/CUDA)。
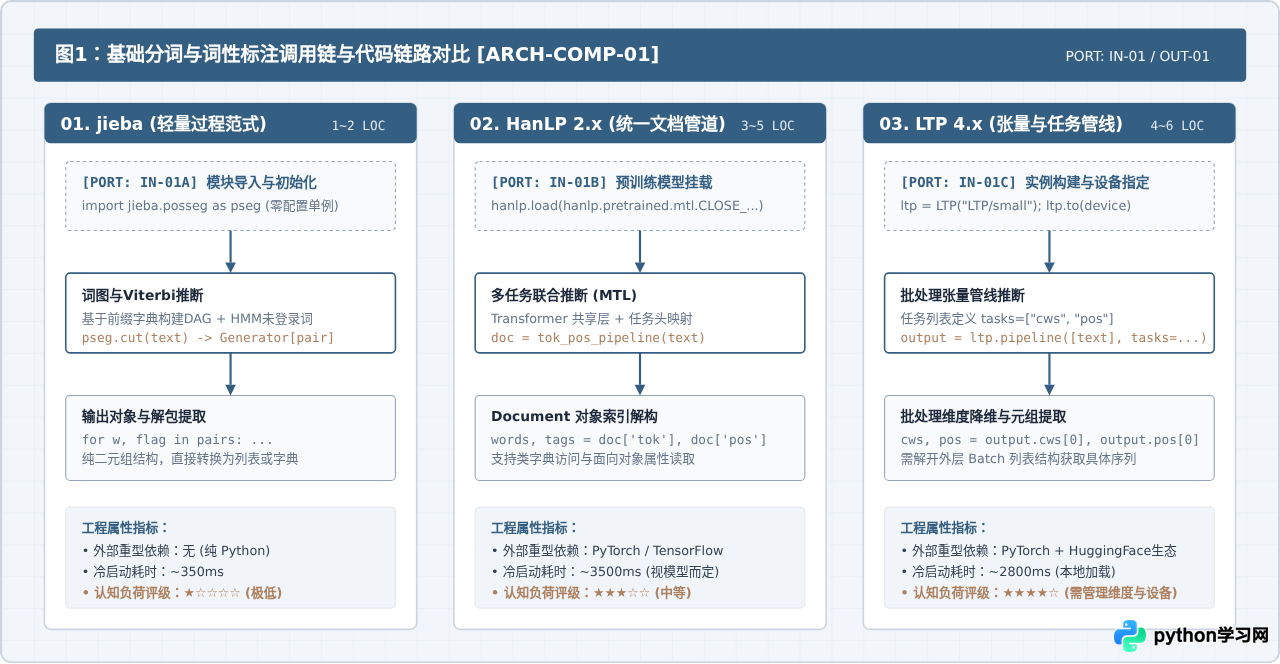
二、分词与词性标注实现:基础代码复杂度实测
为了直观对比代码书写与维护负担,我们以一段典型的业务文本为例:“自然语言处理技术已广泛应用于智能客服与知识图谱构建中”,分别展示三个库完成“分词 + 词性标注”所需的完整可运行 Python 代码。
1. jieba 实现方案
jieba 采用过程式 API,内置默认分词字典与 HMM 词性标注模型。调用者几乎不需要关心生命周期管理:
import jieba.posseg as pseg

# 待分析文本
text = "自然语言处理技术已广泛应用于智能客服与知识图谱构建中"

# 执行分词与词性标注(返回生成器)
words = pseg.cut(text)

# 转换为业务标准字典列表
result = [{"word": item.word, "pos": item.flag} for item in words]

# 示例输出验证(截取前3项)
# [{"word": "自然语言", "pos": "l"}, {"word": "处理", "pos": "v"}, {"word": "技术", "pos": "n"}]代码复杂度特征:极低。无需加载模型对象,无需初始化参数,仅需 2 行核心代码即可产出标准结果。对于只有分词与关键词匹配需求的简单服务,代码侵入性近乎为零。
2. HanLP 2.x 实现方案
HanLP 2.x 引入了多任务流水线设计。如果只需要分词和词性,可以使用经过精简的多任务权重,也可以调用联合模型:
import hanlp

# 加载多任务预训练流水线(支持分词、词性、NER等多任务)
# 执行环境需预先安装 torch 及对应依赖
tagger = hanlp.load(hanlp.pretrained.mtl.CLOSE_TOK_POS_NER_SRL_DEP_SDP_CON_ELECTRA_BASE)

text = "自然语言处理技术已广泛应用于智能客服与知识图谱构建中"

# 限制执行任务通道,优化推断耗时
doc = tagger(text, tasks=["tok/fine", "pos/ctb"])

# 解析 Document 对象(支持键值访问)
tokens = doc["tok/fine"]
pos_tags = doc["pos/ctb"]
result = [{"word": w, "pos": p} for w, p in zip(tokens, pos_tags)]代码复杂度特征:中等。通过配置 tasks 参数按需计算,返回结构化 Document。其优势是 API 设计高度统一,但开发者必须记忆或维护具体的任务名称字符串(如 tok/fine、pos/ctb)。
3. LTP 4.x 实现方案
LTP 4.x 将所有基础分析封装为 pipeline 架构,天然支持批处理输入并需要显式管理输入数据维度:
from ltp import LTP

# 初始化实例,可指定本地路径或 HuggingFace 镜像仓库
ltp = LTP("LTP/small")

text = "自然语言处理技术已广泛应用于智能客服与知识图谱构建中"

# pipeline 默认要求列表格式的批处理输入
output = ltp.pipeline([text], tasks=["cws", "pos"])

# 从批处理结构中降维提取第一条记录
words = output.cws[0]
pos_tags = output.pos[0]
result = [{"word": w, "pos": p} for w, p in zip(words, pos_tags)]代码复杂度特征:稍高。输入必须传 list,输出返回对象内部以批次为第一维度(output.cws[0])。在单句调用场景下,开发者必须编写额外的索引拆包逻辑。
三、高级语义任务:NER 与依存句法分析的代码代价
当业务需求从基础切词演进至命名实体识别(NER)以及句法依存关系提取时,三个库的设计分化尤为明显。jieba 并不支持高级句法分析,若强行使用 jieba,需要额外串联基于统计规则或外部 CRF 的胶水代码;而 HanLP 与 LTP 提供了开箱即用的高级结构抽取支持,但其数据组织形式存在显著差异。
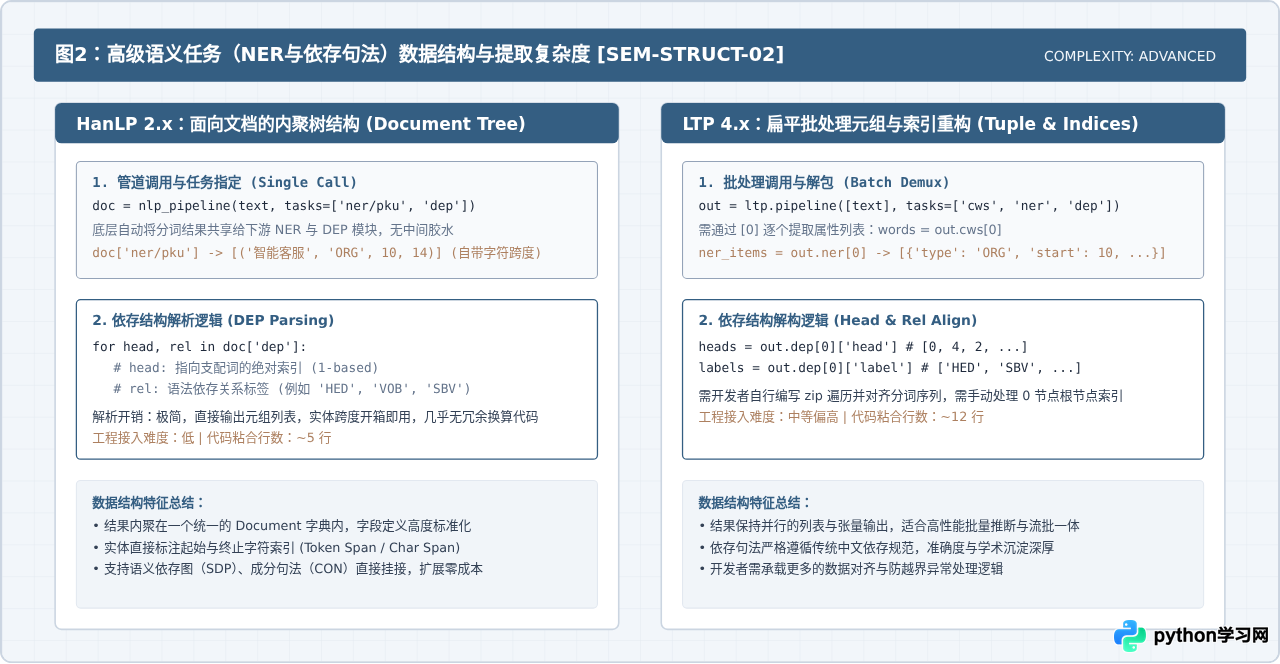
在进行依存句法提取时,以下是 LTP 4.x 完成依存树结构构建的完整代码:
from ltp import LTP

ltp = LTP("LTP/small")
text = "智能客服系统能够精准识别用户的咨询意图"

# 执行分词与依存句法分析
output = ltp.pipeline([text], tasks=["cws", "dep"])

# LTP 返回的是平行的 head 与 label 列表,必须编写对齐逻辑
words = output.cws[0]
dep_heads = output.dep[0]["head"]
dep_labels = output.dep[0]["label"]

# 组装完整的语义依存关联字典
syntax_tree = []
for idx, (word, head, rel) in enumerate(zip(words, dep_heads, dep_labels)):
    # LTP 中 head 指向支配词的 1-based 序号,0 代表根节点 (Root)
    parent_word = "Root" if head == 0 else words[head - 1]
    syntax_tree.append({
        "id": idx + 1,
        "word": word,
        "head_id": head,
        "head_word": parent_word,
        "relation": rel
    })

# 示例验证:查看当前构建出的依存关系节点
# [{"id": 1, "word": "智能", "head_id": 2, "head_word": "客服", "relation": "ATT"}, ...]
从代码可以看出,虽然 LTP 的分析能力极为专业,但业务开发者必须编写针对 head == 0 的索引安全转换代码。若后续还需计算多跳语法路径或构建知识图谱三元组,此类胶水代码在整个代码库中会占据可观比重。
四、生产集成与抽象封装:标准工程步骤
将中文 NLP 库引入生产微服务体系,不能直接在业务 Controller 或 RPC 处理器中散落各库的原始调用。必须经过环境评估、领域词典注入、适配器统一抽象及高并发隔离四个标准步骤。
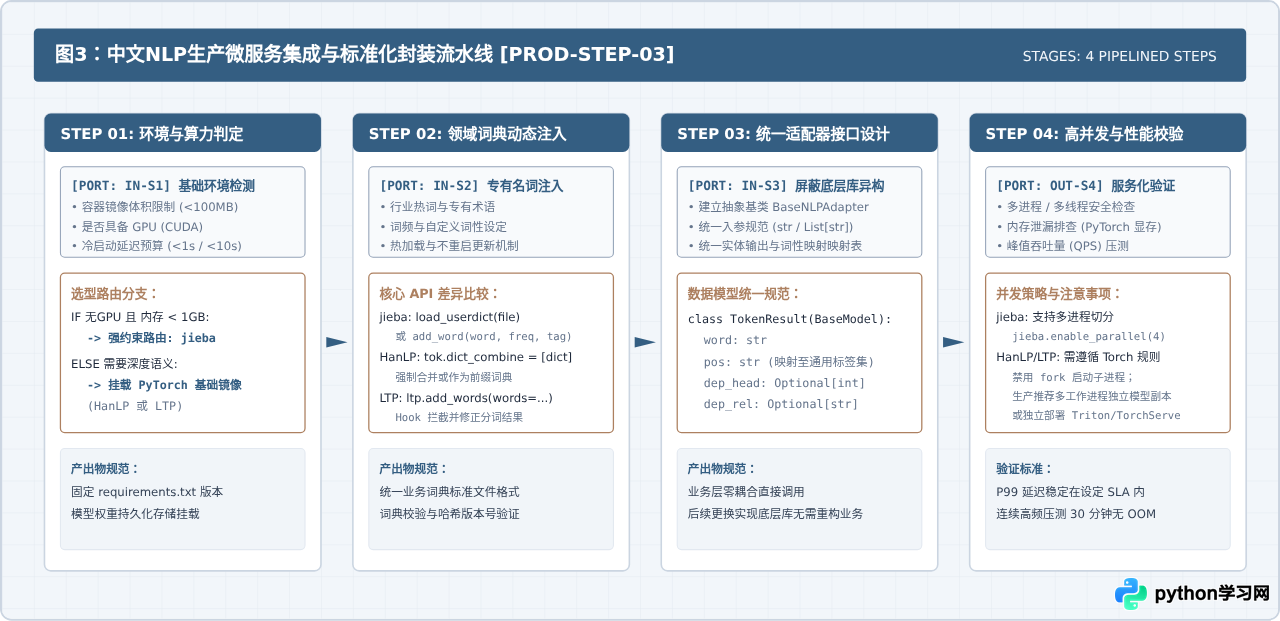
为了使上层业务代码彻底与具体的分词库解耦,推荐采用面向接口编程的适配器模式。以下是一个标准化封装示例:
from abc import ABC, abstractmethod
from typing import List, Dict, Any

class BaseNLPAdapter(ABC):
    """统一中文 NLP 适配器基类"""

    @abstractmethod
    def tokenize_and_pos(self, text: str) -> List[Dict[str, str]]:
        """统一返回格式: [{"word": "...", "pos": "..."}, ...]"""
        pass

class JiebaAdapter(BaseNLPAdapter):
    """jieba 实现适配器"""
    def __init__(self, user_dict_path: str = None):
        import jieba.posseg as pseg
        self.pseg = pseg
        if user_dict_path:
            import jieba
            jieba.load_userdict(user_dict_path)

    def tokenize_and_pos(self, text: str) -> List[Dict[str, str]]:
        pairs = self.pseg.cut(text)
        return [{"word": item.word, "pos": item.flag} for item in pairs]

class LTPAdapter(BaseNLPAdapter):
    """LTP 实现适配器"""
    def __init__(self, model_name: str = "LTP/small"):
        from ltp import LTP
        self.ltp = LTP(model_name)

    def tokenize_and_pos(self, text: str) -> List[Dict[str, str]]:
        out = self.ltp.pipeline([text], tasks=["cws", "pos"])
        words = out.cws[0]
        pos_tags = out.pos[0]
        return [{"word": w, "pos": p} for w, p in zip(words, pos_tags)]
通过这层简化的适配器,业务系统可以在轻量化需求与高精度语义分析需求之间灵活切换,而无需修改任何上层核心业务代码。
五、多维度综合对比与选型决策指南
为了给实际技术决策提供确切依据,我们将三者在关键技术指标、代码复杂度及运维代价上的表现汇总为决策树与评估矩阵。
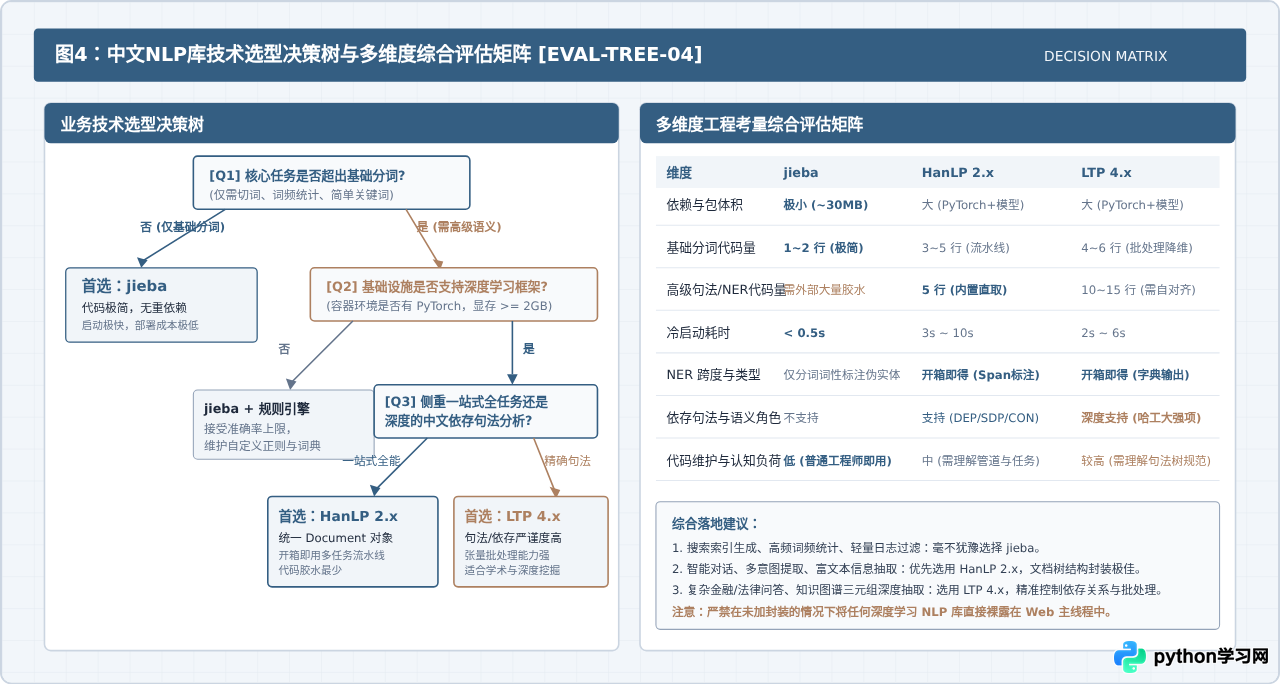
六、总结与落地建议
通过对 jieba、HanLP 2.x 和 LTP 4.x 的全方位代码复杂度剖析,可以得出清晰的技术选型结论:
- 若项目受限于严苛的硬件环境、极低的镜像打包要求或只需基础切词:jieba 是最佳选择。它的代码复杂度几乎可以忽略不计,没有任何框架层面的心智负担。
- 若业务属于一站式语义分析(涵盖分词、实体识别、语义依存、成分句法):HanLP 2.x 的
Document数据结构设计能够显著减少下游业务系统处理结构体时的胶水代码量,其多任务流水线在工程调用上最为规整。 - 若项目以中文语言学深度句法依存、语义角色分析为核心业务壁垒:LTP 4.x 拥有深厚的学术沉淀与精准的依存关系标签体系。虽然其批处理 API 与扁平元组返回要求开发者编写 10~15 行额外的树遍历与索引对齐代码,但其在结构化句法分析领域的严谨度无可替代。
在实际工程架构落地时,务必通过定义清晰的统一适配器接口(如 BaseNLPAdapter)对选定的自然语言处理库进行二次封装,既能规避底层库接口升级对业务的冲击,也为未来的算法平滑迁移与性能调优留出充分的演进空间。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









