

解决Node.js运行Python脚本时的编码与路径错误
深入解析在Node.js中通过child_process调用Python脚本时常见的spawn ENOENT路径找不到、相对路径漂移、以及Windows环境下GBK/charmap编码崩溃与中文乱码问题,提供生产级排查流程、三层编码防御方案与完整的跨平台调用代码封装。
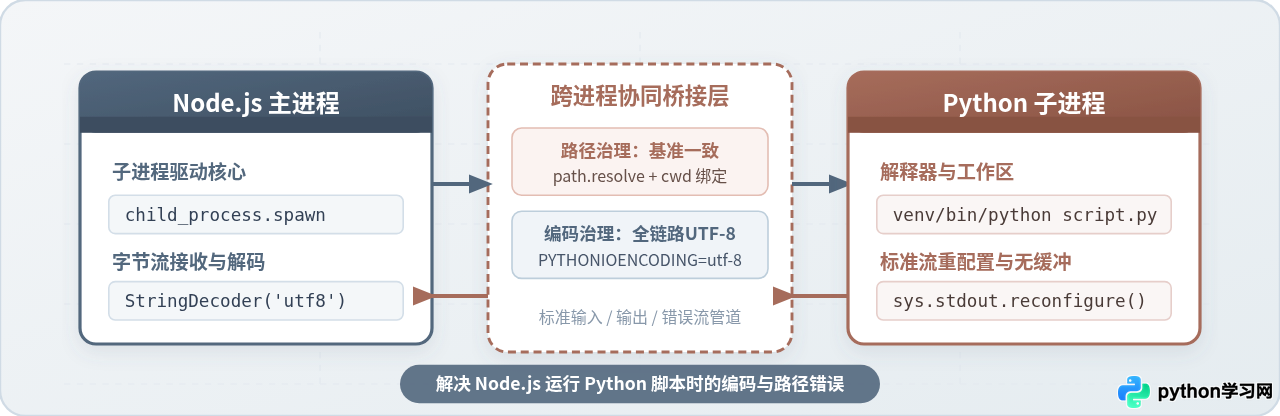
child_process 模块(如 spawn 或 execFile)拉起 Python 脚本完成运算或算法处理,是微服务与后端异构架构中常见的集成模式。然而,由于两个运行时的执行环境差异,开发者极易遭遇两类典型阻碍:一是由工作目录漂移和解释器定位导致的 路径错误(如 spawn ENOENT 或 [Errno 2] No such file or directory);二是由操作系统代码页不匹配、非终端管道缓冲机制引起的 编码与乱码崩溃(如 UnicodeEncodeError 或中文字符截断成锟斤拷)。本文将针对这两个核心问题展开系统排查,剖析操作系统流与解释器机制,并给出兼顾 Windows、macOS 与 Linux 的工业级防御方案。
一、故障表象与进程间通信原理
很多开发者在终端命令行中单独运行 python script.py 能够正常执行,但一旦把命令交由 Node.js 的子进程模块驱动,就会立即崩溃或输出乱码。理解这一现象的关键,在于认清跨进程调用的底层通信原理。
Node.js 主进程与 Python 子进程属于操作系统层面的两个独立进程。Node.js 并不直接“执行”Python 脚本,而是借助操作系统内核的系统调用(在 POSIX 系统上为 fork/exec,在 Windows 上为 CreateProcess)启动 Python 解释器,并建立标准输入(stdin)、标准输出(stdout)、标准错误(stderr)三组无格式的二进制单向管道(Pipes)。
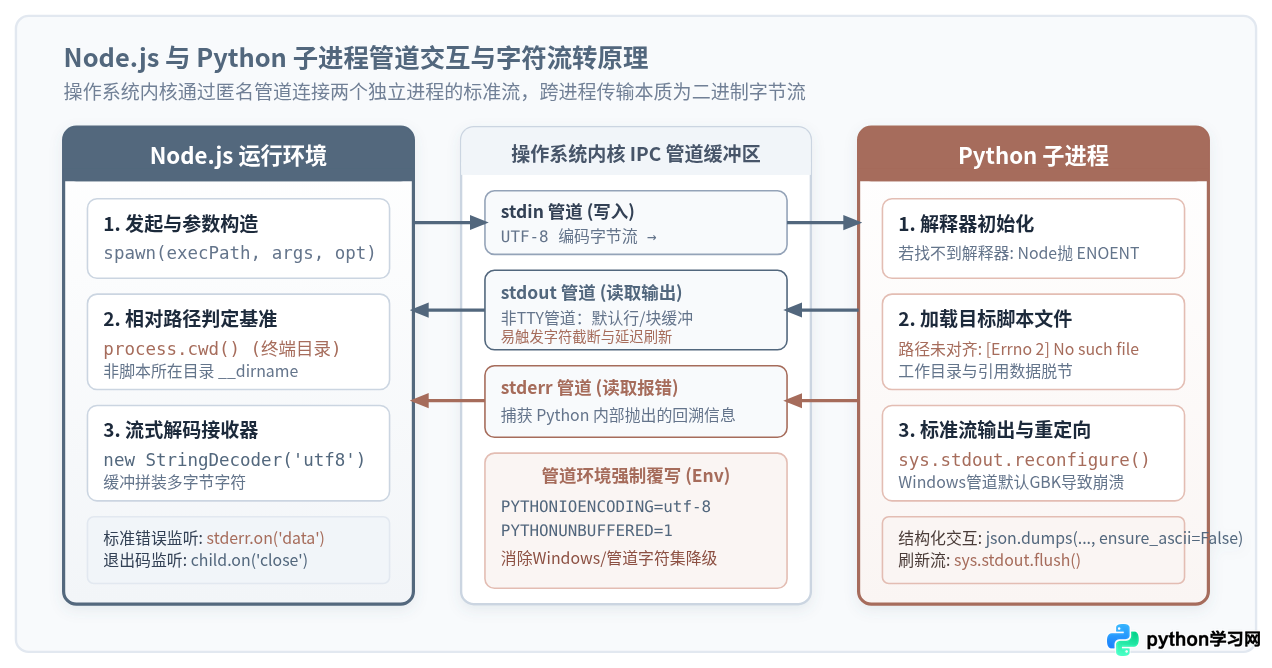
在这个架构中,两类错误分别发生在不同的环节:
- 路径错误发生的时刻:如果在操作系统尝试寻找并启动 Python 可执行程序时路径错误,Node.js 会在主进程直接抛出
spawn ENOENT(Error No Entry,即无此程序);如果 Python 解释器成功启动,但在解释执行其参数所指定的.py脚本或脚本内部open()资源文件时找不到对应文件,则会由 Python 进程向stderr管道写入[Errno 2] No such file or directory并退出。 - 编码错误发生的时刻:当数据通过管道传输时,操作系统只传递原始字节(Bytes)。如果 Python 脚本输出中文,而 Windows 系统默认将非 TTY 管道的标准输出降级为其区域代码页(如简体中文版的 GBK/CP936),而 Node.js 默认使用 UTF-8 规则进行解释,就会导致严重的字符错位与“锟斤拷”乱码;更严重的是,当 Python 试图向仅支持 ASCII/GBK 的管道写入超出编码集的字符时,Python 解释器自身便会抛出
UnicodeEncodeError: 'charmap'/'gbk' codec can't encode character并提前中断退出。
二、路径错误的排查与彻底解决
路径错误之所以让人困惑,主要源于相对路径的基准参考点在运行时发生了意外偏移。排查时应遵循由外向内的层次顺序展开。
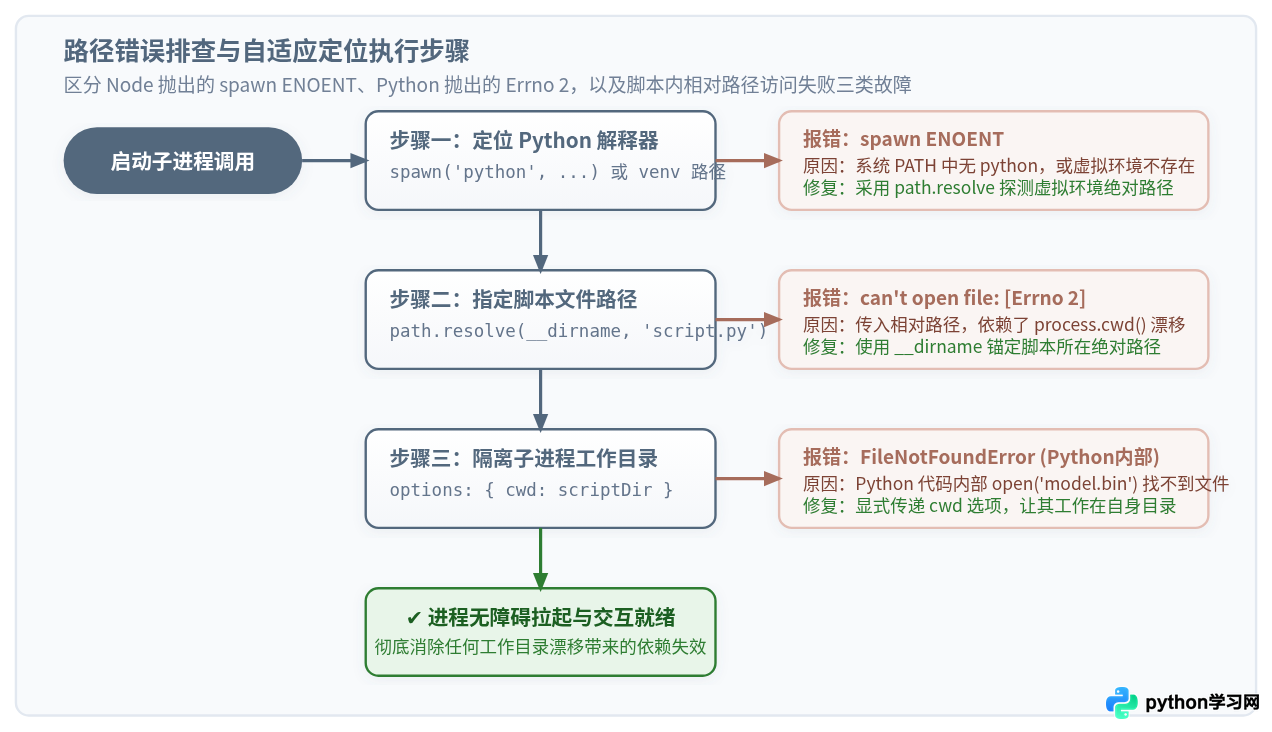
1. 厘清两组最容易混淆的路径基准
Node.js 开发者最容易踩的坑,是误以为 ./script.py 是相对于当前写代码的 .js 文件。事实上:
process.cwd()是 Node.js 进程启动时的终端当前工作目录。如果你在项目根目录运行node src/service/runner.js,此时的相对路径基准是项目根目录,而不是src/service/。__dirname(或 ESM 下的import.meta.dirname)才是当前 JavaScript 模块文件在磁盘上的绝对目录。
因此,所有传递给 spawn 或 execFile 的脚本文件路径,必须使用 path.resolve 或 path.join 基于 __dirname 构造出物理绝对路径,绝不可传递形如 ../scripts/calc.py 的相对路径。
2. 规范化配置子进程工作目录 options.cwd
即便 Python 脚本自身的绝对路径定位正确,Python 脚本内部如果存在读写本地依赖的操作(如 open('weights.bin', 'rb') 或 pd.read_csv('data.csv')),Python 默认也是根据当前工作目录(CWD)去查找文件的。如果 Node.js 没有显式指定,子进程将继承 Node.js 启动时的 process.cwd(),导致 Python 内部再次发生 FileNotFoundError。
解决方案是在 spawn 的配置参数中显式设置 cwd 为脚本所在目录或工程指定的基准目录:
const path = require('path');
const { spawn } = require('child_process');

const scriptDir = path.resolve(__dirname, '../python_tasks');
const scriptPath = path.join(scriptDir, 'process_data.py');

const child = spawn('python3', [scriptPath], {
  cwd: scriptDir // 显式锁定子进程工作环境,杜绝相对路径查找失败
});
3. 虚拟环境(Virtualenv)解释器绝对定位
在生产环境中直接依赖系统默认的 python 或 python3 命令是非常脆弱的,既容易因为不同机器环境变量 PATH 未配置而抛出 spawn ENOENT,又容易因为依赖包未安装在全局环境而报错。规范的做法是指向工程专属的虚拟环境可执行文件:
| 操作系统 | 虚拟环境默认相对路径 | Node.js 动态检测方式 |
|---|---|---|
| Windows | .venv/Scripts/python.exe |
process.platform === 'win32' |
| Linux / macOS | .venv/bin/python |
process.platform !== 'win32' |
exec('python ' + scriptPath) 拼接命令字符串!如果路径中包含空格(例如在 Program Files 或包含空格的用户名目录下),exec 调用的底层 Shell 会将空格视作参数分隔符,导致文件路径被截断进而报错。始终优先使用 spawn 或 execFile,并将路径作为参数数组项传递。
三、编码与缓冲错误的治理方案
解决了路径定位之后,紧接着面临的核心挑战就是数据流的编码一致性与缓冲延迟。
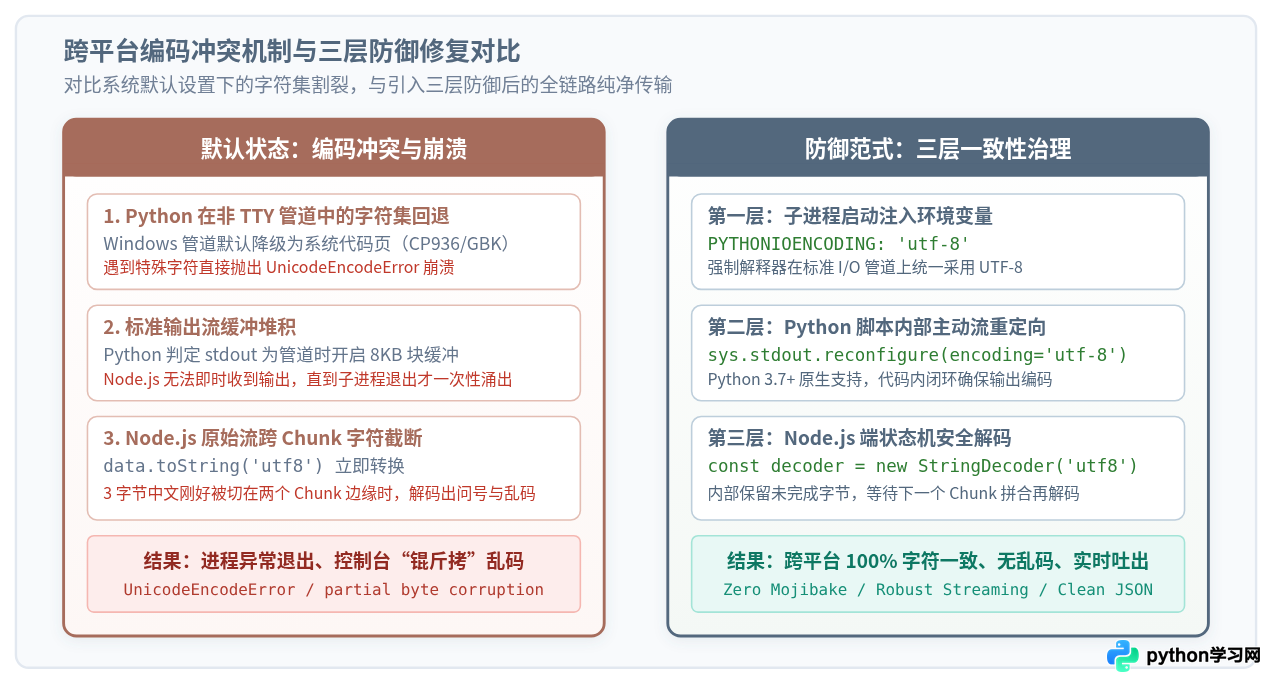
1. 为什么终端正常,一到 Node.js 就乱码或崩溃?
Python 解释器在启动时会对标准 I/O 进行设备探测。当检测到输出目标是控制台(TTY 交互终端)时,现代系统的终端大多能协商为 UTF-8;但当输出目标是操作系统管道(Pipe)时,Python 会采取保守策略:在 Windows 平台上,它往往会退回查询系统的本地 ANSI 代码页(如 cp936 即 GBK,或西欧系统的 cp1252)。
一旦 Python 代码试图打印包含 Emoji、特种数学符号、或 GBK 字符集未收录的生僻字,系统级编码器在尝试把 Python 内部的 Unicode 字符串转换为管道字节流时就会直接失败,抛出致命的 UnicodeEncodeError。即便输出内容纯为简体汉字,GBK 编码的字节流流到 Node.js 侧被以默认的 UTF-8 解码后,控制台就会出现标志性的“锟斤拷”(乱码)。
2. 建立三层一体的编码防御体系
要彻底解决这一问题,不能只在一端打补丁,而应当在环境变量、Python 内部配置以及 Node.js 流解码三个层面形成闭环:
-
第一层(子进程环境变量约束):在 Node.js 调用
spawn时,通过options.env显式注入PYTHONIOENCODING: 'utf-8'和PYTHONUNBUFFERED: '1'。前者强制 Python 对所有标准输入输出流采用 UTF-8 编解码;后者禁用缓冲堆积,使得 Python 的标准输出能够实时吐出至管道,避免数据被卡在 8KB 内部块缓冲区中。 -
第二层(Python 脚本主动重配置):从 Python 3.7 开始,标准库提供了
sys.stdout.reconfigure()与sys.stderr.reconfigure()方法。在 Python 脚本入口处显式声明编码规则,能够确保脚本即使脱离 Node.js 的环境注入也能保持健壮运行:import sys # 保证在管道模式下统一为 UTF-8 输出 if hasattr(sys.stdout, 'reconfigure'): sys.stdout.reconfigure(encoding='utf-8') sys.stderr.reconfigure(encoding='utf-8') -
第三层(Node.js 端采用 StringDecoder 安全解码):在 Node.js 监听
child.stdout.on('data', chunk => ...)时,直接调用chunk.toString('utf8')存在潜在缺陷。因为一个中文字符在 UTF-8 中占据 3 个字节,当管道高并发分片传输时,一个完整汉字的 3 个字节极有可能被切断在两个相邻的chunk中。前一个 chunk 包含 2 个字节,直接解码就会生成无法还原的�(替代字符)。引入 Node.js 原生的string_decoder模块,能够自动缓存不完整的多字节序列,待后续字节到来拼接完整后再输出。
四、生产级健壮调用方案与代码范式
综合上述路径与编码的系统治理原则,下面给出一套可直接应用于生产环境的完整实现范式。
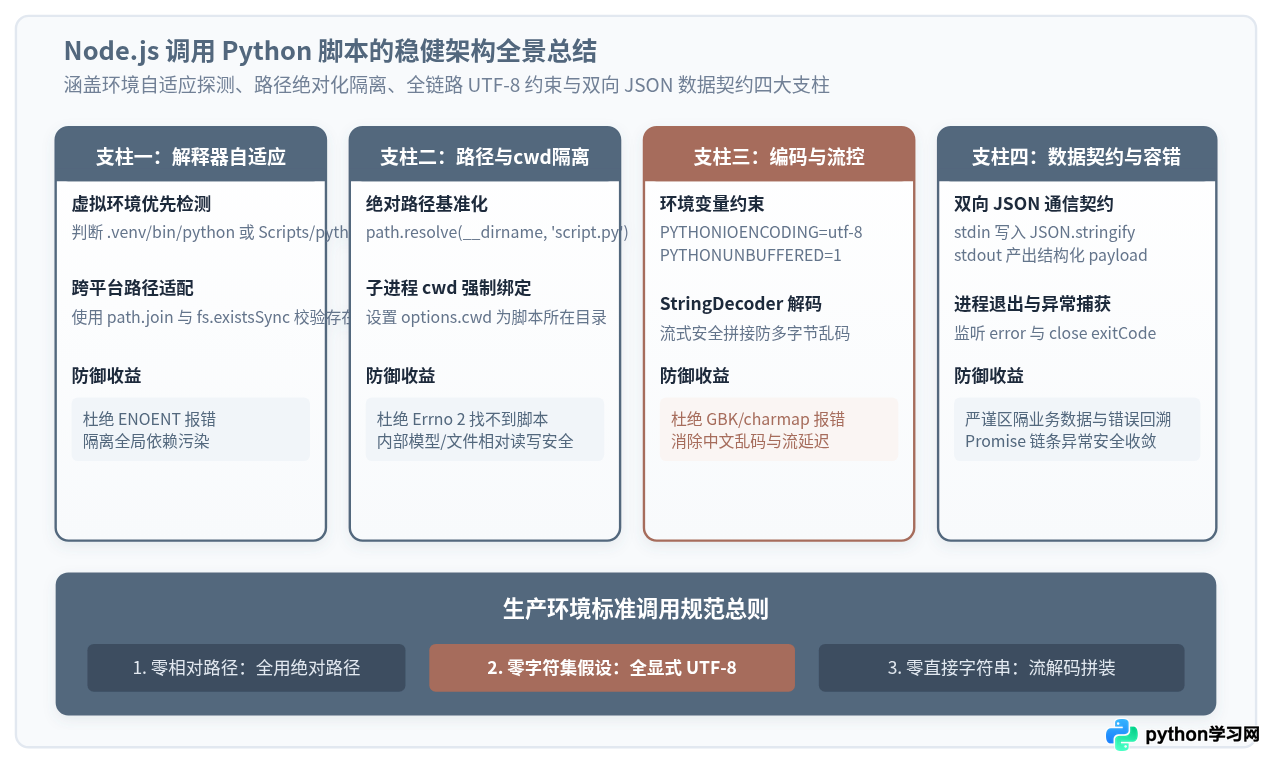
1. Node.js 封装模块:runPythonScript.js
该封装负责自动识别当前系统的虚拟环境解释器、基于脚本所在文件路径定位绝对目标、注入强制 UTF-8 环境变量、并利用 StringDecoder 捕获标准输出与标准错误:
// runPythonScript.js
const path = require('path');
const fs = require('fs');
const { spawn } = require('child_process');
const { StringDecoder } = require('string_decoder');

/**
 * 获取最优先的 Python 解释器绝对路径
 * @param {string} projectRoot - 工程根目录
 * @returns {string} 解释器可执行文件路径
 */
function resolvePythonInterpreter(projectRoot) {
  const isWin = process.platform === 'win32';
  const venvPath = isWin
    ? path.join(projectRoot, '.venv', 'Scripts', 'python.exe')
    : path.join(projectRoot, '.venv', 'bin', 'python');

  if (fs.existsSync(venvPath)) {
    return venvPath;
  }

  // 若无虚拟环境,则回退至系统全局命令
  return isWin ? 'python' : 'python3';
}

/**
 * 稳健执行 Python 脚本并返回结果 Promise
 * @param {string} scriptRelativePath - 相对于当前目录的脚本相对路径
 * @param {Array} args - 传递给 Python 的参数列表
 * @param {object} payload - 准备通过 stdin 输入的 JSON 数据对象
 * @returns {Promise
2. Python 任务脚本范例:processor.py
对应的 Python 脚本遵循纯净的标准 I/O 设计,将非结构化的调试日志输出到 stderr,结构化结果仅输出到 stdout,互不污染:
# processor.py
# -*- coding: utf-8 -*-
import sys
import json
import os

# 1. 显式保障标准 I/O 为 UTF-8 编码
if hasattr(sys.stdout, 'reconfigure'):
    sys.stdout.reconfigure(encoding='utf-8')
    sys.stderr.reconfigure(encoding='utf-8')

def main():
    try:
        # 从标准输入读取 Node.js 传入的 JSON 数据
        input_data = sys.stdin.read().strip()
        params = json.loads(input_data) if input_data else {}

        # 验证工作目录是否正确锁定在脚本所在目录
        current_workdir = os.getcwd()
        sys.stderr.write(f"[Python Debug] 当前工作目录: {current_workdir}\n")

        # 处理业务逻辑(支持包含中文、Emoji 等复杂字符)
        username = params.get("username", "访客")
        message = f"你好,{username}!Python 已成功处理任务,当前时间戳: 2026-11-01。"

        response = {
            "status": "success",
            "received": params,
            "message": message,
            "cwd": current_workdir
        }

        # 2. 将最终结构化数据以 UTF-8 输出到标准输出
        # ensure_ascii=False 确保直接输出真实中文字符而非 \uXXXX 转义字符
        sys.stdout.write(json.dumps(response, ensure_ascii=False))
        sys.stdout.flush()

    except Exception as e:
        sys.stderr.write(f"[Python Error] 发生未捕获异常: {str(e)}\n")
        sys.exit(1)

if __name__ == '__main__':
    main()
五、验证测试与边界防御注意事项
在生产系统正式集成时,建议通过以下清单进行全面验证,以防在特殊边缘场景下偶发错误:
- 特殊字符与空格测试:将整个项目部署在包含空格及中文的路径下(例如
/Users/workspace/测试 目录/或 Windows 上的D:\Project Files\Test),运行测试用例。如果采用的是spawn(executable, [scriptPath]),由于操作系统原生 API 是以数组形式直接传递给可执行文件参数表,无论路径中包含多少空格均能准确定位;若是使用exec拼接字符串,则会发生解析断裂。 - 大体积输出流的死锁防范:操作系统的管道缓冲区容量有限(通常为 64KB)。如果 Python 脚本向
stdout或stderr写入海量数据,而 Node.js 侧未及时监听data事件消耗缓冲区,子进程的写操作将被系统挂起导致死锁卡死。使用封装中的流式监听处理(如child.stdout.on('data'))可及时消费缓冲区,保障流管道畅通无阻。 - 退出状态码校验:务必同时监听
child.on('error')和child.on('close', code => ...)。解释器本身不存在会触发error,而 Python 运行期内部未捕获的异常(如语法错误、模块未导入)则会触发非 0 的exitCode。双重捕获能够确保 Promise 绝不会变成未决(Pending)状态。
- 出现
spawn ENOENT:首先检查传入的第一个参数(Python 解释器路径)是否存在。 - 出现
[Errno 2] No such file:检查传递给 Python 的脚本路径,改用path.resolve(__dirname, ...)。 - 出现
UnicodeEncodeError:在spawn的env中补充PYTHONIOENCODING: 'utf-8'。 - 中文输出呈现为乱码或替代字符:改用
StringDecoder拼装流式字节块,并在 Python 中指定ensure_ascii=False。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









