

Python自然语言处理入门:NLTK、spaCy与Transformers库怎么选
面向Python自然语言处理初学者,全面对比NLTK、spaCy与Transformers三大核心库的架构定位、处理流程、性能差异与应用场景,提供清晰实用的选型指南与工程建议。
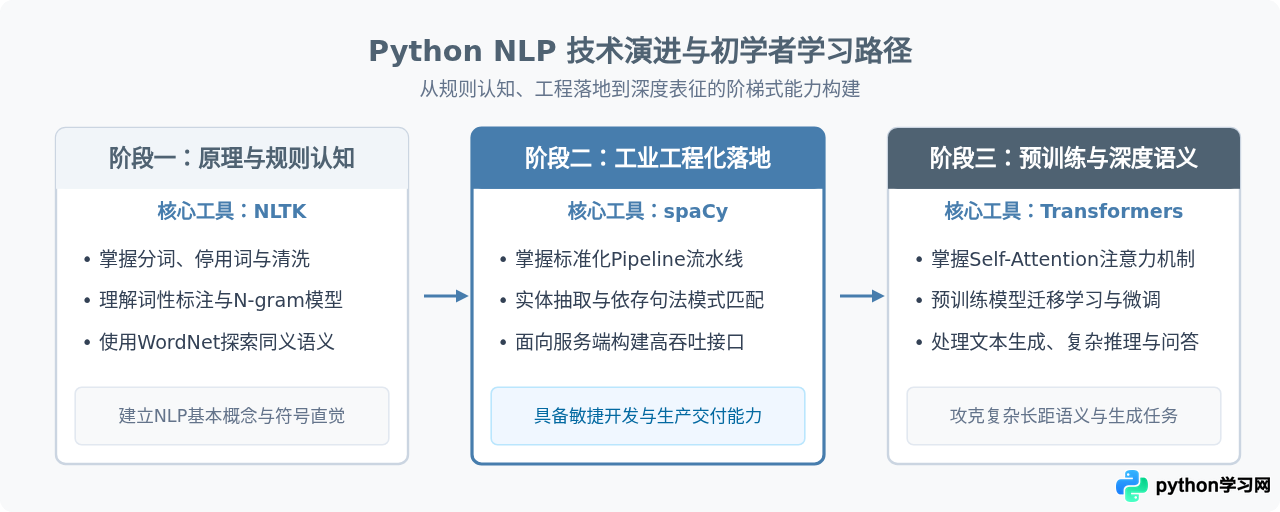
刚接触Python自然语言处理(NLP)时,面对NLTK、spaCy和Transformers这三个频繁出现的库,许多开发者常常陷入困惑:它们的功能看起来高度重叠,到底该学哪一个?结论非常明确:如果是学习语言学基础概念、进行语料统计或做教学演示,选NLTK;如果是构建需要高吞吐、低延迟并用于实际生产环境的信息抽取系统,选spaCy;如果是为了解决复杂语义理解、情感分析或文本生成等高级任务,且具备GPU算力,直接选Transformers。这三个库代表了NLP工程发展的三个不同阶段与设计哲学,理解它们的差异是合理选型的前提。
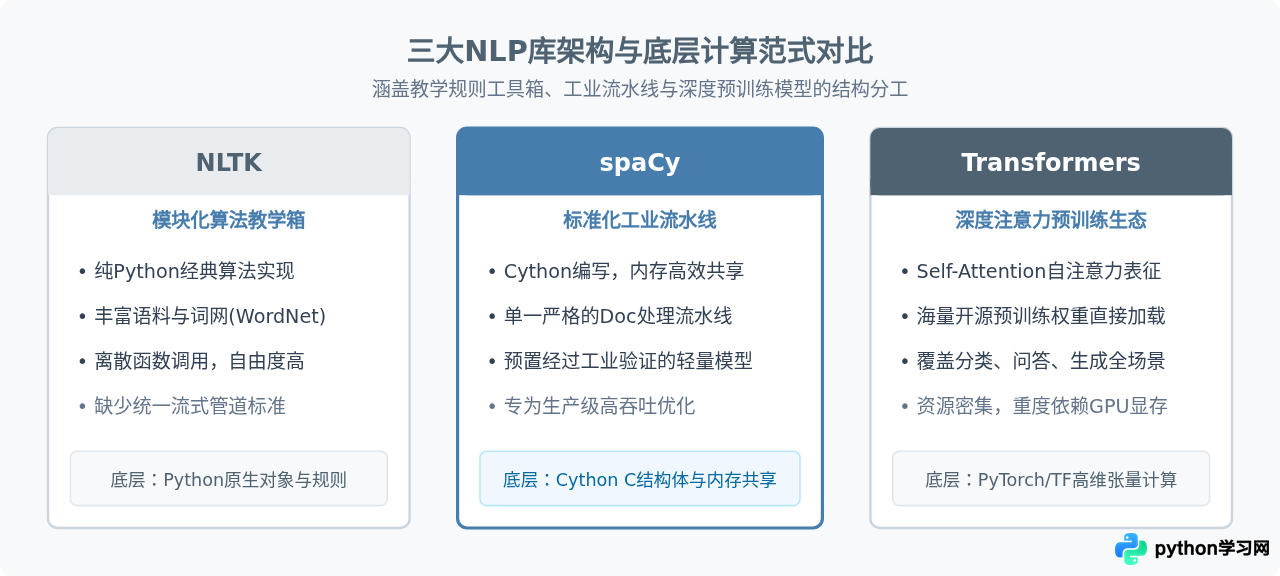
三大库的核心定位与架构差异
自然语言处理涉及从字符切分到深层语义建模的完整链路。这三个库之所以在各自领域保持优势,关键在于它们的底层架构与核心设计目标截然不同:
- NLTK(Natural Language Toolkit)—— 算法教学与学术研究的标准工具箱:NLTK创立于2001年,初衷是作为宾夕法尼亚大学计算语言学教学的辅助工具。它提供了大量经典的语言学算法实现以及超过50个经典语料库(如WordNet、Brown语料库)。它的架构是松散的函数库组合,各个模块相对独立,开发者可以清晰看到每个步骤的实现细节。但由于其主要是纯Python编写,在大规模文本处理时的吞吐性能较为有限。
- spaCy —— 为工业工程落地打造的高性能流水线:由Explosion AI在2015年推出,spaCy的设计宗旨是“商业级别的自然语言处理”。它的底层完全使用Cython编写,重点优化了内存共享与指针操作。与NLTK提供多种不同算法供用户选择不同,spaCy奉行“每类问题只提供一个最优实现”的极简哲学,并围绕统一的
Doc对象设计了标准化的处理流水线(Pipeline)。 - Transformers —— 深度预训练与大语言模型生态核心:由Hugging Face团队维护,是伴随BERT、GPT等Transformer架构兴起而重构现代NLP的代表。它摒弃了传统的词汇规则匹配,基于自注意力机制(Self-Attention)提供上万个预训练模型权重。Transformers的关注点在于深度表征与迁移学习,适合解决表层规则难以捕捉的复杂歧义与深层上下文。
典型任务操作链路与代码实现对比
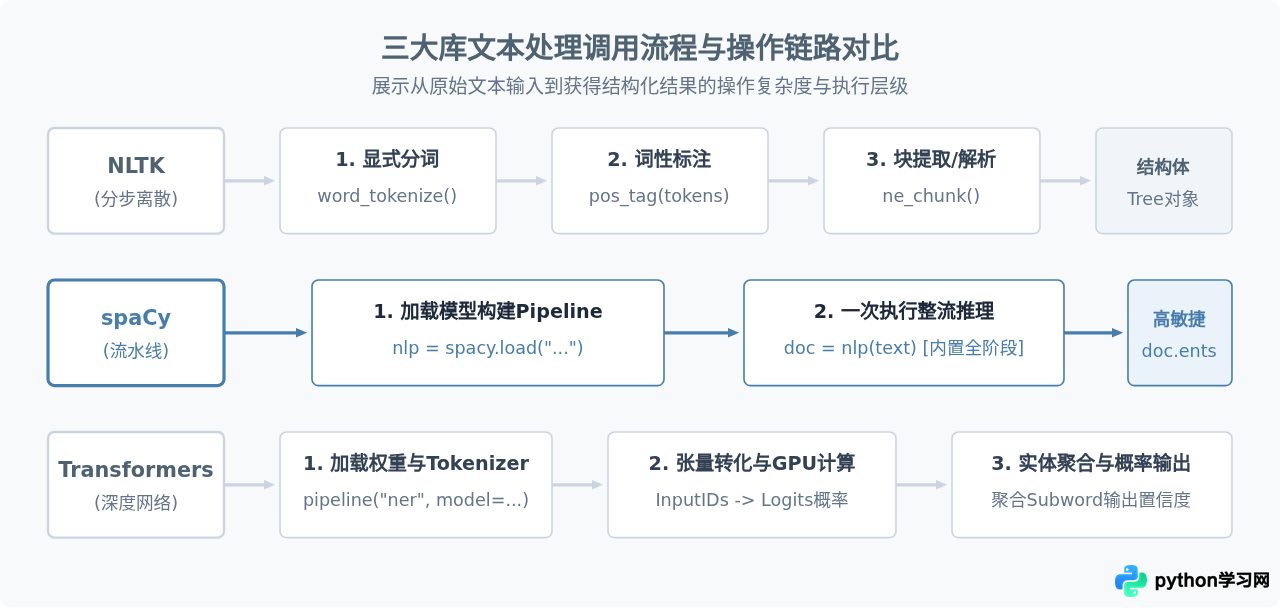
为了直观感受三者的使用模式,我们以常见的信息抽取任务(分词、词性标注及命名实体识别)为例,观察在三个库中分别如何编写与执行。
1. NLTK 的多步骤显式调用
在NLTK中,每个处理环节通常对应独立的函数或类。开发者需要先明确下载对应的数据包,然后逐级转换数据结构:
import nltk

# 首次运行前需下载必要语料与模型数据包
nltk.download('punkt')
nltk.download('averaged_perceptron_tagger')
nltk.download('maxent_ne_chunker')
nltk.download('words')

text = "Steve Jobs presented iPhone at the Macworld conference in San Francisco."

# 第一步:显式分词
tokens = nltk.word_tokenize(text)

# 第二步:词性标注
tagged = nltk.pos_tag(tokens)

# 第三步:浅层命名实体块分析
named_entities = nltk.ne_chunk(tagged)

# 打印生成的树结构
print(named_entities)代码特征:流程完全由开发者手动驱动。这种方式非常适合教学,读者能清晰看到分词结果如何输入给词性标注器,再传递给实体识别块。但代码中包含了较多的中间变量,难以直接应对高并发批量处理。
2. spaCy 的标准化流水线处理
spaCy通过模型加载构建单向流水线。文本传入后一次性完成所有分析,并直接挂载在属性上:
import spacy

# 运行前需通过终端下载模型:python -m spacy download en_core_web_sm
nlp = spacy.load("en_core_web_sm")

text = "Steve Jobs presented iPhone at the Macworld conference in San Francisco."

# 单次调用执行完整流水线(分词、词性、依存句法、实体识别)
doc = nlp(text)

# 直接遍历预先计算好的实体
for ent in doc.ents:
print(f"实体: {ent.text:<15} 标签: {ent.label_}")代码特征:接口高度标准化。输入字符串,输出统一的Doc对象。不仅逻辑清晰,而且底层自动启用了C级别的连续内存分配,处理长文本速度非常快。
3. Transformers 的端到端预训练推理
Transformers通过pipeline高层封装提供开箱即用的深度推理能力,也可以直接加载分词器与模型权重:
from transformers import pipeline

# 初始化命名实体识别管线(自动下载预训练权重与分词配置)
ner_pipeline = pipeline(
    task="ner",
    model="dslim/bert-base-NER",
    aggregation_strategy="simple"
)

text = "Steve Jobs presented iPhone at the Macworld conference in San Francisco."

# 模型前向推理并后处理聚合
results = ner_pipeline(text)

for entity in results:
print(f"实体: {entity['word']:<15} 类别: {entity['entity_group']} 置信度: {entity['score']:.4f}")代码特征:输入文本会被转化为Subword(子词片段)并映射为数值张量,经由多层Self-Attention网络运算输出预测概率分布。它能够识别极其复杂的上下文依存,但每次调用的算力开销远超前两者。
核心选型考量维度
在实际项目选型时,不能单凭“名气大”或“最新”做决定,必须结合计算资源、语种特征以及工程交付要求进行多维度衡量:
| 对比维度 | NLTK | spaCy | Transformers |
|---|---|---|---|
| 执行效率与吞吐量 | 较低(纯Python实现,适合小规模数据与离线脚本) | 极高(Cython底层优化,CPU单核每秒处理万级词汇) | 依赖硬件(CPU推理较慢,通常必须配备GPU加速) |
| 中文支持与适配度 | 弱(无现代官方中文模型,分词通常需外接jieba) | 良(官方提供zh_core_web系列,安装即用,支持词性标注与NER) | 极强(开源社区拥有大量中文预训练模型,如MacBERT、Chinese-RoBERTa等) |
| 硬件资源门槛 | 极低(普通笔记本、微型服务器均可顺畅运行) | 低(内存开销可预测,适合容器化无GPU部署) | 高(模型权重动辄数百兆至数吉字节,显存占用大) |
| API稳定性与工程化 | 偏松散(学术风格,缺少统一流水线规范) | 优秀(高度工程化,开箱即用,支持自定义流水线插件) | 良好(Hugging Face生态活跃,但版本迭代频繁,架构较重) |
| 解决复杂语义能力 | 有限(主要基于规则和浅层统计) | 中等(在标准实体提取与短文本结构化上表现优秀) | 顶尖(基于深层自注意力机制,擅长上下文消歧与长距依赖) |
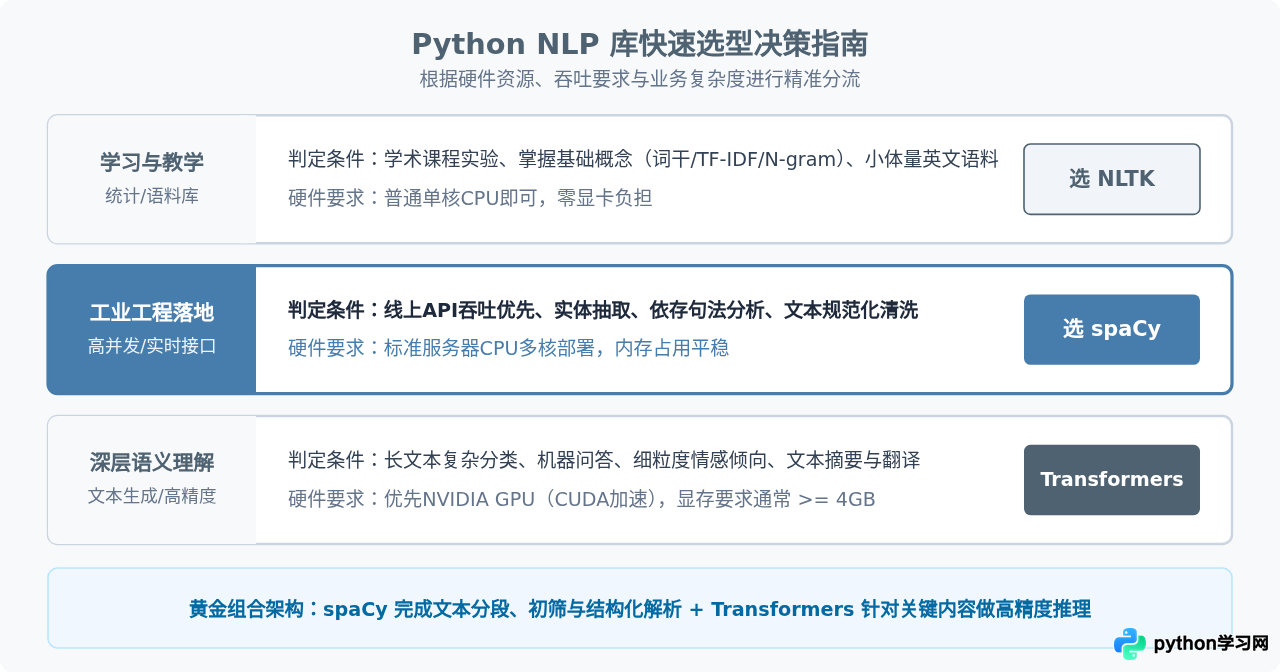
场景化选型决策指南
为了在具体业务或学习任务中快速做出决断,你可以按照以下典型场景进行对号入座:
场景 1:学术作业、教材复现与语言学分析 —— 选用 NLTK
如果你正在大学课程中学习自然语言处理,或者需要复现经典的统计语言学论文、分析英文语料的词性分布、查看词频共现或通过WordNet探查义原关系,NLTK是最好的选择。它不需要繁琐的深度学习环境配置,能让你专注于算法本身的设计细节。
场景 2:线上生产系统、高吞吐API与文本实体清洗 —— 选用 spaCy
如果你的任务是为公司搭建后端服务,例如从海量用户反馈中提取人名、地名、机构名,或者做句子依赖关系提取与规则匹配,且服务器没有GPU显卡,spaCy是当之无愧的首选。其稳定的内存管理和极低的延迟能保证服务在高并发下的稳定性。
场景 3:深层情感分析、文本摘要生成与意图识别 —— 选用 Transformers
当面临以下情况时,应直接选用Transformers:需要识别隐喻、反讽等复杂情感;需要高精度的长文本分类;或者需要做机器翻译、摘要提取与自动问答。尽管它对算力要求较高,但在语义理解精度上具有显著优势。
工程混合实践推荐:在成熟的大型文本系统中,通常采用“spaCy + Transformers”的组合架构。先使用轻量的spaCy进行快速分句、清洗与规则过滤,剔除无效文本;随后将真正包含复杂业务逻辑的关键句送入Transformers进行深度特征提取与分类,从而在性能与精度之间达到平衡。
常见误区与避坑建议
在选择和使用这三个库的过程中,初学者最容易踩到以下几个技术陷阱:
- 误区一:盲目用Transformers替代所有简单任务。大模型虽然表现优异,但推理延迟和显存成本非常可观。如果只是为了从规律文本中提取日期、邮箱或预定义的人名,使用spaCy或纯正则不仅能快数百倍,而且部署维护极其轻松。
- 误区二:在生产后端用NLTK拼凑业务流程。NLTK的代码结构非常适合在Jupyter Notebook中做探索,但在多线程或异步Web服务器(如FastAPI、Tornado)中,其全局状态管理和纯Python循环极易成为性能瓶颈,甚至引发内存泄漏。
- 误区三:忽略分词粒度对后续任务的影响。NLTK默认基于空格和规则分词,中文适配难度大;spaCy将词汇拆分为标准Token;而Transformers采用WordPiece或BPE子词分词(如将生僻词拆解为多个
##片段)。若混淆了这几种Token机制,在进行命名实体对齐或跨库传递特征时很容易产生字符偏移错位。
总结而言,NLTK是帮你“搞懂NLP原理”的导师,spaCy是帮你“快速稳定交付系统”的瑞士军刀,而Transformers则是帮你“突破深层语义上限”的重型武器。根据你的学习目标、业务诉求与算力预算合理组合,才能在NLP项目中事半功倍。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









