

Python使用Hugging Face模型离线本地翻译方案
详解如何在完全离线的内网环境中使用Python与Hugging Face开源模型实现高质量本地机器翻译,涵盖模型固化下载、路径锁定、Transformers与CTranslate2推理代码及长文本批处理优化。
在企业内部系统、保密数据处理或无外网连接的专用服务器中,调用商业云端翻译 API 往往受到合规审计与网络物理隔离的双重制约。在 Python 中实现完全离线的本地翻译方案,核心路径非常清晰:在有网络的环境中预先下载开源翻译模型与分词器权重,持久化到本地固定目录;随后在离线主机中,通过 Hugging Face 的 transformers 库加载该本地路径,并严格开启 local_files_only=True 彻底切断外部网络探测,由本地 CPU 或 GPU 独立执行文本编码、张量生成与目标语言解码。
一、离线翻译系统的运行架构与工作流程
构建稳定离线翻译系统的关键,在于将“模型资产准备”与“离线推理运行”两个阶段彻底解耦。整个生命周期包含模型下载导出、物理介质转移、隔离环境初始化以及流水线推理四个核心环节。
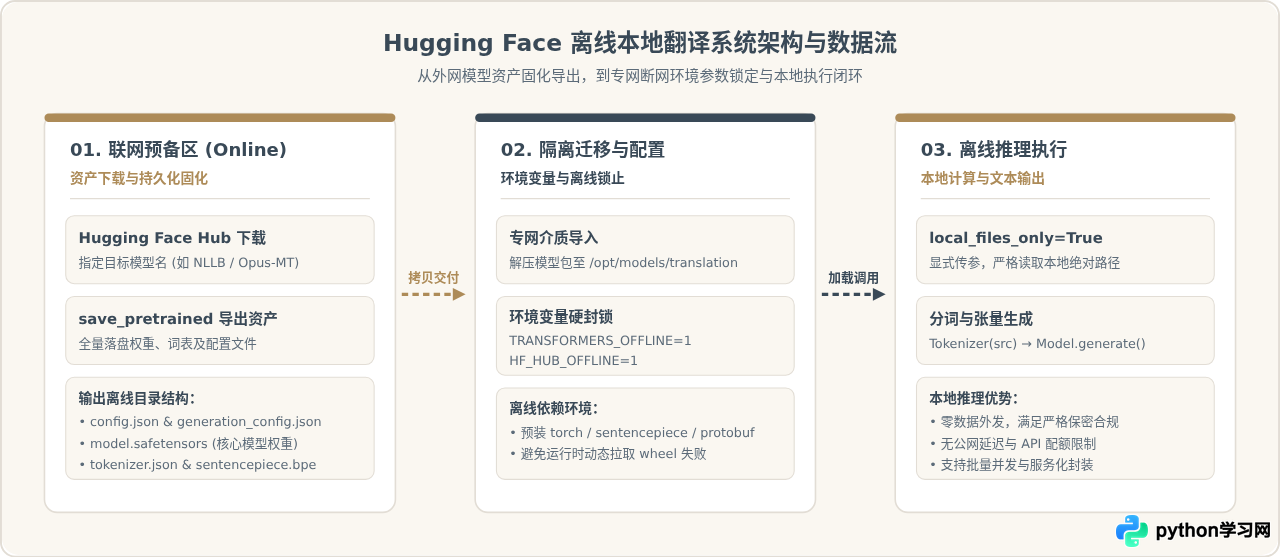
在离线执行中,最容易被忽视的是分词器(Tokenizer)对第三方底层依赖的隐式要求。例如许多神经机器翻译模型依赖 sentencepiece 或 protobuf 进行文本切分,如果在联网机器上只导出了模型权重而未在目标离线机上打包对应的 wheel 安装包,运行期就会在分词阶段抛出导入错误。因此,资产准备不仅包含模型文件,还包括执行环境的完整闭环。
二、常用开源离线翻译模型选型与对比
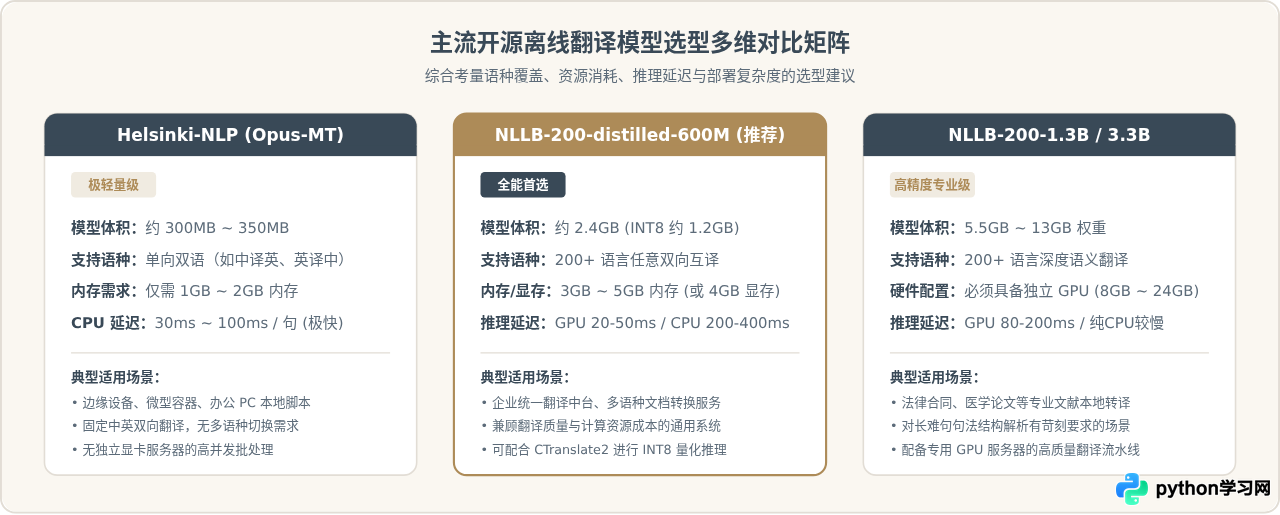
在离线环境下,硬件算力(尤其显存与 CPU 性能)通常固定,因此选择最匹配业务场景的模型至关重要。目前开源社区中成熟度最高的翻译模型主要分为两类:专精单一语言对的轻量模型与支持大规模语种的多语言翻译模型。
| 模型系列 | 典型代表 | 权重大小 | 支持语种 | 硬件建议 | 核心优势与局限 |
|---|---|---|---|---|---|
| Helsinki-NLP Opus-MT | opus-mt-zh-en / opus-mt-en-zh | 约 310 MB | 单向双语对 | 4核 CPU / 2GB 内存 | 体积超小、冷启动极快;缺点是每增加一个语向需单独维护一套权重。 |
| Meta NLLB-200 | nllb-200-distilled-600M | 约 2.4 GB | 200+ 种语言全互译 | 8核 CPU 或 4GB+ 显存 GPU | 语种覆盖全面、翻译质量高;显存占用高于专用模型,支持 INT8 压缩。 |
| Meta NLLB-200 进阶版 | nllb-200-1.3B / 3.3B | 约 5.5 GB / 13 GB | 200+ 种语言全互译 | 专用 GPU(8GB - 24GB) | 长难句与专业术语翻译更精确;需要专用推理显卡,纯 CPU 运行延迟大。 |
三、分步实施操作流程
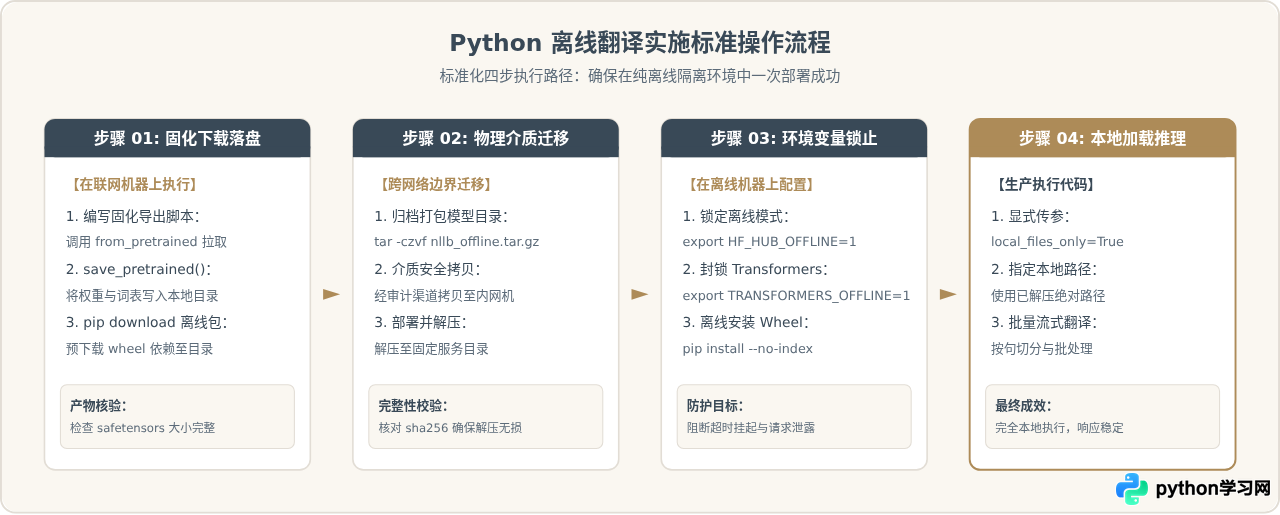
实施一套稳定的 Python 离线翻译系统,需要按照以下四个标准步骤逐一落地:在联网环境中导出模型与构建离线轮子、拷贝至离线生产环境、配置路径与离线环境锁、执行本地代码推理。
步骤一:在联网机器上固化下载模型
在具备外网访问权限的设备上,执行以下脚本将指定模型及其分词器完整保存到本地目录中(以 Meta 开源的 facebook/nllb-200-distilled-600M 为例):
# download_model.py(在联网机上执行)
import os
from transformers import AutoTokenizer, AutoModelForSeq2SeqLM

MODEL_NAME = "facebook/nllb-200-distilled-600M"
TARGET_DIR = "./nllb-200-distilled-600M-offline"

print(f"正在从 Hugging Face 下载并固化模型: {MODEL_NAME} ...")
os.makedirs(TARGET_DIR, exist_ok=True)

# 1. 下载并固化分词器
tokenizer = AutoTokenizer.from_pretrained(MODEL_NAME)
tokenizer.save_pretrained(TARGET_DIR)

# 2. 下载并固化模型权重
model = AutoModelForSeq2SeqLM.from_pretrained(MODEL_NAME)
model.save_pretrained(TARGET_DIR)

print(f"模型已成功固化保存至目录: {os.path.abspath(TARGET_DIR)}")
下载完成后,检查 TARGET_DIR 目录,必须确保包含以下核心文件:
config.json与generation_config.json:模型结构与解码策略配置;model.safetensors或pytorch_model.bin:核心权重文件(体积通常在数 GB 级别);tokenizer.json、sentencepiece.bpe.model、special_tokens_map.json:完整的分词字典与切词规则。
步骤二:离线环境参数硬锁定与加载
将导出的文件夹复制至离线服务器(例如部署在 /opt/models/nllb-200-distilled-600M)。在 Python 代码或系统环境变量中,显式设定离线模式:
# 在离线机器的终端或启动脚本中配置
export HF_HUB_OFFLINE=1
export TRANSFORMERS_OFFLINE=1
四、离线翻译 Python 实现代码与长文本分段
在实际业务中,直接将超长段落传入 Seq2Seq 模型会触发最大序列长度截断(例如 NLLB 默认上下文限制为 1024 词元)。因此,生产代码应包含:路径锁定、语言代码指定(针对 NLLB 多语言场景)以及长文本按句智能切分机制。
# offline_translator.py(在完全离线机器上运行)
import os
import re
import torch
from transformers import AutoTokenizer, AutoModelForSeq2SeqLM

# 强制开启断网模式,防止内部代码意外发起 DNS 解析或 HTTPS 请求
os.environ["TRANSFORMERS_OFFLINE"] = "1"
os.environ["HF_HUB_OFFLINE"] = "1"

class OfflineTranslator:
    def __init__(self, model_dir: str, device: str = None):
        """
        初始化离线翻译器
        :param model_dir: 本地模型资产存放的绝对或相对路径
        :param device: "cuda" 或 "cpu",若为 None 则自动检测
        """
        if not os.path.isdir(model_dir):
            raise FileNotFoundError(f"本地模型目录不存在: {model_dir}")

        if device is None:
            self.device = "cuda" if torch.cuda.is_available() else "cpu"
        else:
            self.device = device

        print(f"[*] 正在从本地加载离线模型: {model_dir}")
        print(f"[*] 推理计算设备: {self.device}")

        # local_files_only=True 确保绝对不请求外网
        self.tokenizer = AutoTokenizer.from_pretrained(
            model_dir,
            local_files_only=True
        )
        self.model = AutoModelForSeq2SeqLM.from_pretrained(
            model_dir,
            local_files_only=True
        ).to(self.device)

        # 切换为评估模式,关闭 Dropout 节省计算
        self.model.eval()

    def _split_sentences(self, text: str) -> list:
        """根据标点符号切分长文本为句子列表,规避模型单次长度截断"""
        sentences = re.split(r'(。|!|?|\. |\! |\? |\n)', text)
        result = []
        for i in range(0, len(sentences) - 1, 2):
            s = sentences[i].strip() + sentences[i+1].strip()
            if s:
                result.append(s)
        if len(sentences) % 2 == 1 and sentences[-1].strip():
            result.append(sentences[-1].strip())
        return result if result else [text]

    def translate(self, text: str, src_lang: str = "zho_Hans", tgt_lang: str = "eng_Latn", max_length: int = 512) -> str:
        """
        执行离线翻译
        :param text: 待翻译文本
        :param src_lang: 源语言代码 (NLLB 代码,如 zho_Hans 为简体中文)
        :param tgt_lang: 目标语言代码 (如 eng_Latn 为英文)
        """
        if not text.strip():
            return ""

        # 设置 NLLB 分词器的源语言
        self.tokenizer.src_lang = src_lang
        # 获取目标语言的特定强制 token id
        tgt_lang_id = self.tokenizer.convert_tokens_to_ids(tgt_lang)

        chunks = self._split_sentences(text)
        translated_chunks = []

        with torch.no_grad():
            for chunk in chunks:
                inputs = self.tokenizer(
                    chunk,
                    return_tensors="pt",
                    padding=True,
                    truncation=True,
                    max_length=max_length
                ).to(self.device)

                # 生成翻译结果
                generated_tokens = self.model.generate(
                    **inputs,
                    forced_bos_token_id=tgt_lang_id,
                    max_new_tokens=max_length,
                    num_beams=4,
                    early_stopping=True
                )

                decoded_text = self.tokenizer.batch_decode(
                    generated_tokens,
                    skip_special_tokens=True
                )[0]
                translated_chunks.append(decoded_text)

        # 针对中英互译自然连接
        if tgt_lang.startswith("zho"):
            return "".join(translated_chunks)
        return " ".join(translated_chunks)


if __name__ == "__main__":
    # 示例调用(此处路径为本地预先解压好的目录)
    LOCAL_MODEL_PATH = "/opt/models/nllb-200-distilled-600M"

    # 初始化翻译引擎
    translator = OfflineTranslator(model_dir=LOCAL_MODEL_PATH)

    # 中译英测试
    sample_zh = "在完全离线的生产环境中部署开源深度学习模型,能够有效保证数据安全并大幅降低接口延迟。"
    en_result = translator.translate(sample_zh, src_lang="zho_Hans", tgt_lang="eng_Latn")
    print("\n[示例翻译结果 - 中译英]:")
    print(f"原文: {sample_zh}")
    print(f"译文: {en_result}")

    # 英译中测试
    sample_en = "Deploying local models ensures zero external data leakage and robust computational privacy."
    zh_result = translator.translate(sample_en, src_lang="eng_Latn", tgt_lang="zho_Hans")
    print("\n[示例翻译结果 - 英译中]:")
    print(f"原文: {sample_en}")
    print(f"译文: {zh_result}")
执行输出说明(示例):
运行上述脚本后,在纯无网的控制台中将看到如下打印日志,模型无需任何外网握手即可完成初始化与推理:
[*] 正在从本地加载离线模型: /opt/models/nllb-200-distilled-600M[*] 推理计算设备: cpu[示例翻译结果 - 中译英]: Deploying open-source deep learning models in fully offline production environments can effectively ensure data security and significantly reduce interface latency.
五、进阶性能优化:使用 CTranslate2 实现量化加速
在只有 CPU 的工控机、普通虚拟机或边缘网关上,直接使用 PyTorch 原生推理 600M 或 1.3B 参数的模型可能会面临较高的 CPU 占用与数百毫秒的延迟。OpenNMT 社区开发的 CTranslate2 是目前针对 Transformer 翻译模型推理性能最极致的开源加速引擎。它原生支持 INT8 / INT16 量化,不仅能将模型权重文件与内存占用削减 50% 以上,还能使 CPU 推理吞吐速度提升 2 至 4 倍。
1. 离线模型转换(在联网或预构建机上完成)
# 使用 ct2-transformers-converter 将 Hugging Face 权重转为 CTranslate2 INT8 模型
ct2-transformers-converter \
    --model /opt/models/nllb-200-distilled-600M \
    --output_dir /opt/models/nllb-600m-ct2-int8 \
    --quantization int8 \
    --force
2. CTranslate2 极速离线推理调用
# ct2_offline_infer.py
import ctranslate2
import transformers

CT2_MODEL_PATH = "/opt/models/nllb-600m-ct2-int8"

# 1. 初始化 CTranslate2 翻译器(设置 intra_threads 充分利用多核 CPU)
translator = ctranslate2.Translator(
    CT2_MODEL_PATH,
    device="cpu",
    intra_threads=4,
    compute_type="int8"
)

# 2. 分词器依然使用本地原有的分词规则
tokenizer = transformers.AutoTokenizer.from_pretrained(
    CT2_MODEL_PATH,
    local_files_only=True
)
tokenizer.src_lang = "zho_Hans"

# 3. 分词转换为 Token 字符串序列
source_text = "本地量化模型大幅削减了显存消耗并提升了并发响应速度。"
tokens = tokenizer.convert_ids_to_tokens(tokenizer.encode(source_text))

# 4. 执行极速翻译推理
target_prefix = [tokenizer.convert_ids_to_tokens([tokenizer.convert_tokens_to_ids("eng_Latn")])[0]]
results = translator.translate_batch([tokens], target_prefix=[target_prefix])

# 5. 解码为目标语言
output_tokens = results[0].hypotheses[0][1:]
translated_text = tokenizer.decode(tokenizer.convert_tokens_to_ids(output_tokens))
print("CTranslate2 译文:", translated_text)
六、生产环境关键技术考量与总结
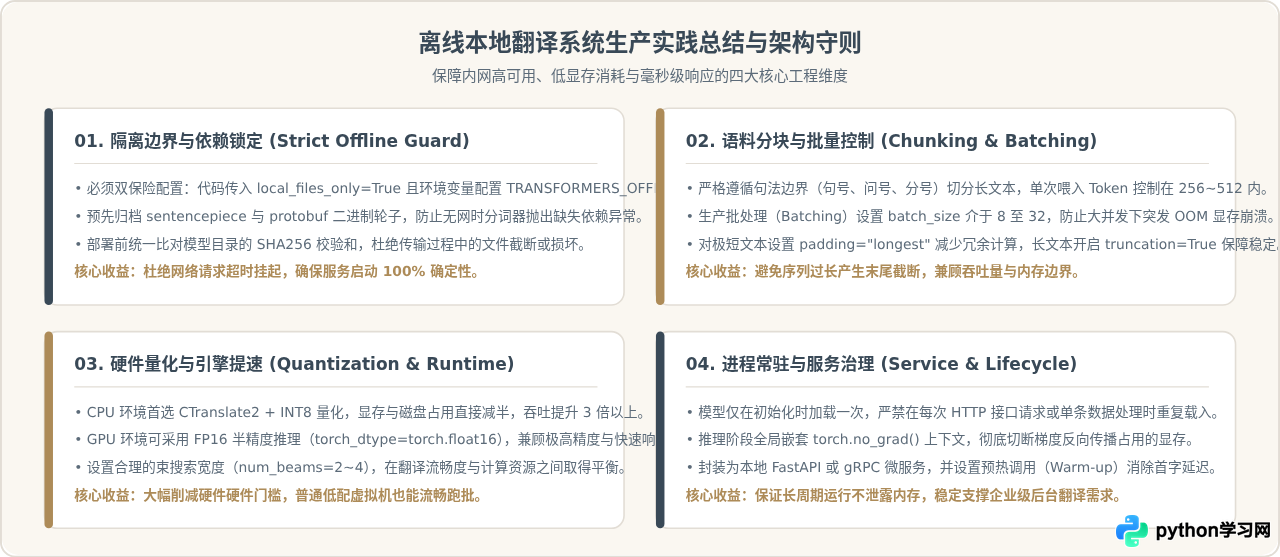
在离线生产环境中落地翻译服务时,除了打通主干流程外,还需在隔离边界、依赖防线、长文切分与常驻服务治理上建立健全的防护措施。
七、方案总结
通过 Hugging Face 生态在 Python 中实现离线本地翻译,实质上是将云端翻译黑盒转化为本地受控的确定性软件资产。针对业务对语言对数量、响应速度与硬件资源的差异,可以采用分级落地策略:对于固定的双语场景,选用 Opus-MT 即可获得极致的轻量性与速度;对于覆盖多语言的通用系统,选用 NLLB-200-distilled-600M 并结合 CTranslate2 INT8 量化 是当前生产落地中最具性价比与稳定性的工业级方案。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









