

Python字符串按分隔符拆分为列表:split()方法详解
深入详解Python中str.split()方法的使用规范、底层机制、sep与maxsplit参数设置,对比默认空白拆分与显式空格拆分的关键差异,并提供常见场景解决方案与避坑指南。
在Python文本处理与数据清洗过程中,将一个完整的连续字符串按照指定标记拆分为多个子元素并存入列表,是最常见的基础操作。Python内置的 str.split() 方法提供了高效、规范的切分能力。调用该方法后,Python会扫描目标字符串,根据给定的分隔符将其切割成若干片段,最终返回一个包含所有切分结果的新列表,而原始字符串本身保持不变。
一、方法签名与参数解析
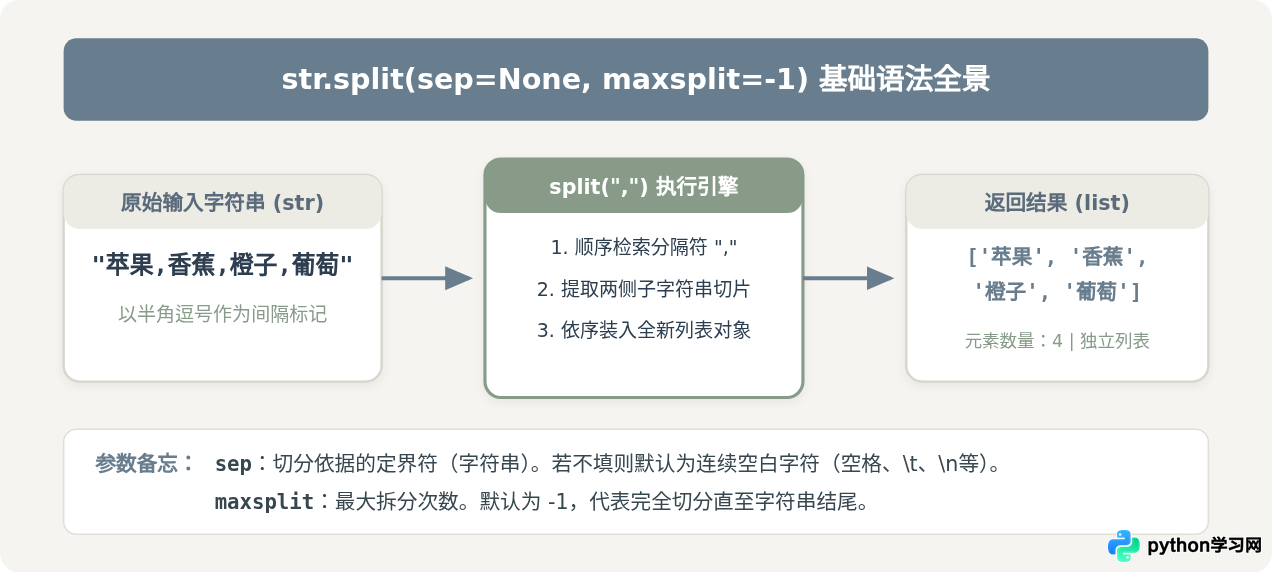
在Python官方文档中,split() 方法的完整原型如下:
str.split(sep=None, maxsplit=-1)该方法包含两个可选参数,其行为由这两个参数的取值共同决定:
- sep (separator):指定用作分隔符的字符串。默认值为
None。如果未指定或者传入None,Python会启用内置的空白符聚集处理规则;如果传入具体字符串(如逗号、冒号、空格或多字符组合),则完全按照该字符进行精确匹配。 - maxsplit:指定拆分的最大次数。默认值为
-1,表示“不限制拆分次数”,即只要遇到分隔符就会进行切分。若指定为正整数n,则最多切分n次,得到的列表长度最多为n + 1。
二、基础操作:按指定分隔符拆分
当处理规整的文本(例如逗号分隔的CSV数据、冒号分隔的系统配置或斜杠分隔的路径)时,需要向 sep 传入明确的字符。
1. 单字符分隔符
以常见的逗号和管道符为例,直接将分隔符作为第一个参数传入:
# 示例 1:切分以逗号分隔的用户标签
tags_text = "python,data-analysis,machine-learning"
tag_list = tags_text.split(",")
print("拆分结果:", tag_list)
print("元素数量:", len(tag_list))2. 多字符复合分隔符
sep 不仅支持单个字符,还可以是任意长度的子字符串。Python会将其作为一个不可拆分的整体单元来寻找匹配点:
# 示例 2:切分包含箭头连接词的流程文本
pipeline_text = "DataLoad -> Clean -> Transform -> Export"
stages = pipeline_text.split(" -> ")
print("流程节点:", stages)三、核心机制对比:split() 默认行为与 split(' ') 的关键差异
初学者极易误认为 text.split() 等价于 text.split(' ')。实际上,两者在面对连续空格、制表符(\t)、换行符(\n)以及首尾空白时,解析逻辑截然不同。理解这一差异是编写稳健文本处理代码的关键。
通过以下代码可以清晰验证两者输出的不同:
raw_content = "   Python    Rust  \t\n  Go   "

# 1. 使用默认参数(推荐常规文本使用)
result_default = raw_content.split()
print("默认 split():", result_default)

# 2. 显式指定单空格
result_explicit = raw_content.split(" ")
print("显式 split(' '):", result_explicit)关键结论:在自然语言处理、日志清洗或用户输入归一化时,如果目的只是“提取所有单词”,务必直接调用 split() 而不要传入 " "。
四、精准控制切分粒度:maxsplit 参数详解
在解析结构化协议(如HTTP报文头、配置文件键值对、固定格式日志)时,字符串中往往只有前几个分隔符具有语义分割作用,后续内容可能包含与分隔符相同的符号。此时,maxsplit 参数可以避免字符串被过度切散。
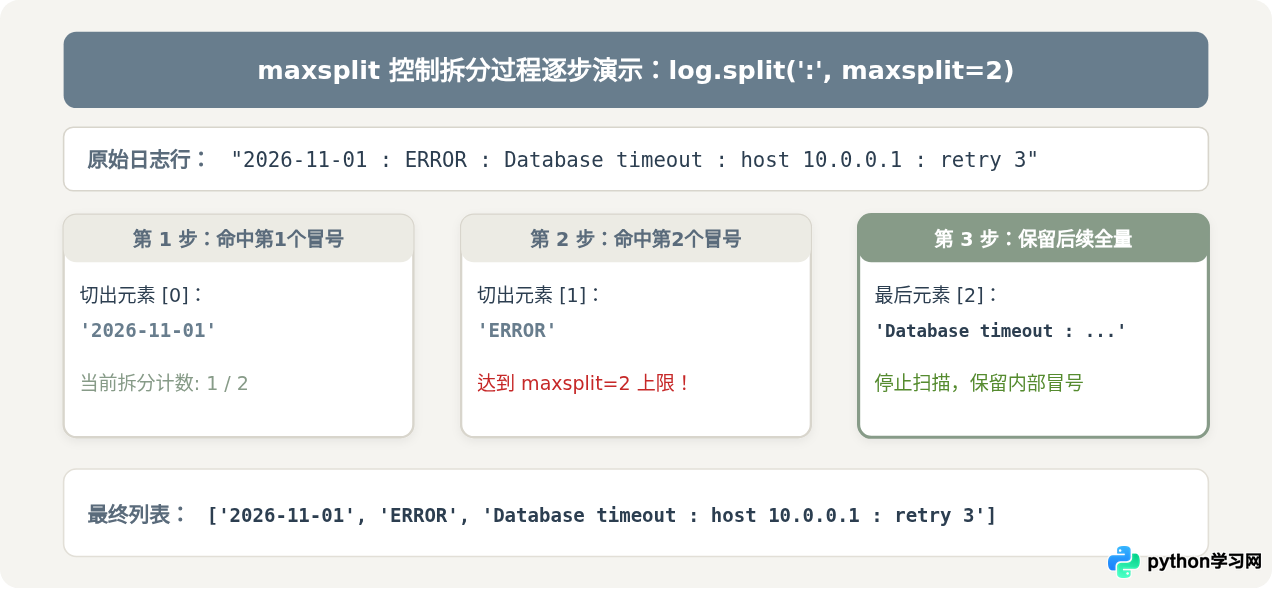
以下是使用 maxsplit 拆分键值对与配置文件的完整代码:
# 场景:解析包含等号的配置项(配置值本身可能也含有等号)
config_entry = "database_uri=postgres://user:pass=word@localhost:5432/app"

# 仅切分第 1 个等号,分成 key 与 value 两部分
key, val = config_entry.split("=", maxsplit=1)

print("Key:", key)
print("Val:", val)如果在此处不设定 maxsplit=1,pass=word 中的等号也会被切开,导致解构赋值失败并抛出 ValueError: too many values to unpack。
五、从右侧切分:rsplit() 方法
除了从左往右扫描的 split(),Python还提供了从右侧开始扫描的 rsplit() 方法:
str.rsplit(sep=None, maxsplit=-1)在不指定 maxsplit 时,split() 与 rsplit() 的切分结果完全一致。但一旦设置了 maxsplit,两者的切分起点即出现方向差异:
split(sep, maxsplit=1):保留最左侧第1个分段,剩余右侧整体保留。rsplit(sep, maxsplit=1):保留最右侧第1个分段,剩余左侧整体保留。
# 场景:提取文件路径的主体与文件扩展名
file_path = "archive.data.backup.tar.gz"

# 从右边切分1次,提取末尾扩展名
parts = file_path.rsplit(".", maxsplit=1)
print("主名称与尾部扩展名:", parts)六、边界情况与常见陷阱排查
当执行 text.split("") 时,Python会直接抛出运行时错误:ValueError: empty separator。如果你的目标是将字符串拆分成单个字符构成的列表,应使用内置函数 list(text)。
处理空字符串时,"".split() 会返回空列表 [];而 "".split(",") 则会返回包含一个空字符串元素的列表 ['']。这是因为显式指定分隔符时,即使没有任何字符,Python也会将整个输入视作一个未命中分隔符的单一片段。
# 空字符串的切分边界测试
print("空字符串默认 split():", "".split())
print("空字符串逗号 split(','):", "".split(","))

# 将字符串拆为字符列表的正确做法
word = "Python"
# print(word.split(""))  # 报错:ValueError: empty separator
print("正确拆为单字符列表:", list(word))七、知识总结与方法选型决策指南
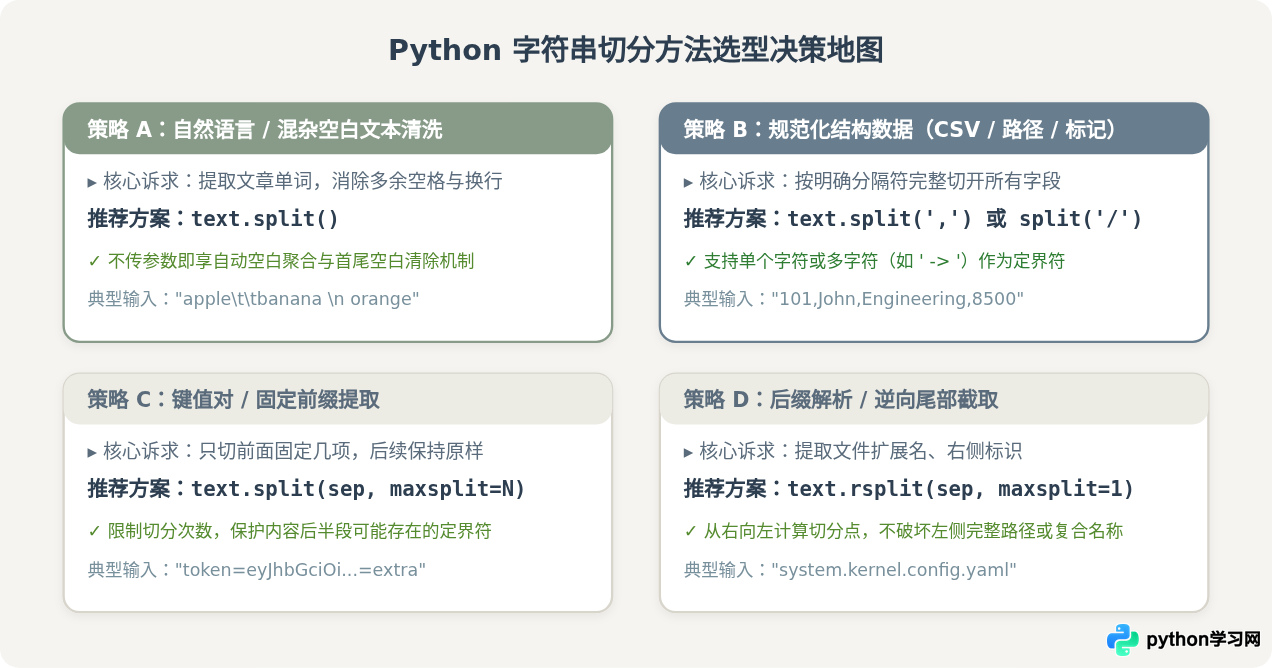
为了在实际编码中快速选择最合理的字符串拆分方案,可参考以下对比总结与决策逻辑:
| 场景需求 | 推荐方法 | 典型示例 | 输出特征 |
|---|---|---|---|
| 清洗不规则文本(提取单词) | s.split() |
" a \t b\n".split() |
['a', 'b'](自动压缩空白,不含空串) |
| 标准分隔符切分(CSV/路径) | s.split(sep) |
"a,b,c".split(',') |
['a', 'b', 'c'](精确匹配) |
| 定长键值对提取(从左截取) | s.split(sep, 1) |
"k=v1=v2".split('=', 1) |
['k', 'v1=v2'](只切一次) |
| 后缀/文件扩展名(从右截取) | s.rsplit(sep, 1) |
"app.test.py".rsplit('.', 1) |
['app.test', 'py'](从右侧拆分) |
| 拆散为单个字符 | list(s) |
list("abc") |
['a', 'b', 'c'](禁止用 split("")) |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









