

TensorFlow与PyTorch学习资源对比:哪份Python机器学习手册更适合你?
深入对比TensorFlow与PyTorch的官方学习手册、体系结构、调试体验、核心代码范式与实操路径,结合详细架构图与决策树,帮助你根据研究与工程目标挑选最适合的机器学习入门指南。
一、官方文档体系与技术生态结构对比
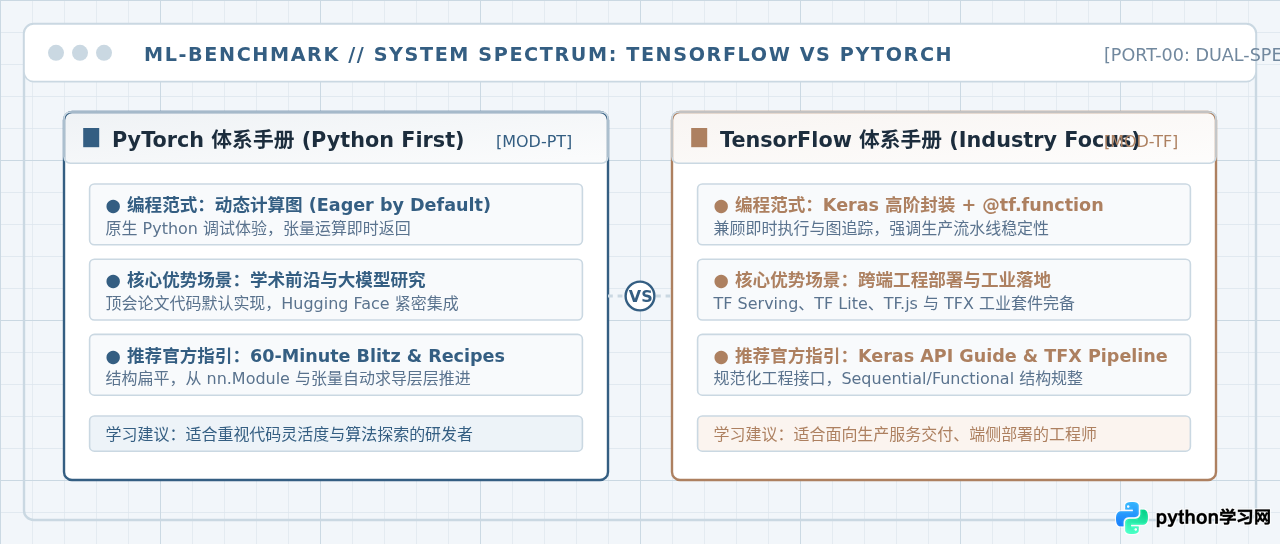
在挑选学习手册时,首先需要理解两个框架官方文档的编写组织逻辑。不同的设计哲学决定了官方手册在知识点编排与学习曲率上的巨大差异。
1. TensorFlow 官方文档体系:模块化与工业交付主导
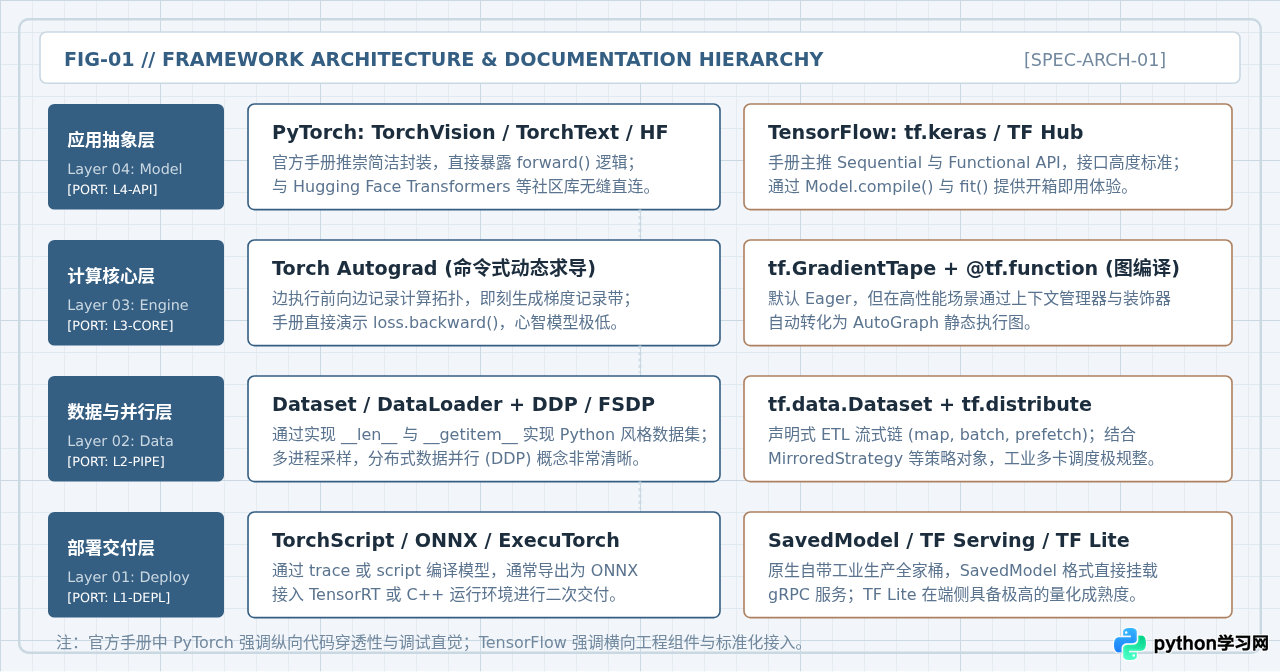
TensorFlow 官方手册(TensorFlow 2.x Guides)以 tf.keras 高阶接口为核心骨架。其组织结构层次鲜明:从最上层的模型构建(Sequential 与 Functional API),逐步下沉至 tf.data(输入流水线)、tf.distribute(分布式策略),最后延伸到部署套件 TFX(TensorFlow Extended)、TF Serving 与 TF Lite。这套手册的优点在于工程规整度极高,所有生产环节的接口都有官方标准的规范解答。
但对于初学者而言,TensorFlow 文档的历史遗留问题构成了最大的认知障碍。在网络检索各类第三方教程时,极易混入旧版 TensorFlow 1.x 的静态会话代码(如 tf.Session() 与占位符 tf.placeholder()),这些语法在 TF 2.x 中早已被废弃或重构。因此阅读 TensorFlow 资料时,读者必须具备识别版本的意识,严格锁定带有 TensorFlow 2.x 标记的官方最新文档。
2. PyTorch 官方文档体系:Python First 与扁平化推进
PyTorch 官方教程(如经典的《Deep Learning with PyTorch: A 60 Minute Blitz》以及官方 Recipes)则坚持“Python First”理念。文档行文如同讲解一个普通的 Python 数学计算库,从张量操作(Tensor)、自动求导(Autograd)、神经网络基类(torch.nn.Module)逐步铺开,没有繁琐的初始化配置过程。
更重要的是,现代深度学习开源生态(例如 Hugging Face Transformers、PyTorch Lightning、timm)均以 PyTorch 原生接口作为首选标准参考。这意味着读者在阅读 PyTorch 官方手册后,能够毫无缝隙地过渡到 GitHub 上的最新学术仓库与模型预训练权重,避免了二次翻译 API 的成本。
二、计算图心智模型与调试排错体验
编写机器学习程序的核心在于构建计算图并计算梯度。两套框架在此处的实现机制不同,直接决定了开发者日常排查 Bug 时的难度与调试手段。
1. 动态图即时求导与符号化图追踪的区别
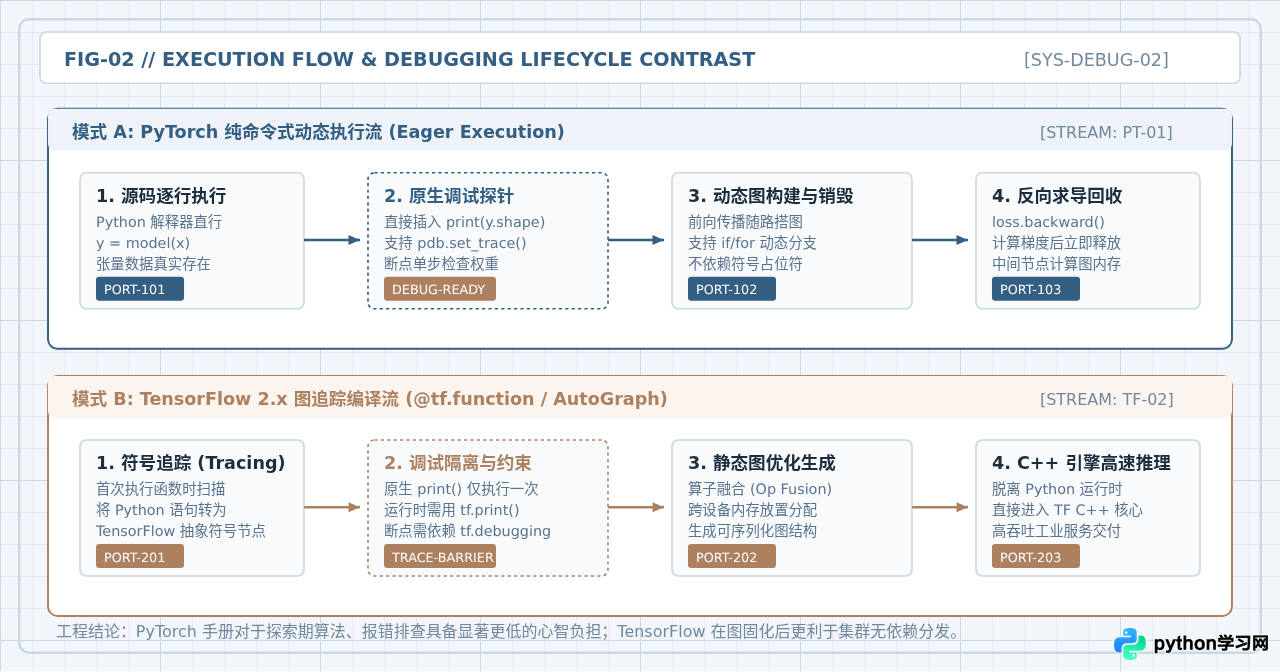
PyTorch 采用纯命令式(Imperative / Eager Execution)机制。当 Python 解释器执行到计算语句时,张量数值即刻产生,并在后台自动记录动态计算历史(Autograd Tape)。遇到张量维度不匹配或数值异常时,开发者可以在任何一行代码前插入 print(tensor.shape),或者直接使用 Python 原生调试器 pdb.set_trace() 暂停程序,单步检查每个张量的实际数值。
TensorFlow 2.x 默认状态下也支持 Eager 模式,但在追求工业级高性能推理与训练时,官方手册要求使用 @tf.function 装饰器将代码编译为静态计算图(AutoGraph)。在图追踪(Tracing)阶段,Python 控制流仅在构筑图时扫描一次,普通的 Python print() 只打印符号信息而非实际数值。如果要在运行时监控张量,必须改用专用的 tf.print(),这给初学者带来了“两套调试心智”的切换负担。
2. 核心代码编写范式对比:线性拟合实战
为了直观感受两份手册推荐的基础代码风格,以下分别给出在相同输入数据下完成一次梯度下降更新的最小完整代码。本示例使用独立脚本运行,环境要求为 Python 3.10+,分别安装 torch 2.0+ 或 tensorflow 2.12+。
# 文件名:demo_pytorch.py
# 执行环境:Python 3.10+ with torch 2.x
import torch
import torch.nn as nn
import torch.optim as optim

# 1. 准备样本数据:形状为 [batch_size, features]
x = torch.tensor([[1.0], [2.0], [3.0], [4.0]], dtype=torch.float32)
y_true = torch.tensor([[2.0], [4.0], [6.0], [8.0]], dtype=torch.float32)

# 2. 定义简单线性模型与损失函数
model = nn.Linear(in_features=1, out_features=1)
criterion = nn.MSELoss()
optimizer = optim.SGD(model.parameters(), lr=0.05)

# 3. 显式前向传播与反向传播三步法
y_pred = model(x)
loss = criterion(y_pred, y_true)

optimizer.zero_grad()  # 必须重置累积梯度
loss.backward()        # 动态图反向求导
optimizer.step()       # 优化器更新权重

# 输出调试验证(可直接打印实际标量值)
print(f"PyTorch Step Loss: {loss.item():.4f}")
print(f"Model Weight: {model.weight.data.numpy()}")# 文件名:demo_tensorflow.py
# 执行环境:Python 3.10+ with tensorflow 2.x
import tensorflow as tf
# 1. 准备样本数据
x = tf.constant([[1.0], [2.0], [3.0], [4.0]], dtype=tf.float32)
y_true = tf.constant([[2.0], [4.0], [6.0], [8.0]], dtype=tf.float32)
# 2. 定义模型层与优化器
layer = tf.keras.layers.Dense(units=1, use_bias=True)
optimizer = tf.keras.optimizers.SGD(learning_rate=0.05)
mse = tf.keras.losses.MeanSquaredError()
# 3. 通过上下文管理器记录梯度
with tf.GradientTape() as tape:
y_pred = layer(x)
loss = mse(y_true, y_pred)
# 计算梯度并由优化器应用更新
gradients = tape.gradient(loss, layer.trainable_variables)
optimizer.apply_gradients(zip(gradients, layer.trainable_variables))
# 输出调试验证
print(f"TensorFlow Step Loss: {float(loss):.4f}")
print(f"Layer Weight: {layer.weights[0].numpy()}")在终端中分别执行上述两个脚本:
python3 demo_pytorch.py
python3 demo_tensorflow.py在 PyTorch 手册中,必须牢记在每次反向传播前显式调用
optimizer.zero_grad()。PyTorch 默认会累加梯度(便于实现大 Batch 梯度累积),若遗漏该语句,多次迭代后梯度将成倍膨胀导致模型发散。而在 TensorFlow 的
tf.GradientTape 机制中,Tape 在默认情况下退出 with 作用域后即被销毁;如需多次求导,必须在创建时显式指定参数 persistent=True。
三、四阶段实操学习路径与手册查阅指引
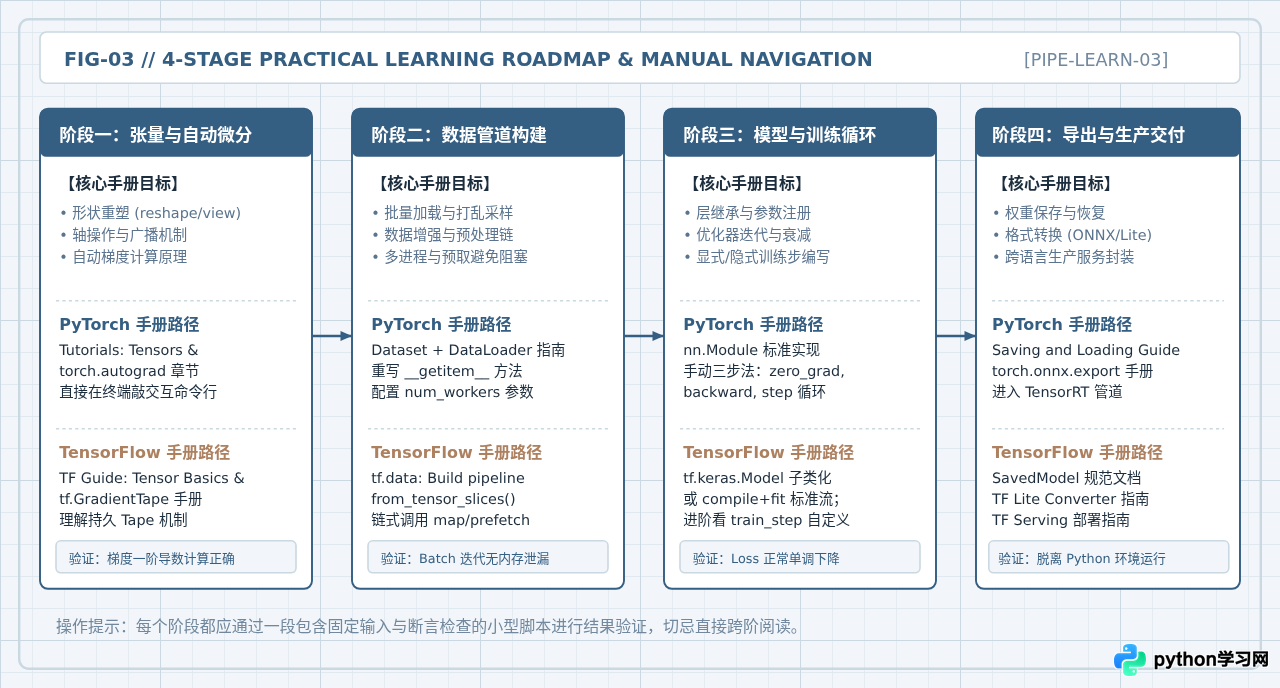
不论阅读哪本手册,系统学习深度学习框架通常包含四个由浅入深的步骤。按照以下标准步骤进行,能够确保每个知识点都有明确的测试产出,避免走入只看不练的死胡同。
阶段一:张量基本操作与自动微分
重点掌握多维张量的创建、切片、形状变换(PyTorch 的 view/reshape 与 TensorFlow 的 tf.reshape)以及广播法则(Broadcasting)。查阅手册时,应重点阅读张量数学算子与一阶导数计算章节,通过交互式命令行编写标量复合函数求导,确认输出与手算梯度一致。
阶段二:数据管道构建与预处理流
这一阶段的核心是解决“显存未跑满,CPU IO 被堵死”的吞吐问题。在 PyTorch 中,应阅读 torch.utils.data.Dataset 和 DataLoader 章节,掌握如何通过重写 __getitem__ 和 __len__ 组织自定义样本;在 TensorFlow 中,重点查阅 tf.data.Dataset 手册,熟练使用 .map()、.batch()、.shuffle() 与 .prefetch(tf.data.AUTOTUNE) 链式流水线。
阶段三:神经网络组装与自定义训练循环
不仅要学会调用现成层(如 Dense/Linear、Conv2d),更要掌握自定义层与损失函数的编写规范。在 PyTorch 中继承 nn.Module 并实现 forward 方法;在 TensorFlow 中掌握 tf.keras.Model 子类化,并理解 train_step 钩子函数的作用,保证在需要魔改算法结构时不会受限于现成高阶 API。
阶段四:模型序列化与生产交付导出
模型训练完成后,需将模型脱离 Python 训练环境交付给下游工程。PyTorch 开发者需要查阅 torch.save(model.state_dict()) 以及 torch.onnx.export 文档,将模型转为 ONNX 格式对接 TensorRT 或 C++ 环境;TensorFlow 开发者则查阅 SavedModel 导出规范以及 TF Lite Converter,生成 .tflite 格式下发至移动端或嵌入式边缘设备。
四、读者选型决策与核心差异总结
结合前文对生态、心智与代码范式的对比,读者应根据自身所处的具体场景与当前目标做出决策,而不是盲目追求“哪一个框架绝对更好”。
1. 针对不同读者背景的选型建议
- 高校科研人员、硕博研究生、算法工程师:优先选择 PyTorch 官方教程。当今顶级学术会议(CVPR、ICCV、NeurIPS、ICLR)以及前沿开源大模型社区(如 Hugging Face、Meta Llama 系列)中,超过 85% 的官方开源代码与预训练权重基于 PyTorch 开发。使用 PyTorch 手册能确保你以最短路径阅读、复现并修改前沿论文代码。
- 企业工业端部署、移动端与嵌入式开发人员:优先选择 TensorFlow 2.x / Keras 手册。如果你的目标是迅速把模型打包挂载到 Java 企业级微服务、C++ 工业机台,或是打包进 Android/iOS 端侧轻量化 App,TensorFlow 的 TF Serving 容器镜像和 TF Lite 量化转换工具链在成熟度与开箱可用性上依然具备强大的工程惯性。
- 初学编程与机器学习的新手:建议优先从 PyTorch 入门。PyTorch 的报错调用栈(Traceback)直观对应 Python 原生代码行,没有图编译与会话抽象的历史包袱,能够帮助你更清晰地看透前向传播与反向传播的物理过程。在完全掌握张量计算原理后,再转去学习 Keras 的工业封装也会变得十分轻松。
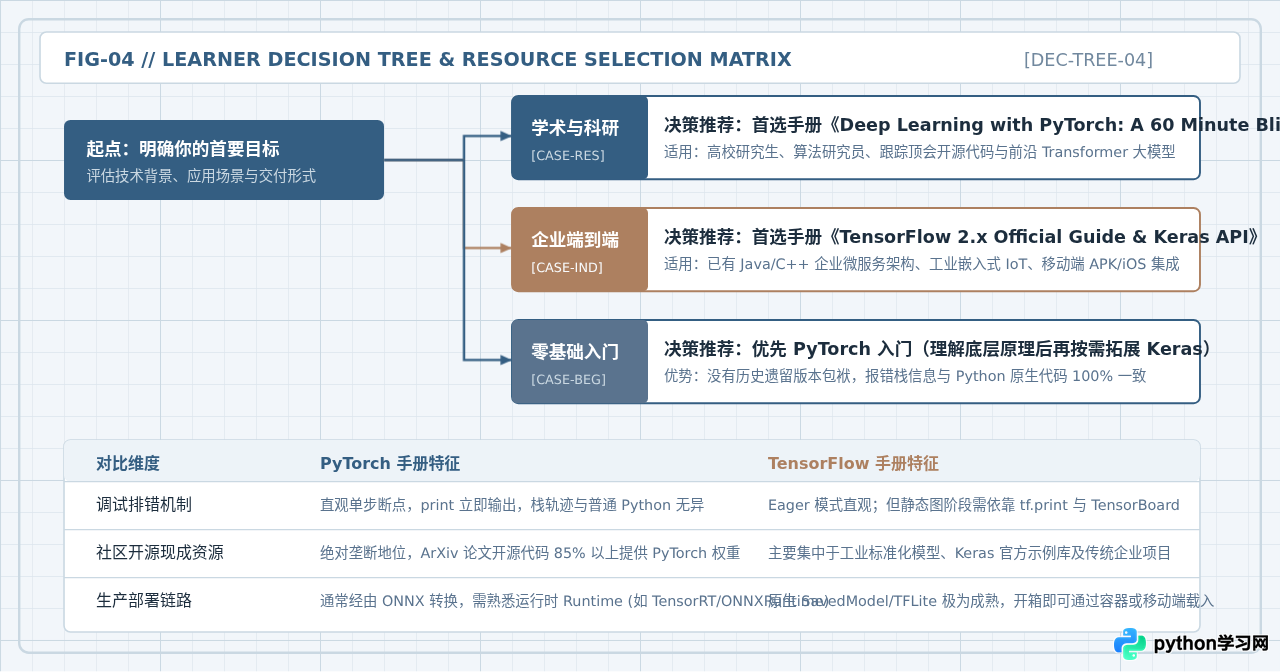
| 对比维度 | PyTorch 官方学习手册 | TensorFlow 2.x 官方手册 |
|---|---|---|
| 主推上手指南 | 《Deep Learning with PyTorch: A 60 Minute Blitz》 | 《TensorFlow 2 quickstart for beginners》& Keras API Guide |
| 编程心智负担 | 极低。与原生 Python 面向对象习惯高度契合 | 中等。Keras 高层极其简明,但底层需理解图追踪逻辑 |
| 报错与调试体验 | 直观友好。报错行精准,原生支持 pdb 与 print | Eager 下良好;在图编译(@tf.function)下定位成本稍高 |
| 前沿算法与论文支持 | 主流统治地位。学术界开源代码默认格式 | 部分老旧论文仍存,新论文多需通过第三方社区重构 |
| 端侧与微服务交付 | 依赖 ONNX / TensorRT / ExecuTorch 等外部工具链 | 原生自带 TF Serving、TFLite 与 TF.js,全栈覆盖完备 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









