

Python re.search返回None导致报错怎么办
针对 Python 中使用 re.search 遇到 'AttributeError: NoneType object has no attribute group' 的报错排查与解决方法,深入分析原因并提供四种工程级稳健应对策略。
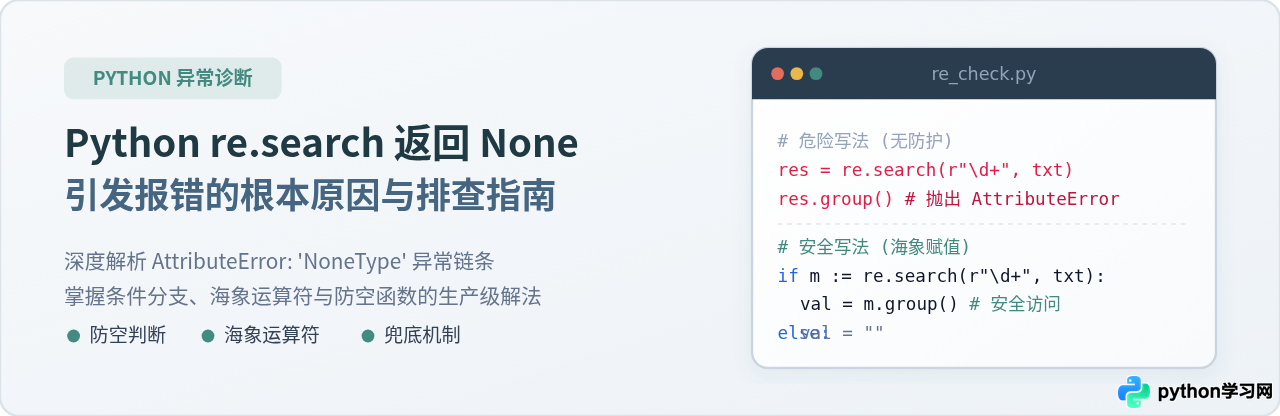
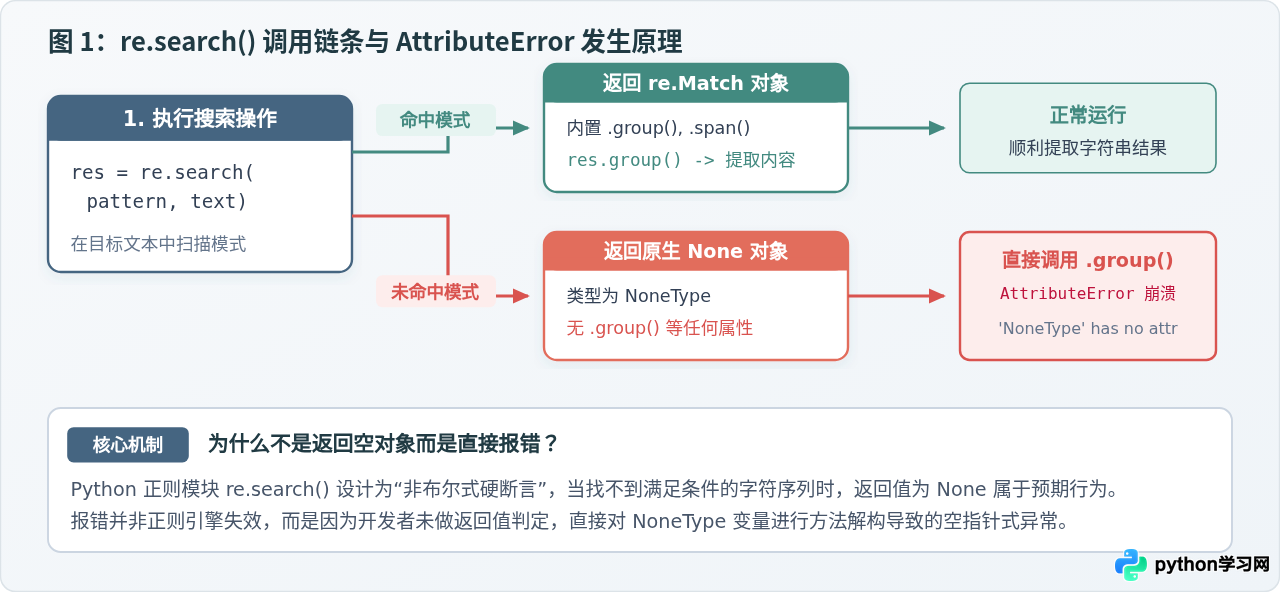
re.search() 会默认返回原生对象 None。如果此时代码未经判断直接调用 .group()、.groups() 或 .start(),就会触发经典的 AttributeError: 'NoneType' object has no attribute 'group' 运行时崩溃。解决此问题的标准路径是:绝不在 re.search() 之后进行未经校验的链式解包,而是采用显式条件分支(if match:)、现代海象运算符(if (m := re.search(...)):)或封装带有安全默认值的提取函数。
一、报错现场重现与错误本质剖析
在日常数据清洗、接口数据解析或爬虫抓取中,我们经常需要从不规则文本中提取指定标记(例如订单号、手机号、日期或状态码)。以下是导致该报错的最典型简化场景:
import re

# 待解析文本:用户可能输入了没有包含订单编号的通知内容
raw_text = "尊敬的用户,您的账户余额已更新,请登录系统查阅。"

# 尝试提取格式如 ORDER-12345 的编号并直接读取群组内容
result = re.search(r"ORDER-(\d+)", raw_text)
order_id = result.group(1)  # <--- 触发程序崩溃!
print("提取到的订单编号为:", order_id)
当执行上述代码时,控制台将立即中断并输出以下回溯异常:
Traceback (most recent call last):
  File "demo.py", line 8, in <module>
    order_id = result.group(1)
AttributeError: 'NoneType' object has no attribute 'group'
不少初学者会误以为这是“正则表达式语法写错了”或“正则引擎损坏”,但实际情况并非如此:
- 正则语法是合法的:
ORDER-(\d+)能够正确解析符合规则的文本; - 根源在于数据落空:由于
raw_text中完全不包含ORDER-前缀,re.search()无法匹配到任何子串; - Python 的返回值哲学:与部分抛出异常的语言不同,Python 正则库在搜索失败时选择返回单例对象
None(其类型为NoneType)。NoneType没有任何像.group()这样的成员方法,强行调用必然引发AttributeError。
二、排查与安全修复的标准操作步骤
遇到该报错时,应当遵循一套标准排查与修复流程,既解决当前脚本的崩溃,又防止未来传入非预期脏数据时再次产生隐患。
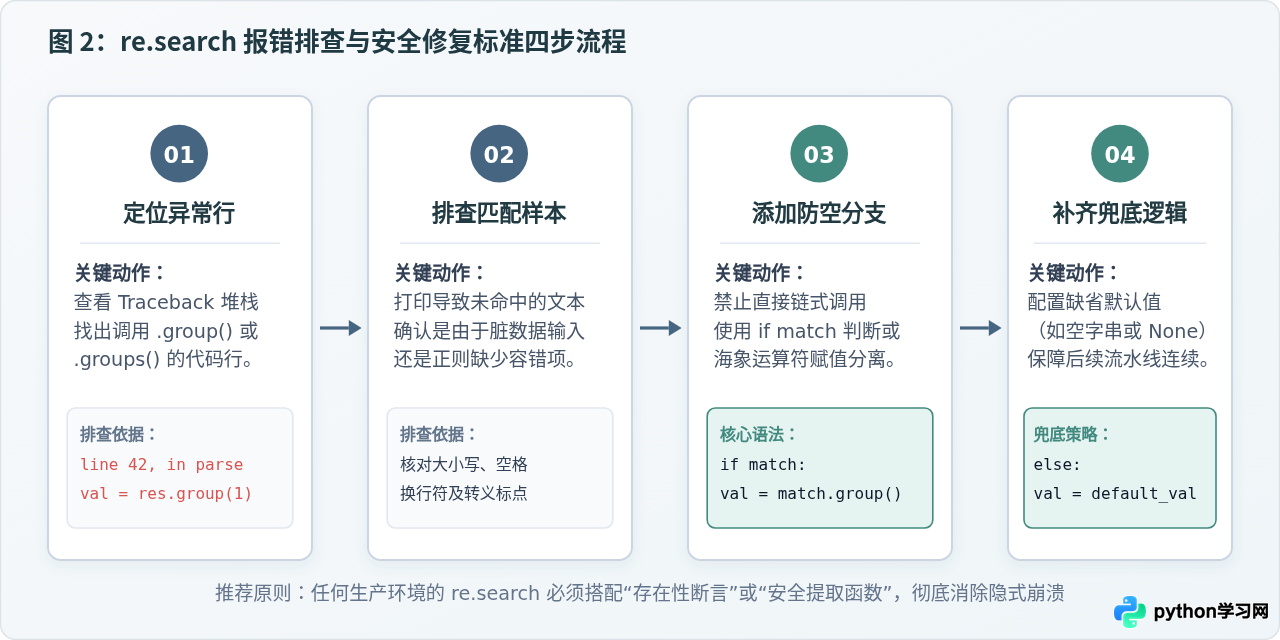
步骤 1:定位报错行并确认调用的成员方法
从 Python 的 Traceback 信息自底向上查看最后一行提示,确认引发异常的变量名称(如 result.group() 或 match.span())。明确该变量是由哪一次 re.search() 赋值产生的。
步骤 2:输出未匹配的原始文本样本
在 re.search() 前加入日志或临时打印语句 print(repr(raw_text))。这一步非常关键:你需要确认究竟是“业务上允许该文本没有对应字段”,还是“待匹配文本存在意外的大小写、前后空白字符或换行,导致正则写得过严而漏配”。
步骤 3:切断危险链式调用,加入防御判断
禁止书写 re.search(...).group() 这类一行到底的语法,必须将“匹配动作”与“结果提取动作”分离,或使用内置条件语句实施有效拦截。
步骤 4:配置明确的缺省保底值
根据业务逻辑决定:当未提取到预期字段时,变量应该保持 None、设置为空字符串 ""、填充默认占位符,还是主动记录警告日志并跳过本轮循环。明确缺省行为能保证下游管道不再引发次生报错。
三、四种生产环境实用修复方案
方案 1:显式 if 判断(通用、稳健、全版本兼容)
这是最符合直觉且最稳定的写法,适用于所有 Python 版本。利用 Python 中 re.Match 对象布尔求值为 True、而 None 布尔求值为 False 的特性:
import re

text = "欢迎使用系统"
match = re.search(r"ID:(\d+)", text)

# 显式校验 match 对象是否有效
if match is not None:
    user_id = match.group(1)
    print("成功解析 ID:", user_id)
else:
    user_id = ""  # 设定缺省兜底值
    print("未在输入文本中找到 ID 信息")
如果希望单行完成,也可以使用 Python 的三元表达式:
match = re.search(r"ID:(\d+)", text)
user_id = match.group(1) if match else "DEFAULT_ID"
方案 2:海象运算符 :=(Python 3.8+ 现代推荐写法)
从 Python 3.8 开始引入的赋值表达式(俗称海象运算符 :=)允许你在条件判断中直接完成赋值。这种写法既保持了一行紧凑的风格,又杜绝了对 None 调用的风险,且不会产生未命中的无用变量:
import re

text = "通知:订单编号 ORDER-98721 已发货"

# 一步完成赋值与非 None 判断
if match := re.search(r"ORDER-(\d+)", text):
    order_id = match.group(1)
    print("提取成功:", order_id)
else:
print("未包含有效订单号,执行备用流程")海象运算符不仅适用于 if 分支,在多模式尝试匹配(elif 链条)中尤为好用。例如依次尝试多种日期格式时,可以连续书写 elif match := re.search(...),结构清晰且性能优异。
方案 3:封装带默认值的安全提取函数(多字段清洗利器)
当一个项目中需要从各种长文本或爬虫响应中解析几十个不同字段时,每个字段都写四行 if-else 会导致代码极度冗余。此时最佳做法是封装一个通用辅助函数:
import re
from typing import Optional

def safe_search(
    pattern: str,
    string: str,
    group: int = 0,
    default: Optional[str] = None,
    flags: int = 0
) -> Optional[str]:
    # 安全执行正则搜索并提取指定分组,若匹配失败则返回设定的默认值。
    if not string:
        return default
    match = re.search(pattern, string, flags=flags)
    if match:
        try:
            return match.group(group)
        except IndexError:
            # 捕获组索引越界时的安全兜底
            return default
    return default

# 使用示例
sample_text = "客户姓名: 张三; 联络邮箱: 无"

# 优雅提取,未命中时静默返回保底默认值,绝不抛出 AttributeError
email = safe_search(r"[\w\.-]+@[\w\.-]+", sample_text, default="未登记邮箱")
name = safe_search(r"姓名:\s*(\S+)", sample_text, group=1, default="未知")

print("姓名:", name)    # 输出: 张三
print("邮箱:", email)   # 输出: 未登记邮箱
方案 4:try...except 异常捕获(容错流与批处理场景)
如果你正在重构遗留代码,或者在海量数据循环中只关注能够命中的数据,且绝大多数数据格式都极其规范,可以使用异常捕获:
import re

dataset = ["ITEM-001: 手机", "ITEM-002: 电脑", "无效数据条目", "ITEM-003: 耳机"]
valid_items = []

for line in dataset:
    try:
        # 如果未匹配到,则 .group(1) 抛出 AttributeError
        item_id = re.search(r"ITEM-(\d+)", line).group(1)
        valid_items.append(item_id)
    except AttributeError:
        # 针对未命中项记录忽略,程序平稳向前推进
        continue

print("有效提取结果:", valid_items)  # 输出: ['001', '002', '003']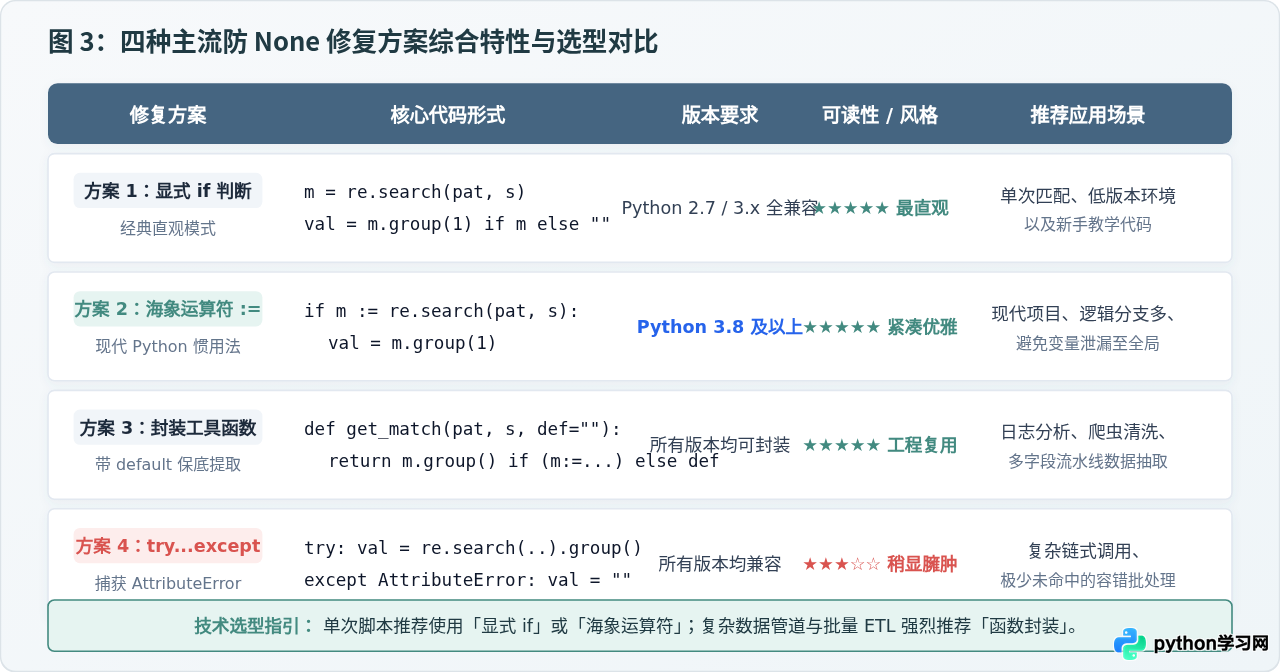
| 方案分类 | 典型代码形式 | Python 版本 | 核心优势 | 潜在缺点 |
|---|---|---|---|---|
| 显式 if 判断 | if match: match.group() |
全版本 | 语义直白,新手极易掌握 | 需先占用一个独立变量名 |
| 海象运算符 | if m := re.search(...): |
Python 3.8+ | 紧凑利落,条件与赋值合一 | 旧项目(如 3.7 及更低)不可用 |
| 函数封装 | safe_search(pat, s, default="") |
全版本 | 高度复用,统一管控缺省值 | 需维护公共工具模块 |
| try...except | except AttributeError: |
全版本 | 能包裹深层链式调用 | 异常跳跃稍显隐晦,微损吞吐性能 |
四、深挖根因:为什么你的正则表达式会返回 None?
在给代码加上了 if match: 保护之后,程序不再崩溃,但有时候你可能会发现:为什么本该匹配到的内容,却始终返回 None 呢?
这往往是由于正则表达式的边界条件或待匹配文本的细节不一致引起的。以下是排查正则为什么落空的四大关键原因:
-
忽略了英文字母大小写差异:
默认情况下正则对大小写高度敏感。如果目标是
http://,而实际文本是HTTP://,则会返回None。解决方案是在re.search()中传入flags=re.IGNORECASE(或re.I)。 -
点号
.无法匹配换行符如果在多行文本中抓取跨行段落(例如
<div>.*?</div>),默认的点号不会匹配换行。必须指定flags=re.DOTALL(或re.S),让.包含换行符在内的所有字符。 -
特殊符号未进行反斜杠转义:
许多标点在正则中具有元字符属性,如点号
.、括号()、方括号[]、加号+、问号?。如果要匹配字面上的句号或括号,必须转义为\.或\(,否则正则引擎会将其视作群组或任意字符规则。 -
混淆了
re.match()与re.search():必须格外留意:
re.match()只从字符串开头开始匹配,若开头不符哪怕中间有符合的子串也会返回None;而re.search()会扫描整个字符串。如果你希望全文检索,务必确认调用的是re.search()而非re.match()。
五、总结与防错检查清单
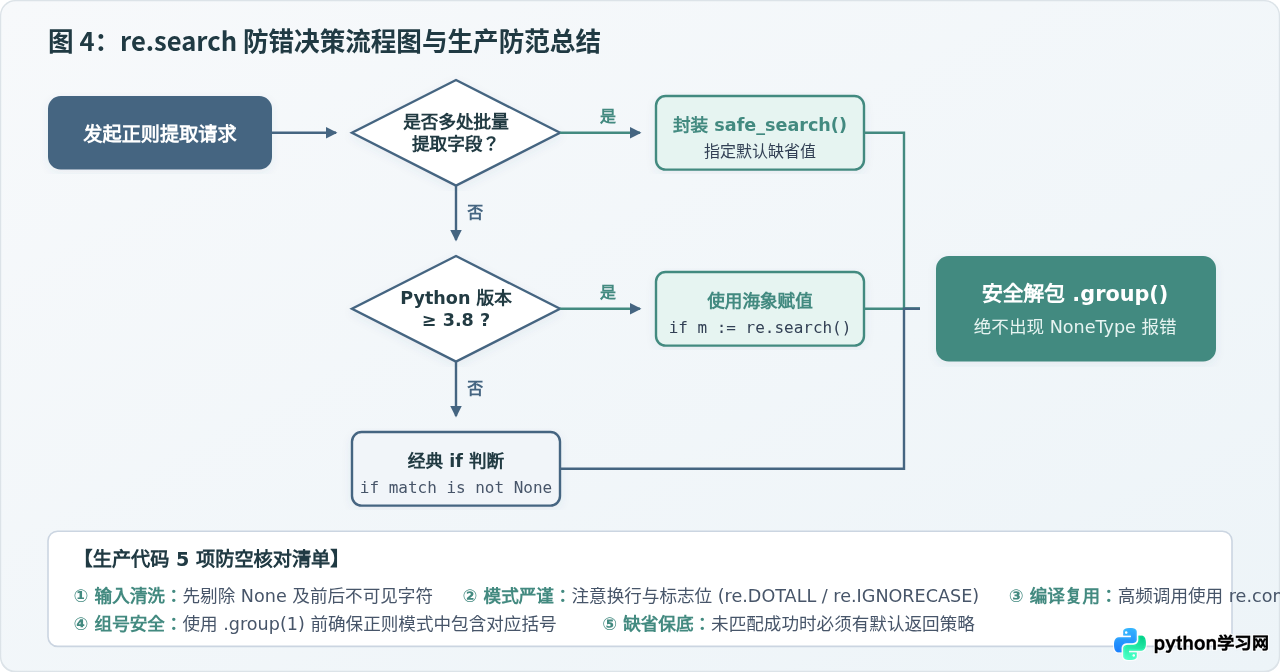
处理 re.search 返回 None 引发报错的本质,是对动态数据的不信任与防御性编程实践。在编写任何涉及文本正则解析的代码时,请对照以下检查清单:
- 严禁无保护链式调用:绝对不要在生产代码中直接编写
re.search(pat, s).group()。 - 版本适应性选型:Python 3.8+ 项目首选
if match := re.search(...);低于 3.8 版本或通用库首选if match is not None:。 - 统一抽取函数:在数据提取量大、字段多的项目中,及早沉淀
safe_search()封装函数,统一收敛默认值。 - 群组索引有效性:调用
match.group(1)之前,确保正则表达式中确实定义了捕获括号(),避免引发IndexError。 - 输入类型前置断言:在把变量传给
re.search()前,确保其本身是str而非None,防止出现TypeError: expected string or bytes-like object。
只要在调用群组方法前建立前置防线,并为未命中的边界情况安排合理的缺省处理路径,就能彻底根治 'NoneType' object has no attribute 'group' 报错,让数据解析程序在各种复杂场景下都能稳定长效运行。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









