

Python机器学习常用库解析:TensorFlow与PyTorch的核心区别

在当前 Python 机器学习与深度学习开发中,TensorFlow 与 PyTorch 构成了绝大多数工程项目与科研任务的基石。两者的根本差异并非单纯的代码语法不同,而是体现在计算图的构建执行机制、开发调试的交互心智模型、以及从模型训练到端到端工业落地的整体生态设计上。本文通过原理剖析、代码实现对比与多场景选型路径,全面解析两大核心库的关键区别,帮助开发者建立清晰的技术判断依据。
一、计算图执行机制:动态图(Define-by-Run)与静态图(Define-and-Run)
深度学习框架的核心任务是管理张量运算并自动计算导数。这一任务的底层支撑即为计算图(Computational Graph)。计算图如何构建与求值,决定了框架的运行性能、灵活性与调试难度。
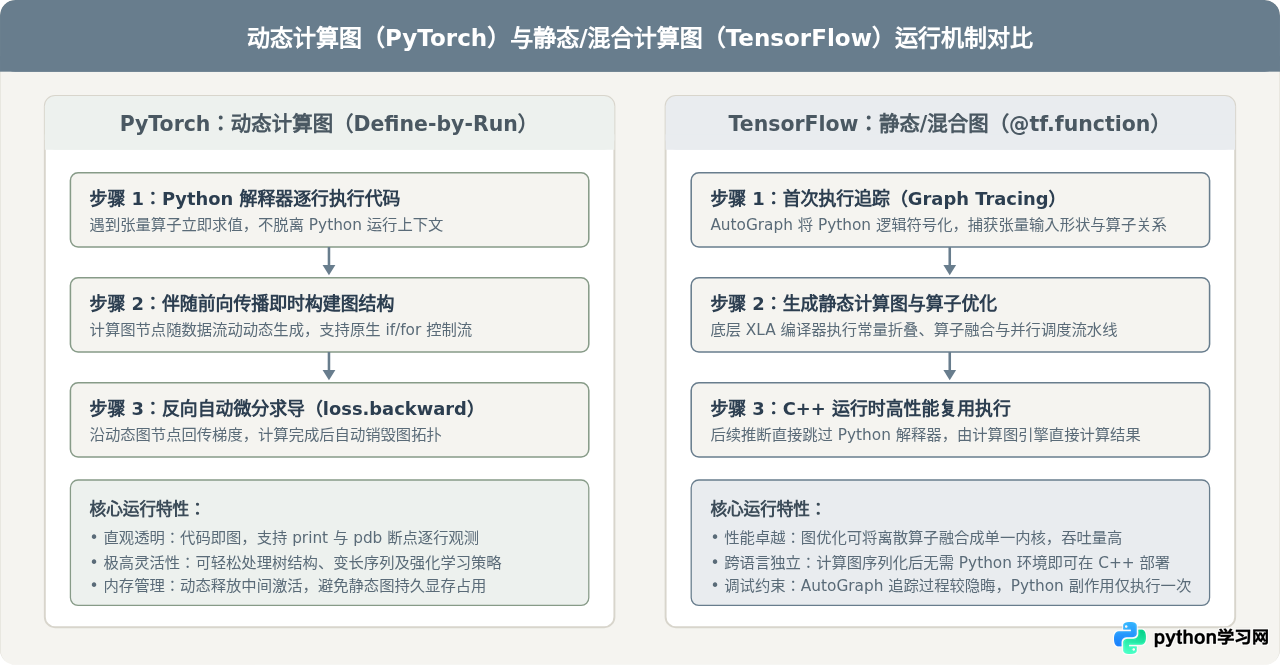
PyTorch 采用动态计算图(Define-by-Run)机制。当代码执行到具体的算子运算时,计算图节点会伴随前向传播即时动态生成。这意味着 Python 解释器的执行流程与计算图构建完全同步。当一次前向传播与反向传播完成后,图结构会被自动销毁,下一次前向传播可以根据新的输入条件生成完全不同的图结构。这种机制天然支持 Python 原生的条件控制语句(如 if-else)与动态循环(如 while)。
TensorFlow 最初确立了静态计算图(Define-and-Run)的工业范式。在 TensorFlow 1.x 时代,开发者需要先声明所有占位符与计算节点构建完整拓扑图,再将其交给底层的 C++ Session 会话进行统一编译与分发执行。为了解决静态图调试繁琐的痛点,TensorFlow 2.x 默认开启了即时执行模式(Eager Execution),同时通过 @tf.function 装饰器与 AutoGraph 技术保留了静态图编译优化的能力。在 tf.function 内部,Python 代码在首次运行时会被追踪并编译为不可变的静态计算图,随后的调用则脱离 Python 运行时,直接由 C++ 引擎高速执行算子融合与并行调度。
动态条件分支的代码实现差异
为了直观说明机制差异对编程方式的影响,以下给出一个根据输入张量均值执行不同数学操作的示例:
# 运行环境:Python 3.10+, torch >= 2.0.0
import torch

def dynamic_pytorch(x: torch.Tensor) -> torch.Tensor:
    # PyTorch 原生支持 Python 的 if 条件控制语句
    # 计算图会根据本次执行的具体分支动态生成求导路径
    if x.mean() > 0:
        return x * 2.0
    else:
        return x * -0.5

x_sample = torch.tensor([1.0, 2.0, 3.0], requires_grad=True)
y_out = dynamic_pytorch(x_sample)
y_out.backward(torch.ones_like(y_out))
print("PyTorch 梯度输出示例:", x_sample.grad)
# 示例输出:PyTorch 梯度输出示例: tensor([2., 2., 2.])
# 运行环境:Python 3.10+, tensorflow >= 2.12.0
import tensorflow as tf
@tf.function
def static_tensorflow(x: tf.Tensor) -> tf.Tensor:
# TensorFlow 在 @tf.function 编译时,AutoGraph 会将 Python if
# 转换为底层静态图算子 tf.cond,确保图结构在不同数据输入下保持统一拓扑
if tf.reduce_mean(x) > 0:
return x * 2.0
else:
return x * -0.5
x_sample = tf.Variable([1.0, 2.0, 3.0])
with tf.GradientTape() as tape:
y_out = static_tensorflow(x_sample)
grad = tape.gradient(y_out, x_sample)
print("TensorFlow 梯度输出示例:", grad.numpy())
# 示例输出:TensorFlow 梯度输出示例: [2. 2. 2.]在上述对比中,PyTorch 允许开发者直接像编写普通 Python 脚本一样组织逻辑;而 TensorFlow 虽然借助 AutoGraph 将 if 转换为图内部的 tf.cond,但在包含复杂 Python 对象(如列表、字典、第三方库调用)时,静态图追踪极易引发多次重追踪(Retracing)甚至引发逻辑不可控的错误。
二、API 架构与模型开发调试体验
深度学习工程不仅关注训练与推断的速度,更取决于模型研发周期中的开发效率与排错成本。两框架在 API 设计层级与调试排障机制上存在显著分野。
1. API 设计哲学与模型定义模式
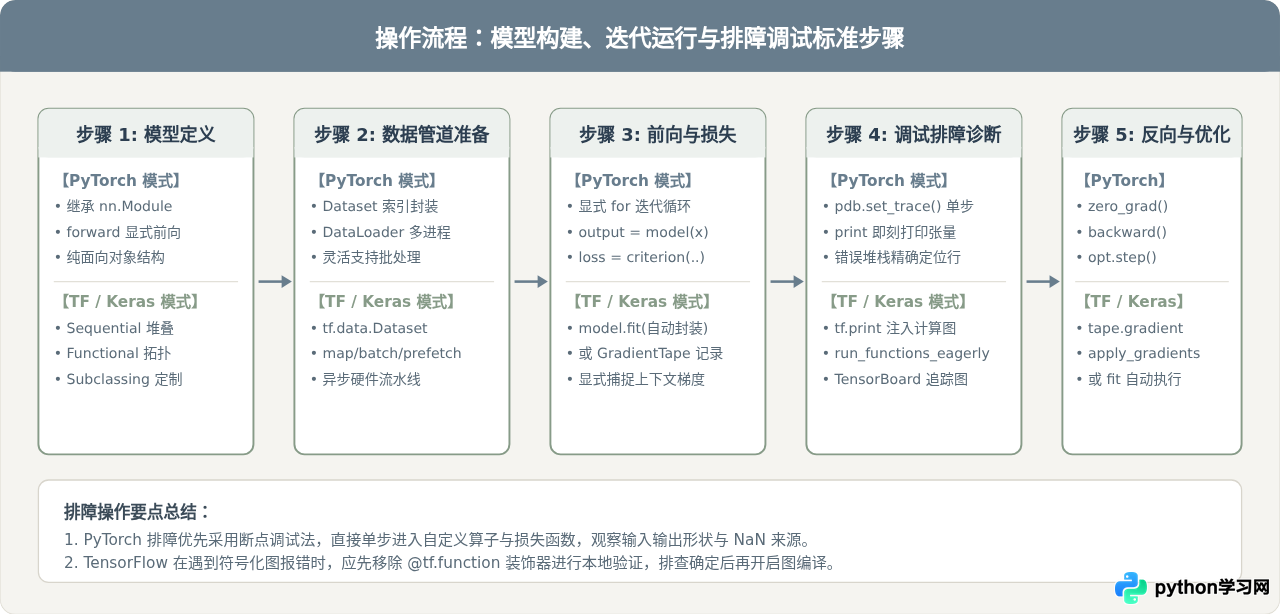
PyTorch 坚守面向对象的 Pythonic 设计准则。其模型构建高度统一:所有网络结构均继承自 torch.nn.Module,并在 forward 方法中定义数据前向传播流程。训练过程通常由显式的 Python 循环构成,开发者对张量运算、梯度归零(optimizer.zero_grad())、反向传播(loss.backward())和权重更新(optimizer.step())拥有绝对控制权。
TensorFlow 在 2.x 版本后全面将 tf.keras 作为官方高阶接口。Keras 提供了三种不同抽象程度的模型构建模式:
- Sequential 顺序模型:仅需堆叠图层,适合简单线性拓扑,开箱即用。
- Functional API 函数式模型:显式声明图层输入输出,支持多输入、多输出及残差跳跃连接。
- Model Subclassing 子类化模型:继承
tf.keras.Model并重写call方法,与 PyTorch 体验类似,提供最高自由度。
此外,TensorFlow 通过 model.compile() 与 model.fit() 将损失函数、优化器和训练迭代完全内嵌封装,极大降低了标准任务的代码量,但也削弱了在训练中途插入细粒度控制逻辑的直观性。
2. 调试与错误排查流程
当张量形状不匹配或数值溢出(出现 NaN)时,开发者的排障路径在两库中截然不同:
- PyTorch 排错:由于运算即时发生,报错堆栈能够精确定位到具体的 Python 源码行。开发者可以在
forward内部任意位置插入print(x.shape)或设置标准 Python 调试器断点(import pdb; pdb.set_trace()),实时检查张量数值与梯度状态。 - TensorFlow 排错:在纯 Eager 模式下调试体验良好;但一旦被
@tf.function封装为图执行,常规 Python 断点与 print 语句将仅在首次追踪构建图时触发一次,无法在后续迭代中捕获异常数值。开发者必须使用tf.print()注入图节点,或显式调用tf.config.run_functions_eagerly(True)强制降级为即时模式进行故障排查。
三、模型生产化与端到端部署链路
模型在实验环境中完成训练只是第一步。在工业级应用中,如何将模型高效率地导出、如何脱离开发机 Python 环境在生产服务器中承载高并发吞吐、以及如何压缩移植至手机和嵌入式芯片,是衡量框架实用性的关键标尺。
1. TensorFlow 的工业级端到端生态体系
TensorFlow 的核心优势始终在于其工业级闭环生态。它提供了一套完整的企业级工具链:
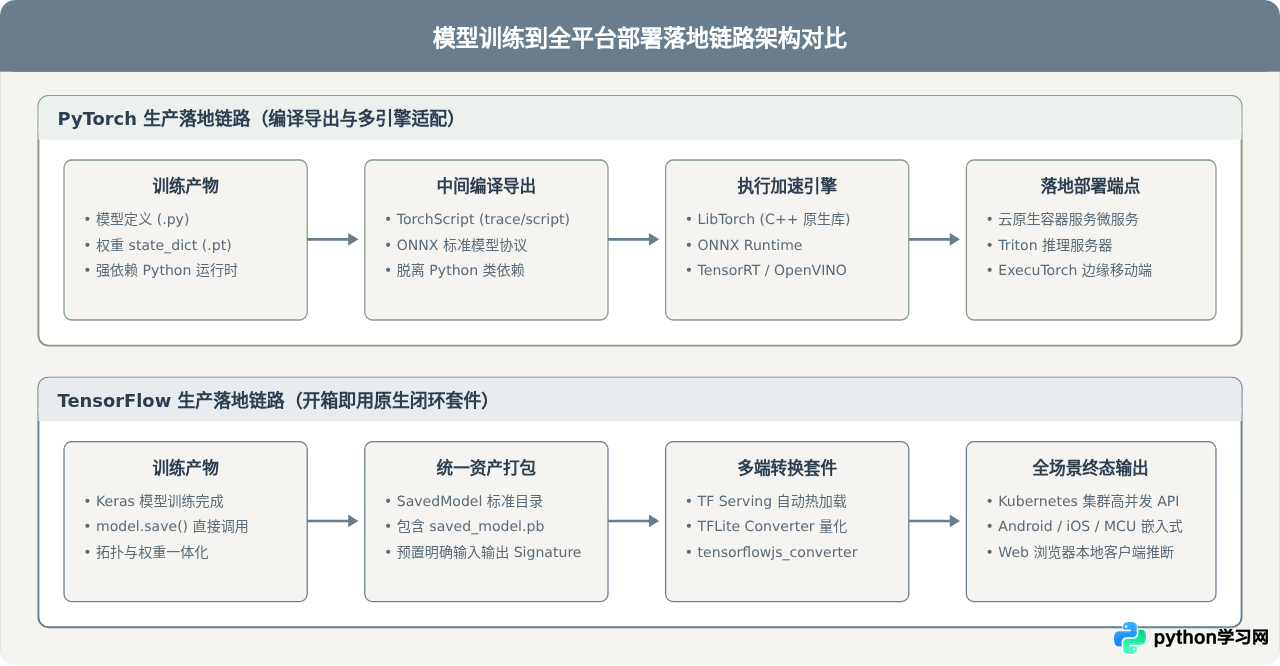
- SavedModel 格式:标准的序列化工业资产格式。它将完整的计算图拓扑、变量权重以及签名入口(Signatures)封存进单一目录,不依赖任何原始训练代码或 Python 脚本即可重建完整推断逻辑。
- TensorFlow Serving:采用 C++ 编写的高并发模型服务化框架,专为生产集群设计。原生支持 gRPC 与 RESTful API、模型零停机动态热加载更新、请求批处理(Batching Scheduling)与多模型版本协同管理。
- TensorFlow Lite (TFLite):面向移动端(Android / iOS)及物联网嵌入式芯片的轻量级运行时。提供全面的定点量化(INT8)、权重剪枝工具以及硬件 NPU/GPU 委托加速接口。
- TensorFlow.js:支持在 Node.js 服务端以及 Web 浏览器端直接利用 WebGL / WebGPU 运行甚至在前端微调模型。
2. PyTorch 的工程化升级与导出路径
早期 PyTorch 依赖保存整个 Python 对象或 state_dict 权重字典,在部署时必须连同 Python 模型类代码一同载入,且受制于 Python 全局解释器锁(GIL),难以承载超大规模高并发服务。随着版本演进,PyTorch 已经建立了成熟的独立导出与加速工具链:
- TorchScript (JIT):提供
torch.jit.trace(输入张量追踪记录执行轨迹)与torch.jit.script(直接解析 Python 语法生成中间表示)两种机制,将模型编译为静态 TorchScript 脚本。导出的.pt模型可直接交由 C++ 库(LibTorch)在无 Python 依赖的高性能服务端中运行。 - ONNX 原生互操作:PyTorch 对开放神经网络交换协议(ONNX)具备极佳的原生支持(
torch.onnx.export),使得 PyTorch 训练的模型能够无缝转换为 ONNX 格式,进而接入 TensorRT、OpenVINO 或 ONNX Runtime 实现硬件级极限加速。 - ExecuTorch:针对边缘计算与移动端设备的新一代端侧部署引擎,大幅简化了 PyTorch 模型向端侧芯片移植的复杂度。
模型导出实操对比
为满足无 Python 依赖的生产化要求,以下展示两框架将模型保存为独立静态文件的标准操作:
# 示例:PyTorch 导出为 TorchScript 格式
import torch
import torch.nn as nn

class LinearModel(nn.Module):
    def __init__(self):
        super().__init__()
        self.fc = nn.Linear(4, 2)
    def forward(self, x):
        return self.fc(x)

model = LinearModel()
model.eval()

# 准备一个标准输入的样例张量,用于前向追踪
example_input = torch.rand(1, 4)
traced_model = torch.jit.trace(model, example_input)

# 保存为单文件序列化模型,后续可由 C++ LibTorch 直接加载运行
traced_model.save("model_traced.pt")
print("PyTorch TorchScript 模型已成功导出至 model_traced.pt")
# 示例:TensorFlow 导出为标准 SavedModel 目录格式
import tensorflow as tf
# 使用 Keras 构建简单全连接模型
tf_model = tf.keras.Sequential([
tf.keras.layers.Input(shape=(4,)),
tf.keras.layers.Dense(2)
])
# 导出为生产标准 SavedModel 目录
# 目录内将包含 saved_model.pb 及 variables/ 目录
tf_model.save("saved_model_dir", save_format="tf")
print("TensorFlow SavedModel 资产已成功保存至 saved_model_dir/")四、框架核心技术维度横向对比
为了全面衡量两者在工程周期各环节的表现,下表在一致的条件设定下,汇总了计算图机制、编程心智、部署支持及社区生态的关键差异:
| 评估维度 | PyTorch | TensorFlow (2.x / Keras) | 差异带来的实际工程影响 |
|---|---|---|---|
| 计算图机制 | 默认动态图(Define-by-Run);2.x 支持 torch.compile 图编译 |
默认 Eager 模式;通过 @tf.function 进行静态图追踪编译 |
PyTorch 写法直观且易于单步断点;TensorFlow 静态图在脱离 Python 时更具稳定性。 |
| API 风格与心智 | 高度面向对象,显式前向 forward 与清晰的手动训练循环 |
分层明显:Keras 声明式封装(Sequential/fit)与子类化模式并存 | 初学者用 Keras 上手最快;进阶开发与算法创新 PyTorch 掌控感更强。 |
| 调试排错成本 | 错误堆栈直指源码行;支持标准 pdb 断点与即时 print | 图模式下报错信息冗长;追踪过程与 Python 控制流存在潜在副作用冲突 | PyTorch 在解决形状不匹配、中间变量异常时的定位速度显著优于静态图模式。 |
| 学术与论文生态 | 占据顶级学术会议(CVPR、NeurIPS、ICLR)80% 以上开源代码 | 学术界占比持续下降,主要留存于历史成熟基准与特定机构项目中 | 复现最新学术论文、追踪生成式 AI(LLM、Diffusion)首选 PyTorch。 |
| 高并发云端服务 | 依赖 TorchScript / ONNX + Triton Server 或 LibTorch 部署 | 拥有原生且成熟的 TensorFlow Serving(支持动态 Batching 与热更新) | 大型企业若已有完备的 TF Serving 基础设施,维护成本与集群管理门槛更低。 |
| 移动与端侧适配 | ExecuTorch 正在加速普及;跨端方案常依赖 ONNX 转换 | TensorFlow Lite 体系极为完善,覆盖嵌入式、手机硬件加速与 JS | 在需要将轻量化视觉或音频模型刷入移动设备或微控制器的场景中,TFLite 工具链更成熟。 |
五、工程场景选型决策指南
在技术选型时,不应脱离具体的业务目标、团队技能树与基础设施现状去强行评判优劣。根据项目的核心诉求,建议遵循以下判断路径:
关键选型决策原则:
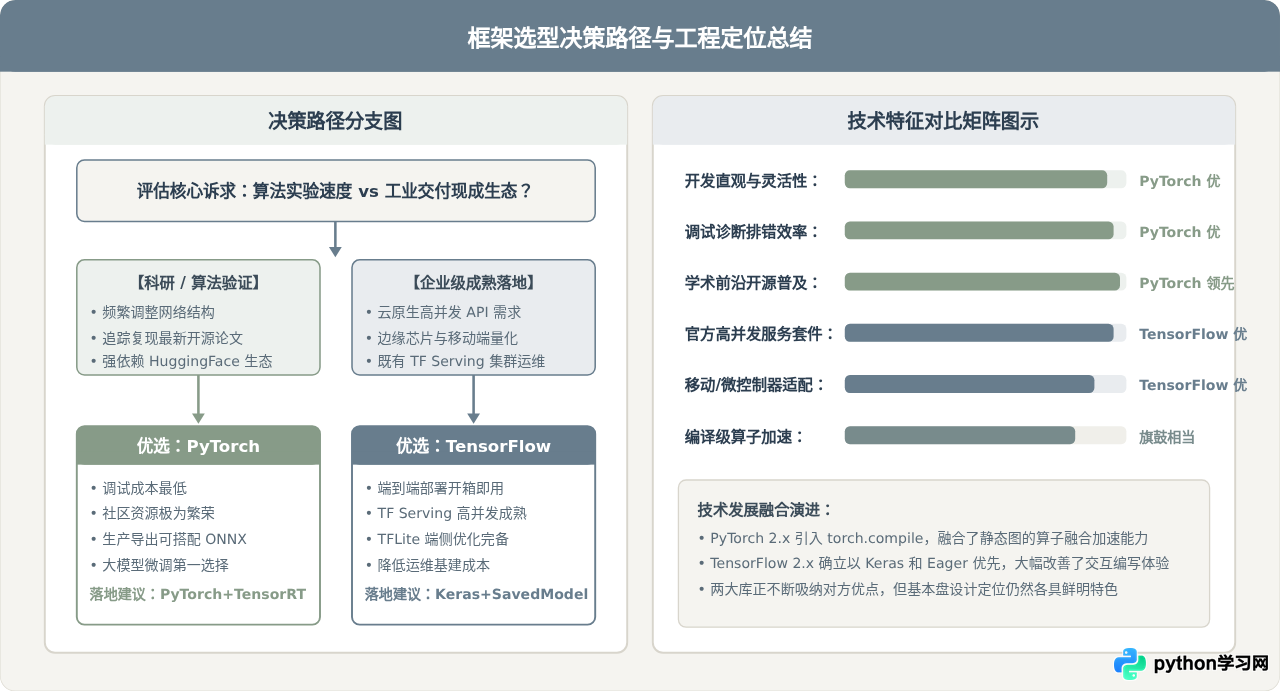
1. 如果项目核心目标是算法前沿探索、快速实验验证、论文模型复现或大语言模型(LLM)微调:优先选择 PyTorch。Hugging Face Transformers 等主流开源大模型生态均以 PyTorch 作为第一等公民提供支持。
2. 如果项目属于企业现有成熟业务扩展、团队以工业 Java/C++ 后端维护为主、追求一站式服务化集群运维或端侧嵌入式设备落地:优先考虑 TensorFlow(利用 TF Serving 与 TFLite 建立开箱即用的落地流水线)。
3. 如果是兼顾前沿开发与高性能部署的新建工程:推荐采用 PyTorch 2.x 训练 + ONNX/TensorRT 导出的混合工程架构。
六、总结与实践建议
回顾 TensorFlow 与 PyTorch 的演化历程,两者走过了截然相反的技术融合路径:TensorFlow 从底层的静态图计算引擎起家,逐步向高层易用的动态交互与 Keras 封装靠拢;PyTorch 则从极致直观的动态图交互出发,逐步完善了静态编译(torch.compile)、C++ 运行时与多端导出工具链。
对于当下从事 Python 机器学习的开发者而言:
- 如果重点在于理解算法原理、跟进最前沿模型架构或从事深度学习学术研究,应将 PyTorch 作为核心主力工具深入掌握;
- 如果负责维护既有企业的工业流水线、对接高并发 TF Serving 集群或开发移动嵌入式智能设备,则 TensorFlow 与 Keras 的闭环部署生态依然具备显著的开箱即用优势。
掌握两者的核心机制差异与适用边界,能够帮助工程师在不同的项目阶段做出最合理、成本最低的架构决策。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









