

Python在人工智能中的应用:TensorFlow与PyTorch开发解析
深入解析Python在人工智能领域的核心应用,系统对比TensorFlow与PyTorch的底层架构、数据加载、模型构建、训练循环与生产部署,提供详尽的代码范式与技术选型指南。
一、底层设计哲学:动态计算图与混合执行机制
深度学习框架的核心功能在于高效表达复杂的多维数组(张量)运算,并通过自动微分(Automatic Differentiation)机制完成反向梯度的自动求导。TensorFlow与PyTorch在实现这一目标时,采取了不同的设计哲学与演进路线。
PyTorch从诞生之初便确立了“以Python为中心”(Pythonic)与“动态计算图”(Define-by-Run)的架构体系。在PyTorch中,前向传播代码的执行过程即是计算图的构建过程。张量每执行一次加法、矩阵乘法或激活函数,框架便动态记录该运算节点。这种模式赋予了开发者极高的调试便利性:用户可以使用Python原生的条件控制语句(if/else)、循环(while/for)自由构建动态结构模型,并直接借助标准调试器(如pdb)或print函数在任意执行步查看张量数值和形状。
TensorFlow在1.x时代采用纯粹的“静态计算图”(Define-and-Run)机制,即先通过符号编程定义完整图拓扑,再通过tf.Session分发执行。这种设计具备全局图优化与部署便利的优势,但在调试与交互体验上门槛较高。自TensorFlow 2.x起,官方将即时执行(Eager Execution)设为默认模式,语法体验全面贴合Python直观习惯;同时引入了@tf.function装饰器与AutoGraph技术,允许开发者将普通Python函数透明编译为高性能的优化静态图(Graph Execution),兼顾了原型设计的灵活性与工业生产的高性能吞吐。
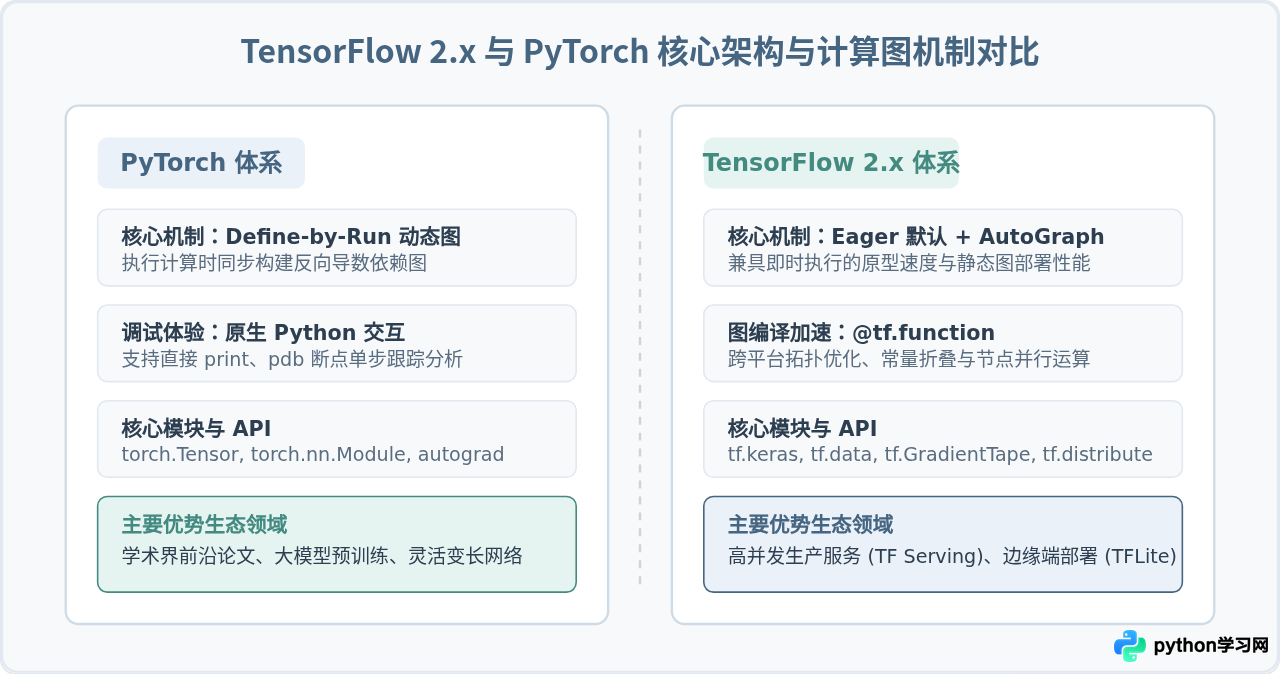 图1:TensorFlow 2.x 与 PyTorch 核心计算机制及架构特性对比
二、标准开发流水线:从数据准备到评估导出
无论选用哪种框架,深度学习算法工程通常都遵循高度标准化的全生命周期工作流。整个过程包含数据预处理与加载管道、网络架构定义、损失函数与优化目标设定、训练循环执行以及模型序列化与导出五个核心阶段。
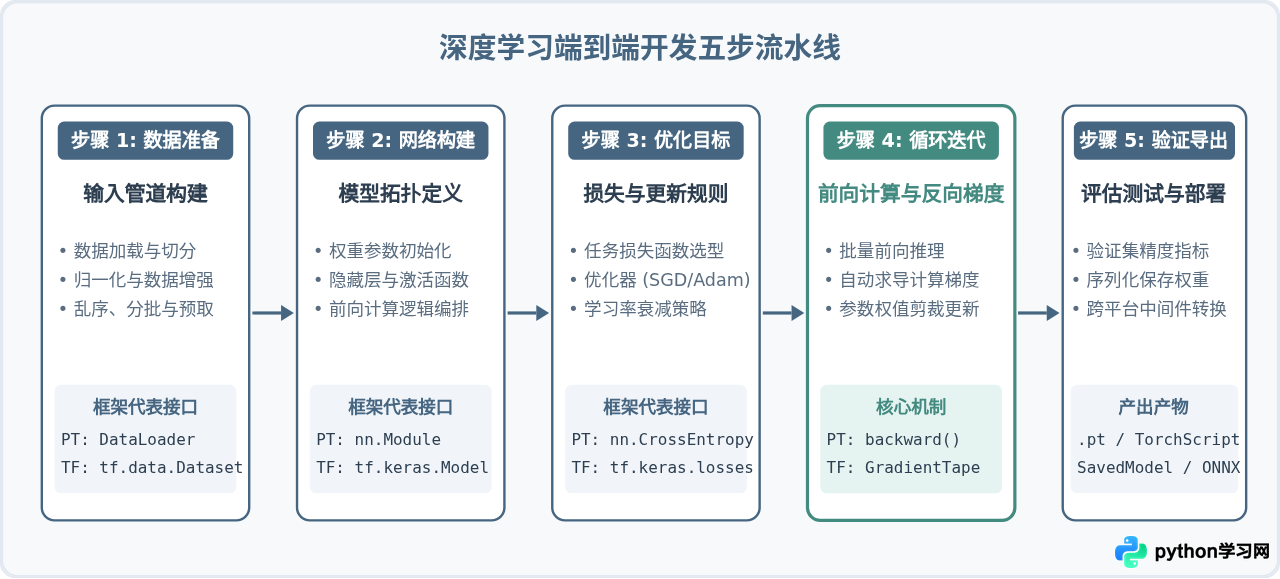 图2:深度学习算法全生命周期开发流程图
1. 数据管道构建对比
在模型吞吐量受限于I/O读取与预处理的场景下,框架的数据加载器质量直接决定了GPU的运算利用率。
- PyTorch 数据生态:通过继承
torch.utils.data.Dataset实现__len__与__getitem__抽象方法,随后交由DataLoader处理多进程批量加载、内存锁页(pin_memory)及样本打乱(shuffle)。其设计非常贴合Python原生编程体验,易于与自定义数据结构整合。 - TensorFlow 数据生态:核心依托
tf.data.DatasetAPI。该模块构建在C++异步处理引擎之上,提供了链式调用接口(map,batch,prefetch,interleave),通过声明式管道实现后台自动流水线优化(如tf.data.AUTOTUNE),能够深度减少CPU预处理与GPU计算等待间的时间重叠。
2. 网络结构定义范式
PyTorch推崇显式面向对象封装:模型必须继承自 torch.nn.Module,在 __init__ 中声明具有可学习权重的算子层,在 forward 方法中编写张量计算的前向流通路。
import torch
import torch.nn as nn

class PyTorchClassifier(nn.Module):
    def __init__(self, input_dim=784, hidden_dim=128, num_classes=10):
        super(PyTorchClassifier, self).__init__()
        self.fc1 = nn.Linear(input_dim, hidden_dim)
        self.relu = nn.ReLU()
        self.fc2 = nn.Linear(hidden_dim, num_classes)

    def forward(self, x):
        # 显式定义前向计算逻辑
        h = self.relu(self.fc1(x))
        out = self.fc2(h)
        return out
TensorFlow则通过 tf.keras 提供了三种不同维度的定义方式:极简线性的 Sequential 模式、支持多输入多输出分支的 Functional API 函数式模式,以及与PyTorch几乎完全一致的 Model Subclassing 类子类化模式。
import tensorflow as tf
from tensorflow.keras import layers, Model

# 采用 Subclassing 方式,与 PyTorch 形成直接对等
class TFClassifier(Model):
    def __init__(self, hidden_dim=128, num_classes=10):
        super(TFClassifier, self).__init__()
        self.fc1 = layers.Dense(hidden_dim, activation='relu')
        self.fc2 = layers.Dense(num_classes)

    def call(self, inputs, training=False):
        # call 方法承载前向流通路
        h = self.fc1(inputs)
        out = self.fc2(h)
        return out
三、训练循环与梯度更新:自动微分机制解析
模型训练的本质是通过数值优化算法最小化经验风险。在此阶段,两者的底层自动微分机制展现出截然不同的交互形态。
在PyTorch中,张量自带梯度求导标记(requires_grad=True)。在调用损失函数得到标量后,执行 loss.backward() 会自动从叶子节点溯源回传梯度,计算得到的偏导数直接累加至各参数的 .grad 属性中。因此,在每一次更新前,必须显式调用 optimizer.zero_grad() 清空历史累加值,并在反向传播完成后执行 optimizer.step() 更新参数。
在TensorFlow 2.x中,梯度计算依托显式上下文管理器 tf.GradientTape 实现。在上下文块内执行的前向操作会被磁带(Tape)精确记录,随后通过显式调用 tape.gradient(loss, model.trainable_variables) 计算目标对可训练权重的偏导列表,最后由 optimizer.apply_gradients(zip(grads, vars)) 完成参数更新。
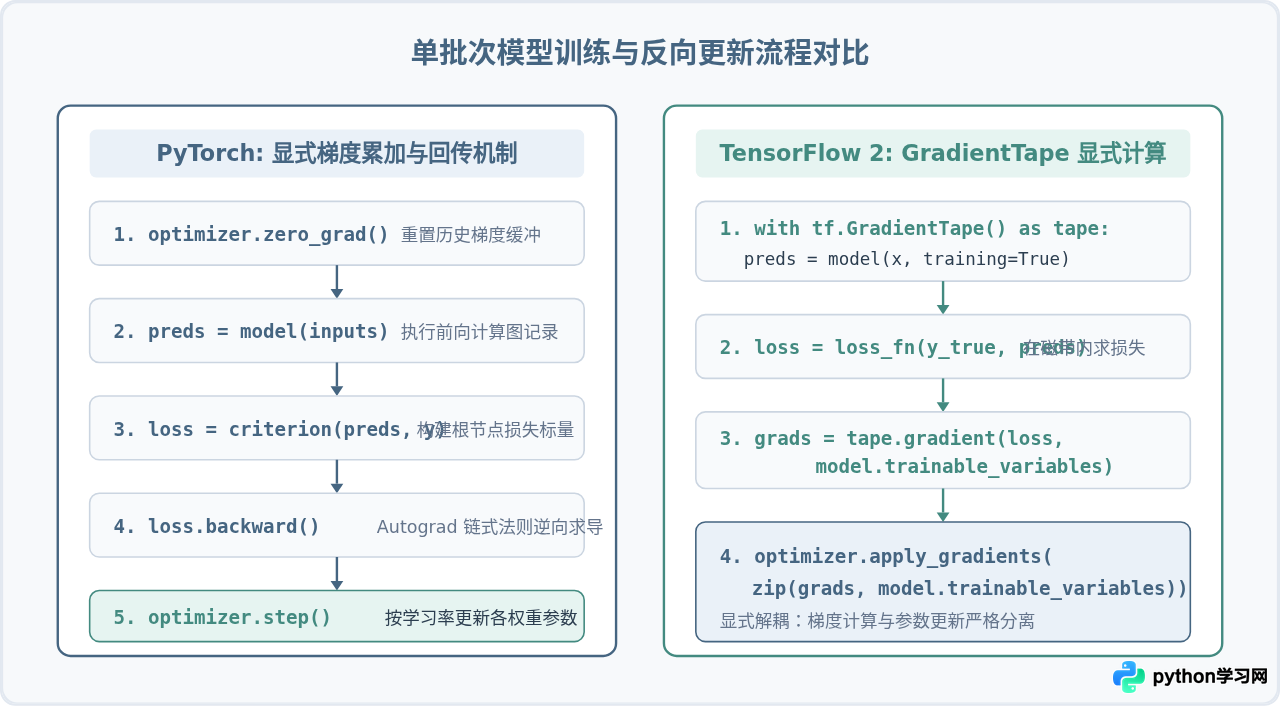 图3:PyTorch与TensorFlow单批次训练更新与自动微分流水线机制
可运行训练步对比实现
为了直观体会两者的实际代码落地差异,下面展示对单一Batch张量执行前向推导与梯度更新的最小完整代码。
PyTorch 自定义训练步:
import torch
import torch.nn as nn
import torch.optim as optim

# 1. 初始化模型、损失函数与优化器
model = nn.Linear(in_features=10, out_features=1)
criterion = nn.MSELoss()
optimizer = optim.SGD(model.parameters(), lr=0.01)

# 2. 模拟单批次输入与标签
x_batch = torch.randn(32, 10)
y_batch = torch.randn(32, 1)

# 3. 核心训练步
optimizer.zero_grad()               # 显式清空梯度
predictions = model(x_batch)         # 前向计算
loss = criterion(predictions, y_batch)  # 计算损失
loss.backward()                     # 反向自动微分求导
optimizer.step()                    # 更新权重参数

print(f"[PyTorch] 当前步损失: {loss.item():.4f}")
TensorFlow 2.x 自定义训练步:
import tensorflow as tf

# 1. 初始化模型、损失函数与优化器
tf_model = tf.keras.layers.Dense(units=1, input_shape=(10,))
loss_fn = tf.keras.losses.MeanSquaredError()
optimizer = tf.keras.optimizers.SGD(learning_rate=0.01)

# 2. 模拟单批次数据
tf_x_batch = tf.random.normal([32, 10])
tf_y_batch = tf.random.normal([32, 1])

# 3. 可选装饰器:加速为图执行模式
@tf.function
def train_step(x, y):
    with tf.GradientTape() as tape:
        preds = tf_model(x, training=True)
        current_loss = loss_fn(y, preds)
    # 计算梯度
    gradients = tape.gradient(current_loss, tf_model.trainable_variables)
    # 应用梯度更新
    optimizer.apply_gradients(zip(gradients, tf_model.trainable_variables))
    return current_loss

step_loss = train_step(tf_x_batch, tf_y_batch)
print(f"[TensorFlow] 当前步损失: {step_loss.numpy():.4f}")model.compile() 与 model.fit() 高阶API,框架内部会自动封装分布式策略、指标度量以及验证回调。但在涉及强化学习、生成对抗网络(GAN)或复杂的物理机理融合模型时,GradientTape 提供的自由度与可控性不可替代。
四、模型序列化与工程化部署
完成模型训练后,算法必须输出为标准化的独立构件,交付生产环境进行高可用、低时延的在线推理或离线批处理。
| 对比维度 | PyTorch | TensorFlow |
|---|---|---|
| 原生持久化格式 | .pt / .pth (基于Python pickle序列化参数字典) |
SavedModel 目录 (包含计算图PB文件与资产资产) |
| 生产脱敏编译 | TorchScript (通过 torch.jit.trace 或 torch.jit.script 摆脱Python依赖) |
天然图结构,直接导出完整自包含计算图结构与变量 |
| 高性能服务框架 | TorchServe (支持多Worker管理与动态批处理) | TensorFlow Serving (经过超大规模工业验证的高并发C++微服务) |
| 移动与嵌入式端侧 | PyTorch Mobile / ExecuTorch | TensorFlow Lite (TFLite,软硬件量化支持体系极其完善) |
| 开放互操作格式 | torch.onnx.export() (与ONNX生态高度契合) |
借助 tf2onnx 工具包转出 |
五、框架选型与落地决策导图
面对实际工程项目时,技术团队应结合团队研发背景、部署目标平台、迭代速度与既有基础设施进行综合权衡。
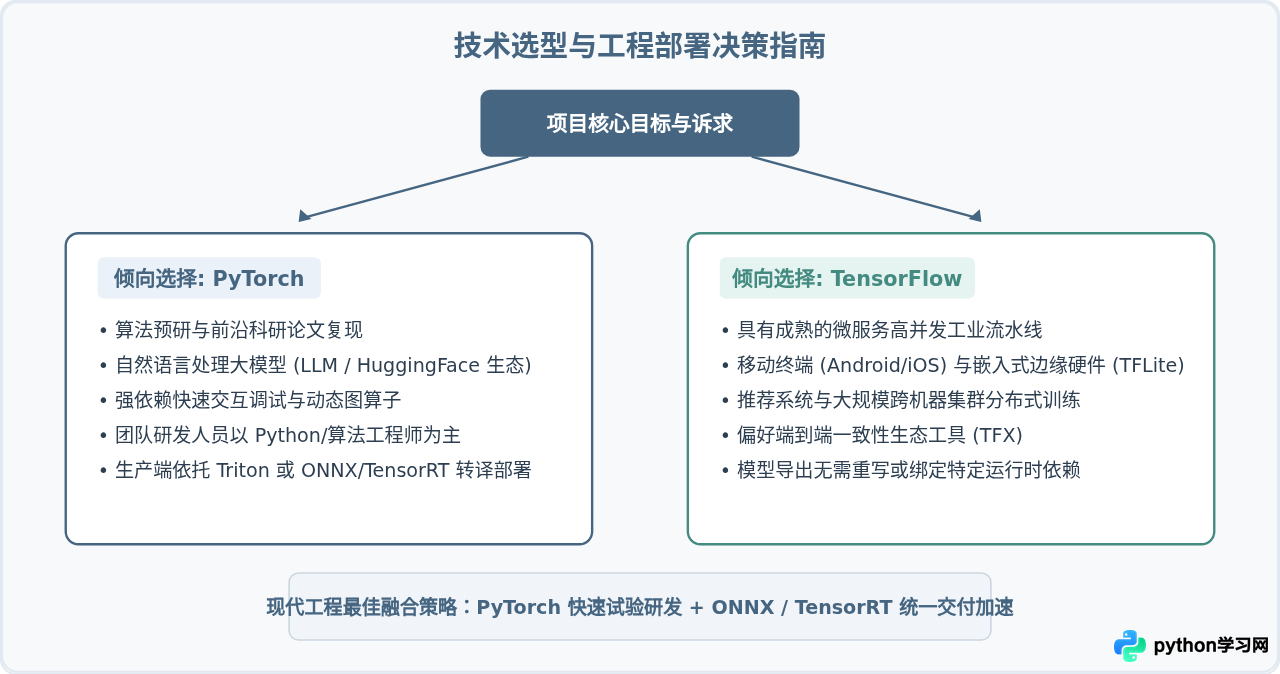 图4:深度学习框架选型、研发迭代与生产部署决策路径
六、实际开发中的关键避坑注意事项
-
显存泄漏与张量解耦(
.detach()/.item()): 在PyTorch记录损失或统计指标时,若直接使用total_loss += loss,由于loss变量包含计算图历史回溯指针,会导致整张动态计算图常驻显存引发OOM。正确的做法是使用total_loss += loss.item()取出纯Python标量数值。 -
评估与训练模式切换(
model.train()与model.eval()): 包含Dropout或BatchNorm层的网络,在前向推导时必须正确显式切换状态。在评估时,PyTorch需调用model.eval()并配合with torch.no_grad():禁用梯度计算;在TensorFlow中,需显式向call(inputs, training=False)传递布尔标志。 -
数据类型与设备对齐(Device Alignment):
PyTorch中跨设备传输较为严格,输入数据与模型权重必须同时位于
cuda或cpu上(如tensor.to(device)),否则将触发运行时错误;TensorFlow通常提供更为平滑的混合设备安置策略,但在高性能分布式训练时仍需明确规划tf.distribute.Strategy范围。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









