

怎么下载菜鸟教程Python 100例的PDF或离线学习资料?
针对菜鸟教程未直接提供Python 100例官方单键下载的现状,本文系统梳理了浏览器打印另存、Python自动化爬虫清洗导出PDF,以及获取社区开源归档三种可行方案与实操步骤。
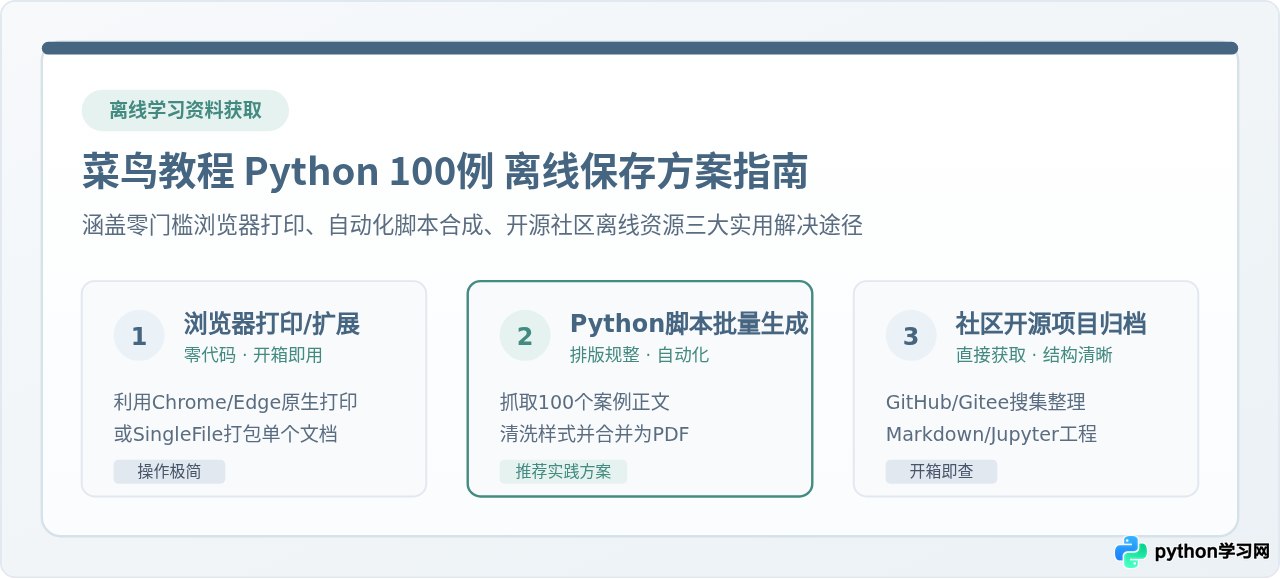
一、为什么官方没有直接提供PDF下载?
菜鸟教程作为面向初学者的通用在线编程技术网站,其主要业务模式是基于网页交互阅读与在线编译器(Tryit Editor)体验。网站的“Python 100例”页面结构为:一个主索引目录页面(包含题目1到题目100的标题链接),每个题目指向独立的子页面(例如 python-exercise-example1.html)。
由于网页结构天然是分散的超文本,且页面中集成了侧边导航、广告栏、评论区与在线运行按钮,官方并没有针对这100个例子专门生成一个合并版PDF放置在服务器供人一键下载。对于想要在没有网络环境下(如飞机上、旅途中、封闭机房)研习题目,或者希望将题目汇总打印在纸上练习的读者,必须通过本地转换或技术手段生成离线版。
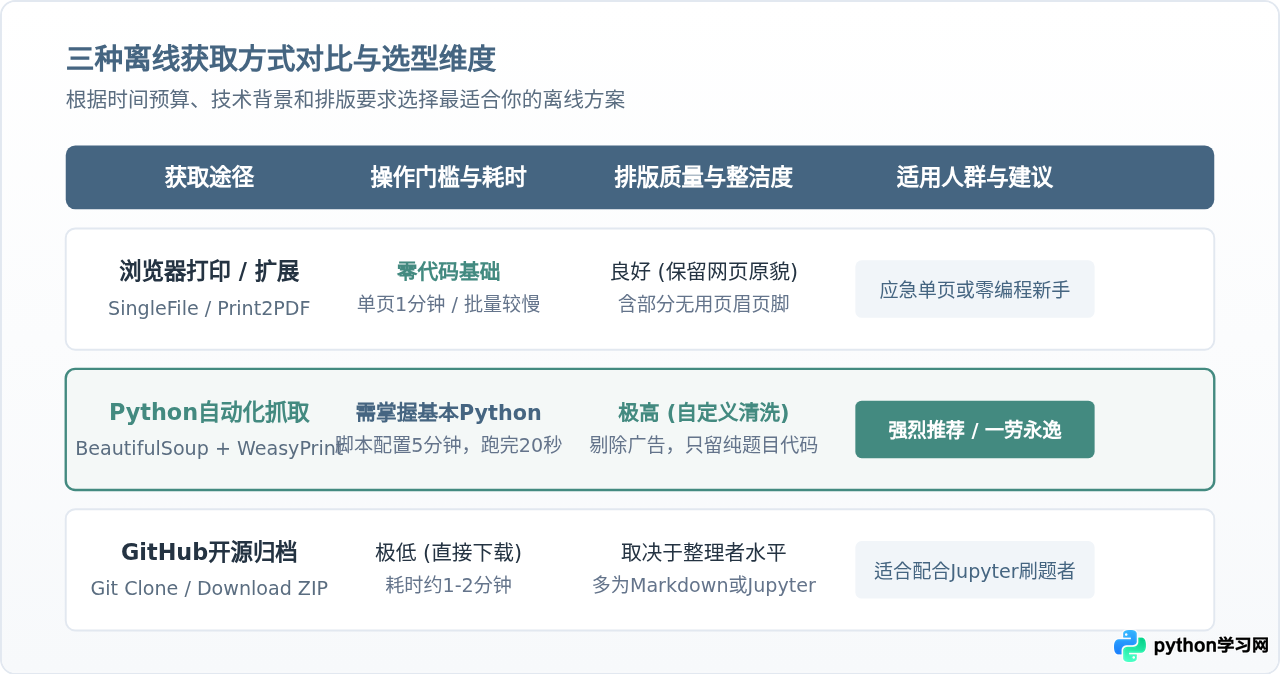
二、方法一:零门槛浏览器打印与扩展保存
如果不需要批量写代码,只想快速将特定题目或整本页面存入iPad或电脑本地阅读,利用浏览器内置的“另存为PDF”是最直接的方式。
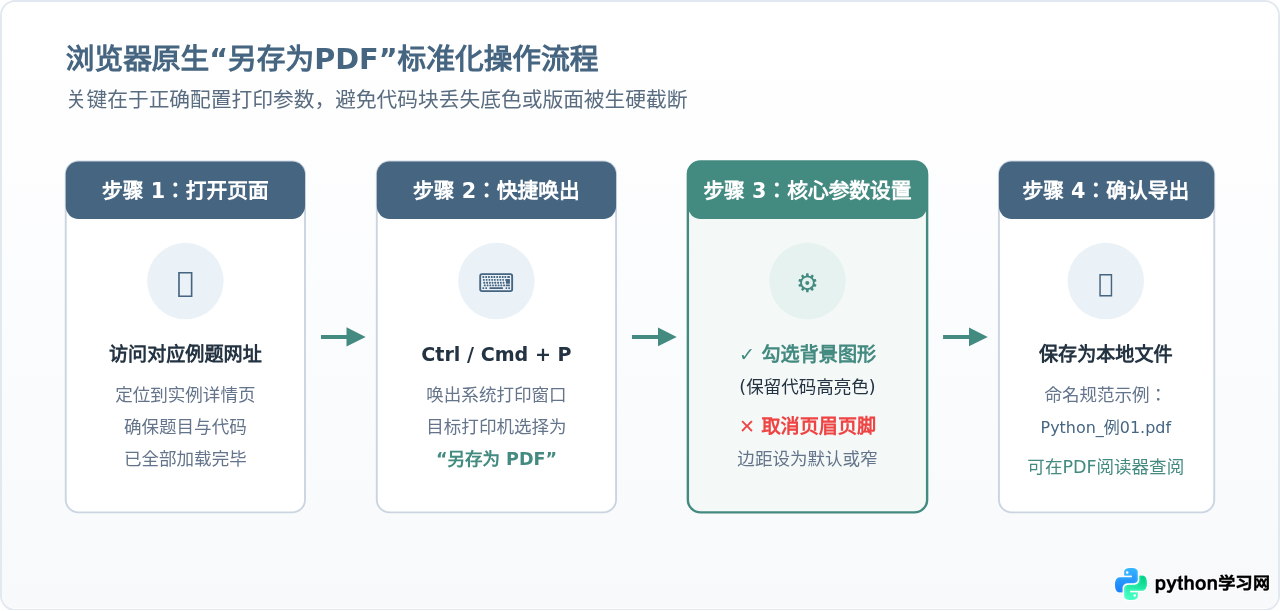
1. 浏览器自带打印功能(Ctrl + P / Cmd + P)
现代Chromium内核浏览器(如Google Chrome、Microsoft Edge)提供了高度成熟的打印渲染引擎:
- 在浏览器中打开目标实例页面(如
https://www.runoob.com/python/python-exercise-example1.html)。 - 按下快捷键
Ctrl + P(Windows)或Cmd + P(Mac)呼出打印面板。 - 在“目标打印机”下拉菜单中选择“另存为 PDF”。
- 点击“更多设置”:
- 背景图形:务必勾选,否则代码高亮底色和语法着色会变为纯白。
- 页眉和页脚:建议取消勾选,避免在导出的每一页上下打印出网页URL和系统时间。
- 边距:选择“默认”或“无”,让代码块排版更宽敞。
- 点击“保存”,选择保存路径即可生成清晰的PDF文件。
2. 使用 SingleFile 扩展打包完整单页
如果希望导出的资料保持网页原有的CSS样式、语法高亮与字体,还可以安装浏览器开源扩展SingleFile(支持Chrome、Edge、Firefox)。
在菜鸟教程页面点击扩展图标,SingleFile会将整个网页中的CSS、内嵌图片与DOM节点压缩并打包为一个单独的 .html 文件。双击即可在任何离线电脑上用任意浏览器秒开,效果与线上完全一致。
三、方法二:利用Python自动化脚本批量生成全套PDF(推荐)
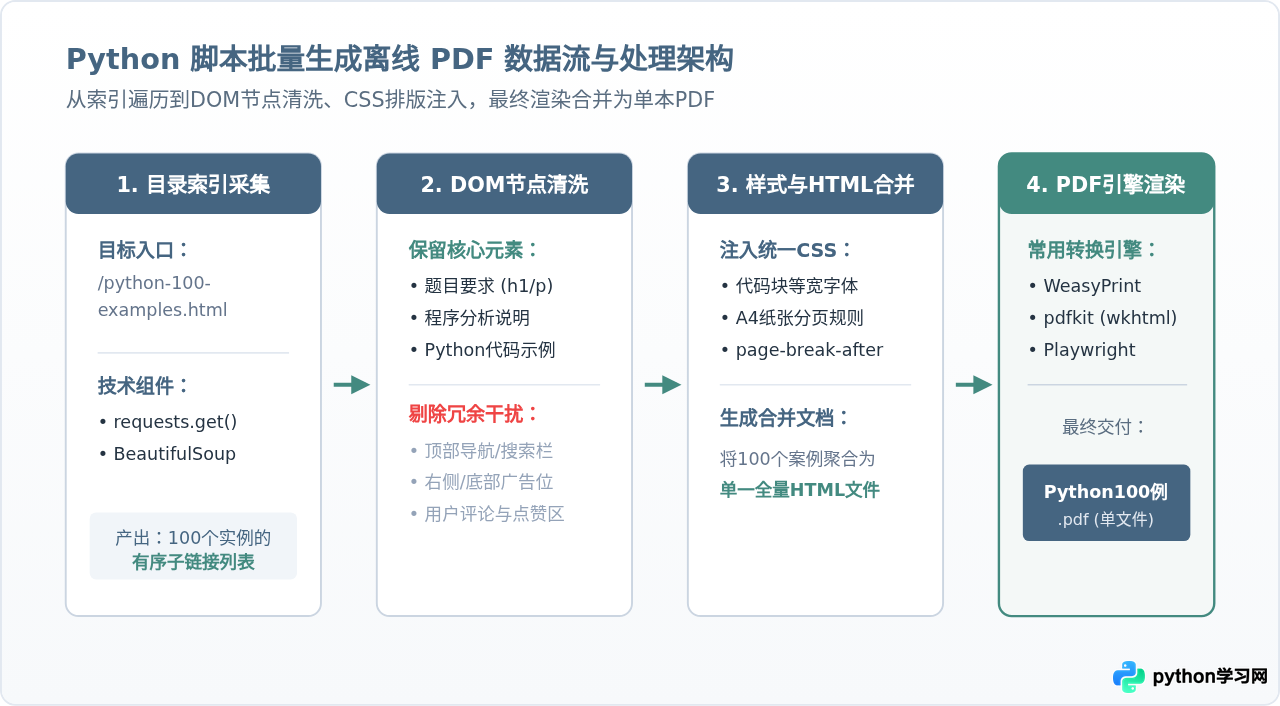
如果逐页打印100个网页,需要重复手动操作100次,效率极低。掌握Python基础的读者,完全可以用Python自己写一个批量抓取脚本:首先请求主目录提取100个案例的URL,接着清洗提取正文(剔除侧边栏、广告和评论),最后合并转换为一本连贯的PDF电子书。
1. 依赖库准备
推荐使用 requests 处理网络请求,beautifulsoup4 进行HTML节点定位,以及轻量且不依赖复杂外部环境的 weasyprint(或 pdfkit)完成渲染:
# 终端安装基础依赖
pip install requests beautifulsoup4 weasyprint
2. 核心脚本实现代码
下面是一个经过模块化设计的完整Python脚本示例。脚本会自动解析目录页,循环抓取100个案例的题目要求与代码,注入分页与排版CSS,最后输出为单一PDF:
import os
import time
import requests
from bs4 import BeautifulSoup
from weasyprint import HTML

BASE_URL = "https://www.runoob.com"
INDEX_URL = f"{BASE_URL}/python/python-100-examples.html"
HEADERS = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
}

def get_example_links():
    """从菜鸟教程Python 100例主索引页获取所有题目链接"""
    resp = requests.get(INDEX_URL, headers=HEADERS, timeout=10)
    resp.encoding = "utf-8"
    soup = BeautifulSoup(resp.text, "html.parser")

    links = []
    content_div = soup.find("div", class_="article-intro")
    if not content_div:
        return links

    for a in content_div.find_all("a"):
        href = a.get("href")
        if href and "python-exercise-example" in href:
            full_url = href if href.startswith("http") else f"{BASE_URL}{href}"
            if full_url not in links:
                links.append(full_url)
    return links

def fetch_case_content(url):
    """抓取单个案例的题目、分析与代码"""
    resp = requests.get(url, headers=HEADERS, timeout=10)
    resp.encoding = "utf-8"
    soup = BeautifulSoup(resp.text, "html.parser")

    # 核心正文节点通常在 class 为 article-intro 的容器中
    article = soup.find("div", class_="article-intro")
    if not article:
        return ""

    # 移除所有无关 script 和推广外部链接
    for bad_tag in article.find_all(["script", "ins", "iframe"]):
        bad_tag.decompose()

    return str(article)

def build_pdf(links, output_pdf="Runoob_Python_100_Cases.pdf"):
    """拼接所有内容并使用WeasyPrint导出PDF"""
    css_style = """
    <style>
        @page { size: A4; margin: 18mm 15mm; }
        body { font-family: 'PingFang SC', 'Microsoft YaHei', sans-serif; color: #222; }
        .case-wrapper { page-break-after: always; padding-bottom: 20px; }
        pre, code { font-family: monospace; background: #f5f5f5; border-radius: 4px; }
        pre { padding: 12px; border: 1px solid #ddd; white-space: pre-wrap; }
        h1, h2, h3 { color: #456581; }
    </style>
    """

    combined_html = f"<html><head>{css_style}</head><body>"
    for index, link in enumerate(links, 1):
        content = fetch_case_content(link)
        combined_html += f'<div class="case-wrapper"><h2>第 {index} 例</h2>{content}</div>'
        time.sleep(0.3)  # 礼貌延时,避免瞬时并发给源站带来压力

    combined_html += "</body></html>"
    HTML(string=combined_html).write_pdf(output_pdf)
    print(f"导出成功,文件位于:{output_pdf}")

if __name__ == "__main__":
    links = get_example_links()
    print(f"成功获取到 {len(links)} 个题目链接,开始下载与转换...")
build_pdf(links)1. 设置延时:菜鸟教程页面为公共资源,使用爬虫时必须保留 time.sleep(0.3) 以上的请求间隔,避免被服务器IP限流或触发验证码。
2. 分页符控制:在CSS中给每个题目的容器包裹 page-break-after: always;,这样生成的PDF中每个练习题都会从新的一页开始,打印或翻阅时非常整齐。
四、方法三:获取社区已有的开源归档工程
如果不愿自己运行脚本,也可以直接利用开源社区开发者整理好的成果。在GitHub或Gitee上,许多开发者在刷完菜鸟教程Python 100例后,会将代码、题目说明和解题思路整理成结构化的项目。
1. 检索关键词
在GitHub或Gitee搜索框中输入以下关键词:
runoob-python-100-examples菜鸟教程 python 100例 markdownpython 经典练习100题 pdf
2. 常见开源格式与适用软件
| 文件格式 | 主要特点 | 推荐阅读/练习工具 |
|---|---|---|
| 排版固定、开箱即读,适合平板手写批注或A4纸质打印 | Adobe Acrobat, Edge/Chrome内置阅读器, GoodNotes | |
| .md (Markdown) | 纯文本存储,便于全文搜索、个人增删改动和补充个人题解 | Typora, Obsidian, VS Code, MarkText |
| .ipynb (Jupyter) | 题目与代码单元格交互,可直接在本地按 Shift+Enter 逐题运行调试 | Jupyter Notebook, JupyterLab, VS Code Jupyter扩展 |
从第三方开源社区或网盘下载资料时,仅下载 .pdf、.md、.ipynb 或 .zip 文本格式。切勿下载或运行扩展名为 .exe、.bat、.vbs 等可执行文件,谨防虚假捆绑软件与恶意木马。
五、离线资料的高效练习与学习闭环
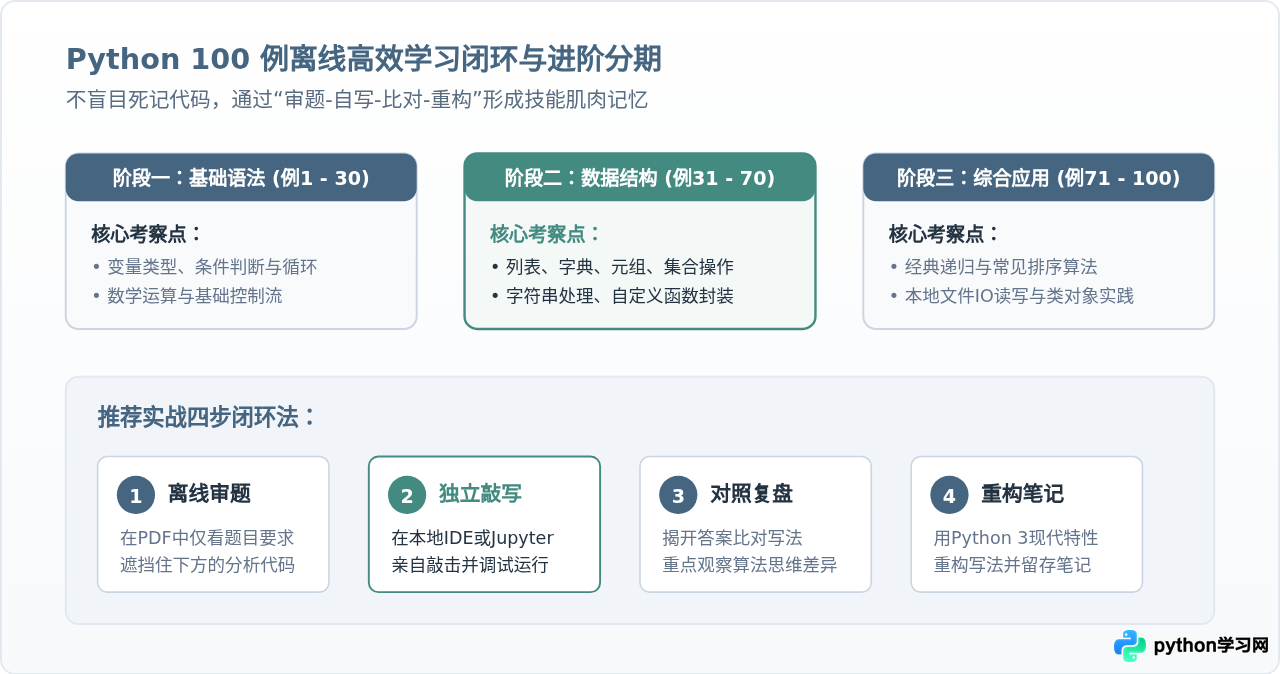
下载到完整的PDF或离线文档仅是第一步,编程学习的关键在于“脱离参考答案独立敲代码”。很多初学者把100题当成小说看,结果合上书后依然写不出程序。
六、常见问题与注意事项
在离线使用或制作Python 100例资料时,读者往往会遇到以下两个容易困扰的问题:
- Python 2 与 Python 3 语法差异:菜鸟教程部分历史案例早期基于Python 2编写(如
print "Hello"无括号语法、xrange()等)。在离线练习时,请统一采用现代 Python 3.x 语法标准进行重构(例如使用print()函数和range())。 - 代码缩进丢失或Tab错乱:从PDF中复制带缩进的代码到编辑器时,有时制表符或空格会被PDF排版引擎压缩为单个空格,导致出现
IndentationError。因此强烈建议看懂逻辑后在本地编辑器手动敲写,而不是直接复制粘贴。
总结来说,获取菜鸟教程Python 100例离线资料并没有门槛阻碍。如果时间紧促、仅需偶尔参阅,使用浏览器的“打印为PDF”即可快速保存;如果想要一份排版清爽、无广告且带分页的书籍式PDF,利用上文提供的Python抓取清洗脚本是最优解;而如果偏好在Jupyter等交互式环境中练习,直接检索下载社区开源的 .ipynb 仓库最为契合。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









