

Python自动化入门:5个核心库推荐与学习路线
针对初学者的Python自动化入门指南,系统推荐openpyxl、python-docx、requests、playwright、schedule五大核心库,并提供四阶段递进式学习路线与实战避坑建议。
一、自动化初学者的认知界定与选型逻辑
很多初学者一提到自动化,第一反应往往是“写网络爬虫”或“写复杂的图形界面测试”。这种认知看似合理,因为网页爬虫和界面点击具有很强的直观反馈;但实际上,爬虫面临频繁的反爬策略与页面改版,UI模拟则容易受到窗口分辨率、弹窗遮挡等不稳定因素干扰,对于新手而言维护成本极高。
真正能够迅速在工作中带来稳定收益的,是结构化本地文档处理与规范的数据接口交换。遵循从“确定性高”到“动态性高”的原则,自动化的学习应当优先覆盖格式固定的本地文件(Excel、Word),随后延伸到标准的Web API接口,最后才是动态网页模拟与任务调度。
二、5个核心库详解与最小可用示例
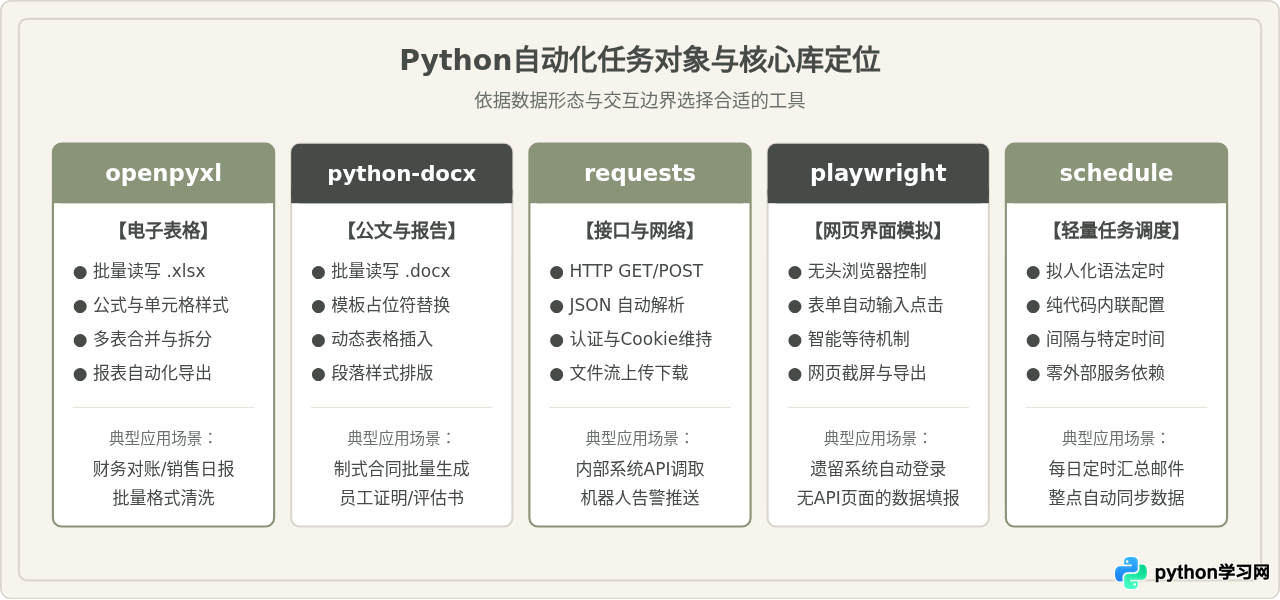
1. openpyxl:电子表格批量处理
Excel是现代办公中最广泛的数据载体。openpyxl专门用于处理 .xlsx 格式文件。与功能庞大、依赖C底层的 pandas 相比,openpyxl 更加轻量,能够精细化保留和修改单元格样式、背景色、字体以及公式表达式。
实战场景:合并同一目录下所有分支部门上报的销售表格,并自动在末尾追加求和公式。
from pathlib import Path
from openpyxl import load_workbook, Workbook

def merge_sales_reports(source_dir: Path, output_file: Path):
    target_wb = Workbook()
    target_ws = target_wb.active
    target_ws.title = "汇总表"
    target_ws.append(["部门", "销售员", "本月业绩"])

    for file_path in source_dir.glob("*.xlsx"):
        wb = load_workbook(file_path, data_only=True)
        ws = wb.active
        # 跳过首行表头,提取有效记录
        for row in ws.iter_rows(min_row=2, values_only=True):
            if row[0] is not None:
                target_ws.append(row)

    # 在最后一行添加合计公式
    total_row = target_ws.max_row + 1
    target_ws.cell(row=total_row, column=1, value="合计")
    target_ws.cell(row=total_row, column=3, value=f"=SUM(C2:C{total_row - 1})")

    target_wb.save(output_file)

# 示例调用
# merge_sales_reports(Path("./reports"), Path("./final_summary.xlsx"))
load_workbook(filename) 时未指定参数,单元格读出的将是公式本身(例如 =A1+B1)而不是数值结果。如果需要读取之前由Excel计算好的数值,必须显式设置 data_only=True;但此时若修改并保存该文件,原有公式将被静态值覆盖。因此,读数据和重写模板时建议分开处理。
2. python-docx:文档报告批量生成
在涉及人事录用通知书、制式服务合同、培训结业证明等场景中,大量文档结构完全一致,仅姓名、日期、金额等关键字段不同。python-docx 可以对 .docx 文档进行精确的文本与表格控制。
实战场景:读取预先设计好的模板文档,将特定的占位符替换为实际业务数据,批量导出命名规范的正式文件。
from pathlib import Path
from docx import Document

def generate_contract(template_path: Path, output_path: Path, context: dict):
    doc = Document(template_path)

    # 替换段落中的占位符
    for paragraph in doc.paragraphs:
        for key, val in context.items():
            placeholder = f"{{{{{key}}}}}"
            if placeholder in paragraph.text:
                # 提示:直接替换paragraph.text可能会破坏该段落原有的特殊加粗等局部格式
                paragraph.text = paragraph.text.replace(placeholder, str(val))

    # 替换表格中的占位符
    for table in doc.tables:
        for row in table.rows:
            for cell in row.cells:
                for key, val in context.items():
                    placeholder = f"{{{{{key}}}}}"
                    if placeholder in cell.text:
                        cell.text = cell.text.replace(placeholder, str(val))

    doc.save(output_path)

# 示例数据
# data = {"client_name": "星河科技有限公司", "amount": "88,000", "sign_date": "2026-10-25"}
# generate_contract(Path("template.docx"), Path("星河科技_合同.docx"), data)
run 对象。如果占位符(如 {{client_name}})在编辑时被打断,直接在 run.text 级别匹配可能会漏掉。在制作模板时,建议一次性完整输入占位符,或者在段落层级做文本替换。
3. requests:数据接口交互与跨系统打通
自动化流程往往需要外部系统的数据输入或将结果推送通知。requests 是 Python 事实上的 HTTP 客户端标准,语法清晰简洁,非常适合与企业微信群机器人、飞书机器人、钉钉告警或各类内部微服务 RESTful API 进行对接。
实战场景:将自动跑出的报表指标,通过网络请求发送到群机器人,实现无人值守的实时结果同步。
import requests

def notify_webhook(webhook_url: str, message_text: str) -> bool:
    payload = {
        "msgtype": "text",
        "text": {
            "content": message_text
        }
    }
    headers = {"Content-Type": "application/json"}

    try:
        response = requests.post(
            webhook_url,
            json=payload,
            headers=headers,
            timeout=10
        )
        response.raise_for_status()
        res_json = response.json()
        return res_json.get("errcode") == 0
    except requests.exceptions.RequestException as e:
        print(f"告警通知发送失败: {e}")
        return False
4. playwright:现代化浏览器界面自动化
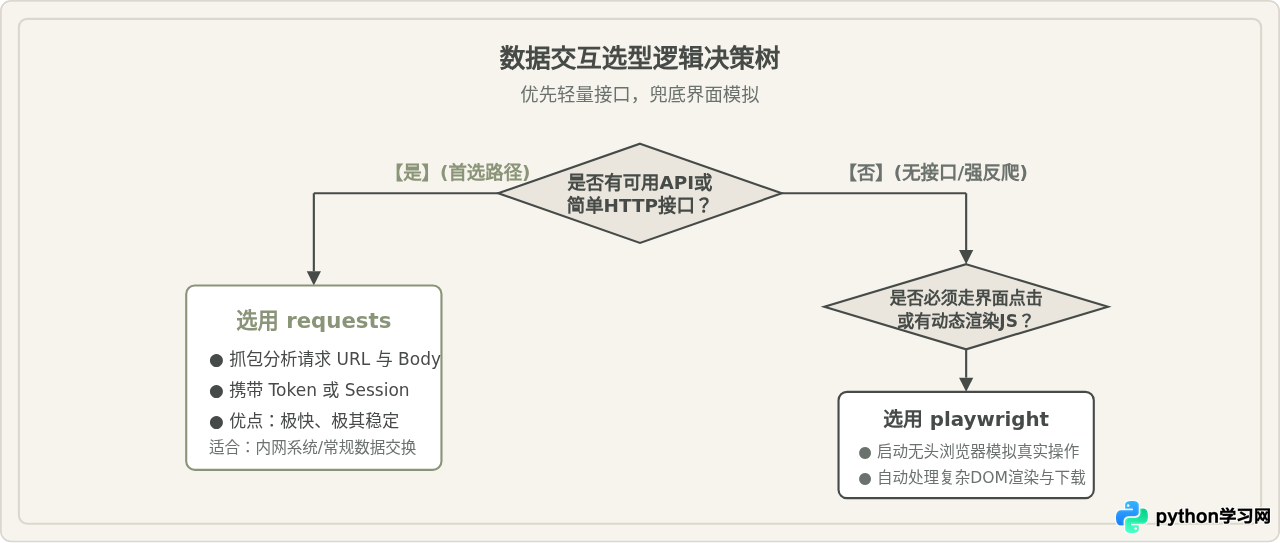
当目标业务系统没有开放任何 API 接口,或者接口需要复杂的动态令牌与验证码时,浏览器自动化就成为了兜底手段。与早期的 selenium 相比,微软维护的 playwright 具有自动等待页面元素就绪、内置强大的录制功能(playwright codegen)以及更简单的并发控制等优势。
实战场景:自动打开后台网页,输入账号密码登录,跳转到导出页面并下载当天的对账单。
from playwright.sync_api import sync_playwright

def download_daily_bill(login_url: str, download_folder: str):
    with sync_playwright() as p:
        browser = p.chromium.launch(headless=True)
        context = browser.new_context(accept_downloads=True)
        page = context.new_page()

        # 访问并输入登录表单
        page.goto(login_url)
        page.fill('input[name="username"]', "automation_bot")
        page.fill('input[name="password"]', "SecretPass123")
        page.click('button[type="submit"]')

        # 等待页面导航至后台首页
        page.wait_for_url("**/dashboard")

        # 监听并捕获下载事件
        with page.expect_download() as download_info:
            page.click("text=导出今日对账单")

        download = download_info.value
        download.save_as(f"{download_folder}/{download.suggested_filename}")

        browser.close()
time.sleep(5) 等待元素加载。网络抖动或渲染变慢会导致点击失败,而加载迅速时又白白浪费时间。playwright 默认在执行 click 或 fill 时自动等待元素可见可交互,充分利用内置的等待机制是保证脚本稳定性的关键。
5. schedule:极简任务调度
编写完自动化脚本后,如果每次都需要人工在终端敲命令执行,自动化就只完成了一半。在无需部署大型分布式调度系统(如 Airflow 或 Celery)的场景下,schedule 提供了纯 Python 语法的定时执行能力。
import time
import schedule

def main_job():
    print("开始执行自动化处理任务...")
    # 此处调用前面的 openpyxl 处理与 requests 推送逻辑

# 声明任务执行频率
schedule.every().day.at("09:30").do(main_job)
schedule.every(2).hours.do(main_job)

if __name__ == "__main__":
    print("定时服务已启动,按 Ctrl+C 退出。")
    while True:
        schedule.run_pending()
        time.sleep(1)
三、两种外部交互手段的选型决策:API与UI
在涉及与外部软件交互时,初学者最容易在“用 requests 调接口”与“用 playwright 模拟点击”之间犹疑不决。很多人为了省事,不论什么场景都直接上浏览器模拟,这种做法往往带来高频的维护困境。
下表对比了这两种方式的本质区别与适用前提:
| 对比维度 | 网络接口方式(requests) | 浏览器模拟方式(playwright) |
|---|---|---|
| 执行速度 | 毫秒级别,无渲染损耗 | 秒级以上,需加载DOM/CSS/JS |
| 资源开销 | 极低,仅占用少量内存与网络带宽高 | 需运行浏览器内核,内存与CPU占用较高 |
| 稳定性 | 高,只要协议不变就不会崩溃 | 中等,容易受前端弹窗、改版与异步加载影响 |
| 适用边界 | 系统开放了API,或接口抓包逻辑清晰简单 | 复杂单页应用(SPA)、动态鉴权、强制滑动验证 |
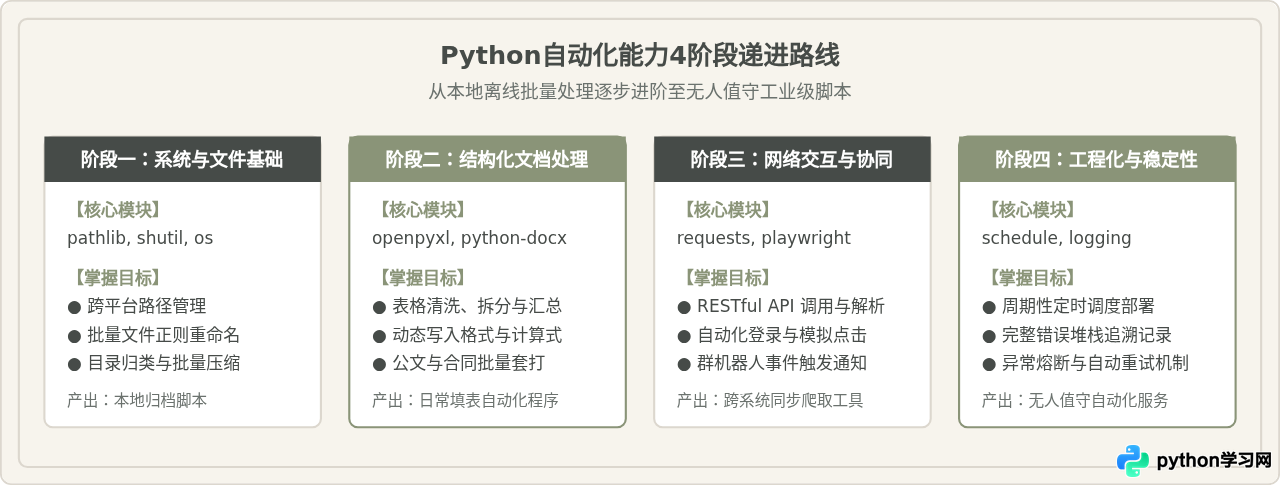
四、4个阶段的自动化进阶学习路线
掌握自动化不需要一口吃成胖子。按照由内而外、从确定性到健壮性的学习路径,可以避免由于知识跨度过大而产生挫败感:
阶段一:文件系统与基础语法底座
这个阶段的目标是让计算机能按照规则批量定位与重命名文件。需要掌握:
- Python内置的
pathlib.Path:路径拼接、通配符查找(glob)、创建目录与检测存在。 - 标准库
shutil与os:文件的移动、复制、压缩打包。 - 基础数据结构:列表(遍历批量文件)与字典(映射配置参数)。
阶段二:结构化本地文档自动化
目标是彻底解决重复机械的填表与报告撰写。核心抓手是 openpyxl 与 python-docx:
- 掌握多表格批量抽取特定行、多工作簿合并与格式清洗。
- 掌握制式报告模板的占位符批量填充、生成个性化合同或证明文件。
- 理解文件打开与保存的安全机制,学会用异常处理防止脚本写入中断损坏原文件。
阶段三:跨网络与系统联动
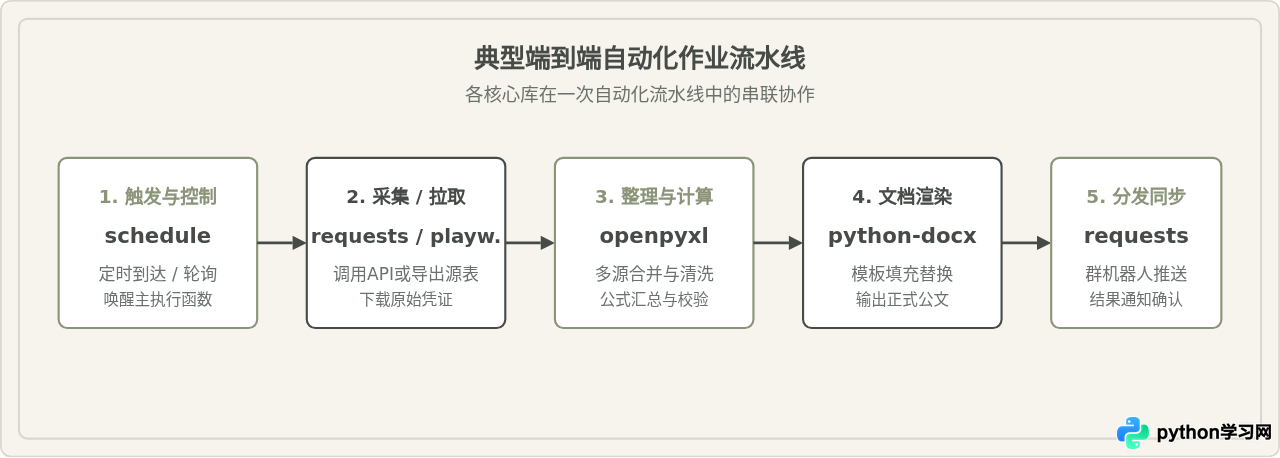
目标是打通“数据获取 - 本地加工 - 结果分发”的完整链路:
- 使用
requests对接企业内部系统 API、解析 JSON 数据并与 Excel/Word 串联。 - 使用
playwright录制并实现无 API 系统的自动化登录、填报与下载。 - 掌握企业微信、钉钉或邮件协议(
smtplib),完成自动回落通报。
阶段四:工程化与无人值守守护
目标是让脚本在服务器或工作电脑上长期平稳运行,出现意外可排查:
- 使用
schedule或操作系统定时器(Windows任务计划程序 / Linux crontab)进行定时调度。 - 引入
logging标准模块记录每次执行的开始、耗时、处理数量与异常堆栈。 - 建立容错保护(防御性编程):在主循环中添加
try...except,避免单条数据报错导致整个轮询服务死掉。
五、入门阶段的三大关键防坑准则
-
严禁硬编码绝对路径:新手常将路径写为
C:\\Users\\Administrator\\Desktop\\data.xlsx,一旦脚本在同事电脑或服务器上运行就会报错。始终优先使用Path(__file__).resolve().parent来基于当前脚本位置计算相对路径。 -
为每一个外部IO加上超时与保护:无论是读取网络接口(
requests)还是控制网页元素(playwright),永远必须设置timeout参数。永远不要让脚本在网络抖动或断网时陷入无限挂起的假死状态。 - 源文件只读不破坏:进行 Excel 或 Word 自动化批量修改时,不要直接原地覆盖原文件。标准做法是先另存为备份或者输出到新目录,确认处理条目数量完整一致后,再进行归档。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









