

Python基础语法速查:变量、数据类型与控制流详解
本文系统梳理Python基础语法的核心脉络,聚焦变量引用机制、内置数据类型特性及控制流执行逻辑,提供清晰的代码示例、常见易错陷阱排查及四幅高清晰度矢量结构图。
掌握Python的核心在于理解其动态类型与对象引用的本质、熟练选用合适的数据容器,以及准确运用分支与循环控制程序的流转方向。本文剥离泛化的概念铺垫,直击变量分配、常用内置数据结构及控制流语法的底层运转方式与实操要点,帮助你在编写和阅读代码时快速建立清晰的执行模型。
一、变量定义与对象引用机制
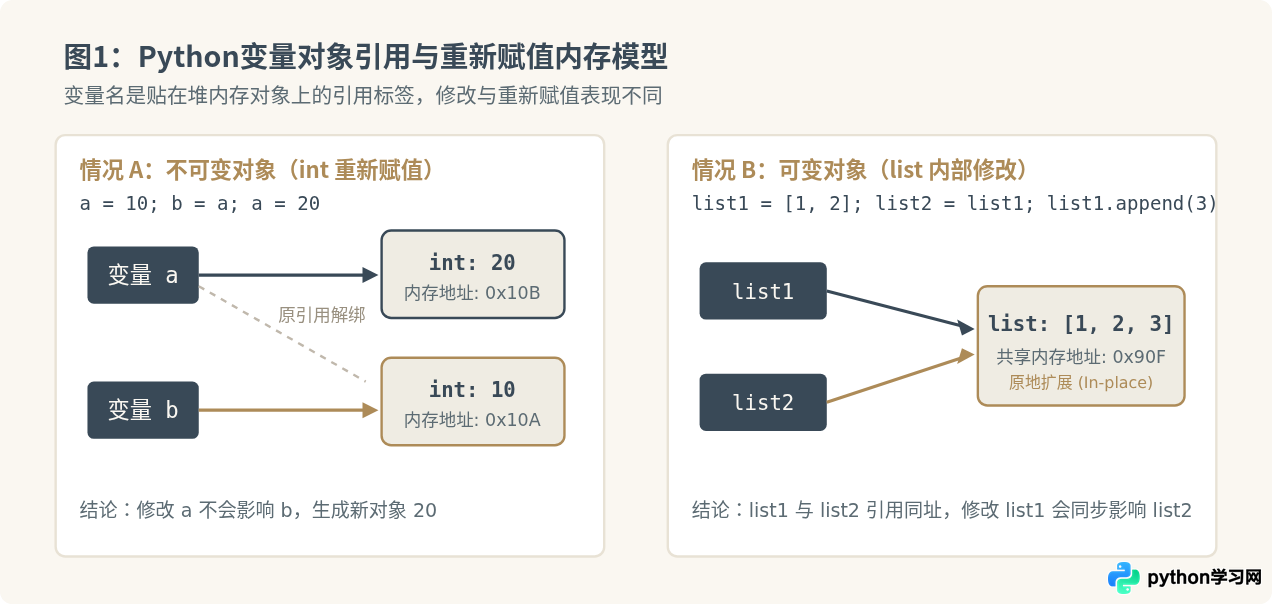
在Python中,声明变量不需要指定类型,直接使用赋值运算符 = 即可完成创建。但与其他静态语言不同的是,Python中的变量名本质上并不是容纳数据的物理内存格子,而是指向具体对象内存地址的“名称标签”。
# 变量定义与多重赋值
status_code = 200
user_name = "Alice"
is_active = True

# 链式赋值与解包赋值
x = y = z = 0
a, b = 10, 20
a, b = b, a  # 原生支持优雅的变量值交换
变量命名的基本规则要求首字符必须是字母或下划线,后续字符可包含数字、字母及下划线,且严格区分大小写。遵循PEP 8规范,普通变量与函数名推荐使用蛇形命名法(如 max_retry_count),常量采用全大写加下划线(如 MAX_CONNECTIONS)。
理解变量的底层引用对于规避意外的数据改写至关重要。当执行 y = x 时,并不是在内存中将数据复制了一份,而是让 y 指向与 x 相同的对象地址。判断两个变量的值是否相同使用 ==,而判断两个变量是否引用同一个对象则使用 is 操作符(对应内置函数 id() 返回的内存地址)。
二、核心数据类型特征与容器选型
Python内置了丰富的基本标量类型与容器结构。根据数据的可变性、访问模式与结构特征合理选择类型,是保证代码效率与可维护性的基础。
1. 标量类型:数值、布尔与字符串
- 数值类型(int, float):Python 3中的整型具备高精度特性,不会出现整数溢出;除法
/始终返回浮点数,整除使用//,取模使用%,幂运算使用**。 - 布尔类型(bool):包含
True和False,本质是整型子类(int(True) == 1)。在控制流判定中,数字0、空字符串""、空容器[]/{}/set()以及None均被视作假值(Falsy)。 - 字符串(str):字符的不可变序列,支持切片操作
s[start:stop:step]。推荐优先使用 f-string 进行字符串格式化插值:f"User: {user_name}, Score: {score:.2f}"。
2. 四大内置容器:列表、元组、字典与集合
针对批量数据,Python提供了四种用途分明的容器:
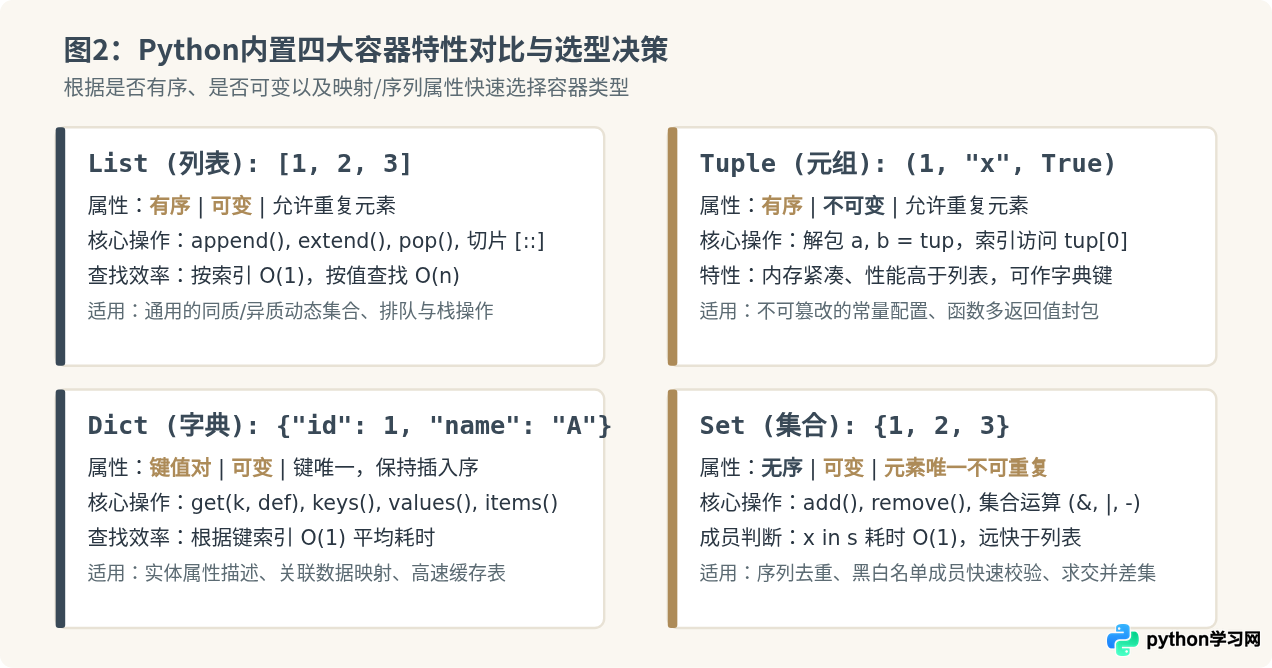
- 列表(List):有序、可变,元素可重复。支持追加
append()、按索引插入与删除。适合需要动态变动长度并保持插入次序的序列。 - 元组(Tuple):有序、不可变,元素可重复。声明后内部元素不可改动。作为轻量级记录容器,不仅内存开销低于列表,还可用作字典的键。
- 字典(Dict):键值对映射,无重复键。自Python 3.7起键保持插入顺序,基于哈希表实现,键的查找与写入具有平均 O(1) 时间复杂度。字典的键必须是可哈希(不可变)对象。
- 集合(Set):无序、元素唯一且可变。基于哈希表实现去重与成员资格判断(
in操作平均耗时 O(1)),并支持数学意义上的交集(&)、并集(|)与差集(-)计算。
三、控制流语句与逻辑控制
控制流决定了指令被执行的次序。Python使用严格的缩进(推荐4个空格)来定义逻辑代码块,消除了其他语言中的大括号与明确闭合关键字。
1. 条件判断(if / elif / else)
条件分支根据布尔表达式的结果决定分支走向,支持逻辑运算符 and、or、not。Python支持链式条件比较,例如 0 <= score <= 100 等价于 score >= 0 and score <= 100。
# 条件分支与三元表达式
score = 85

if score >= 90:
    grade = "A"
elif score >= 80:
    grade = "B"
elif score >= 60:
    grade = "C"
else:
    grade = "D"

# 条件表达式(三元运算符):[真值表达式] if [条件] else [假值表达式]
result = "Pass" if score >= 60 else "Fail"
2. 循环结构(for 与 while)
for 循环在Python中本质上是“迭代器消费模式”,用于遍历任意可迭代对象(如列表、字符串、字典、生成器)。搭配内置的 range()、enumerate() 与 zip() 可以高效完成计数和成对遍历:
# 常用遍历范式
names = ["Alice", "Bob", "Charlie"]

# 计数遍历
for i in range(len(names)):
    pass

# enumerate 同时获取索引与值
for idx, name in enumerate(names, start=1):
    print(f"{idx}: {name}")

# zip 并行迭代多个序列
scores = [92, 85, 78]
for name, score in zip(names, scores):
    print(f"{name} -> {score}")
while 循环则用于在满足指定条件时持续循环,注意必须在循环体内部推进状态更新以避免死循环:
count = 3
while count > 0:
    print(f"倒计时: {count}")
    count -= 1
3. 循环跳转:break、continue 与循环特有的 else 分支
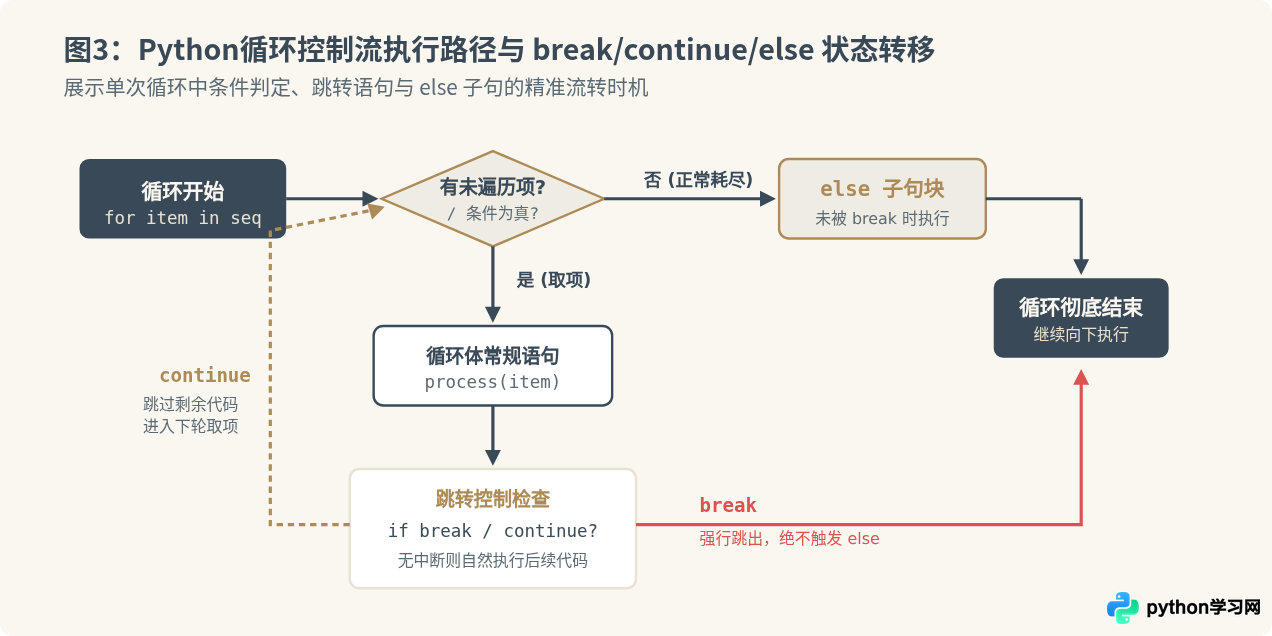
循环体内的执行流向由三个关键机制控制:
break:立即彻底终止当前所在层的整个循环,跳出循环体。continue:立即终止当前这一轮迭代,跳过循环体中剩余的代码,直接开始下一轮迭代。- 循环的
else子句:当且仅当循环正常遍历完毕(即没有遇到break中断)时触发执行。这一结构非常适合用来处理“在序列中搜索目标,未找到时执行备选逻辑”的场景,能够完全避免引入额外的状态标记布尔变量。
四、常见语法陷阱与排查避坑
初学者在编写Python代码时,常因忽略对象引用与作用域特性而遭遇意外Bug。以下列出三类最为典型的语法陷阱及标准解决方案。
陷阱 1:默认参数使用可变对象
表现:函数定义时如果将空列表 [] 或空字典 {} 作为形参默认值,多次调用该函数时,默认值会在不同调用之间共享累加。
原因:Python函数的默认参数在函数定义时完成求值并绑定一次,而不是在每次调用时重新创建。所有未显式传入该参数的调用,都会共享同一个可变对象引用。
# 错误示例:默认参数共享
def add_item_bad(item, target_list=[]):
    target_list.append(item)
    return target_list

print(add_item_bad(1))  # 示例输出: [1]
print(add_item_bad(2))  # 示例输出: [1, 2](意外累加了前次结果)

# 正确做法:使用 None 作为占位符,函数内部动态初始化
def add_item_good(item, target_list=None):
    if target_list is None:
        target_list = []
    target_list.append(item)
    return target_list
陷阱 2:遍历列表的同时直接增删元素
表现:在 for item in my_list: 循环中调用 my_list.remove(item) 或 del,会出现跳过某些元素、删不干净甚至索引越界的诡异现象。
原因:迭代器内部维护了一个递增的偏移索引。当你在原列表中删除一个元素时,其后所有元素会左移补位,但迭代器的索引指针依然加1,导致原本紧随其后的元素被直接跳过。
numbers = [1, 2, 2, 3, 4]

# 错误写法:无法彻底清除全部值为 2 的元素
for num in numbers:
    if num == 2:
        numbers.remove(num)
# 示例结果: numbers 为 [1, 2, 3, 4],第二个 2 被跳过了

# 正确做法 1:使用列表推导式生成全新过滤列表
numbers = [x for x in numbers if x != 2]

# 正确做法 2:若必须在原地修改,遍历原列表的浅拷贝副本
for num in numbers[:]:
    if num == 2:
        numbers.remove(num)
陷阱 3:混淆直接赋值、浅拷贝与深拷贝
表现:使用 list.copy() 或 dict.copy() 复制了包含嵌套容器的对象后,修改内层容器的数据,原对象的内层数据依然被同步更改。
原因:浅拷贝仅复制外层容器本身,容器内部存储的子对象引用依然指向原内存地址。若要完全隔断内外层所有对象的联系,必须使用 copy.deepcopy() 进行递归深拷贝。
import copy

origin = [[1, 2], [3, 4]]
shallow = origin.copy()
deep = copy.deepcopy(origin)

origin[0].append(99)
print(shallow)  # 示例输出: [[1, 2, 99], [3, 4]](内层对象受影响)
print(deep)     # 示例输出: [[1, 2], [3, 4]](完全独立)
五、基础语法核心体系速查总览
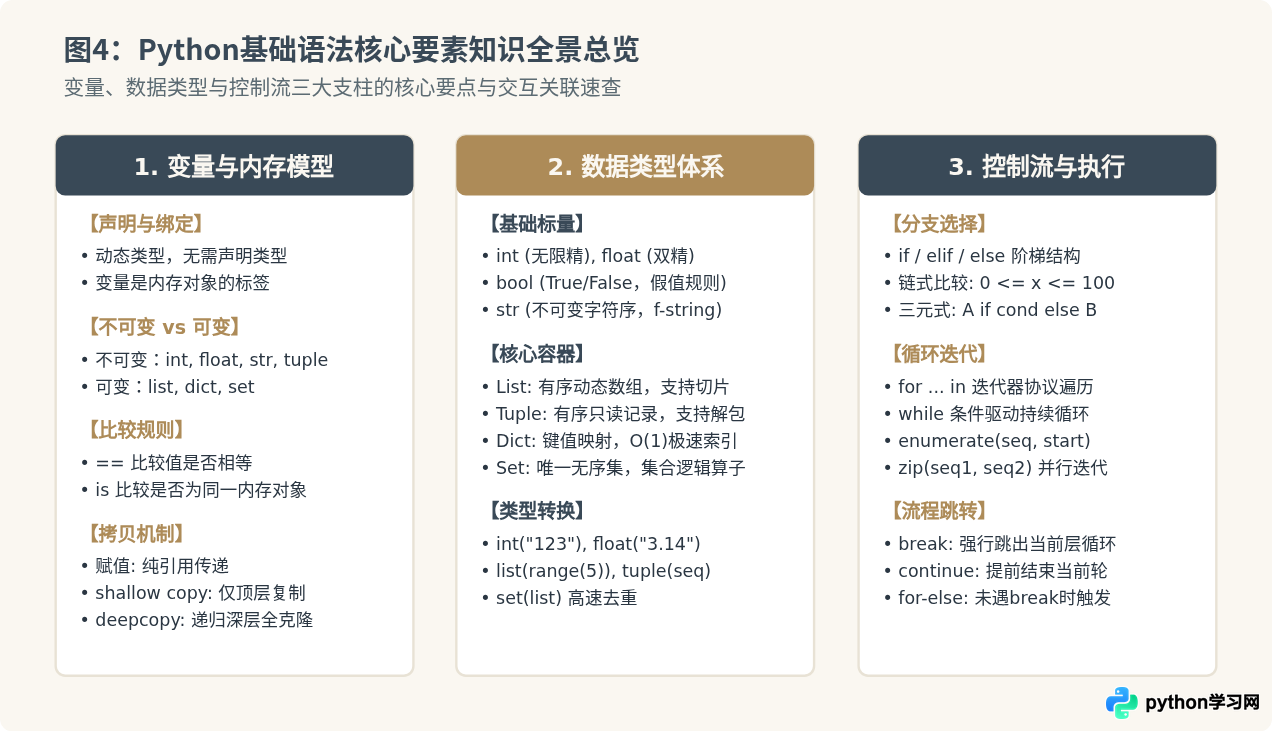
将变量机制、数据类型与控制流三者归纳总结,可以形成一张高密度的Python基础语法架构全景图。编写代码时,牢记“一切皆对象”、“按需选容器”与“逻辑缩进明确”三项基本法则,即可稳健驾驭日常开发中的绝大部分控制与数据处理任务。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









