

Python字符串切片基础练习题:索引、步长与默认值解析
深入解析Python字符串切片核心机制,系统拆解正负双向索引、左闭右开区间、步长方向与缺省默认值自动填充规则,配合精选练习题与工程图解,帮助读者彻底掌握切片运算。
掌握 Python 字符串切片的核心在于理解基本表达式 sequence[start:stop:step] 的三元机制:双向索引映射、左闭右开区间判定、步长正负决定的遍历方向,以及缺省参数触发的边界推导。许多初学者在遇到负索引与负步长组合时经常感到困惑,甚至对空字符串的返回原因缺乏清晰认识。本文从底层切片工作原理切入,通过严谨的推导流程与五道精选练习题,逐项解析索引、步长与默认值的运算逻辑。
一、字符串切片的核心结构:双向索引与区间定义
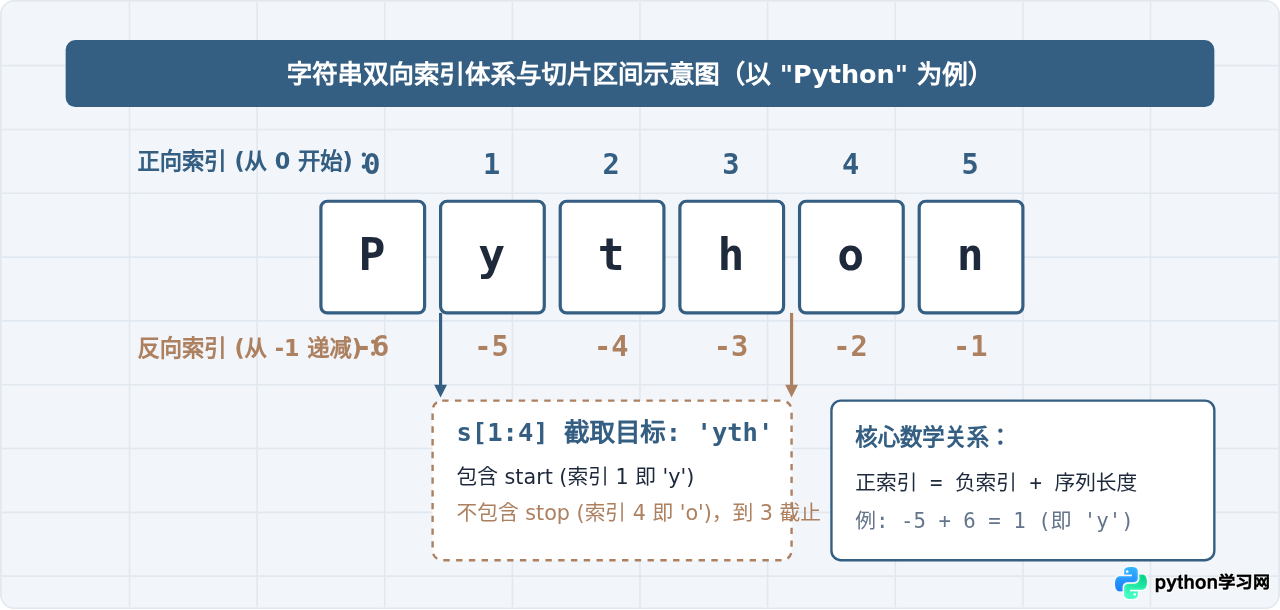
在 Python 中,字符串属于不可变序列(Sequence),序列中的每个字符都拥有双重索引编号:非负的“正向索引”(从 0 开始自左向右递增)与负数的“反向索引”(从 -1 开始自右向左递减)。切片表达式的基本形式为 s[start:stop:step],其中包含三个关键参数:
- start(起始索引):切片提取的第一个字符位置。
- stop(结束索引):切片截取的终止边界,在提取时遵循“左闭右开”规则,即结果包含
start对应的字符,但绝不包含stop对应的字符。 - step(步长):决定取值的步进距离与扫描方向。
step > 0时向右扫描,step < 0时向左扫描。默认值为1。
二、切片执行推导流程:步长与默认值判定逻辑
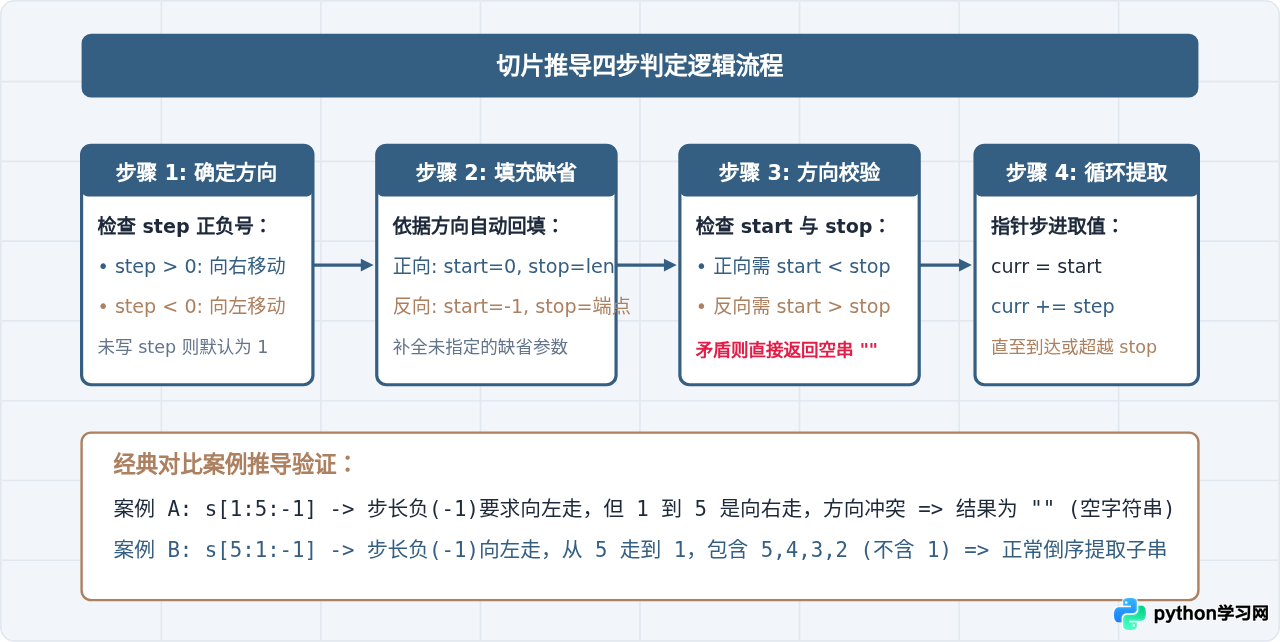
当切片表达式中省略部分参数时,Python 解释器会根据 step 的正负号执行确定性的缺省值推导机制。很多初学者以为 start 总是默认为 0,stop 总是默认为字符串末尾,这仅在 step > 0 时成立;一旦 step < 0,缺省行为将完全反转。
| 参数缺失情况 | 当步长为正 (step > 0) 时的默认值 | 当步长为负 (step < 0) 时的默认值 | 典型示例 |
|---|---|---|---|
start 省略 |
0(序列头部第一个元素) |
-1 或 len(s)-1(序列末尾最后一个元素) |
s[:3] 从 0 开始;s[:3:-1] 从 -1 开始 |
stop 省略 |
len(s)(越过末尾,保证取到末尾字符) |
理论上的负无穷端(保证左侧首字符能被取到) | s[2:] 取至末尾;s[3::-1] 取至索引 0 包含首字符 |
step 省略 |
默认为 1(正向单步扫描) |
s[1:4] 等同于 s[1:4:1] |
|
为了判断一个切片的结果,应严格按照四个工程步骤在脑海中执行模拟推导:
三、步长与缺省值行为的机制对比
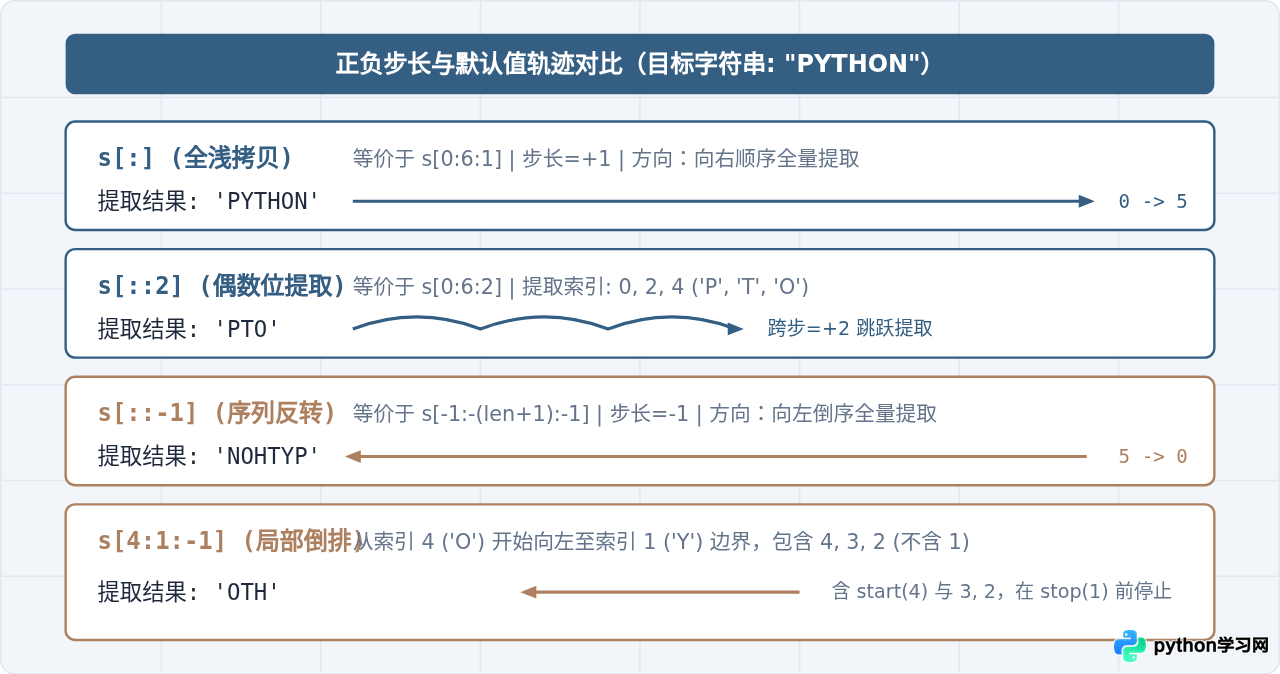
当开发者书写诸如 s[:]、s[::-1]、s[::2] 时,实际利用的是默认值的隐式机制。为了直观观察不同参数配置下的切片指针移动轨迹,我们将几种最常见切片模式的行为对比呈现在图 3 中:
四、基础练习题深度精析
为了检验对索引位置、步长正负与默认值推断的理解,下面通过五道典型题目进行细致拆解。请在看解答前先在心里得出自己的答案。
题目:给定字符串 text = "Developer",写出以下两个切片表达式的执行结果:
# 表达式 A
res_a = text[3:7]

# 表达式 B
res_b = text[-7:-2]
详细解析:
表达式 A 分析:text[3:7] 省略了 step,默认步长为 1(正向)。start = 3,stop = 7。字符串中索引 3 为 'e',索引 4 为 'l',索引 5 为 'o',索引 6 为 'p',索引 7 为 'e'。依据左闭右开规则,包含 3, 4, 5, 6,到 7 停止,因此结果为 'elop'。
表达式 B 分析:text[-7:-2] 中均采用负索引。字符串长度为 9。我们将负索引换算为正索引:start = -7 + 9 = 2(字符 'v'),stop = -2 + 9 = 7(字符 'e')。步长为默认值 1,因此该切片等价于 text[2:7],依次提取索引 2, 3, 4, 5, 6,结果为 'velop'。
# 输出验证
print(res_a)  # 示例输出: 'elop'
print(res_b) # 示例输出: 'velop'题目:给定字符串 code = "ABCDEFGHIJ",分别提取其偶数索引位字符(0, 2, 4...)与奇数索引位字符(1, 3, 5...),应如何写切片?另外说明 code[1:8:3] 的结果。
详细解析:
提取偶数索引位时,起始索引为 0,因为提取至末尾且步长为正,可以直接省略 start 与 stop,只需指定 step=2,即 code[::2]。由于 start 默认回填 0,因此依次取索引 0 ('A')、2 ('C')、4 ('E')、6 ('G')、8 ('I'),结果为 'ACEGI'。
提取奇数索引位时,起始索引必须从 1 开始,终止位置到末尾,故省略 stop,写作 code[1::2]。提取索引为 1 ('B')、3 ('D')、5 ('F')、7 ('H')、9 ('J'),结果为 'BDFHJ'。
对于 code[1:8:3],start=1,stop=8,step=3。第一次取索引 1 ('B'),下一次取 1 + 3 = 4 ('E'),再下一次取 4 + 3 = 7 ('H'),继续累加 7 + 3 = 10 >= 8 已超越 stop 边界,终止循环。因此结果为 'BEH'。
code = "ABCDEFGHIJ"
print(code[::2])     # 示例输出: 'ACEGI'
print(code[1::2])    # 示例输出: 'BDFHJ'
print(code[1:8:3]) # 示例输出: 'BEH'题目:给定字符串 alpha = "abcdef",请给出以下三个表达式的执行结果:
r1 = alpha[::-1]
r2 = alpha[4::-1]
r3 = alpha[:2:-1]
详细解析:
这是检验对负步长默认值掌握程度的经典题。此时 step = -1 < 0,扫描方向一律自右向左:
alpha[::-1]:start缺省填入 -1(最末字符'f'),stop缺省填入头部边界之外,从而能够完整提取到首位字符'a'。整串反转,输出'fedcba'。alpha[4::-1]:start = 4(字符'e'),stop缺省。因为是负步长,stop缺省意味着一直向左提取直到包含首个字符(索引 0)。提取序列为索引 4 ('e')、3 ('d')、2 ('c')、1 ('b')、0 ('a'),输出'edcba'。alpha[:2:-1]:start缺省,因为step < 0,start自动推断为末尾 -1(字符'f');stop = 2。依据“左闭右开”(此处为向左移动时的开区间),终止于索引 2 之前,即不包含索引 2(字符'c')。提取序列为索引 5 ('f')、4 ('e')、3 ('d'),在到达 2 时立刻停止。输出结果为'fed'。
alpha = "abcdef"
print(alpha[::-1])   # 示例输出: 'fedcba'
print(alpha[4::-1])  # 示例输出: 'edcba'
print(alpha[:2:-1]) # 示例输出: 'fed'题目:判断下列两个切片返回的结果是什么?为什么不会报错?
s = "Python"
ans_a = s[1:4:-1]
ans_b = s[4:1:1]
详细解析:
在 Python 中,单字符按索引访问(如 s[10])如果越界会抛出 IndexError;但切片操作永远不会引发 IndexError。如果切片边界矛盾或完全越界,Python 统一返回空序列(空字符串 "")。
分析 ans_a s[1:4:-1]:step = -1,指示必须向左走(索引递减)。但 start = 1,stop = 4,若要从 1 到达 4,必须向右移动(索引增加)。起始点到目标终点的逻辑方向与步长规定的前进方向产生直接冲突,因此第一次循环判断即已越界,返回空字符串 ""。
分析 ans_b s[4:1:1]:step = 1,指示必须向右走(索引递增)。但 start = 4,stop = 1,4 已经在 1 的右侧,向右前进永远无法到达 1,方向再次产生矛盾,同样直接返回空字符串 ""。
s = "Python"
print(repr(s[1:4:-1]))  # 示例输出: ''
print(repr(s[4:1:1])) # 示例输出: ''题目:给定 msg = "Hello",长度仅为 5。执行以下代码会发生什么?
sub1 = msg[2:100]
sub2 = msg[-100:3]
sub3 = msg[10:20]
详细解析:
Python 切片内置了对极端超界索引的自动裁剪(Clamping)机制:
sub1 = msg[2:100]:stop = 100远超过字符串最大合法索引 4。解释器自动将stop钳制在len(msg) = 5处。因此切片等价于msg[2:5],提取索引 2, 3, 4,输出'llo'。sub2 = msg[-100:3]:start = -100远小于负向合法边界 -5。解释器自动将其裁剪为序列最开端 0。因此该切片等价于msg[0:3],提取索引 0, 1, 2,输出'Hel'。sub3 = msg[10:20]:start与stop均已完全超越字符串右边界。经过裁剪后,有效区间长度为 0,安全返回空字符串"",不会发生崩溃。
msg = "Hello"
print(sub1)  # 示例输出: 'llo'
print(sub2)  # 示例输出: 'Hel'
print(repr(sub3))  # 示例输出: ''
五、切片解题思维模型与排查总结
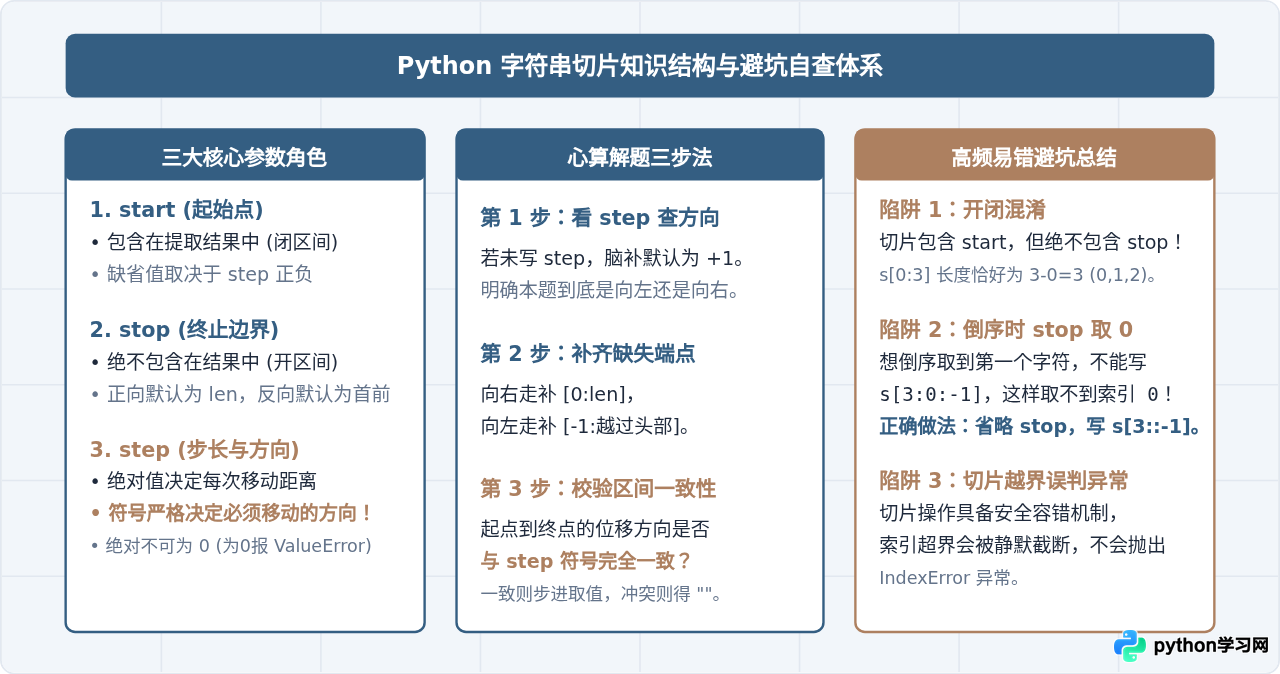
为了在实际编码与考试排错中做到零失误,可以将切片的判断过程浓缩为一张排查体系图:
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









