

Python基础切片语法:列表、字符串与元组的[start:stop:step]用法
深入解析Python中列表、字符串与元组的切片语法[start:stop:step]。通过清晰的栅栏边界模型、步长决策流程、三大序列行为对比及经典模式速查,帮助读者彻底掌握左闭右开、负索引、逆序翻转与切片赋值。
在 Python 中,切片(Slicing)是提取连续或等间隔子序列的核心机制。无论是可变的列表(list),还是不可变的字符串(str)与元组(tuple),均遵循统一的 [start:stop:step] 切片语法。掌握该语法不仅能省去繁琐的循环遍历,还能避免手动索引边界时的越界异常,写出优雅高效的代码。
一、基本切片语法与参数含义
切片的基本语法形式为:sequence[start:stop:step]。方括号中由两个冒号分隔三个参数,各自承担明确的边界定位与步进控制职责:
- start(起始索引):切片开始提取的边界位置。结果中包含该位置上的元素。
- stop(结束索引):切片终止提取的边界位置。结果中不包含该位置上的元素(即遵循左闭右开区间
[start, stop)原则)。 - step(步长):提取元素时的移动方向与间隔步频。默认为
1。为正数时从左向右截取,为负数时从右向左截取。
省略某个参数时,Python 会按固定规则自动填补默认值:未指定 start 时默认为序列开头;未指定 stop 时默认为序列末尾;未指定 step 时默认为 1(此时两个冒号可简写为一个,即 sequence[start:stop])。
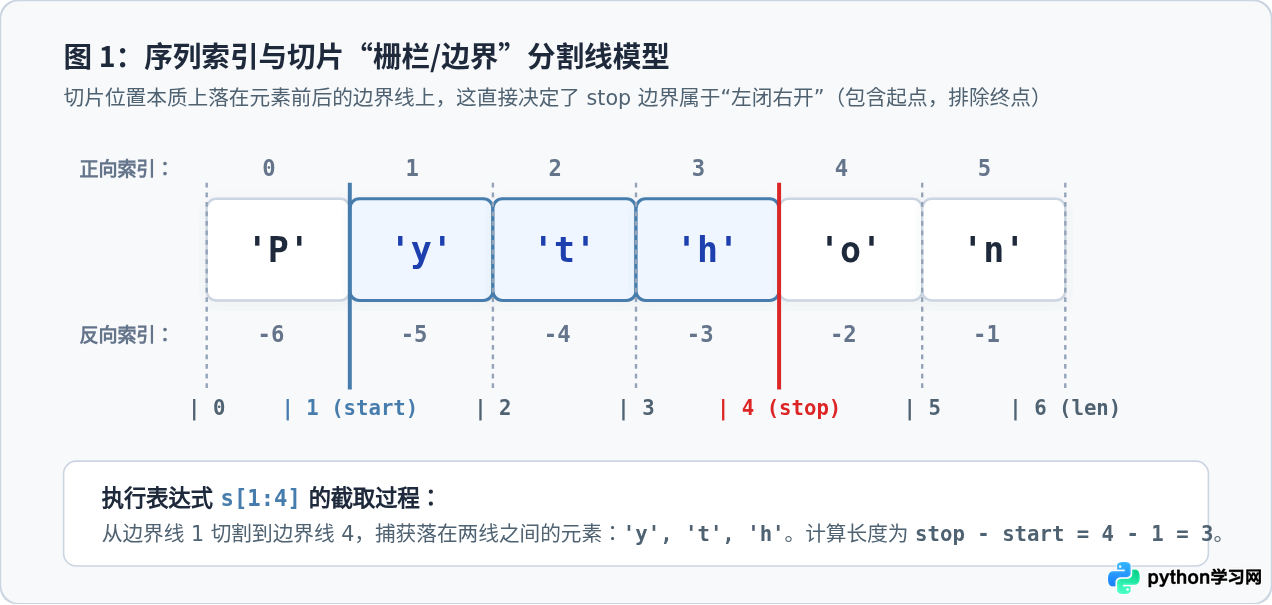
理解左闭右开的“边界切割模型”
很多初学者会疑惑:为什么 s[1:4] 的结束索引是 4,却只提取到索引 3 对应的字符?最直观的理解方式是栅栏/边界模型(如上图 1 所示):索引不仅可以看作元素本身的编号,更可以看作落在元素之间的垂直分割线。
长度为 N 的序列,其元素编号为 0 到 N-1,而边界分割线的编号为 0 到 N。表达式 s[start:stop] 的本质就是在 start 边界和 stop 边界各切一刀,取出夹在这两条分界线中间的所有元素。因此:
- 切片提取的元素个数始终等于
stop - start(在 step=1 时),例如4 - 1 = 3,精准获得 3 个元素; - 两段相邻的切片
s[:k]和s[k:]能够无缝拼合成完整序列s[:k] + s[k:] == s,不会重复提取边界元素,也不会遗漏元素。
-1 表示最后一个元素,-2 表示倒数第二个,以此类推。在切片中,正负索引可以自由混用。例如 s[1:-1] 表示从第 2 个元素开始,一直提取到倒数第 1 个元素之前,常用于剥离外层包裹的引号或括号。
二、步长(step)控制与逆向推导流程
步长参数 step 决定了指针在序列中如何游走。当 step 为非 1 的值时,切片机制展现出强大的数据采样与反转能力。
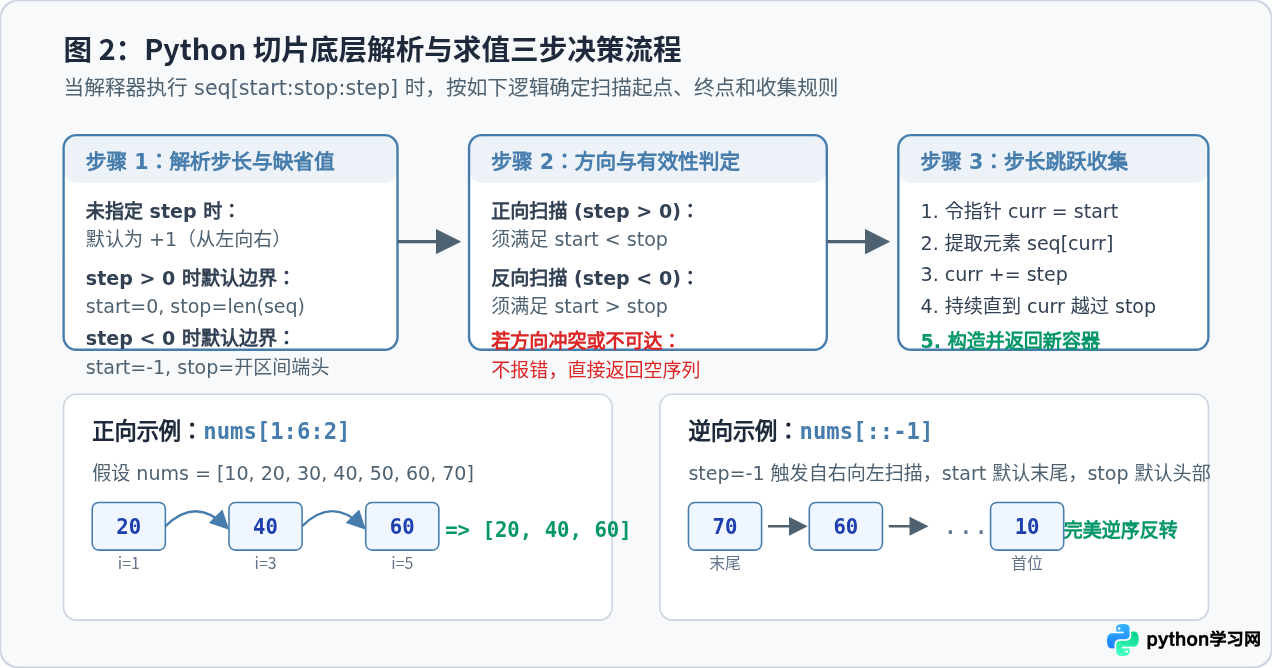
1. 正步长(step > 0):等间隔抽样
当 step 为正整数时,切片从左向右移动。指针从 start 开始,每次累加 step,只要指针小于 stop 就将元素加入结果集。
# 环境:Python 3.x 执行示例
numbers = [0, 1, 2, 3, 4, 5, 6, 7, 8, 9]

# 提取偶数项(从索引 0 开始,步长为 2)
evens = numbers[::2]

# 提取奇数项(从索引 1 开始,步长为 2)
odds = numbers[1::2]

# 提取中间区段隔项采样(索引 2 到 8,步长为 3)
sampled = numbers[2:8:3]odds: [1, 3, 5, 7, 9]
sampled: [2, 5]
2. 负步长(step < 0):逆向反转与倒序提取
当 step 为负整数时,指针的移动方向彻底逆转为自右向左。此时起止默认值也同步发生镜像反转:start 默认为序列最后一个元素(-1),stop 默认为序列开头之前(包含索引 0 处的元素)。
这是 Python 中最经典的倒序技巧 [::-1] 的底层运作逻辑:
# 字符串逆序
text = "Python"
reversed_text = text[::-1]

# 列表逆序
data = [10, 20, 30, 40]
reversed_data = data[::-1]

# 指定区间的反向截取(从索引 4 逆向截取到索引 1 之后,不含 1)
rev_part = numbers[4:1:-1]reversed_data: [40, 30, 20, 10]
rev_part: [4, 3, 2]
start > stop。若写成 numbers[1:4:-1],由于指针在索引 1 处且步长为负,往左移动永远无法到达右侧的索引 4,Python 会直接判定区间不可达并返回空对象 [],而不会报错。
三、列表、字符串与元组的切片行为对比
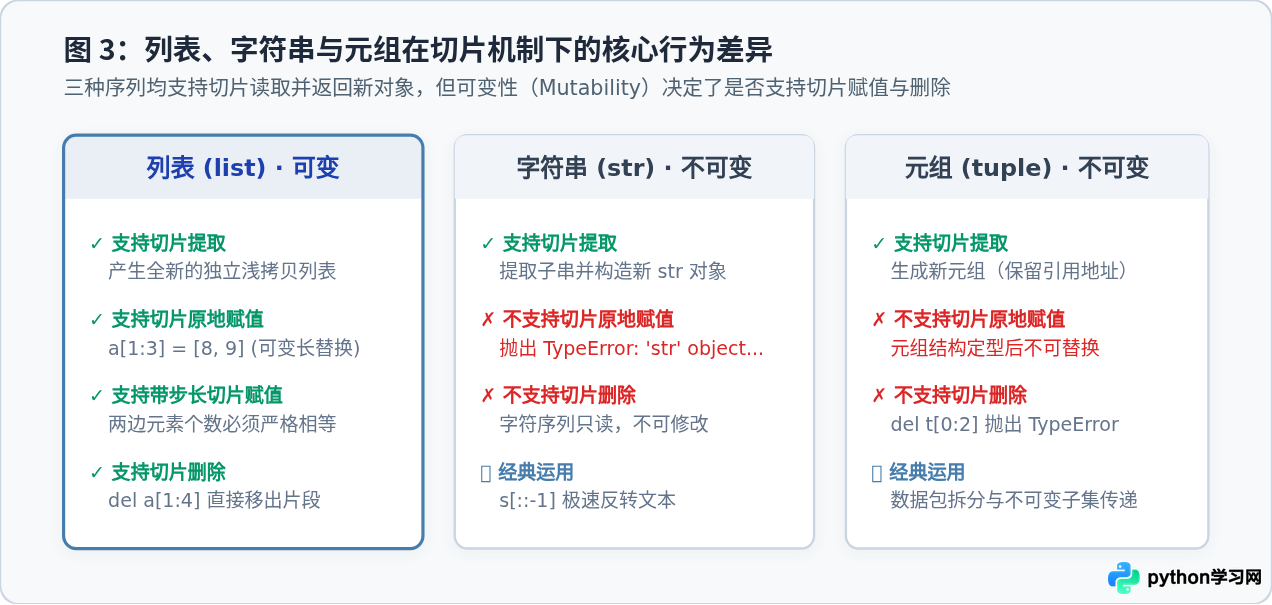
列表(list)、字符串(str)与元组(tuple)都是 Python 的内置序列类型,三者均完整支持上述切片提取语法。然而,对象可变性(Mutability)的差异导致它们在切片赋值和原位修改上有着根本区别。
| 序列类型 | 可变性 | 切片读取行为 | 切片赋值 a[i:j] = ... | 切片删除 del a[i:j] |
|---|---|---|---|---|
| 列表 (list) | 可变 (Mutable) | 返回新列表(浅拷贝) | 支持(原位替换,可变长) | 支持(原位删除元素) |
| 字符串 (str) | 不可变 (Immutable) | 返回新字符串(子串副本) | 不支持(抛出 TypeError) | 不支持(抛出 TypeError) |
| 元组 (tuple) | 不可变 (Immutable) | 返回新元组(浅拷贝引用) | 不支持(抛出 TypeError) | 不支持(抛出 TypeError) |
1. 不可变序列(字符串与元组):只读浅拷贝
字符串与元组一旦创建,其内部内容即被冻结。切片操作只是从原数据中读取子集并构建全新的独立对象,原对象不受任何影响。
# 字符串与元组的切片提取
s = "Hello World"
sub_s = s[0:5]       # 'Hello'

t = (1, 2, 3, 4, 5)
sub_t = t[1:4]       # (2, 3, 4)

# 尝试对不可变序列进行切片赋值会触发异常
# s[0:2] = "Hi"      # 抛出 TypeError: 'str' object does not support item assignment
# t[0:2] = (8, 9)    # 抛出 TypeError: 'tuple' object does not support item assignment
2. 可变序列(列表):切片提取、原地替换与删除
列表不仅可以通过切片读取生成新列表,还可以利用切片作为左值进行原地修改:
- 普通切片赋值(未指定 step):可以实现非等长替换。用右侧可迭代对象中的元素直接替代切片选中的区间,列表长度会自动伸缩。
- 扩展步长切片赋值(指定了非 1 的 step):右侧元素数量必须与切片选出的槽位数严格相等,否则会抛出
ValueError。 - 切片删除(del 语句):直接从列表中批量移除指定范围的元素。
fruits = ["apple", "banana", "cherry", "date", "fig"]

# 1. 普通切片替换:将索引 1 到 3 的两个元素替换为三个新元素(列表变长)
fruits[1:3] = ["blueberry", "citrus", "dragonfruit"]
print("替换后:", fruits)

# 2. 切片删除:直接移除末尾部分
del fruits[3:]
print("删除后:", fruits)

# 3. 带步长的切片赋值(数量必须严格匹配)
nums = [10, 20, 30, 40]
nums[::2] = [99, 88]   # 索引 0 和 2 分别被替换为 99 和 88
print("步长替换后:", nums)删除后: ['apple', 'blueberry', 'citrus']
步长替换后: [99, 20, 88, 40]
四、常见切片场景与边界避坑指南
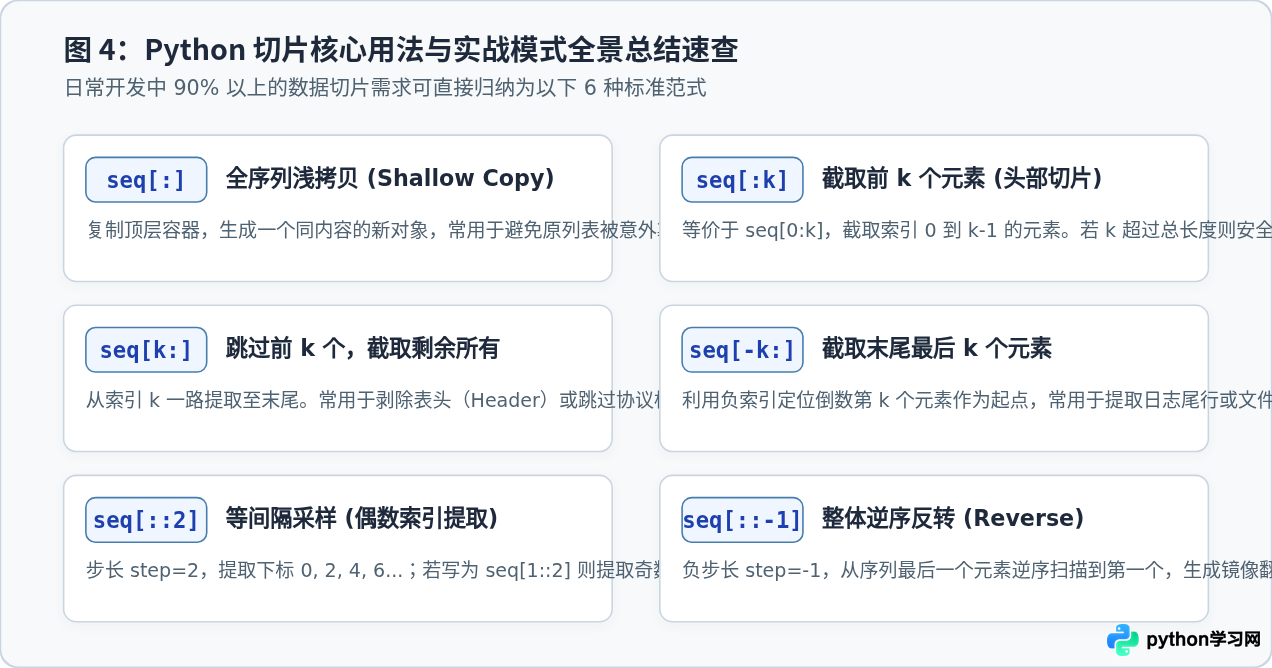
在日常数据处理与算法实现中,切片有若干极为实用的标准写法。了解切片的边界宽容性与浅拷贝特性,可以帮助我们避免常见的逻辑陷阱。
1. 切片的容错性:越界不报错
在 Python 中,通过单下标访问元素时(如 sequence[100]),若索引超出范围会立即抛出 IndexError。但在切片操作中,Python 表现出极大的宽容性:超出序列实际长度的索引会被自动截断到合法边界,绝不会抛出越界异常。
chars = ['a', 'b', 'c']

# 单下标越界:报错
# chars[10] -> IndexError: list index out of range

# 切片越界:自动截断到边界,安全返回
safe_slice1 = chars[1:100]    # 返回 ['b', 'c']
safe_slice2 = chars[50:100]   # 起点已越界,返回 []
2. 完整浅拷贝 seq[:] 的应用与局限
当需要复制一个列表以便修改而不影响原数据时,常用 new_list = old_list[:]。这种方式创建了一个新的外层列表容器(地址改变)。
但需要特别注意,这属于浅拷贝(Shallow Copy):若列表内部嵌套了字典、其他列表等可变对象,切片复制出来的依然是内部对象的引用。此时若修改了嵌套对象,原列表依然会被联动改变。如需彻底独立,需使用 copy.deepcopy()。
五、总结
Python 切片语法 [start:stop:step] 统一规范了列表、字符串与元组的子序列截取逻辑。其核心要点可提炼为:
- 左闭右开:包含
start,排除stop,步长为 1 时截取长度精准等于stop - start。 - 步长定方向:
step > 0从左向右,step < 0从右向左(起止默认值自动反转)。 - 类型决定能力:列表可变,支持通过切片进行原位替换与批量删除;字符串与元组不可变,切片始终返回只读新副本。
- 安全越界:切片自动夹紧边界,不会因索引超出长度而报错,是构建防御性代码的有力工具。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









