

Python切片步长为负数怎么取值?列表反转技巧解析

在 Python 中,切片的基本语法是 sequence[start:stop:step]。当步长 step 为负数时,切片的抓取方向发生反转——从原本的“从左往右”变为“从右往左”。这一变化同时触发了缺省边界的自动倒置:默认起始位置 start 变为序列末尾,默认终止位置 stop 变为序列开头之前。因此,lst[::-1] 能够直接提取整个列表的倒序副本。本文将深入解析负步长切片的取值判定链路,剖析为什么部分切片会返回空列表,并系统对比三种列表反转技巧的实现机制与选型依据。
一、负步长切片的核心运行机制
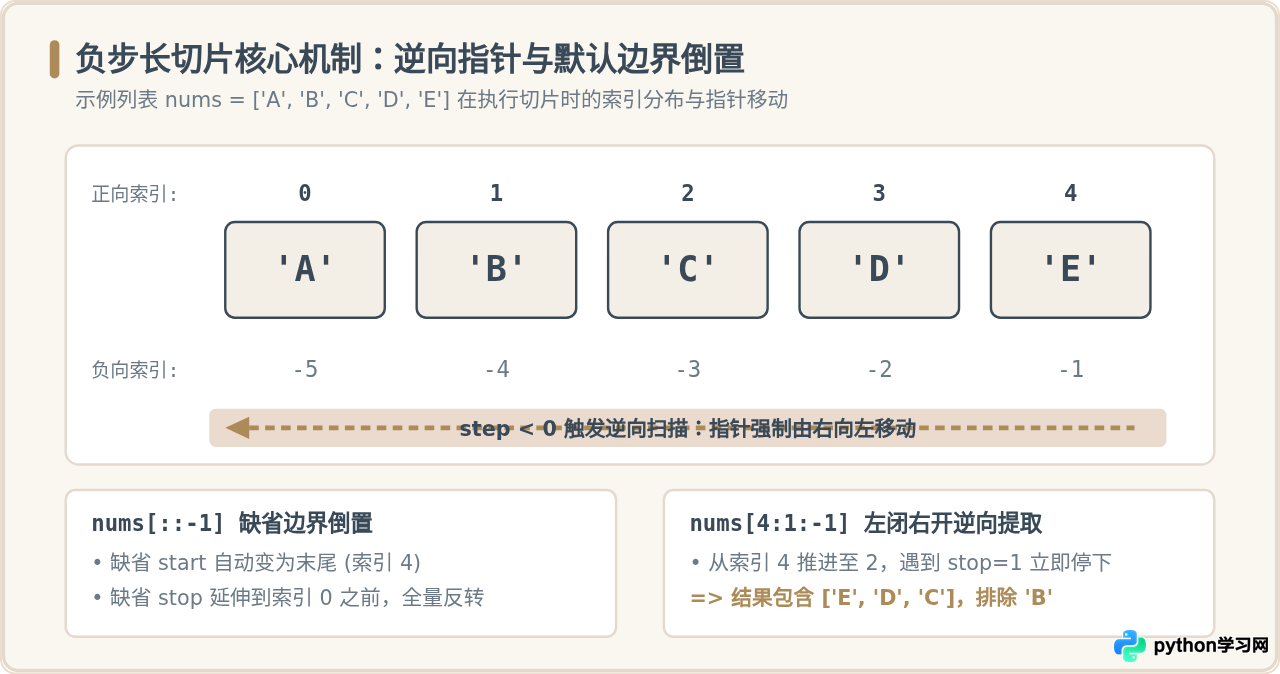
理解切片取值的核心在于抓住三个关键要素:移动方向、提取区间以及缺省边界值。常规正步长切片中,指针沿着索引递增方向推进;一旦 step < 0,整个判定体系会做出如下调整:
- 方向由步长符号唯一决定:只要
step < 0,指针就必须由大索引向小索引方向移动。无论start和stop使用正数索引还是负数索引,都不会改变从右向左的扫描方向。 - 左闭右开区间的逆向解释:切片始终遵循“包含起始位置,不包含结束位置”的原则。在负步长下,提取范围是
[start, stop),但由于是逆向推进,实际抓取的元素索引序列为:start、start + step、start + 2*step……直到抵达或越过stop为止(不含stop本身)。 - 缺省值的逆向倒置:若省略
start,默认取最后一个元素的有效索引(即len(seq) - 1或-1);若省略stop,默认延伸至序列的最左端之前,确保索引0处的元素能够被完整收录。
二、负步长切片的四步推导法与代码实测
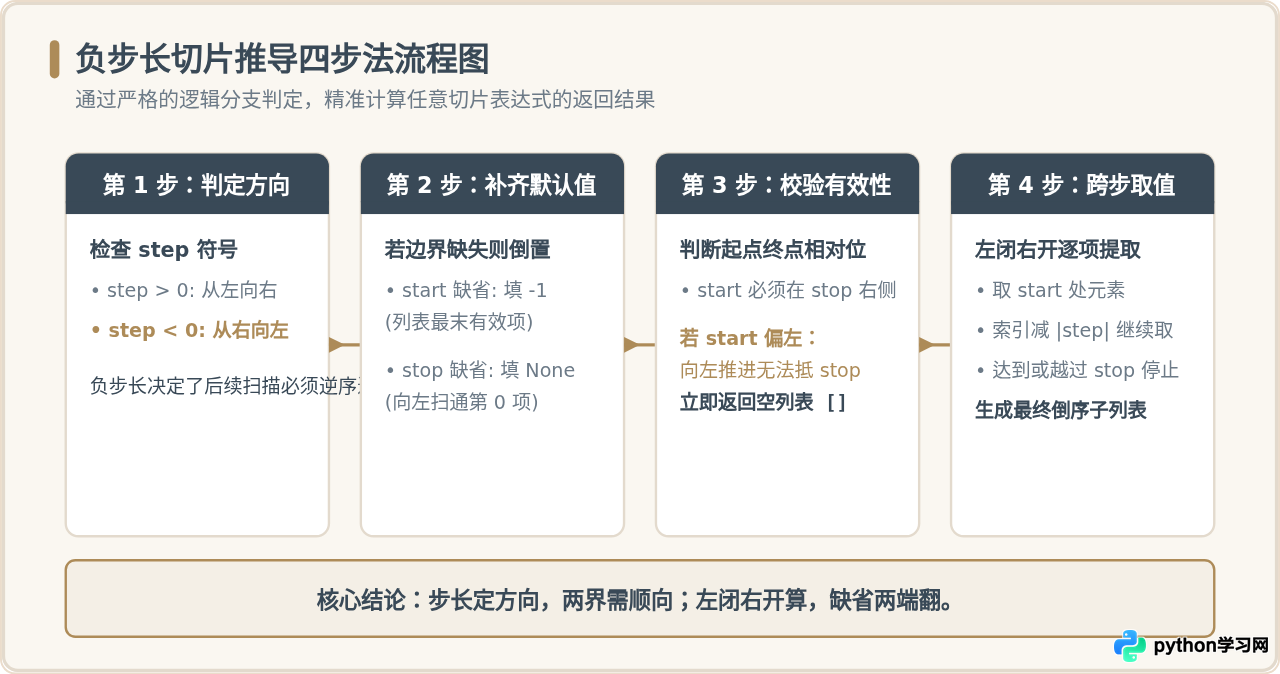
在阅读或编写含有负步长的复杂切片时,不需要死记硬背各种边界组合,遵循标准化的四步逻辑即可快速得出确定结果:
- 第一步:检查 step 的正负性,锁定扫描方向。若
step > 0向右走;若step < 0向左走。 - 第二步:补齐未指定的 start 和 stop。若
step < 0且start缺省,填入-1(序列最后一个元素);若stop缺省,填入“向左延伸到底”(包括索引 0)。 - 第三步:校验起点与终点的相对位置。向左移动时,
start在物理序列中的位置必须严格位于stop的右侧。如果start已经在stop的左侧,向左走将永远无法抵达stop,Python 会直接返回空列表[]。 - 第四步:按步长跨步收集元素,严格遵循左闭右开。包含
start,在每一步减去|step|,直到遇到或超越stop终止。
下面结合一段完整的 Python 交互代码,验证不同切片形式的实际输出:
# 准备基础列表数据
nums = ['A', 'B', 'C', 'D', 'E']

# 案例 1:完整反转(缺省边界)
print(nums[::-1])
# 示例输出:
# ['E', 'D', 'C', 'B', 'A']

# 案例 2:显式正向索引指定区间
# start=4 ('E'), stop=1 ('B')。由于左闭右开,'B' 不包含在内
print(nums[4:1:-1])
# 示例输出:
# ['E', 'D', 'C']

# 案例 3:负数索引与负步长组合
# start=-1 ('E'), stop=-4 ('B')
print(nums[-1:-4:-1])
# 示例输出:
# ['E', 'D', 'C']

# 案例 4:步长大于 1 的负步长跨跳
print(nums[::-2])
# 示例输出:
# ['E', 'C', 'A']
三、负数索引 vs 负数步长:常见误区解析
初学者在学习切片时,极容易混淆负数索引与负数步长的概念。尽管二者都带有负号,但它们在切片底层扮演着截然不同的角色:
- 负数索引是“静态坐标”:它只是表示元素在序列中位置的另一种表达方式,用于从序列右端往前计数(例如
-1对应最后一个元素,-2对应倒数第二个元素)。它本身并不蕴含任何“遍历运动”的意图。 - 负数步长是“动态向量”:它规定了切片提取时指针的位移方向与步幅大小。负号明确指令指针“从右向左走”。
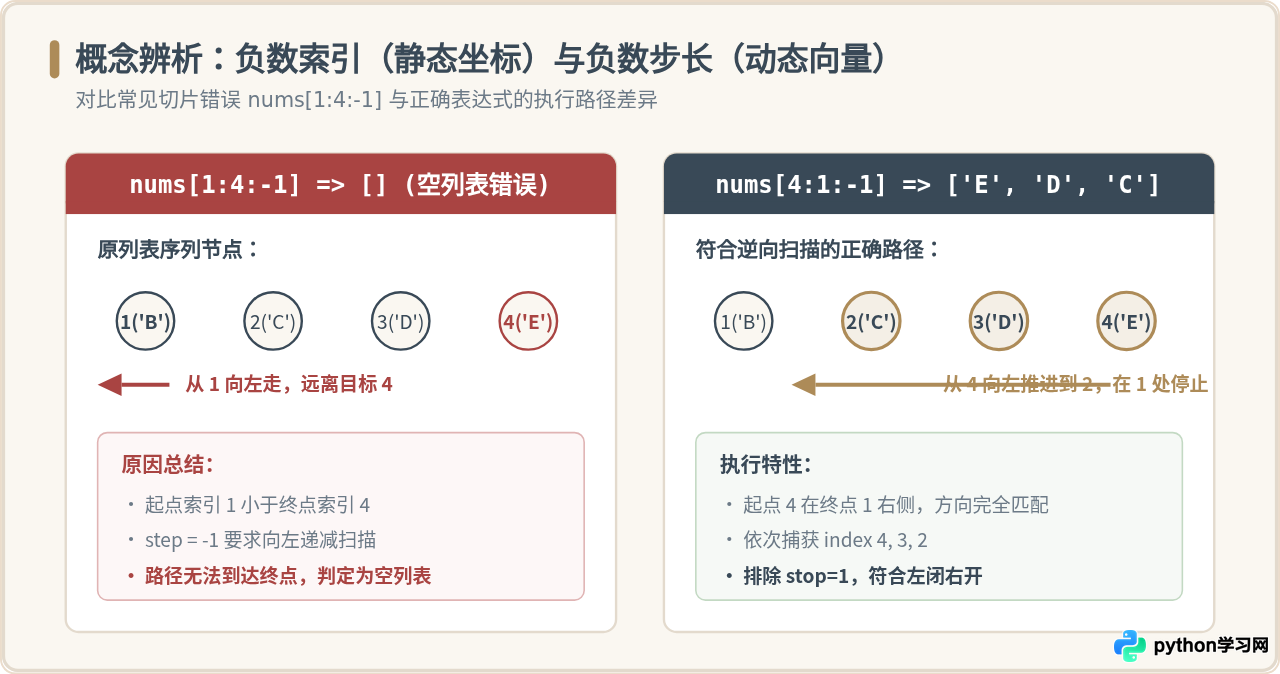
很多开发者直觉上认为 [1:4] 是截取子区间,再加上 -1 就能把该区间倒过来。但切片机制并非“先截取再反转”,而是“边移动边抓取”。在 nums[1:4:-1] 中,start=1 位于 stop=4 的左侧,而 step=-1 要求指针往左移动。指针从位置 1 往左走只会到达 0、-1,永远无法抵达目标边界 4,因此判定区间不可达,直接返回空列表 []。正确的写法必须让起点在右、终点在左,即 nums[4:1:-1] 或先正向切片再反转 nums[1:4][::-1]。
四、Python 列表反转的三大核心技巧对比与选型
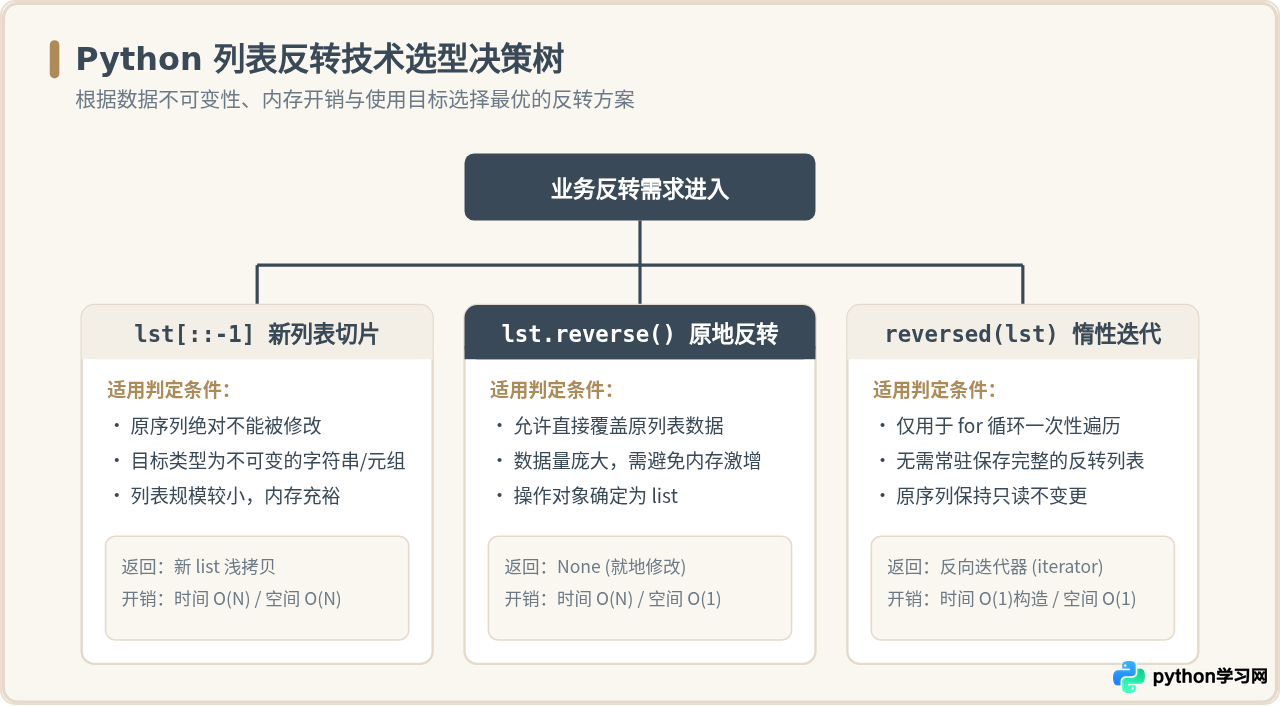
在日常开发中,将列表进行倒序排列是一个高频需求。Python 提供了三种截然不同的工具:切片 [::-1]、列表自带的 reverse() 方法以及内置函数 reversed()。它们各自有着独特的内存开销与运行特征:
1. 切片反转:lst[::-1]
切片反转属于浅拷贝构造。它会在内存中分配一块全新的连续存储空间,然后按照倒序依次将原列表中的对象引用填充进去,原列表完全不受影响。这种写法的优势在于语法极其紧凑,且不仅适用于列表,还普遍适用于字符串(str)和元组(tuple)等不可变序列。
2. 原地反转:lst.reverse()
reverse() 是 Python 列表对象(list)特有的方法。它通过双指针首尾交换算法直接就地修改原列表底层的元素指针数组,其空间复杂度为 $O(1)$,不产生额外的列表内存分配。需要特别注意的是,该方法直接修改自身,其返回值为 None,因此不能用于链式赋值操作(例如 new_list = old_list.reverse() 会得到 None)。
3. 迭代器反转:reversed(lst)
内置函数 reversed() 接收一个可逆序列,返回一个反向迭代器对象(reverseiterator)。它不会立即反转全部元素,也不分配新列表,而是在每一次通过 for 循环或调用 next() 时,惰性地从后往前产出元素。这在大数据量遍历处理时能极大降低瞬时内存峰值。
| 对比维度 | 切片反转 lst[::-1] |
原地方法 lst.reverse() |
反向迭代 reversed(lst) |
|---|---|---|---|
| 修改原列表 | 否(原列表保持不变) | 是(就地修改原列表) | 否(原列表保持不变) |
| 返回值 | 全新的倒序列表对象 | None(易错点) |
反向迭代器(list_reverseiterator) |
| 额外空间复杂度 | $O(N)$(需分配新列表内存) | $O(1)$(零额外内存) | $O(1)$(仅迭代器指针开销) |
| 类型通用性 | 高(列表、字符串、元组) | 低(仅限于 list) |
中(实现了 __reversed__ 或 __len__+__getitem__) |
| 典型适用场景 | 需要保留原序列不变、字符串反转 | 大型列表原地排序、严格控制内存 | for 循环逆序遍历、流式逐项处理 |
五、总结与工程实践建议
掌握 Python 负步长切片与列表反转的核心心智模型,可以总结为以下两项原则:
- 负步长切片牢记“向左扫描”:
step < 0强制定义了由右向左的扫描路径。只有当start位于stop右侧时,切片才能捕获有效子序列;若需全量反转,直接依赖缺省边界[::-1]最为安全。 - 反转选型按场景定夺:临时生成新列表或处理字符串用
[::-1];对大型列表节省内存并允许修改自身用lst.reverse();单纯遍历而不驻留数据用reversed(lst)。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









