

Python处理百万行Excel汇总数据的内存优化
针对Python处理接近百万行大体量Excel文件时容易出现的内存溢出问题,详解openpyxl只读模式、分块迭代、类型压缩与底层引擎切换等实用内存优化方案。
在数据处理任务中,Excel(.xlsx)格式的单表容量上限为 1,048,576 行。当使用 Python 尝试一次性读取接近上限的百万行 Excel 数据并进行汇总统计时,常规的 pandas.read_excel() 往往会瞬间消耗数 GB 甚至十几 GB 内存,极易导致系统内存耗尽(OOM)。本文将解析 Excel 解包膨胀的根本成因,并提供只读流式迭代、底层解析器替换与分块聚合等经过验证的低内存实践方案。
一、为什么百万行 Excel 会耗尽内存
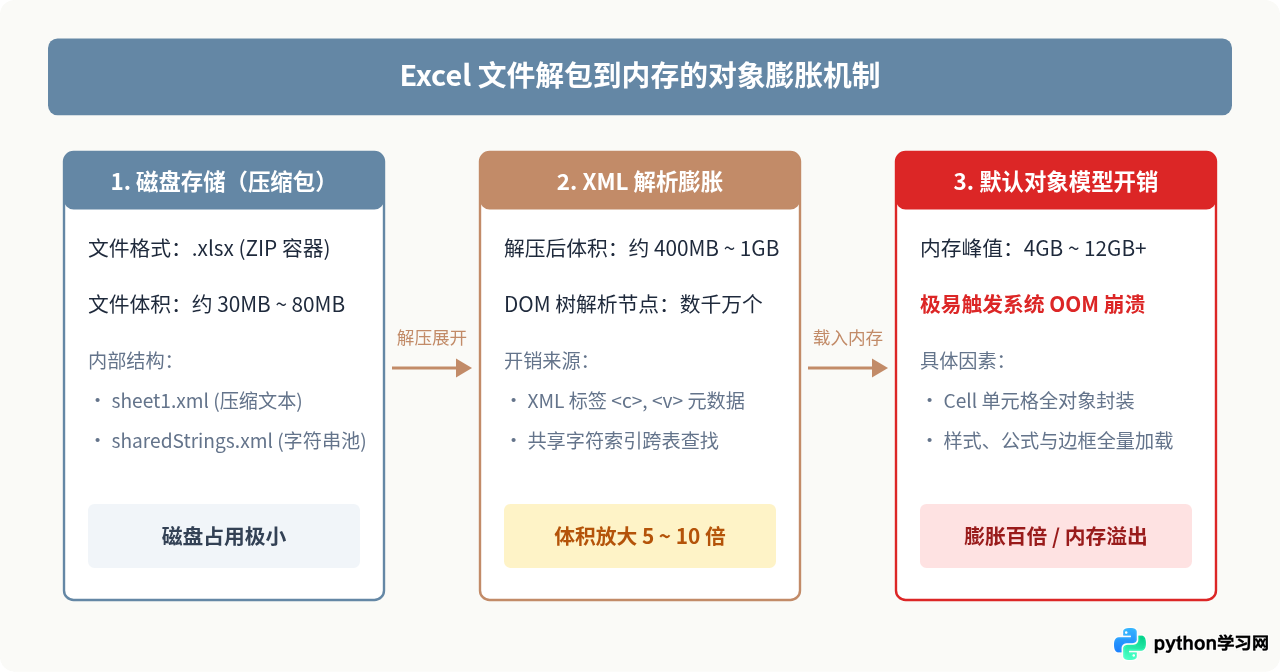
一个包含 100 万行、10 列数值与短文本的 .xlsx 文件,在磁盘上的体积通常仅有 40MB 至 80MB。这是因为 .xlsx 本质上是由 ZIP 压缩算法打包的 XML 文本集合。然而,当 Python 库将其解压并构建为内存对象时,体积会成几何级数放大:
- XML 标记与共享字符串表:解压后的
sheet1.xml往往达到数百兆字节。每一个单元格都有独立的 XML 标签包裹,文本数据还需要去sharedStrings.xml中查询索引并反序列化。 - 标准模式下的单元格对象(Cell Object):默认情况下,像
openpyxl这样的库会为每个单元格构建一个完整的 Python 对象,包含字体、填充颜色、边框、数据类型及公式属性。每个 Python 对象自身附带头信息开销,1000 万个单元格对象仅对象头就需要数吉字节内存。 - Pandas 的全量中间转换:
pandas.read_excel()默认底层调用openpyxl构建完整工作簿对象后,再转换为 Python 列表并转入 NumPy 数组。这一过程中存在多个全量数据副本共存的内存峰值区间。
二、核心优化方案:只读流式迭代处理
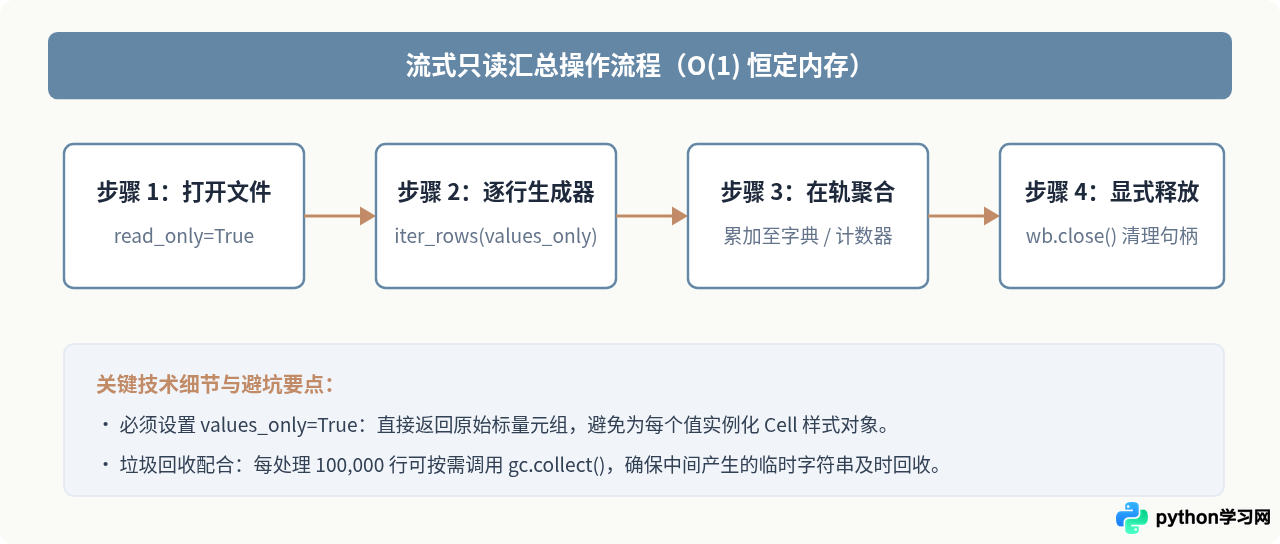
如果业务目标是对数据进行汇总统计(例如按部门求和、统计总金额、计算平均单价等),完全无需把全量数据一次性留在内存中。最佳实践是利用生成器“读一行、累加一行、丢弃一行”,使得内存占用始终维持在数十兆的恒定水平。
openpyxl 流式汇总实现示例
在 openpyxl 中开启 read_only=True 会将底层 XML 解析器切换为基于事件的流式读取器(SAX 模式),内存占用不会随行数增长:
import openpyxl
from collections import defaultdict

def stream_summarize_excel(file_path):
    # 以只读模式加载工作簿,不加载样式与完整文档树
    wb = openpyxl.load_workbook(filename=file_path, read_only=True, data_only=True)
    sheet = wb.active

    # 用于汇总的存储结构(仅存储聚合结果,内存开销极小)
    summary = defaultdict(lambda: {"total_amount": 0.0, "count": 0})

    # iter_rows 逐行读取,values_only=True 直接产出纯 Python 标量元组
    rows = sheet.iter_rows(values_only=True)
    header = next(rows)  # 提取表头

    # 假设表头包含:dept, amount
    dept_idx = header.index("dept")
    amount_idx = header.index("amount")

    for row_num, row in enumerate(rows, start=1):
        dept = row[dept_idx]
        amount = row[amount_idx]

        if amount is not None:
            summary[dept]["total_amount"] += float(amount)
            summary[dept]["count"] += 1

    wb.close()
    return summary

# 示例调用
# res = stream_summarize_excel("million_rows_data.xlsx")
# print(f"汇总部门数: {len(res)}")read_only=True 模式下,切勿使用 sheet.max_row 属性。部分 Excel 文件在未显式扫描末尾前无法预知行数,调用该属性可能迫使库预先完整扫描文件,破坏流式处理的低开销特性。
三、进阶:利用 Calamine / Rust 引擎大幅提升吞吐
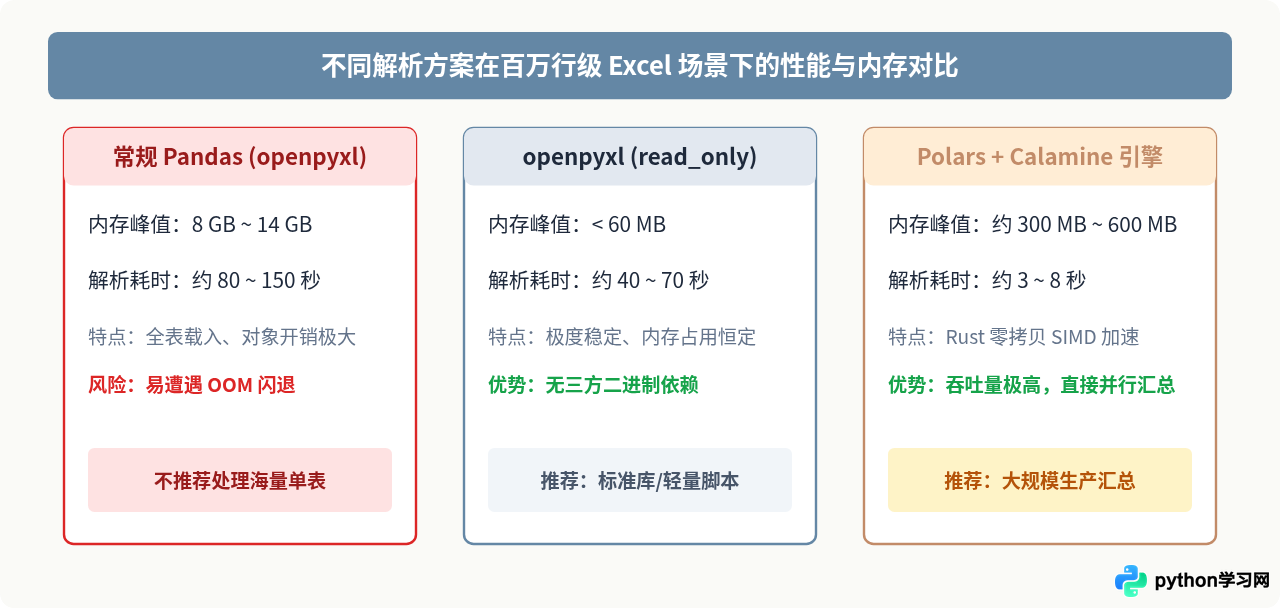
虽然 openpyxl 的只读模式成功压制了内存,但由于纯 Python 解析大量 XML 标签存在解释器瓶颈,遍历 100 万行可能耗时 30 至 90 秒。针对性能敏感场景,推荐采用基于 Rust 编写的 Excel 解析器 calamine(可通过 python-calamine 或 polars 快速集成)。
基于 Polars + Calamine 的汇总代码
Polars 原生支持通过 calamine 引擎快速读取 Excel,并在底层直接映射为紧凑的 Apache Arrow 内存结构,结合其多线程 GroupBy,能将百万行统计缩短至数秒:
import polars as pl

def fast_summarize(excel_path):
    # 使用 calamine 作为底层解析引擎,仅载入指定汇总列
    df = pl.read_excel(
        source=excel_path,
        engine="calamine",
        columns=["dept", "amount"]
    )

    # 借助 Arrow 紧凑内存结构进行并行聚合
    summary = df.group_by("dept").agg([
        pl.col("amount").sum().alias("total_amount"),
        pl.col("amount").count().alias("row_count")
    ])

    return summary

# 示例调用
# result_df = fast_summarize("million_rows_data.xlsx")
# print(result_df)
四、方案选型与落地决策总结
在面对接近或达到百万行的 Excel 汇总任务时,应根据部署环境的内存上限和运行效率要求选择相适应的方案:
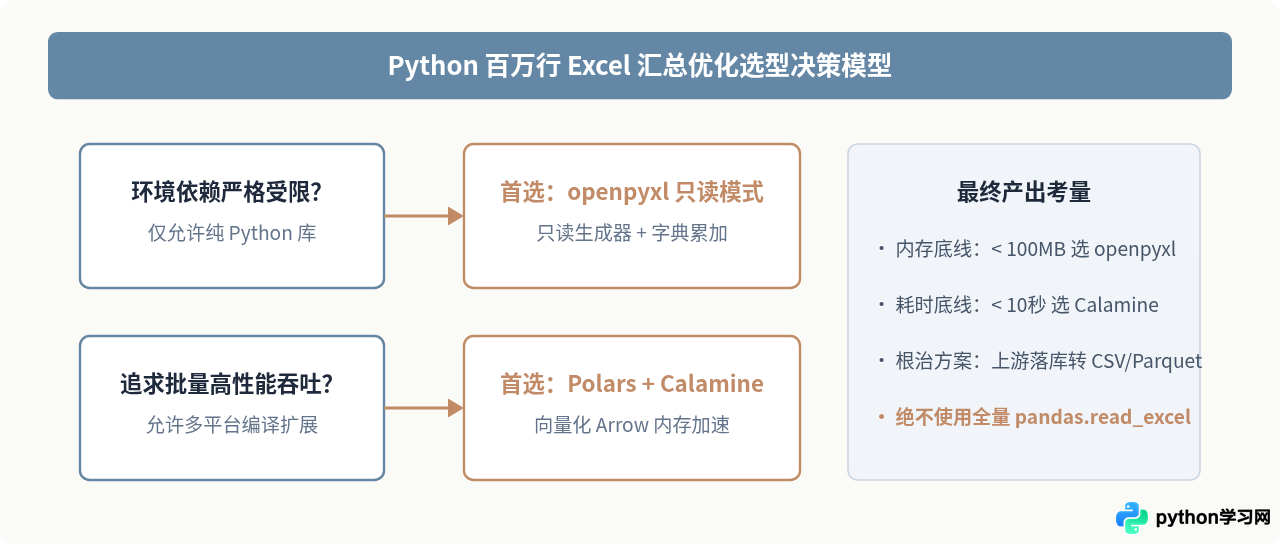
综上所述,百万行 Excel 汇总任务的内存优化核心不在于机器加装物理内存,而在于打破“把整个工作簿加载进内存”的思维惯性。利用只读流式模式或更高效的二进制解析器,完全可以在百兆级别的平稳内存中高效达成汇总目的。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









