

Python中数组怎么用?列表(list)基础操作与常见误区澄清
一、概念澄清:Python中到底有没有“数组”?
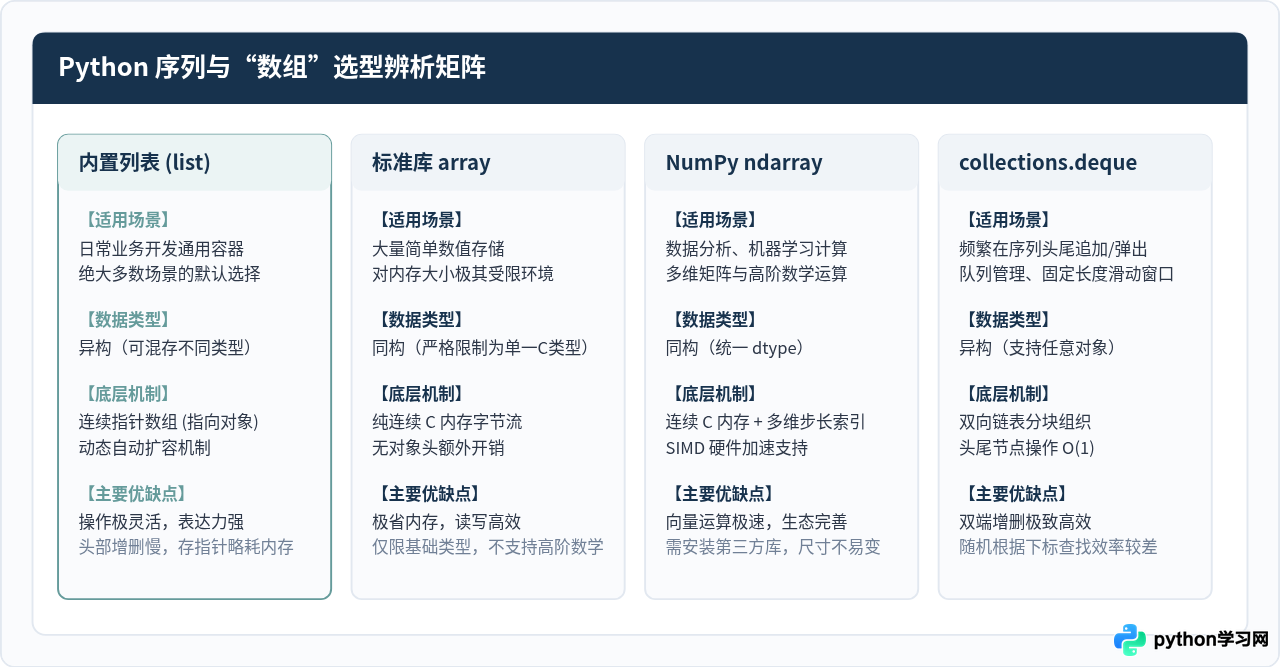
从 C、Java 等静态类型语言转向 Python 的开发者,往往会直觉性地寻找 array 关键字。实际上在 Python 的生态体系中,序列容器根据使用场景被清晰地划分为了不同层次:
- 内置列表(list):这是日常 Python 编程中使用频次最高的序列容器。它的底层由动态指针数组实现,支持元素异构(同一个列表中可存放不同类型的对象),且具有自动扩容机制。日常口语交流中所说的“Python 数组”,绝大多数情况下指的正是列表。
- 标准库
array模块:Python 标准库其实内置了array.array。它要求内部所有元素必须是同一种基础 C 数据类型(如整型、浮点型),内存布局紧凑高效,但缺乏灵活的高阶操作,仅在对内存占用极为敏感的特定场景下使用。 - NumPy 科学计算数组(ndarray):在数据分析、机器学习和科学计算领域,第三方库 NumPy 提供的
ndarray才是主力。它在连续 C 内存块中存放同构数值,支持极速的矩阵向量化运算。 - 双向队列(collections.deque):标准库提供的双端队列容器,专门优化了序列头部与尾部的双向高效插入与弹出操作。
二、列表(list)的基础操作全景
对于大部分常规业务开发,直接使用列表即可完成所有“数组”类工作。掌握其规范操作是编写可靠代码的前提。
1. 列表的创建与初始化
在 Python 中创建列表非常直接,推荐优先使用方括号字面量:
# 1. 常见字面量创建方式
empty_list = []                         # 空列表
numbers = [1, 2, 3, 4, 5]               # 包含整型的列表
mixed_list = [10, "Python", True, 3.14] # 容纳多种不同类型

# 2. 通过内置函数 list() 进行类型转换
chars = list("hello")                   # ['h', 'e', 'l', 'l', 'o']
range_list = list(range(1, 6))          # [1, 2, 3, 4, 5]

# 3. 列表推导式(推荐的高效初始化方式)
squares = [x * x for x in range(5)]     # [0, 1, 4, 9, 16]
2. 索引访问与切片机制
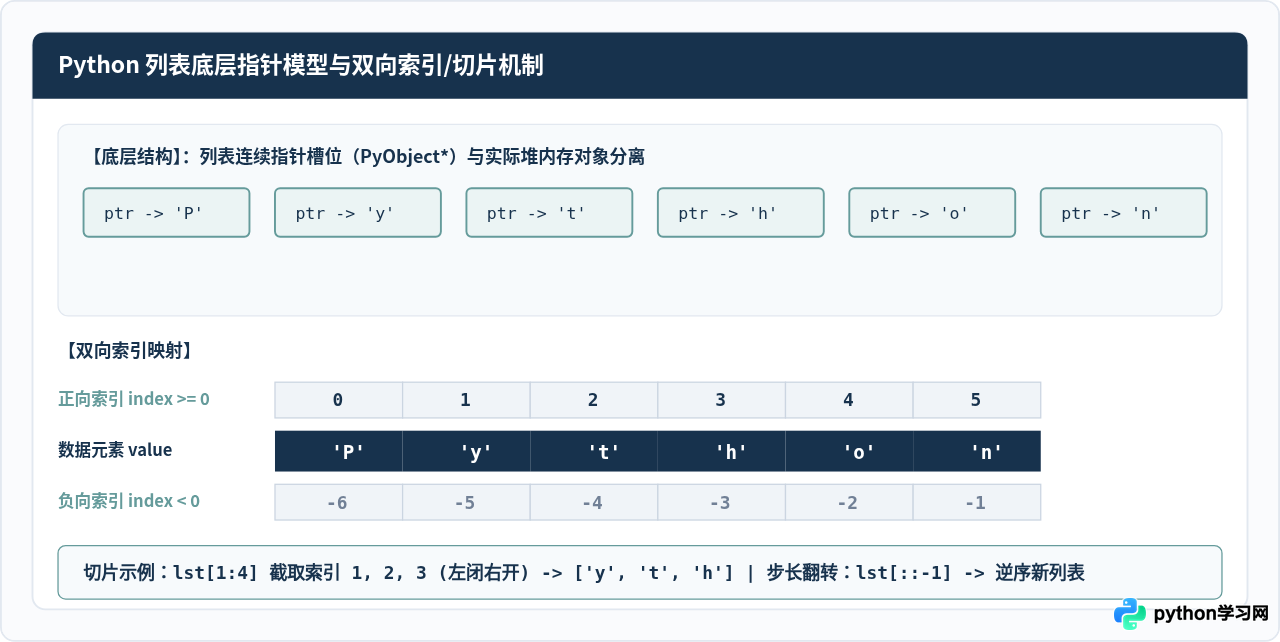
Python 列表支持非常灵活的双向索引和切片语法:
- 正向索引:从
0开始递增,表示从前往后定位。 - 负向索引:从
-1开始递减,-1即为最后一个元素,-2为倒数第二个。 - 切片格式:
list[start:stop:step]。切片遵从左闭右开原则,包含起始位置start,但不包含结束位置stop。
letters = ['P', 'y', 't', 'h', 'o', 'n']

# 基础索引读取与越界注意
print(letters[0])    # 输出: 'P'
print(letters[-1])   # 输出: 'n' (倒数第一)

# 切片操作(左闭右开)
print(letters[1:4])  # 输出: ['y', 't', 'h'] (截取索引 1, 2, 3)
print(letters[:3])   # 输出: ['P', 'y', 't'] (省略start,默认从0开始)
print(letters[3:])   # 输出: ['h', 'o', 'n'] (省略stop,一直截取到末尾)

# 步长 (step) 控制
print(letters[::2])  # 输出: ['P', 't', 'o'] (每隔2步取一个)
print(letters[::-1]) # 输出: ['n', 'o', 'h', 't', 'y', 'P'] (步长为-1,实现逆序)
3. 增添元素的3种关键方法
| 方法 | 调用示例 | 功能说明 | 时间复杂度 |
|---|---|---|---|
append(x) |
lst.append(10) |
将传入对象 x 作为一个完整元素,追加到列表末尾 |
均摊 O(1) |
extend(iterable) |
lst.extend([20, 30]) |
遍历可迭代对象,将其中的所有元素逐一解包并追加到末尾 | O(k),k为参数长度 |
insert(idx, x) |
lst.insert(0, 99) |
在指定索引 idx 处插入元素,其后原有元素全部后移 |
O(n) |
4. 删除元素的4种途径
pop([index]):移除并返回指定索引处的元素。如果不传参数,默认移除末尾元素(时间复杂度为 O(1));如果传0移除首位元素,需要平移后续所有元素,复杂度为 O(n)。remove(value):从左至右扫描列表,删除第一个与value相等的元素。如果列表中不存在该元素,将抛出ValueError。del lst[index]或del lst[start:stop]:Python 语言内置的语句,直接按索引或切片范围从内存中删除指定元素。clear():清空列表中的全部元素,使列表长度变为 0。
data = [10, 20, 30, 20, 40]

# 1. pop: 取出并删除末尾
last_val = data.pop()      # last_val = 40,data变为 [10, 20, 30, 20]

# 2. remove: 按值删除第一个匹配项
data.remove(20)            # 删除第一个20,data变为 [10, 30, 20]

# 3. del 语句删除特定下标
del data[0]                # 删掉下标0的10,data变为 [30, 20]

# 4. clear: 完全清空
data.clear()               # data变为 []
5. 排序与翻转辨析
在操作列表顺序时,务必分清就地修改(In-place)与返回新对象的区别:
lst.sort():列表的原生方法,直接在当前列表内部完成升序排序,无返回值(返回None)。sorted(lst):内置通用函数,不会改变原列表lst,而是构建并返回一个排序好的全新列表。lst.reverse():就地翻转原列表中的元素顺序;而reversed(lst)返回的是一个逆序迭代器。
三、核心误区澄清:5大高频踩坑场景深度剖析
在实际工程代码中,由于未理解底层原理,初学者极易写出看似正确但逻辑完全跑偏的代码。以下5大误区尤为普遍。
误区一:浅拷贝与引用传递陷阱(“改了一个,怎么全变了?”)
在 Python 中,变量名实际上是指向对象内存地址的“引用/标签”。单纯的等号赋值并不会创建新的列表对象:
a = [1, 2, 3]
b = a          # b 与 a 指向完全相同的同一个堆内存列表
b.append(99)
print(a)       # 输出: [1, 2, 3, 99]!a 同样被修改了!
若希望得到一个彼此独立的列表,必须进行拷贝:
- 浅拷贝(Shallow Copy):使用
b = a.copy()或b = a[:]。浅拷贝会创建一个新列表容器,但如果列表中嵌套了子列表,子列表内部的指针仍是指向同一个对象的。 - 深拷贝(Deep Copy):当列表中包含多层嵌套对象时,必须引入标准库模块
import copy; b = copy.deepcopy(a),彻底递归复制所有层级的独立对象。
matrix = [[0] * 3] * 3。这种写法创建出的 3 行,本质上全部指向同一个 [0, 0, 0] 子列表引用!一旦执行 matrix[0][0] = 1,会导致 3 行的首列全部变成 1。正确矩阵初始化做法:务必使用列表推导式独立创建每一行:
matrix = [[0] * 3 for _ in range(3)]。
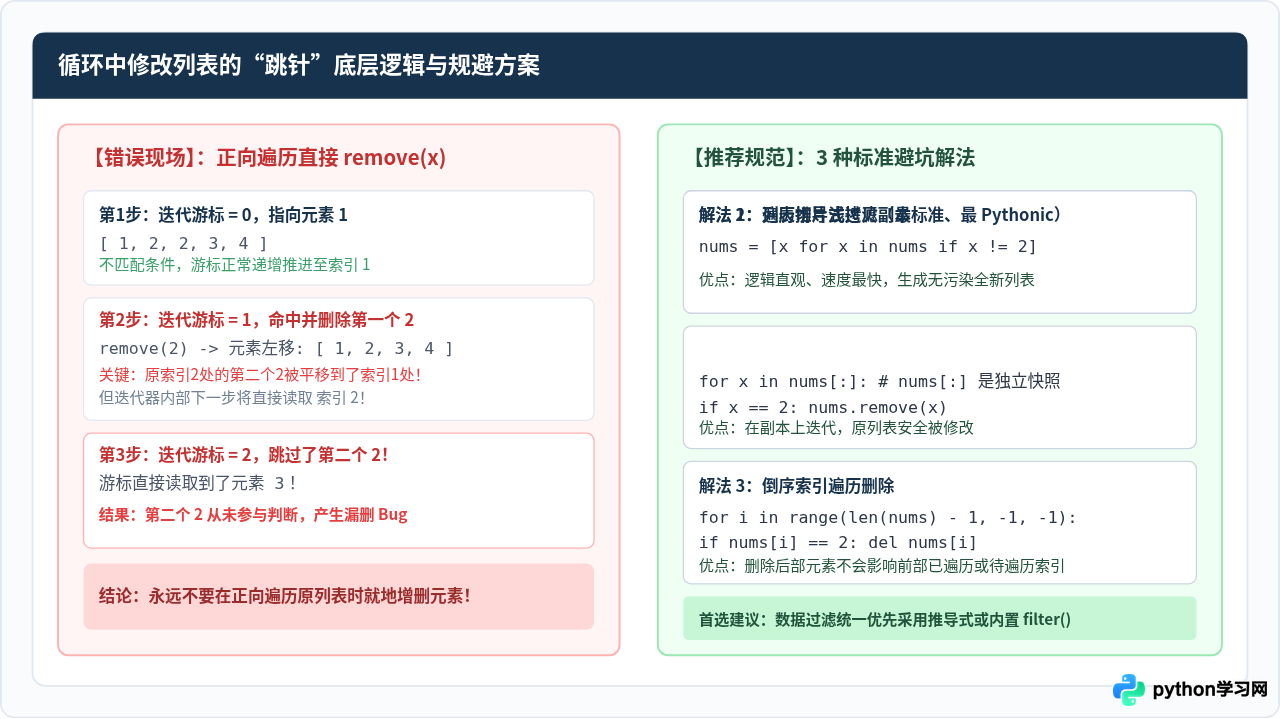
误区二:在 for 循环中边遍历边删除元素(迭代“跳针”现象)
很多开发者会尝试写出类似下面的代码来清洗数据:
# 错误示例:边遍历边删除
nums = [1, 2, 2, 3, 4]
for x in nums:
    if x == 2:
        nums.remove(x)

print(nums)  # 实际输出: [1, 2, 3, 4]!第二个 2 居然没有被删掉!
这是因为 for 循环内部通过一个递增的下标索引来追踪当前位置。当第一个 2 被移除后,列表内部后续所有元素会整体向左移动一位,而此时循环计数器正常加 1,正好跳过了移动到当前槽位的第二个 2!
误区三:将空列表作为函数形参的默认值
在编写函数时,很多人习惯写出如下签名:
# 错误示范:可变对象作为默认参数
def collect_data(item, target_list=[]):
    target_list.append(item)
    return target_list

print(collect_data("A"))  # 输出: ['A']
print(collect_data("B"))  # 惊人输出: ['A', 'B']!而不是预期的 ['B']!
在 Python 中,函数的默认参数只在模块被加载定义时计算一次。此时 target_list=[] 在内存中只创建了一个唯一的列表对象。后续所有不传该参数的函数调用,都会共享同一个列表对象的修改状态。
None,并在函数体内部进行惰性判断创建:
def collect_data(item, target_list=None):
    if target_list is None:
        target_list = []
    target_list.append(item)
    return target_list
误区四:混淆 append() 与 extend() 导致嵌套层级混乱
在合并列表时,误用 append() 是一个极为低级却高频发生的失误:
base_a = [1, 2]
base_a.append([3, 4])
print(base_a)  # 输出: [1, 2, [3, 4]] -> 变成了包含子列表的嵌套结构!

base_b = [1, 2]
base_b.extend([3, 4])
print(base_b)  # 输出: [1, 2, 3, 4] -> 真正将元素平铺合并进去
误区五:将长列表当作双端队列,频繁在头部进行 insert(0, x) 或 pop(0)
Python 的列表在底层是连续物理内存指针块。当在末尾进行 append() 或 pop() 时,由于容量有预分配机制,均摊复杂度是极其高效的 O(1);但一旦在索引 0 处插入或弹出,整个列表后面的 n 个指针就必须全量在内存中向前或向后挪动一位,时间复杂度直线上升至 O(n)。
当处理成千上万条消息队列、任务缓冲池时,这种写法会导致性能严重暴跌。如果需要频繁在序列两头进出元素,请立刻改用 from collections import deque。
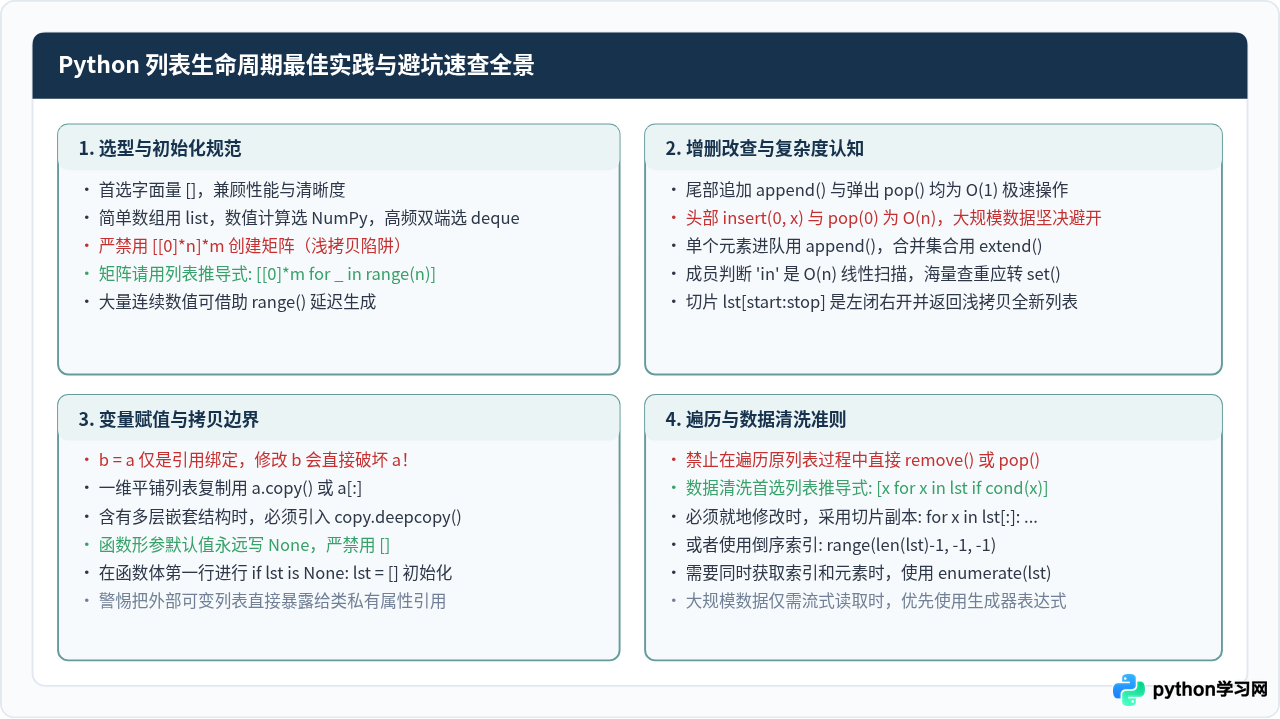
四、最佳实践与避坑速查全景图
为了让知识体系更加清晰,我们从生命周期维度将 Python 列表的最佳实践与避坑准则总结为下方的全景图:
总结
在 Python 语言中,并不存在独立于对象体系之外的传统硬编码数组类型,内置的列表(list)承担了日常开发中绝大多数序列存储与操作职责。掌握列表的关键,在于理解它底层“连续指针数组”的实现逻辑:由此带来了负向索引与切片的优雅表达,也决定了尾部快速、头部缓慢的性能特征。在实际编写代码时,时刻注意规避浅拷贝共享、循环修改跳针以及默认形参污染三大陷阱,善用列表推导式进行声明式数据处理,便能写出既地道优雅又安全高效的 Python 程序。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









