

Python字符串切片步长用法:怎么每隔n个字符取值
全面讲解Python字符串切片中步长(step)的用法,深入剖析如何每隔n个字符取值、步长与跳过字符数的关系、正负步长及实际应用场景与易错点。
在处理传感器时序报文、解析固定列宽日志、从采样数据中抽取基准位,或是从复合字符串中提取特定规律字段时,按固定跨度提取字符是一项高频出现的任务。例如,我们需要提取所有偶数索引的字符、隔一个字符读取一位,或者以 3 为跨度抽样数据。在 Python 中,完成该任务最简洁、高效且符合官方推荐惯例的方式,就是使用切片(Slicing)语法的第三个参数——步长(step)。通过 string[start:stop:step],我们可以在一条简短的语句内精确控制提取跨度与方向。
一、核心结论:每隔 n 个字符取值的标准写法
在讨论具体代码之前,我们需要先厘清日常自然语言与切片步长数值之间的对应逻辑。在实际开发和需求沟通中,“每隔 n 个字符取值”往往包含两种具体的理解维度:
- 理解一:以 n 为固定跨度周期取值。即选中第 0 项、第 n 项、第 2n 项……此时对应的切片步长为
step = n。例如,若希望每 2 个字符作为一个步进周期抽取一次,切片表达式直接写作string[::2]。 - 理解二:在两个被选中的字符之间,跳过(间隔)n 个字符。例如“每隔 1 个字符取 1 个”,意味着取第 1 个字符,跳过紧邻的 1 个字符,再取第 3 个字符。此时实际行进的索引跨度为 2。对应的步长换算公式为:
step = n + 1。
若你的需求是“在相邻提取的字符之间跳过 k 个字符”,则对应的切片步长参数为 step = k + 1;若需求是“按索引跨度 n 周期性采样”,则步长直接设为 step = n。最常用的全串隔位抽取表达式为 string[::step]。
二、语法解剖:string[start:stop:step] 的工作机制
Python 字符串属于不可变序列对象,支持通过下标与切片操作截取子序列。标准的切片语法允许我们传入三个由冒号分隔的整数参数:起始索引 start、结束索引 stop 以及步长 step。
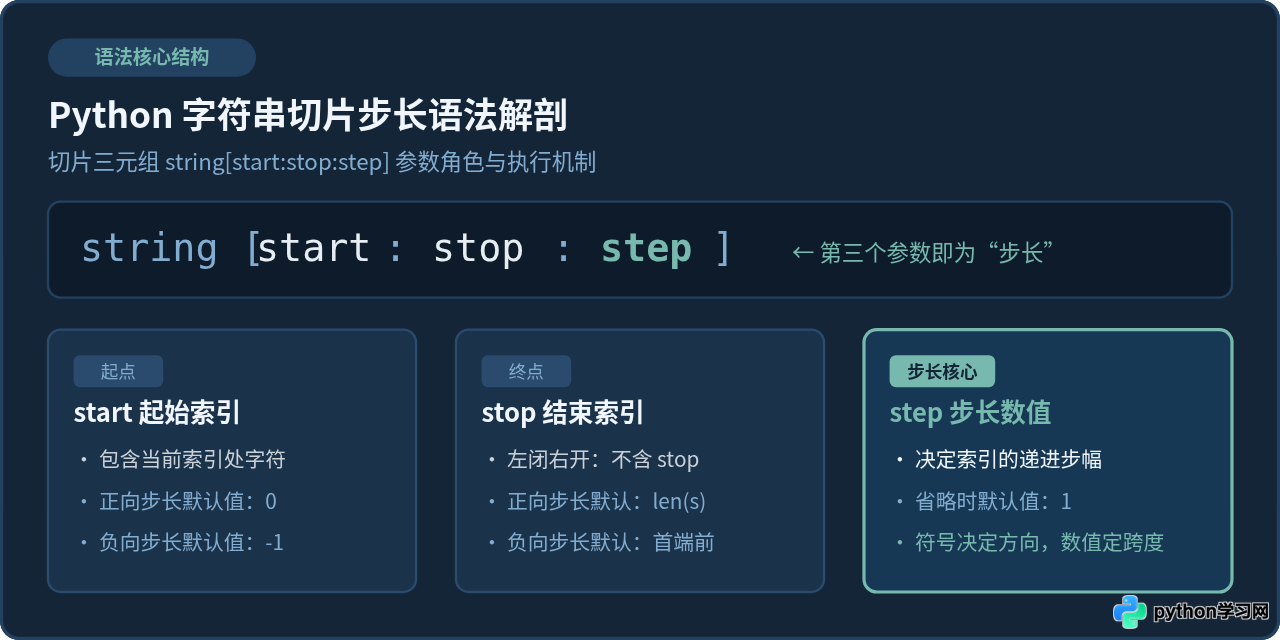
每个参数在切片执行过程中扮演着明确的职责:
- start(起始索引):切片读取的起点位置,结果包含该索引处的字符。如果省略不写,在步长为正数时默认取
0(字符串首字符)。 - stop(结束索引):切片读取的终点边界。遵循 Python 常见的“左闭右开”原则,即结果不包含
stop处的字符。如果省略不写,在步长为正数时默认读取到字符串结尾(len(string))。 - step(步长):每次提取后,当前指针向下一个目标位置行进的增量。如果不提供第二个冒号或省略该值,其默认值为
1,即连续逐字提取。
三、原理探究:步长与字符跨度的映射关系
为了直观掌握步长在底层的跳跃过程,我们以字符串 s = "PYTHONIC" 为例,观察设定 step=2 时的提取行为。此时我们采用表达式 s[::2]:
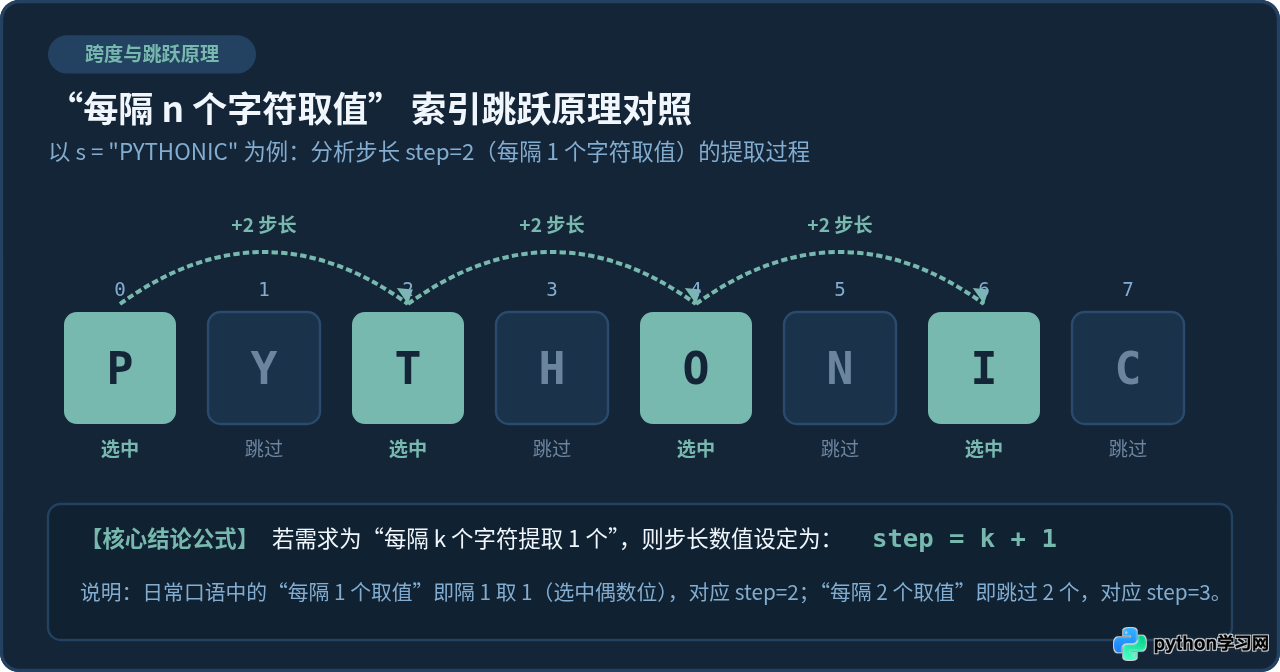
从图 2 可以清晰地看到:
- 提取从默认起点索引
0(字符'P')开始。 - 指针增加步长数值
2,抵达索引2(字符'T'),此时中间的索引1(字符'Y')被跳过。 - 指针继续增加
2,抵达索引4(字符'O'),跳过字符'H'。 - 指针再次增加
2,抵达索引6(字符'I'),跳过字符'N'。 - 下一次增加后索引将达到
8,超出合法索引范围,切片流程平稳停止。最终返回的字符串为"PTOI"。
四、操作步骤:如何落地每隔 n 个字符取值
在实际编码中,按照规范的推导流程编写切片,可以有效避免 off-by-one(差一错误)或方向冲突问题。建议遵循以下四步实施路径:
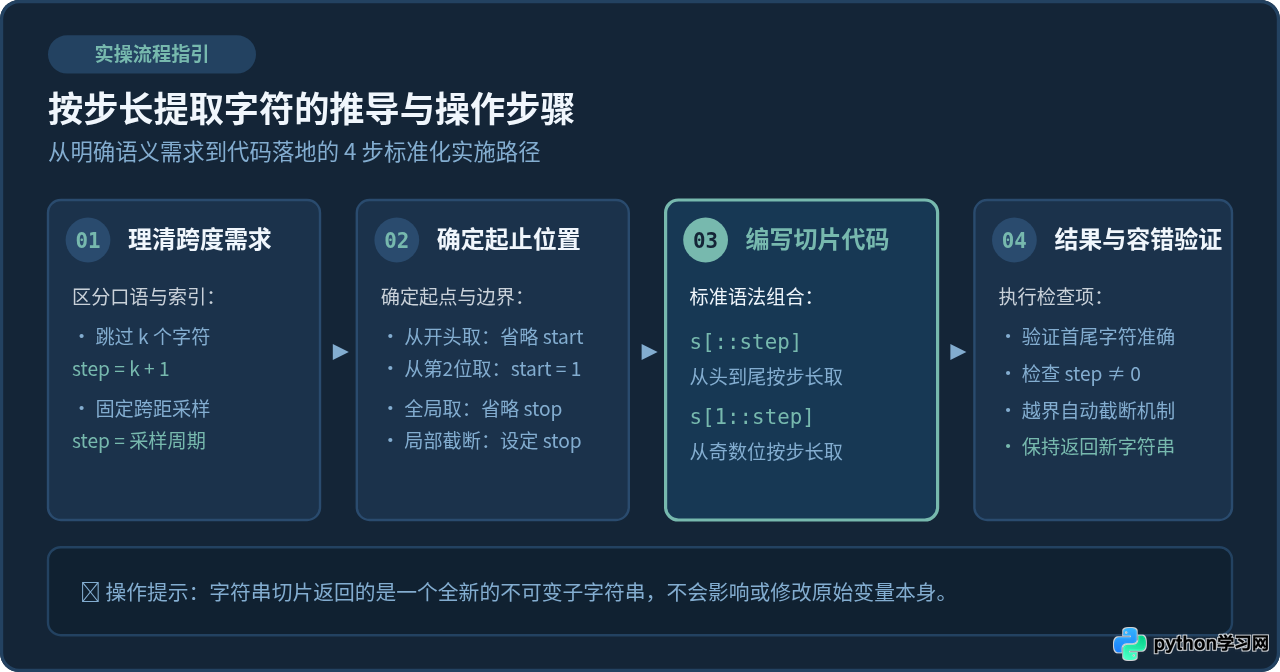
1. 基础示例:每隔 1 个字符取值(隔位取值)
如果希望从字符串首个字符开始,每跳过 1 个字符取 1 个(即取出索引 0, 2, 4, 6... 处的字符),我们设定步长为 2:
# 准备样本字符串
text = "abcdefghijk"

# 从索引 0 开始,步长为 2
result_even = text[::2]
print(result_even)  # 示例输出: 'acegik'
2. 基础示例:每隔 2 个字符取值(跳过两个取一个)
如果需求是“每隔 2 个字符取 1 个”(即取出索引 0, 3, 6, 9... 处的字符),步长应设为 3:
text = "0123456789"

# 步长为 3,依次获取 0, 3, 6, 9
result_step3 = text[::3]
print(result_step3)  # 示例输出: '0369'
3. 切换起点:提取奇数位置字符
默认情况下,省略 start 会从索引 0 开始取值。若要从第 2 个字符(索引 1)开始隔位提取,只需将 start 显式指定为 1:
text = "abcdefghijk"

# 从索引 1 开始,步长为 2(提取奇数位:1, 3, 5, 7, 9)
result_odd = text[1::2]
print(result_odd)  # 示例输出: 'bdfhj'
五、全景对照:正向步长、负向步长与区间限制
步长不仅可以是正数,还可以是负数。当 step 为负整数时,切片的扫描方向会彻底反转,从右向左移动。这为倒序提取和字符串反转提供了极大的便利。
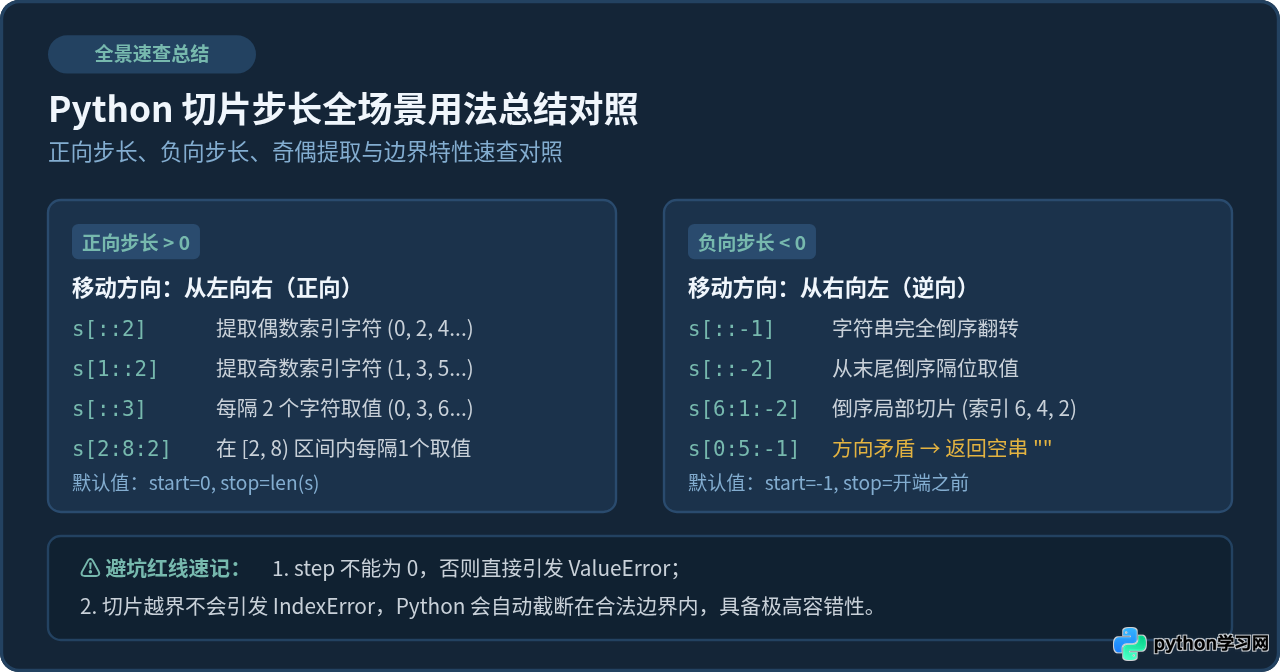
1. 限定范围的步长切片:s[start:stop:step]
步长不仅可以在全字符串上执行,也可以限制在指定区间内。例如,仅对索引 2 到 8 之间的字符执行隔位提取:
raw_data = "AB_10_20_30_CD"

# 仅在 [3, 11) 范围内按步长 3 抽取
sub_sample = raw_data[3:11:3]
print(sub_sample)  # 示例输出: '1_0'
2. 倒序与逆向隔位取值:s[::-1] 与 s[::-2]
当 step = -1 时,start 默认指向字符串最后一个字符(索引 -1),stop 默认覆盖到首字符之前,形成经典的反转字符串写法:
word = "PYTHON"

# 字符串完全倒序
reverse_word = word[::-1]
print(reverse_word)  # 示例输出: 'NOHTYP'

# 从末尾开始,倒序每隔 1 个字符取 1 个(索引 -1, -3, -5)
reverse_step2 = word[::-2]
print(reverse_step2)  # 示例输出: 'NHY'
六、避坑清单:切片步长的三大高频误区
1. 步长绝对不能设为 0
切片允许 start 和 stop 越界或省略,但 step 绝对不能为 0。如果将步长设为 0,Python 解释器无法确定指针的前进方向与幅度,会直接抛出 ValueError:
s = "hello"
# 错误写法:引发 ValueError: slice step cannot be zero
# bad_slice = s[::0]
2. 起止位置与步长方向冲突导致返回空字符串
当下标递进方向与步长符号相反时,切片并不会报错,而是直接返回空字符串 ""。例如:
s[0:5:-1]:起点是 0,终点是 5,步长为 -1(向左走)。从 0 向左不可能到达 5,因此返回""。s[5:1:2]:起点是 5,终点是 1,步长为 2(向右走)。从 5 向右移动不可能到达 1,因此返回""。
3. 切片的自动截断特性(不抛 IndexError)
与单独通过单下标访问字符(如 s[100] 抛出 IndexError: string index out of range)不同,切片操作具备内置的边界保护机制。如果 start 或 stop 超出了字符串的实际长度,Python 会优雅地将其裁剪至有效边界,而不会中断程序执行。
七、速查表:常见需求与对应切片写法
下表整理了日常开发中最常用的按步长取值需求与对应切片表达式,供快速查阅参考:
| 业务需求 | 对应切片语法 | 以 "ABCDEFGHIJ" 为例的输出 |
|---|---|---|
| 提取所有偶数索引项(每隔1个取1个) | s[::2] |
'ACEGI' |
| 提取所有奇数索引项(从第2个字符开始隔位取) | s[1::2] |
'BDFHJ' |
| 每隔 2 个字符取 1 个(跳过2个字符) | s[::3] |
'ADGJ' |
| 每隔 3 个字符取 1 个(跳过3个字符) | s[::4] |
'AEI' |
| 完全倒序翻转字符串 | s[::-1] |
'JIHGFEDCBA' |
| 从右向左倒序隔位取值 | s[::-2] |
'JHFDB' |
| 在指定区间 [2, 8) 范围内隔位提取 | s[2:8:2] |
'CEG' |
掌握了 string[start:stop:step] 的规律后,无论是在常规的数据清洗、文本特征抽取,还是算法中的回文字符串判断场景下,都可以通过简明优雅的代码快速实现字符串按步长提取。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









