

Python字符串常用方法详解:切片、查找与替换实战
深入解析Python字符串的核心操作方法:切片语法原理与越界规则、in/find/index查找方法对比选型、replace替换与不可变内存机制,配以实战案例与避坑指南。
一、理解前提:字符串的不可变性与底层序列结构
在深入具体方法前,需要明确 Python 字符串的核心存储机制。Python 字符串是由 Unicode 字符构成的有序不可变序列:
- 有序索引访问:字符串中的每个字符都拥有唯一确定的整数坐标,支持从左至右由
0开始的正向索引,以及从右至左由-1开始的反向索引。 - 不可原地修改:一旦在内存中创建,其内部字符内容便固定不变。尝试使用赋值语句
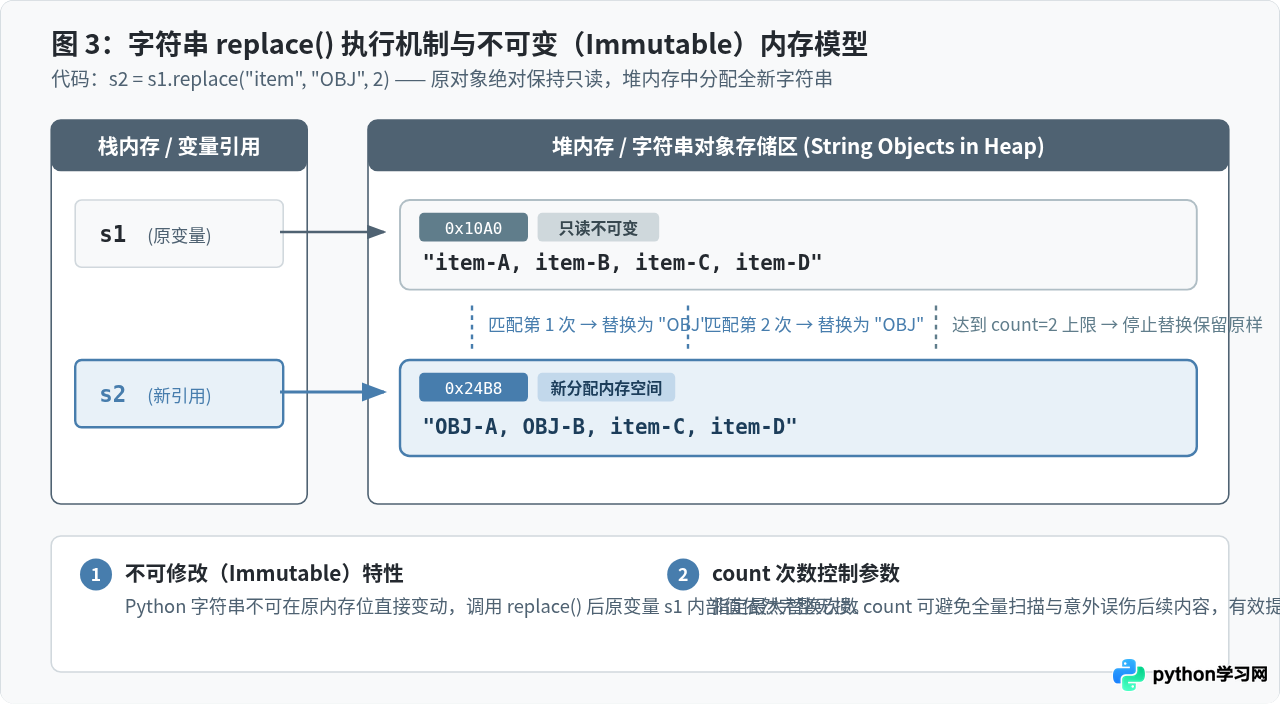
s[0] = 'X'会直接触发TypeError: 'str' object does not support item assignment。 - 派生新对象:无论是切片子串、替换字符还是拼装连接,所有方法均通过创建新的字符串对象交付。理解这一点有助于合理评估高并发或大循环场景下的内存开销。
二、字符串切片详解与实战技巧
切片(Slice)是 Python 提取子字符串最灵活、最高效的原生语法机制。它允许我们通过指定起止边界与采样步长,从原字符串中精确抽取出任意片段。
1. 切片的核心语法结构
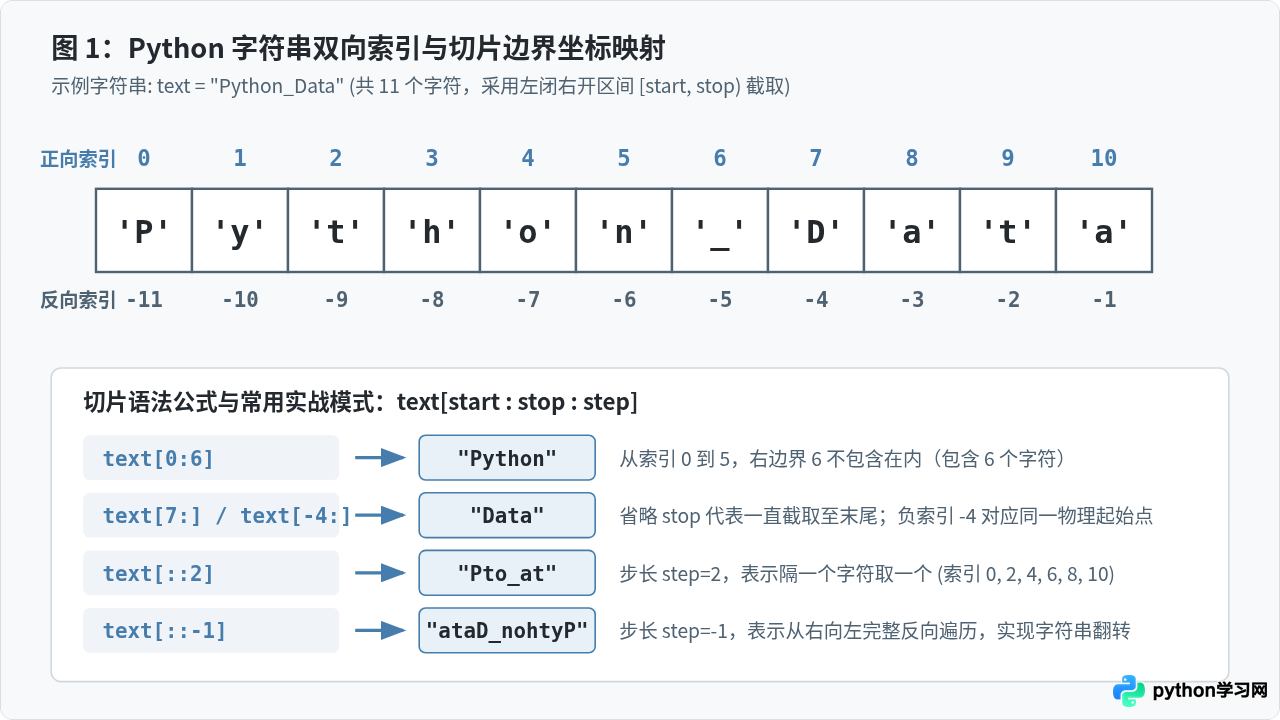
切片的基本表达式为 sequence[start:stop:step],各参数具有明确的规则:
start(起始索引):切片开始提取的位置。包含该索引对应的字符。缺省时默认为0(正步长时)或末尾(负步长时)。stop(结束索引):切片停止提取的边界。不包含该索引对应的字符(遵循数学上的左闭右开区间[start, stop))。缺省时表示一直截取到字符串末尾。step(步长):每次提取字符的步进跨度。默认为1。若为负数,表示从右往左反向步进。
2. 常见切片模式与代码实操
下面通过具体代码演示正向区间截取、省略边界、负索引截取以及负步长逆序的完整用法:
# 定义示例字符串
text = "Python_Data_2026"

# 1. 基础区间切片:提取前 6 个字符 [0, 6)
name = text[0:6]

# 2. 省略边界:从索引 7 开始截取至末尾
tail = text[7:]

# 3. 负索引提取:截取末尾 4 位字符(年份)
year = text[-4:]

# 4. 步长采样:每隔 1 个字符提取 1 个字符
sampled = text[::2]

# 5. 反向步长:完整反转字符串
reversed_text = text[::-1]

print("name:", name)
print("tail:", tail)
print("year:", year)
print("sampled:", sampled)
print("reversed:", reversed_text)
在 Python 中,通过单个下标访问不存在的索引(如 text[100])会直接抛出 IndexError: string index out of range 异常;而在切片操作中,Python 会自动将超出字符串实际长度的索引截断为合法边界。例如 text[7:100] 会安全返回 "Data_2026",text[50:100] 会返回空字符串 "" 而不会发生崩溃。这一特性使得切片在解析变长文本时具有极高的鲁棒性。
三、字符串查找方法对比与选型实战
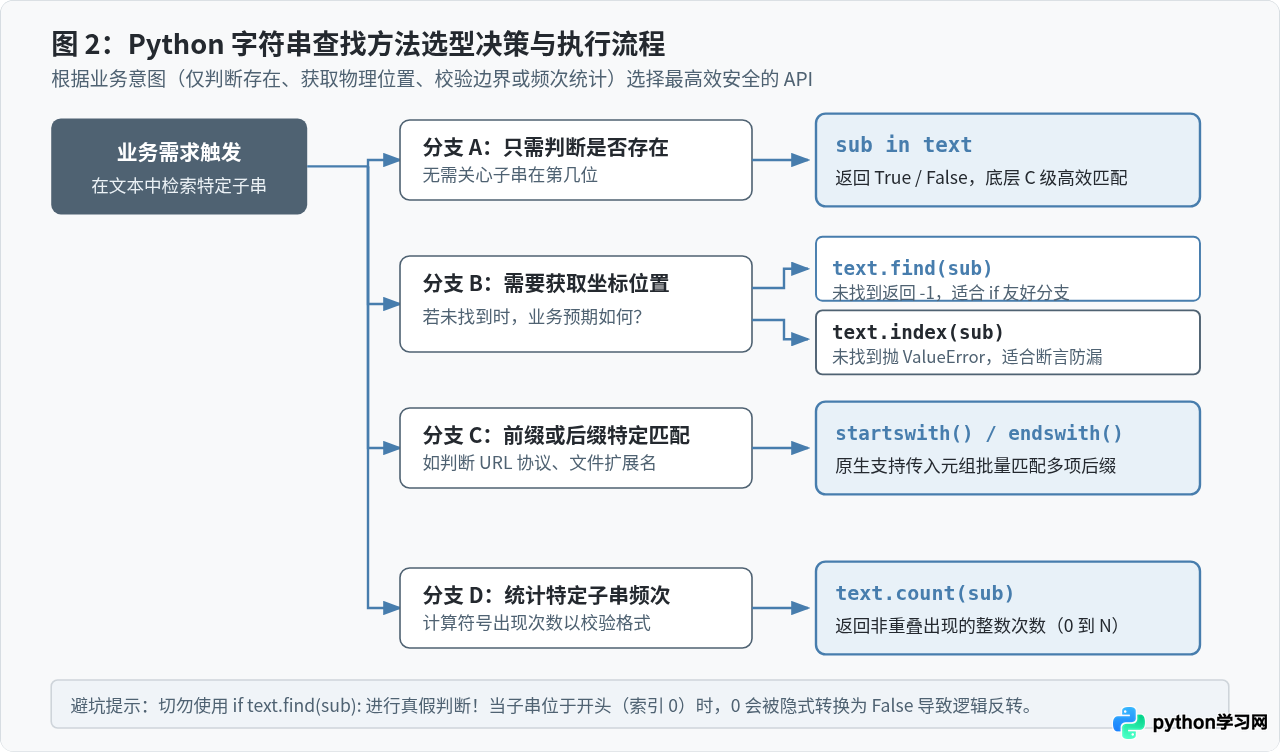
在处理文本时,查找子字符串或判断某子模式是否存在是核心诉求。Python 提供了成员操作符 in、find()、rfind()、index()、rindex()、startswith()、endswith() 以及 count() 等多个 API。选用哪个方法取决于业务是否需要返回索引位置以及找不到时的容错策略。
1. 各查找方法的机制对比
| 方法 / 操作符 | 返回值类型 | 未找到目标时的行为 | 典型适用场景 |
|---|---|---|---|
sub in s |
bool |
返回 False |
仅需判断目标子串是否存在,最 Pythonic 且性能最优 |
s.find(sub) |
int |
返回 -1 |
需要获取首次出现的索引下标,支持安全的 if 分支判断 |
s.rfind(sub) |
int |
返回 -1 |
从右向左查找,返回最后一次出现的索引下标(如查找最后路径斜杠) |
s.index(sub) |
int |
抛出 ValueError |
严格要求目标必须存在,配合 try-except 校验关键数据格式 |
s.startswith(prefix) |
bool |
返回 False |
校验协议头、特定标识;支持传入 tuple 批量匹配 |
s.endswith(suffix) |
bool |
返回 False |
校验文件扩展名、固定后缀;支持传入 tuple 批量匹配 |
s.count(sub) |
int |
返回 0 |
统计子串在主串中无重叠出现的总次数 |
2. 查找实战代码与结果验证
下面的示例代码演示各种查找方式的正确用法与容错处理:
url = "https://example.com/reports/financial_2026.csv"

# 1. 存在性快速判定 (in 关键字)
if "reports" in url:
    print("资源位于 reports 目录中")

# 2. 前缀与后缀批量匹配 (元组多模式匹配)
is_https = url.startswith("https://")
is_valid_format = url.endswith((".csv", ".xlsx", ".tsv"))
print(f"HTTPS协议: {is_https}, 支持的数据表格式: {is_valid_format}")

# 3. 安全获取位置索引 (find 与 rfind)
domain_start = url.find("example.com")
last_slash_idx = url.rfind("/")
print(f"域名起始索引: {domain_start}, 最后一个路径斜杠索引: {last_slash_idx}")

# 提取文件名(结合 rfind 与切片)
file_name = url[last_slash_idx + 1:]
print(f"提取文件名: {file_name}")

# 4. 找不到时的行为对照
missing_pos = url.find("archive")
print(f"查找不存在的内容 (find): {missing_pos}")  # 输出 -1

# 5. 频次统计 (count)
slash_count = url.count("/")
print(f"斜杠出现总次数: {slash_count}")
在 Python 中,if text.find("target"): 是极其危险的写法。因为当 target 位于字符串开头时,find() 返回索引 0,而数字 0 在条件判断中会被自动转换为 False,导致逻辑分支直接漏走!正确的写法应为:if text.find("target") != -1: 或直接使用更为简洁的 if "target" in text:。
四、字符串替换与清洗实战
文本清洗与格式标准化离不开替换操作。Python 提供了开箱即用的 replace() 方法,针对单字符映射场景还提供了底层的 translate() 方法。
1. replace() 的语法与内存机制
语法定义为:str.replace(old, new[, count])。
old:被替换的目标子串。new:替换后的新子串。如果传空字符串"",则表示将目标子串完全删除。count(可选):最大替换次数。默认替换所有出现的匹配项;若指定具体数值,则仅从左到右替换前count次。
2. 替换操作常见场景代码示例
包含指定次数替换、链式替换以及使用 maketrans() 与 translate() 进行多字符批量映射的高效清洗技巧:
raw_msg = "[WARN] [WARN] Disk space low; [WARN] please clean temp files."

# 场景 1:限制替换次数(只替换第 1 个 [WARN] 为 [CRITICAL])
fixed_msg = raw_msg.replace("[WARN]", "[CRITICAL]", 1)
print("部分替换:", fixed_msg)

# 场景 2:全局删除特定字符(将空字符串作为 new)
compact_msg = raw_msg.replace(" ", "")
print("清除空格:", compact_msg)

# 场景 3:链式替换(适合 2-3 个连续字符规则)
dirty_text = "Python 2.7 -> Python 3.8 & Python 3.10"
clean_text = dirty_text.replace("Python 2.7", "Py2").replace("Python 3.8", "Py38")
print("链式替换:", clean_text)

# 场景 4:高阶性能技巧:利用 translate 批量映射敏感字符
# 将标点符号统一转换为下划线,去除特殊符号
table = str.maketrans({"@": "_", "#": "_", "$": "_", "%": None})
tag_str = "user@name#tag$2026%token"
sanitized = tag_str.translate(table)
print("translate批量映射结果:", sanitized)
五、综合实战:结构化数据提取与敏感信息脱敏
在实际工程项目中,切片、查找与替换通常协同完成任务。以下演示一个典型的综合实战案例:解析一条未格式化的系统审计日志,定位关键时间戳、提取操作用户,并对手机号码与邮箱进行隐私脱敏。
def parse_and_mask_log(log_line: str) -> dict:
    """
    输入原始日志,提取结构化字段并对敏感数据进行脱敏处理
    日志格式示例:[2026-10-30 09:30:15] USER:alice; PHONE:13812345678; EMAIL:alice_finance@corp.com; ACTION:export
    """
    # 步骤 1:利用切片提取时间戳(前 21 个字符形如 [YYYY-MM-DD HH:MM:SS])
    timestamp = log_line[1:20]

    # 步骤 2:利用 find 定位字段并切片提取用户
    user_start = log_line.find("USER:") + len("USER:")
    user_end = log_line.find(";", user_start)
    username = log_line[user_start:user_end]

    # 步骤 3:提取手机号并进行中段脱敏 (保留前3后4,中间4位替换为*)
    phone_start = log_line.find("PHONE:") + len("PHONE:")
    phone_end = log_line.find(";", phone_start)
    raw_phone = log_line[phone_start:phone_end]
    # 利用切片组合实现脱敏
    masked_phone = raw_phone[:3] + "****" + raw_phone[-4:] if len(raw_phone) == 11 else raw_phone

    # 步骤 4:提取邮箱并脱敏用户名部分
    email_start = log_line.find("EMAIL:") + len("EMAIL:")
    email_end = log_line.find(";", email_start)
    raw_email = log_line[email_start:email_end]
    at_pos = raw_email.find("@")
    if at_pos > 2:
        masked_email = raw_email[:2] + "***" + raw_email[at_pos:]
    else:
        masked_email = raw_email

    # 步骤 5:提取操作类型
    action_start = log_line.find("ACTION:") + len("ACTION:")
    action = log_line[action_start:].strip()

    return {
        "timestamp": timestamp,
        "username": username,
        "phone": masked_phone,
        "email": masked_email,
        "action": action
    }

# 执行验证
raw_log = "[2026-10-30 09:30:15] USER:alice_dev; PHONE:13812345678; EMAIL:alice_finance@corp.com; ACTION:export"
record = parse_and_mask_log(raw_log)

for k, v in record.items():
    print(f"{k.ljust(10)}: {v}")
在该案例中,切片保证了截取定长和变长内容时的精准度,find() 提供了安全的动态边界定位,而基于切片与拼接的重组逻辑则实现了符合隐私合规的数据脱敏。
六、核心方法总结与避坑速查
为了在实际编码中快速查阅并避开常见陷阱,我们将切片、查找与替换的语法特性、返回值差异和性能经验总结如下:
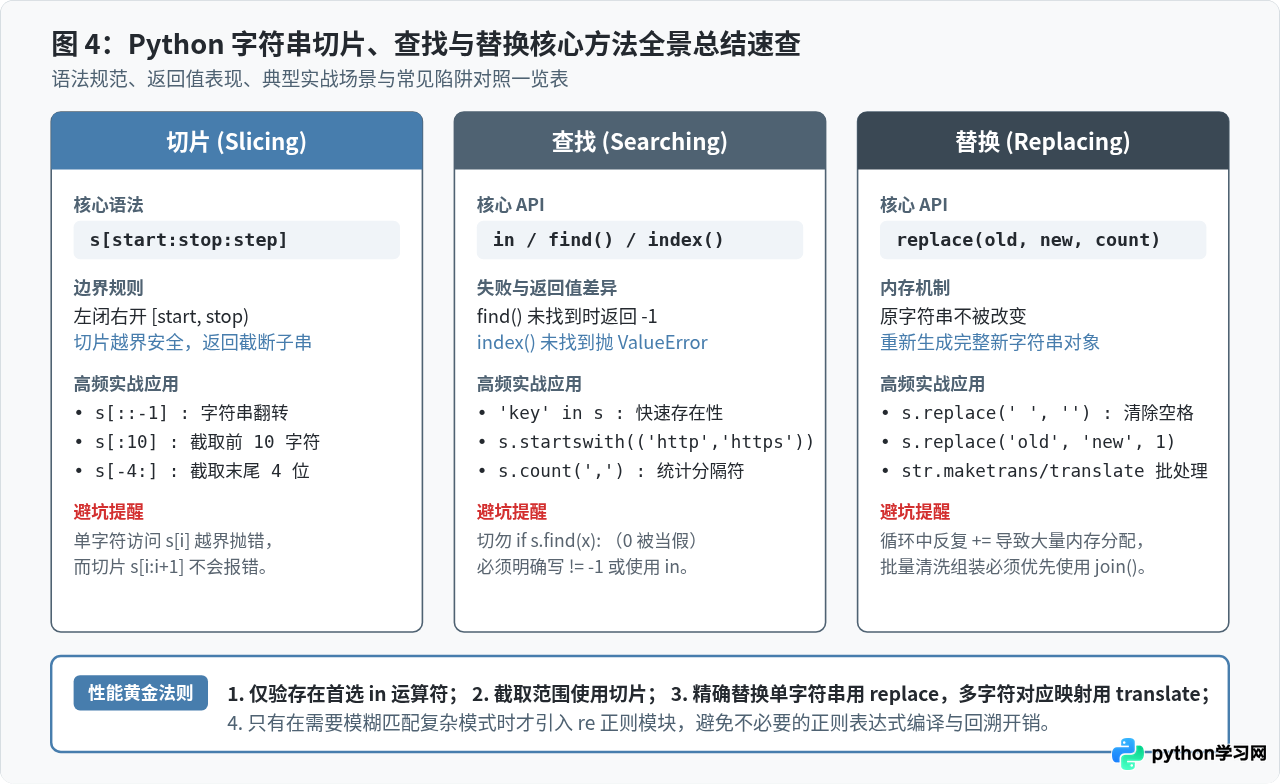
性能优化与高频避坑清单
- 不要在循环内使用
+=拼接字符串:因为字符串不可变,循环内部反复+=会导致频繁的内存重分配与内存复制。需要拼接多个子串时,应先将片段追加到list中,最后调用''.join(list_of_strings)进行一次性组装。 - 区分单个索引取值与切片容错机制:访问未知长度字符串时,若不确定长度,优先使用切片如
s[:1]获取首字符(即便字符串为空串""也不会报错),避免直接调用s[0]触发IndexError。 - 警惕
count()的非重叠计数规则:count()方法在统计时不会重叠计算。例如'aaaa'.count('aa')得到的结果是2而不是3。如需统计包含重叠滑动窗口的频次,需改用正则向前查找或手动循环切片。 - 优先使用原生方法代替重量级正则表达式:对于简单的固定子串判定、截取与单模式替换,内置的
in、切片和replace()在底层均由 C 语言针对性优化,执行速度比编译正则表达式快数倍至数十倍。仅在涉及复杂模式匹配(如模糊正则模式、动态分词)时才引入re模块。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









