

Python字符串replace、切片与正则部分替换的适用场景对比

在 Python 开发中,字符串替换是一类基础且高频的操作。由于 Python 字符串具有不可变(immutable)的特性,任何替换逻辑都不会在原内存地址上就地修改,而是基于既定规则创建并返回一个新的字符串对象。处理“部分替换”任务时,开发者通常有三种主流手段:str.replace()、切片拼接以及 re.sub()。虽然它们都能完成子串更新,但在匹配机制、位置控制精度以及性能表现上存在明显边界。本文将全面对比这三种方案的核心差异,给出具体场景下的选型依据与避坑指南。
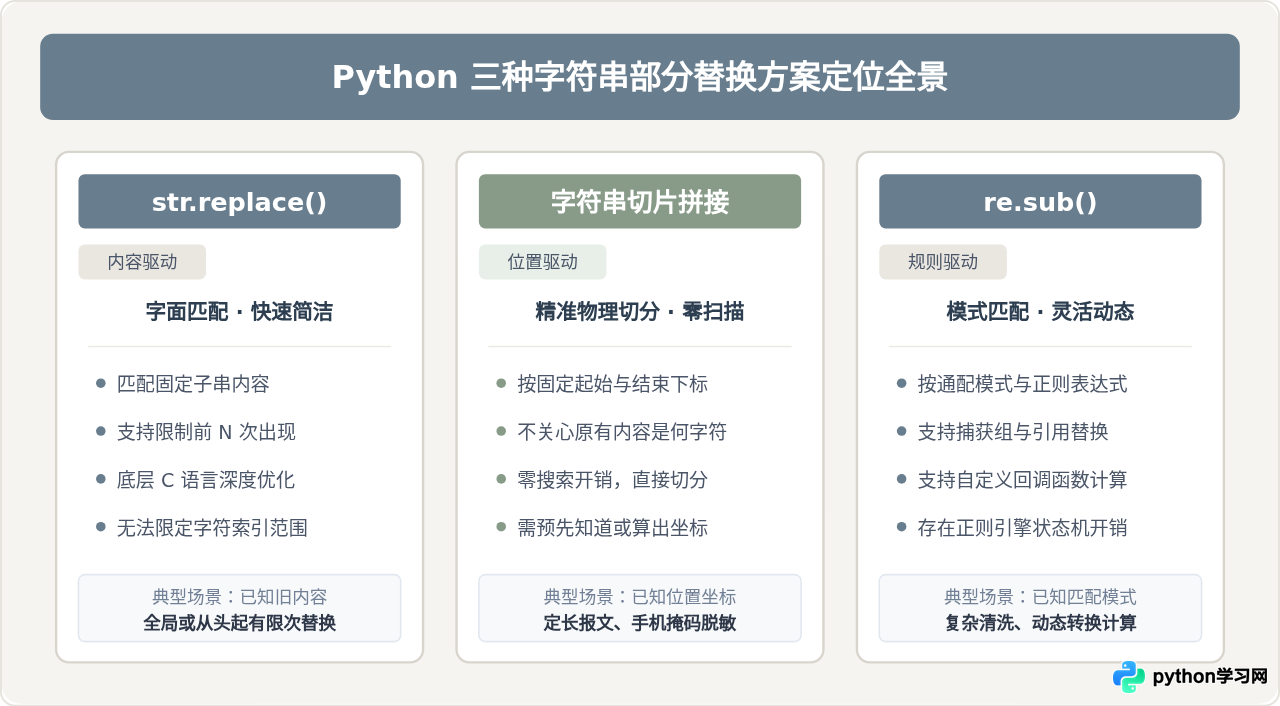
一、核心机制与基础语法解析
1. str.replace():基于字面量的定额/全量替换
str.replace(old, new[, count]) 是 Python 内置的字符串方法。它的核心特征是“精确字面值匹配”。当传入 old 参数时,解释器不会解析任何正则通配符,而是将其作为纯文本在主串中寻找完全匹配的子串。
参数 count 是控制“部分替换”的关键。如果不指定 count,方法会替换所有出现的匹配项;如果传入正整数 count=k,则仅按从左到右的扫描顺序,替换前 k 次出现的子串,后续出现的相同内容将完整保留。
# 基础语法与 count 限制示例
raw_text = "apple pie, apple cider, apple juice"

# 全量替换
print(raw_text.replace("apple", "orange"))
# 示例输出: orange pie, orange cider, orange juice

# 部分替换:仅替换前 2 次
print(raw_text.replace("apple", "orange", 2))
# 示例输出: orange pie, orange cider, apple juice
局限性:str.replace() 只能从字符串头部顺次计数。如果需求是“只替换第 2 个出现的 apple”或“只替换特定位置之后的字符”,str.replace() 单独使用便无法直接完成,必须依赖额外的查找或截断步骤。
2. 字符串切片拼接:基于索引区间的物理重组
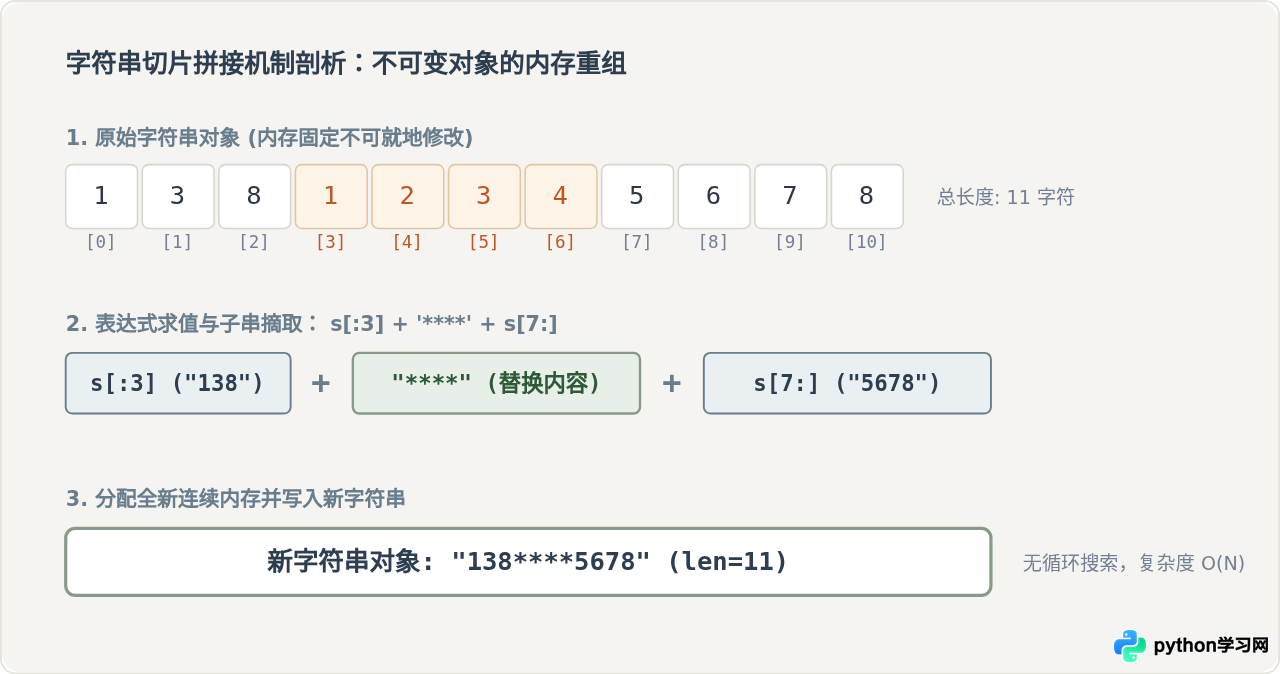
切片是 Python 对序列型对象的原生操作。切片拼接的核心思路是:根据已知字符的起始索引 start 和结束索引 end,将原字符串在物理上拆分为前缀 s[:start] 和后缀 s[end:],然后在中间插入新内容:s[:start] + new_content + s[end:]。
# 基于固定索引的部分替换
phone = "13812345678"

# 将中间 4 位(索引 3 到 7)替换为掩码 "****"
masked_phone = phone[:3] + "****" + phone[7:]
print(masked_phone)
# 示例输出: 138****5678
切片拼接完全绕过了“文本搜索”这一步骤。无论原字符串在该区间内的字符是什么,切片都能直接将其覆盖。这种机制在处理定长报文、日志格式化或结构化字段替换时具有确定性的优势。
3. re.sub():基于模式规则与动态函数的逻辑替换
标准库 re 模块中的 re.sub(pattern, repl, string, count=0, flags=0) 提供了极高的灵活性。其底层驱动是正则表达式引擎,支持元字符、边界匹配、字符集和贪婪/非贪婪量词。
除了支持模式匹配外,re.sub() 最关键的能力在于 repl 参数不仅可以是字符串,还可以是一个可调用对象(callable,如函数或 lambda 表达式)。在执行替换时,正则引擎每次命中匹配,都会把匹配对象 Match 作为参数传入该函数,并以函数返回值作为替换文本。
import re

# 场景 A: 使用正则模式匹配并保留结构 (捕获组重组)
date_str = "2026-10-23"
# 将 YYYY-MM-DD 转换为 DD/MM/YYYY
formatted_date = re.sub(r"(\d{4})-(\d{2})-(\d{2})", r"\3/\2/\1", date_str)
print(formatted_date)
# 示例输出: 23/10/2026

# 场景 B: 使用 callable 动态函数进行部分替换
text = "订单编号: item_45, 价格: 80 元, 折扣: 10 元"

def apply_tax(match):
    val = int(match.group(0))
    return str(round(val * 1.1))

# 将文本中所有单独出现的数字乘以 1.1 税率后替换
result = re.sub(r"\b\d+\b", apply_tax, text)
print(result)
# 示例输出: 订单编号: item_45, 价格: 88 元, 折扣: 11 元
二、关键场景下的深度对比
为了让读者在实际编码中精准选择,我们围绕三种最容易产生疑惑的具体情境,在一致条件下剖析其差异及其背后的原因。
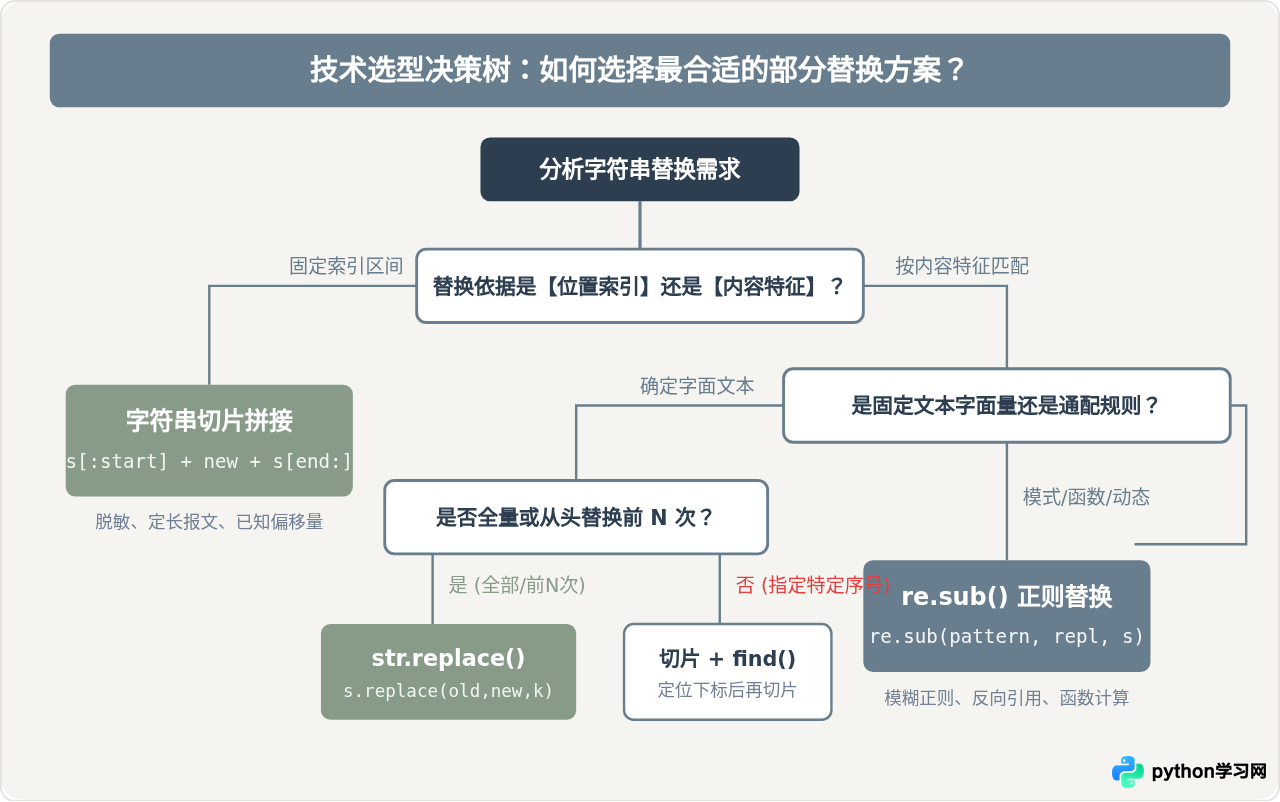
场景一:仅替换“特定序号”或“特定出现位置”的子串
这是业务中最常见的需求之一。例如文本中有 4 个 # 符号,需求是“仅替换第 2 个 # 为 @,其他 # 保持不变”。
- str.replace() 的局限:
replace('#', '@', 2)会将第 1 个和第 2 个都替换掉;无法表达“跳过第 1 个,只改第 2 个”。 - 切片方案:先通过两次
find()找到目标序号字符的具体索引,再使用切片精确更新。text = "tag1#tag2#tag3#tag4" # 寻找第二个 '#' 的索引 first_idx = text.find("#") second_idx = text.find("#", first_idx + 1) if second_idx != -1: res = text[:second_idx] + "@" + text[second_idx + 1:] print(res) # 示例输出: tag1#tag2@tag3#tag4 - re.sub() 方案:利用带计数状态的闭包函数或通过正则环视断言完成。虽然代码行数少,但在简单字符替换时显得有些大材小用。
场景二:定长报文、掩码脱敏与固定区间修改
在处理银行卡号、身份证号脱敏,或者解析金融、工业传感器定长报文时,字符的位置是严格规范化的(例如“从第 10 字节开始的 4 个字符代表校验码”)。
在这种情境下,切片拼接是绝对的最佳实践。原因在于:
- 避免内容误伤:如果使用
replace("00", "**"),原文本开头或结尾恰巧也有"00",就会发生非预期篡改;而切片牢牢锁定索引范围,绝不波及其他区域。 - 零搜索代价:切片通过指针算术直接定位内存偏移量,不需要遍历整个字符串做字符比对,执行速度极其稳定。
场景三:多条件、模糊模式与动态值计算
如果替换目标不具备固定位置,也没有固定的字面值,而是遵循某种规则(例如“连续的空白符统一压成单个空格”、“敏感词库动态脱敏”、“HTML 标签属性替换”),此时 replace() 和单纯的切片拼接都无法胜任。
re.sub() 凭借正则引擎的 DFA/NFA 状态机,能在一趟扫描中完成模式匹配,并结合反向引用(如 \g<1>)或回调函数实现高度定制化的替换。此时正则带来的灵活性远超其在性能上的微小损失。
三、性能开销与底层实现差异
对于高频执行的数据管道或 Web 请求处理,选型不同带来的性能损耗有显著差异:
- str.replace() 的 C 级循环:CPython 底层使用优化的字符串查找算法(如改进版 Boyer-Moore-Horspool 或单字符快速匹配),其内存重组在 C 扩展层面单次申请并直接填充新缓冲区。因此在针对字面值的替换场景中,
replace()是效率最高的方案。 - 切片拼接的轻量级开销:切片拼接涉及两次切片提取与一次拼接。在 CPython 中,切片只做浅拷贝(提取局部字节块),三段拼接由操作码
BUILD_STRING或连续加法完成。因为完全没有字符串搜索开销,在小范围、固定位置的替换中,耗时与replace()处于同一数量级,远快于正则。 - re.sub() 的状态机与回溯:正则表达式在执行前需要编译为字节码或底层有限状态机。即便通过
re.compile()进行了预编译缓存,在匹配时依然要逐字符驱动状态转移,并记录捕获组信息。若repl为 Python 函数,每个匹配项还会产生一次函数调用的上下文切换。因此其相对执行耗时通常是前两者的数倍到数十倍。
re.sub()。只有当匹配规则具备模糊性、多分支或动态逻辑时,正则的灵活性才足以抵消其执行开销。
四、综合对比与避坑指南
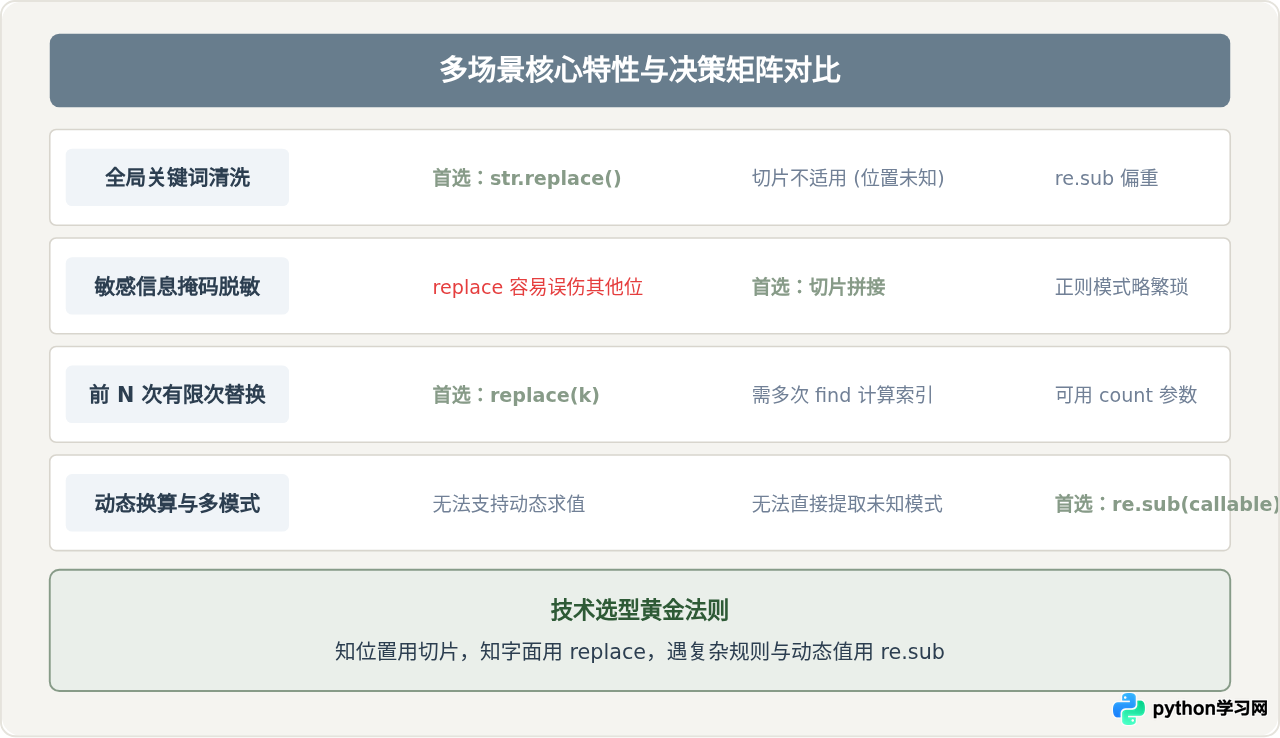
下表归纳了三种方案在各维度的综合指标:
| 对比维度 | str.replace() | 字符串切片拼接 | re.sub() |
|---|---|---|---|
| 匹配基准 | 固定文本字面量 | 物理字符索引下标 | 正则表达式模式/规则 |
| 部分替换控制 | 支持 count 参数限制前 N 次 |
通过 [start:end] 精确控制指定段落 |
支持 count 限制及前后条件断言 |
| 动态计算能力 | 不支持(仅支持静态映射) | 支持结合外部变量与格式化字符串 | 原生支持回调函数(callable) |
| 执行效率 | 极高(C 底层直接组装) | 极高(直接指针切分与内存拼接) | 中等(依赖正则引擎匹配与回溯) |
| 代码可读性 | 直观明了,不易出错 | 简单直接,需小心索引边界计算 | 表达力强,复杂的正则表达式较难维护 |
开发中的常见陷阱与注意事项
- 切片索引越界与偏移计算:Python 字符串切片即便超出字符串最大长度也不会抛出
IndexError,而是静默截断为最大有效范围。虽然这提高了容错率,但在做等长替换时容易因索引偏差导致结果长度与预期不符。编写切片代码时建议加入单元测试或断言校验字符串长度。 - 大量替换时的频繁拼接性能陷阱:如果需要对同一个长字符串进行数十次或上百次局部切片更新,切勿在循环体内反复执行
s = s[:idx] + char + s[idx+1:],这会导致 \(O(M \times N)\) 的内存重复分配开销。正确的做法是将字符串转换为字符列表list(s),直接按索引赋值后通过"".join(list)一次性组装。 - 正则表达式的转义与原始字符串:使用
re.sub()时,务必对pattern使用原始字符串前缀r"...";如果替换内容中包含特殊字符\或$,切记在re.sub()中这些字符具有反向引用含义,必要时使用re.escape()对输入进行清洗。
掌握以上三种替换机制的内在原理与差异,能够帮助我们在面对日常的文本清洗、数据格式化及业务报文处理时,既保证代码的清晰可读,又兼顾运行时的执行效率。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









