

怎么在Python asyncio事件循环中安全运行多线程阻塞代码
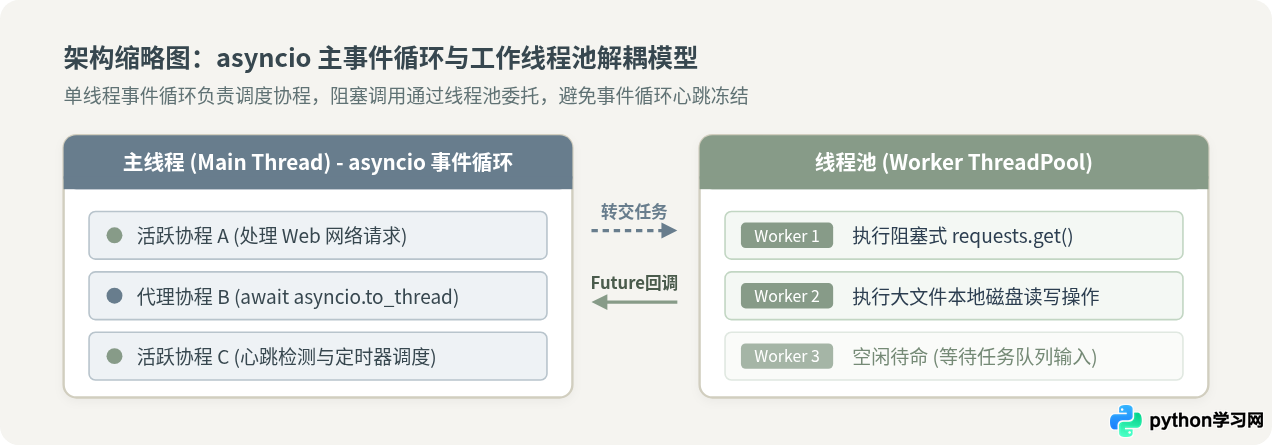
在Python asyncio单线程事件循环中,直接调用同步阻塞函数会导致所有并发协程冻结。本文系统讲解如何利用asyncio.to_thread与自定义ThreadPoolExecutor将阻塞代码转交后台工作线程,深入对比默认线程池与独立隔离线程池的适用场景,并剖析跨线程安全通信与任务取消的处理边界。
await 等待其结果。Python 3.9+ 推荐使用原生的 asyncio.to_thread(),而在高并发或资源受限场景下,则应通过自定义的 ThreadPoolExecutor 配合 loop.run_in_executor() 进行资源隔离,同时做好上下文变量传递与跨线程安全回调。
一、为什么必须在独立线程中运行阻塞代码
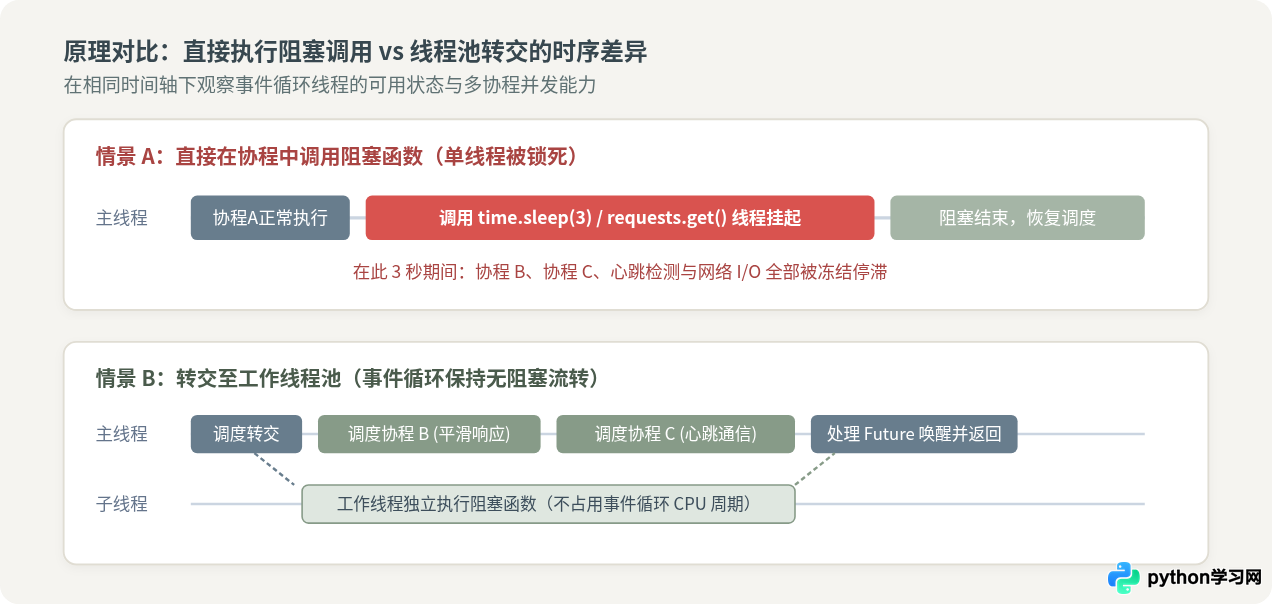
asyncio 采用的是单线程协同式多任务模型。所有协程的调度、Socket 读写监听、定时器以及信号触发,都在同一个 OS 线程(主线程事件循环)中按轮次流转。协程之所以能够并发,依赖于它们遇到 I/O 等待时通过 await 主动向事件循环让出执行权。
如果协程内部调用了传统的阻塞函数(例如 time.sleep()、基于套接字阻塞模式的 requests 请求、传统的同步数据库驱动、或耗时的本地大文件读写),当前线程就会在此处陷入内核态等待,事件循环将彻底丧失控制权。在此期间,无论是网络心跳包响应、其他客户端的接入还是定时任务,都会全部陷入物理冻结状态。
二、核心操作步骤与标准实现
将阻塞调用安全接入 asyncio 的核心步骤包含三个环节:确定阻塞操作函数签名、选择合适的线程池容器、并在协程中通过 Future 机制等待执行完成。
步骤一:使用 asyncio.to_thread 快速封装
从 Python 3.9 开始,标准库提供了轻量级顶层函数 asyncio.to_thread()。它负责将普通同步函数包装为可以在事件循环中直接 await 的协程,并自动把调用者的上下文变量(contextvars)复制到执行线程中:
import asyncio
import time
import requests

# 模拟传统的阻塞型网络请求函数
def sync_fetch_url(url: str, timeout: int = 5) -> dict:
    resp = requests.get(url, timeout=timeout)
    return {"status": resp.status_code, "length": len(resp.text)}

async def main():
    print("任务启动,准备执行阻塞请求...")
    # 关键点:使用 asyncio.to_thread 委托至工作线程
    result = await asyncio.to_thread(sync_fetch_url, "https://httpbin.org/delay/2", timeout=5)
    print(f"请求完成,结果为: {result}")

if __name__ == "__main__":
    asyncio.run(main())
运行结果示例:
任务启动,准备执行阻塞请求...
请求完成,结果为: {'status': 200, 'length': 382}
步骤二:使用自定义 ThreadPoolExecutor 实现资源配额隔离
当系统中存在高频突发任务或特定的大耗时阻塞操作时,如果全部抛入默认全局线程池,很容易耗尽工作线程,导致其他正常的后台任务排队等待。此时必须通过 concurrent.futures.ThreadPoolExecutor 显式指定线程池规格,并借助 loop.run_in_executor() 进行调度:
import asyncio
from concurrent.futures import ThreadPoolExecutor

# 针对重度磁盘 I/O 专设的独立线程池,限制最大并发线程数为 4
disk_io_executor = ThreadPoolExecutor(max_workers=4, thread_name_prefix="disk-io")

def blocking_file_write(filename: str, size_mb: int) -> int:
    # 模拟同步磁盘大文件写入操作
    data = b"X" * (1024 * 1024)
    bytes_written = 0
    with open(filename, "wb") as f:
        for _ in range(size_mb):
            f.write(data)
            bytes_written += len(data)
    return bytes_written

async def safe_disk_operation():
    loop = asyncio.get_running_loop()
    print("向专用磁盘线程池分派写入任务...")

    # 将专用线程池作为第一个参数传入 run_in_executor
    written = await loop.run_in_executor(
        disk_io_executor,
        blocking_file_write,
        "/tmp/temp_test.bin",
        10
    )
    print(f"磁盘写入成功,共写入 {written} 字节")

async def main():
    try:
        await safe_disk_operation()
    finally:
        # 必须在事件循环生命周期结束时妥善关闭线程池
        disk_io_executor.shutdown(wait=True)

if __name__ == "__main__":
    asyncio.run(main())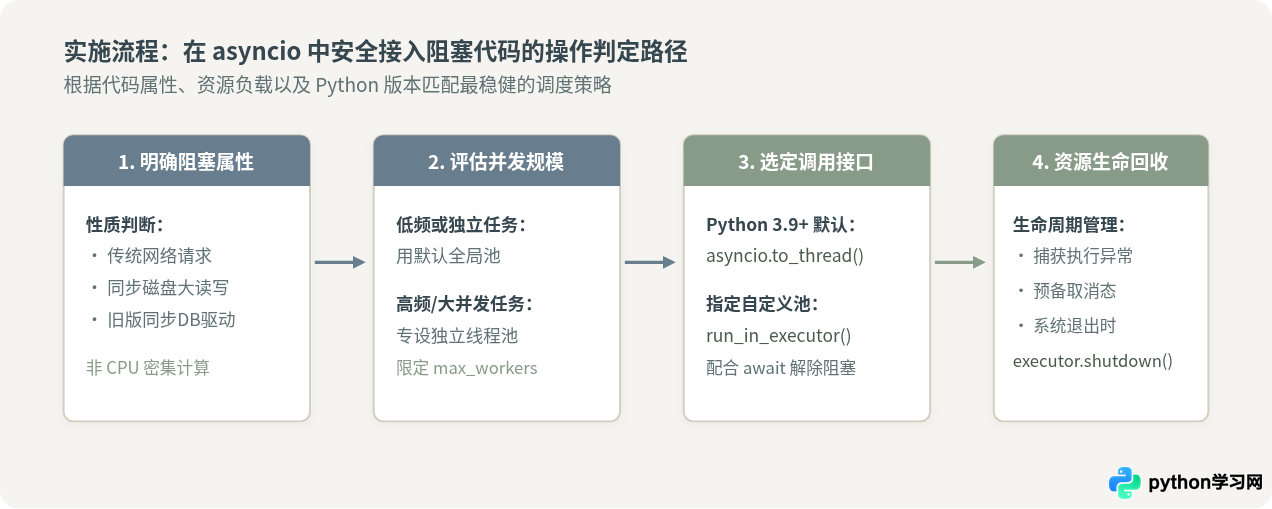
三、关键差异剖析:默认线程池 vs 独立隔离线程池
在实际项目中,许多开发者习惯无条件使用 asyncio.to_thread() 或 loop.run_in_executor(None, func)。这两种写法在底层都依赖事件循环的默认执行器(Default Executor)。为了在工程中做出正确的架构选择,我们需要在相同调用条件下对比默认线程池与独立线程池的关键差异:
| 对比维度 | 默认全局线程池 (asyncio.to_thread) | 显式独立线程池 (ThreadPoolExecutor) |
|---|---|---|
| 线程容量上限 | 通常默认为 min(32, os.cpu_count() + 4),对整个事件循环全局共享。 |
由开发者按需显式指定 max_workers,精准控制并发规模。 |
| 资源隔离性 | 低。若某类高延迟调用占满了所有可用线程,其他不同模块的阻塞调用也会陷入等待队列。 | 高。不同业务使用独立池(如日志写入池、三方支付池),物理隔离,互不争抢。 |
| 上下文变量 (contextvars) | asyncio.to_thread() 会自动快照并同步当前协程的 contextvars 到工作线程。 |
通过 run_in_executor 直接调度时需手动处理上下文传递,否则工作线程读取为空。 |
| 退出销毁控制 | 随着进程退出被隐式回收,难以精确把控在途任务的优雅刷新(Drain)。 | 支持在应用下线钩子中调用 executor.shutdown(wait=True) 确保未完成任务安全落地。 |
为什么这一差异至关重要?
假设应用中包含两个功能:一个是日常的本地日志持久化,另一个是偶尔拉取一个耗时 30 秒的外部报表。如果两个任务都使用默认线程池,当外部报表突发 30 个请求时,默认线程池的工作线程将被瞬间占满。此时,原本仅需 1 毫秒的本地日志写入任务也被迫在队列中等待 30 秒。这种现象被称为线程池饥饿(Thread Starvation)。通过引入独立的 ThreadPoolExecutor,可以为耗时未知的不稳定任务设定严格的并发上限,从而捍卫核心通道的畅通。
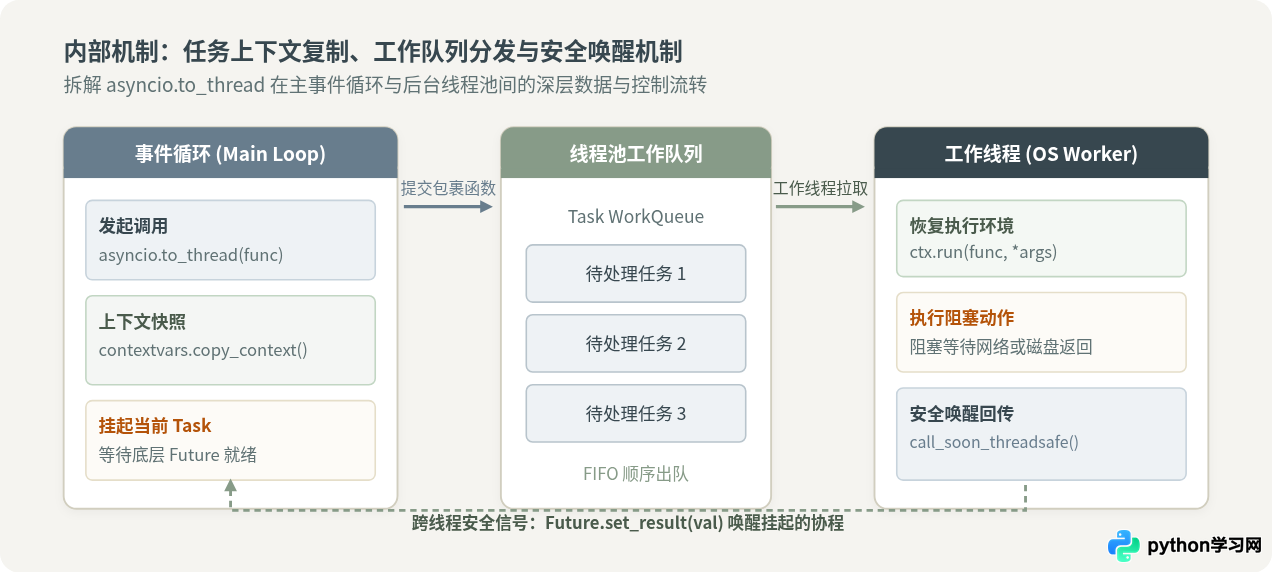
四、关键细节与线程安全边界
将代码移交到多线程执行后,虽然解除了事件循环的冻结,但也正式引入了多线程并发的典型问题。要确保运行过程“绝对安全”,必须严格遵守以下三条边界准则:
1. 严禁从工作线程直接调用非线程安全的 asyncio 接口
当后台线程中的任务执行到特定阶段,需要通知主事件循环(例如触发一个协程或更新状态)时,绝对不能直接调用事件循环中的普通函数或直接操作 asyncio 内部对象。事件循环自身的方法几乎都不是线程安全的。
从工作线程向事件循环发起操作时,必须使用专门提供的跨线程安全方法:
- 调度普通同步回调:使用
loop.call_soon_threadsafe(callback, *args)。 - 向事件循环提交协程并等待结果:使用
asyncio.run_coroutine_threadsafe(coro, loop)。该方法会返回一个标准的concurrent.futures.Future,线程可据此同步等待结果。
错误写法(引发数据竞争与事件循环异常):
def worker(): async_queue.put_nowait(data) # 错误!asyncio.Queue 不是线程安全的
安全写法(使用线程安全入口投递):
def worker(loop, async_queue): loop.call_soon_threadsafe(async_queue.put_nowait, data) # 正确
2. 警惕协程取消(Task Cancellation)的假象
当调用 task = asyncio.create_task(asyncio.to_thread(blocking_func)) 并在稍后执行 task.cancel() 时,虽然主事件循环中的 task 会抛出 asyncio.CancelledError 并结束等待,但后台 OS 线程中的 blocking_func 并不会被强制杀掉。
Python 线程无法被外部强制安全终止。工作线程会继续占用 CPU 或套接字,直到同步函数自然返回。如果该函数持有外部锁或尝试在完成后写入共享状态,必须在代码内部设置协作式标志位(如 threading.Event),或者在主协程妥善处理孤儿线程可能带来的状态污染。
3. 认清 GIL 与 CPU 密集型任务的边界
多线程方案仅适用于 I/O 阻塞型代码(如等待网络、读写磁盘或释放了 GIL 的 C 扩展如 NumPy 密集运算)。如果运行的是 Python 原生的高计算量阻塞代码(如遍历超大字典、复杂 JSON 解构或纯 Python 数学运算),由于全局解释器锁(GIL)的存在,多线程无法利用多核 CPU,反而会因频繁的线程上下文切换加剧事件循环的响应延迟。
面对纯 CPU 密集型阻塞计算,应将执行器替换为 concurrent.futures.ProcessPoolExecutor,将计算任务转移至完全独立的子进程中进行。
五、核心要点总结
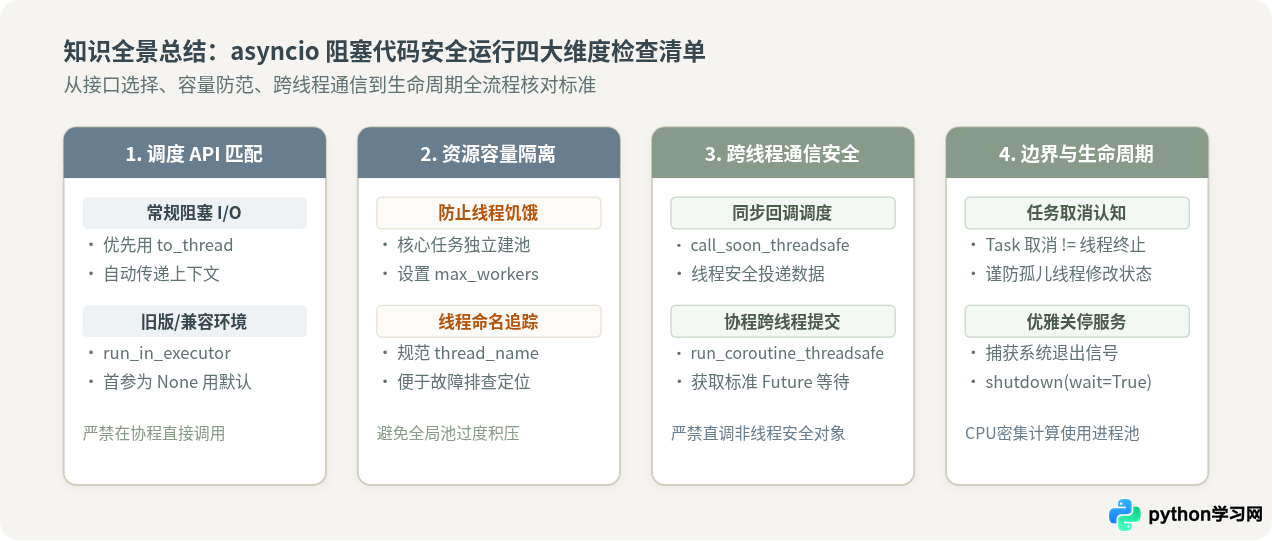
在 Python asyncio 事件循环中安全运行阻塞代码,其本质是在维持事件循环单线程高效调度的前提下,合理利用多线程作为外部缓冲池。完整的安全落地准则可归纳为下方的全景检查图谱:
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









