

Python中break和continue的区别:怎么灵活控制循环流程
深入解析Python中break和continue的核心区别、执行机制与实战场景。配合高清SVG原理图与完整代码示例,掌握列表检索、数据清洗、卫语句扁平化与多层嵌套跳出技巧。
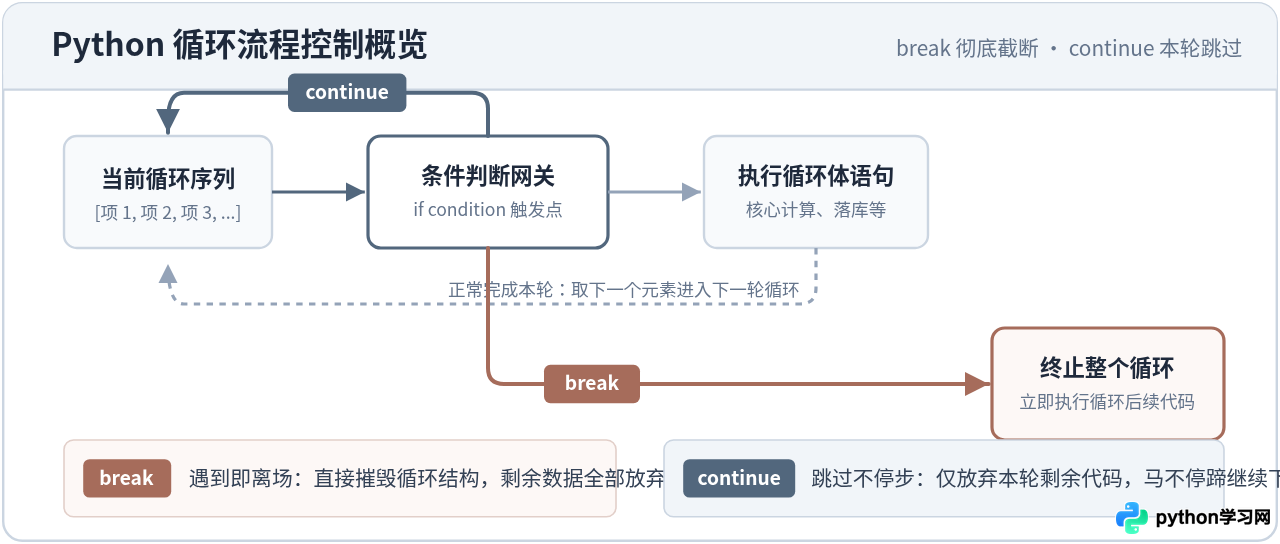
一、核心机制对比:两行指令改变的程序流向
循环的本质,是一个按部就班的状态机。无论是遍历序列的 for 循环,还是基于布尔条件轮询的 while 循环,默认都会执行完循环体内每一行指令,直到整个序列被耗尽或判定条件变为 False 为止。
在实际业务中,我们经常遇到不需要(或不应该)按部就班跑完全程的情况。此时,break 与 continue 就是直接干预迭代步调的两个核心阀门。我们先通过一段简短的代码,观察它们面对完全相同的数据输入时所产生的截然不同的结果:
# 目标数据源
numbers = [10, 20, -5, 30, 40]

print("--- 测试 break 的行为 ---")
for num in numbers:
    if num < 0:
        print(f"遇到负数 {num},立即触发 break!")
        break
    print(f"处理数字: {num}")

print("
--- 测试 continue 的行为 ---")
for num in numbers:
    if num < 0:
        print(f"遇到负数 {num},跳过当前项 continue!")
        continue
print(f"处理数字: {num}")处理数字: 10
处理数字: 20
遇到负数 -5,立即触发 break!
--- 测试 continue 的行为 ---
处理数字: 10
处理数字: 20
遇到负数 -5,跳过当前项 continue!
处理数字: 30
处理数字: 40
从输出中可以清晰看到:在遇到 -5 时,break 导致整个循环戛然而止,排在后面的 30 和 40 完全失去了被访问的机会;而 continue 仅仅舍弃了 -5 本身后续的打印动作,循环序列指针继续右移,30 和 40 依然得到了正常处理。
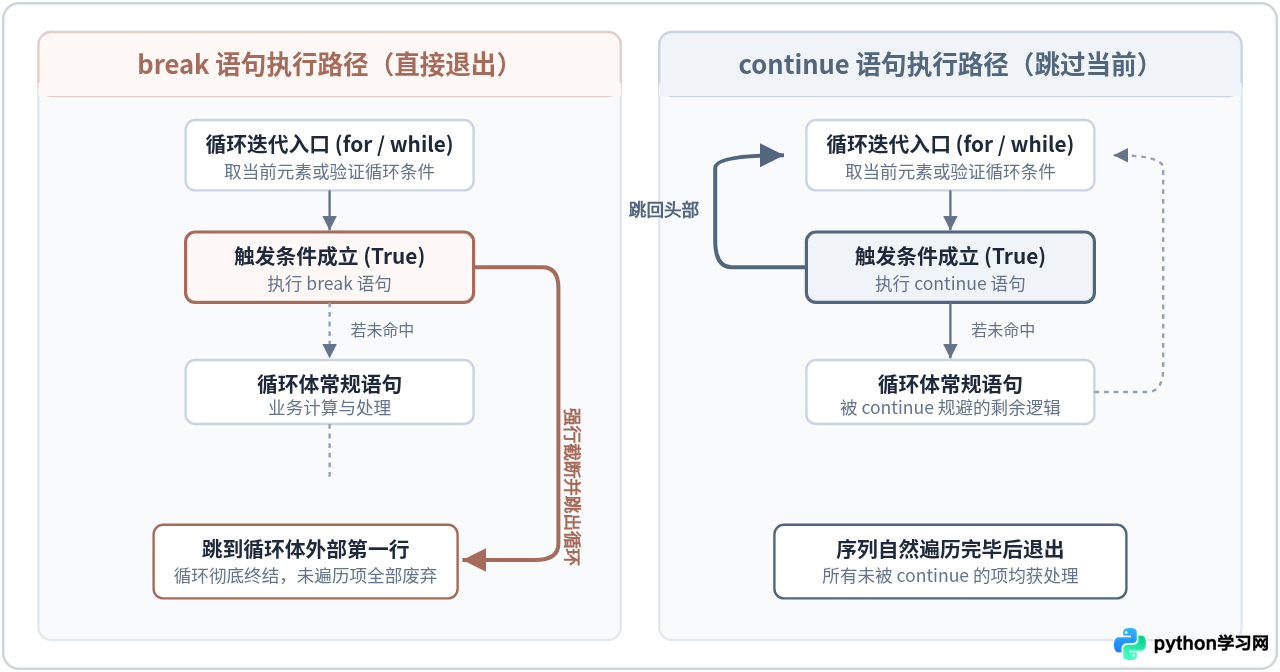
二、break 详解:精准检索与安全熔断
很多新手初写循环时,容易陷入一种机械式思维:既然开了循环,就非得让它把列表里的几万条数据全部扫完。但设想一个真实的业务场景——从数据库或日志列表中查找一个指定 ID 的用户订单。一旦在第 3 条记录命中目标,若任由循环继续空转 9997 次,就是在徒劳消耗 CPU 周期。
1. 目标搜索与提前跳出
break 最经典的用武之地就是“条件检索”。在找到满足特定条件的元素后,立即记录结果并退出循环:
users = [
    {"id": 1001, "name": "张三"},
    {"id": 1002, "name": "李四"},
    {"id": 1003, "name": "王五"},
]

target_id = 1002
found_user = None

for user in users:
    if user["id"] == target_id:
        found_user = user
        print(f"成功找到目标用户: {user['name']}")
        break  # 找到了就立刻终止,不再检查后续用户
else:
    # 只有当循环完整遍历完毕、且未被 break 中断时,才会执行本分支
print(f"未找到 ID 为 {target_id} 的用户")Python 支持在
for 和 while 后面直接附带 else 子句。这里的 else 含义并非“条件不满足”,而是“如果循环正常跑完了全程、中途没有遇到 break,就执行本代码”。一旦循环被 break 强制截断,else 块就会被自动跳过。利用这一特性,我们无需再额外定义 found = False 这样的布尔标记变量,代码更加紧凑利落。
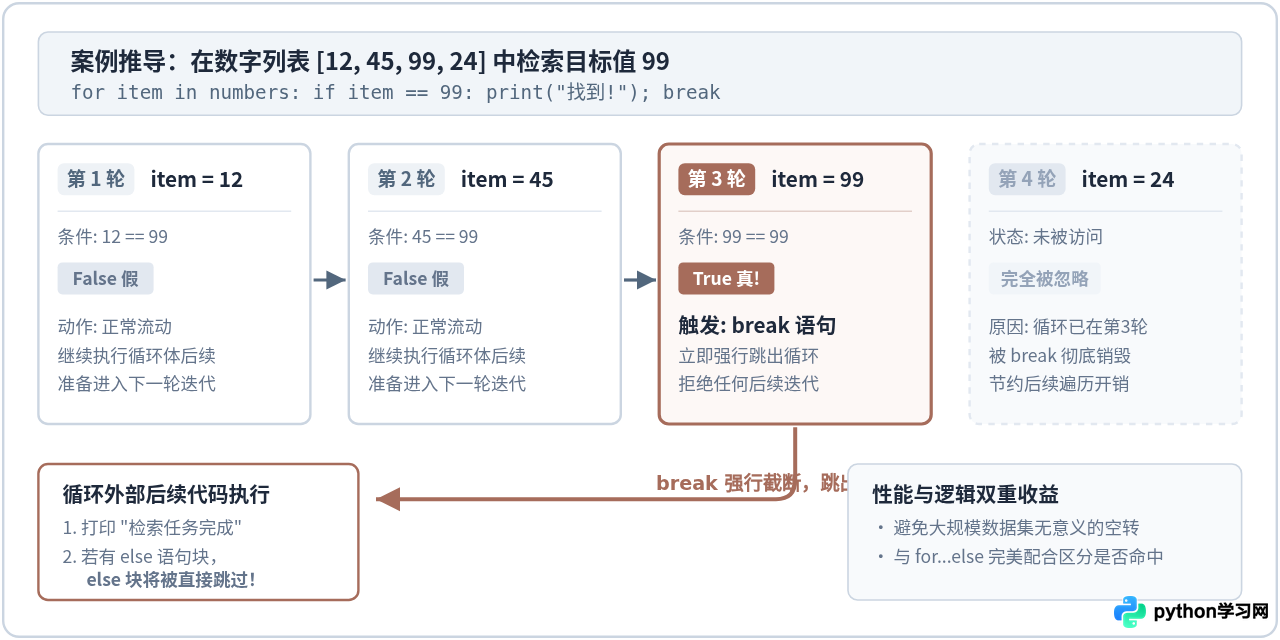
2. while 守护循环的主动退出出口
在网络长连接、命令行交互界面或定时轮询任务中,我们经常使用 while True 构建常驻循环。由于循环条件永远为真,此时 break 充当了唯一的安全防线,通常与退出指令或异常熔断阈值绑定:
# 模拟用户输入流
inputs = ["help", "status", "exit", "metrics"]

for command in inputs:
    # 实际应用中常为 command = input("请输入指令: ")
    print(f"收到指令: {command}")
    if command == "exit":
        print("识别到退出命令,程序安全停止。")
        break
print(f"正在执行指令 [{command}] 的业务逻辑...")正在执行指令 [help] 的业务逻辑...
收到指令: status
正在执行指令 [status] 的业务逻辑...
收到指令: exit
识别到退出命令,程序安全停止。
三、continue 详解:数据清洗与卫语句扁平化
如果说 break 是终结者的重锤,那么 continue 就是精细的过滤器。在批量处理数据时,现实中的数据往往参差不齐,存在空值、格式破损或不需要关注的冗余记录。此时我们不希望终止任务,只希望“跳过坏样本,继续处理好样本”。
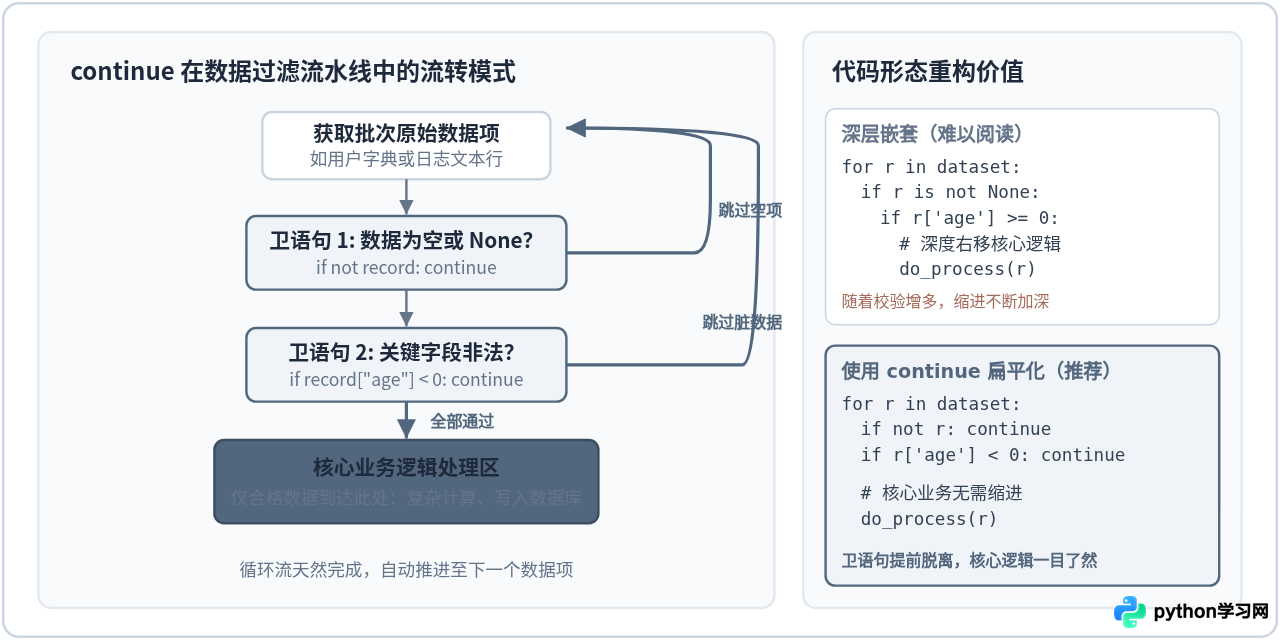
1. 作为“卫语句”消灭深层 if 嵌套
许多初学者编写循环逻辑时,喜欢把所有处理代码都包裹在多层 if 语句内部,导致代码一行行向右滑动,形成所谓的“金字塔代码”。利用 continue 将校验逻辑反转为“卫语句(Guard Clause)”,能够让核心业务代码始终保持在最左侧的清晰缩进层:
raw_records = [
    {"name": "小明", "score": 85, "active": True},
    None,                                     # 脏数据:空对象
    {"name": "小红", "score": -1, "active": True},   # 脏数据:分数异常
    {"name": "小刚", "score": 92, "active": False},  # 业务过滤:未激活
    {"name": "小华", "score": 78, "active": True},
]

processed_count = 0

for record in raw_records:
    # 卫语句 1:剔除空值
    if not record:
        continue

    # 卫语句 2:剔除异常分数
    if record["score"] < 0 or record["score"] > 100:
        continue

    # 卫语句 3:剔除未激活用户
    if not record["active"]:
        continue

    # --- 核心业务处理区:到达此处的必定是合规数据 ---
    print(f"正在为合格用户 [{record['name']}] 录入成绩: {record['score']}")
    processed_count += 1

print(f"处理完成,有效记录共计: {processed_count} 条")正在为合格用户 [小华] 录入成绩: 78
处理完成,有效记录共计: 2 条
2. 致命陷阱:在 while 循环中因 continue 诱发死循环
在 for 循环中,由于迭代器由 Python 内部自动推进,使用 continue 非常安全。但在 while 循环中,若计数器的累加语句位于 continue 之后,极易造成无限循环!这是新手最常踩中的暗坑:
# 【错误写法示范】:会导致死循环挂起!
# count = 0
# while count < 5:
#     if count == 2:
#         continue  # 跳过了下方的 count += 1,count 永远为 2,程序卡死!
#     print(count)
#     count += 1

# 【正确写法示范】:确保自增在判定前或在分支内妥善处理
count = 0
while count < 5:
    count += 1
    if count == 3:
        print("跳过数值 3")
        continue
print(f"当前计数值: {count}")当前计数值: 2
跳过数值 3
当前计数值: 4
当前计数值: 5
for i in range(...)。Python 的 range 生成器会在底层负责游标自增,彻底杜绝因 continue 错位而造成的无限死锁。
四、进阶场景:嵌套循环中的作用边界与多层跳出
在多维数组、矩阵遍历或双重列表匹配中,break 和 continue 有一条极其严格的铁律:它们永远只对“直接包裹它们的当前最内层循环”生效,对外层循环毫无感知。
当我们在内层循环找到了目标,希望连同外层循环一并退出时,单纯写一个 break 只能退出内层,外层依然会继续下一轮迭代。针对多层循环跳出,业界有以下三种典型处理方案:
matrix = [
    [1, 2, 3],
    [4, 99, 6],
    [7, 8, 9]
]
target = 99

# 方案 1(最推荐):封装为独立函数,利用 return 一键退出
def find_in_matrix(mat, val):
    for r_idx, row in enumerate(mat):
        for c_idx, item in enumerate(row):
            if item == val:
                return (r_idx, c_idx)
    return None

coords = find_in_matrix(matrix, target)
print(f"方案1 函数return结果: 坐标在 {coords}")

# 方案 2:借助外层 for...else 与 break 级联传递
found = False
for r_idx, row in enumerate(matrix):
    for c_idx, item in enumerate(row):
        if item == target:
            print(f"方案2 级联break: 找到目标 {item}")
            found = True
            break  # 退出内层
    if found:
break # 检测到标志,退出外层方案2 级联break: 找到目标 99
return)远优于方案 2。它不仅逻辑更纯粹、消除了外部布尔状态变量的污染,还便于针对搜索逻辑单独编写单元测试。
五、选型决策指南与核心差异总结
在决定该使用 break 还是 continue 时,不妨问自己一个核心问题:“这次跳过之后,后续的其他数据还需要继续处理吗?”
- 如果答案是“不需要,整个任务已达到目标或已彻底失败” —— 坚定选用
break。 - 如果答案是“需要,仅仅是当前这一条数据不合规,其余数据还必须继续跑” —— 坚定选用
continue。
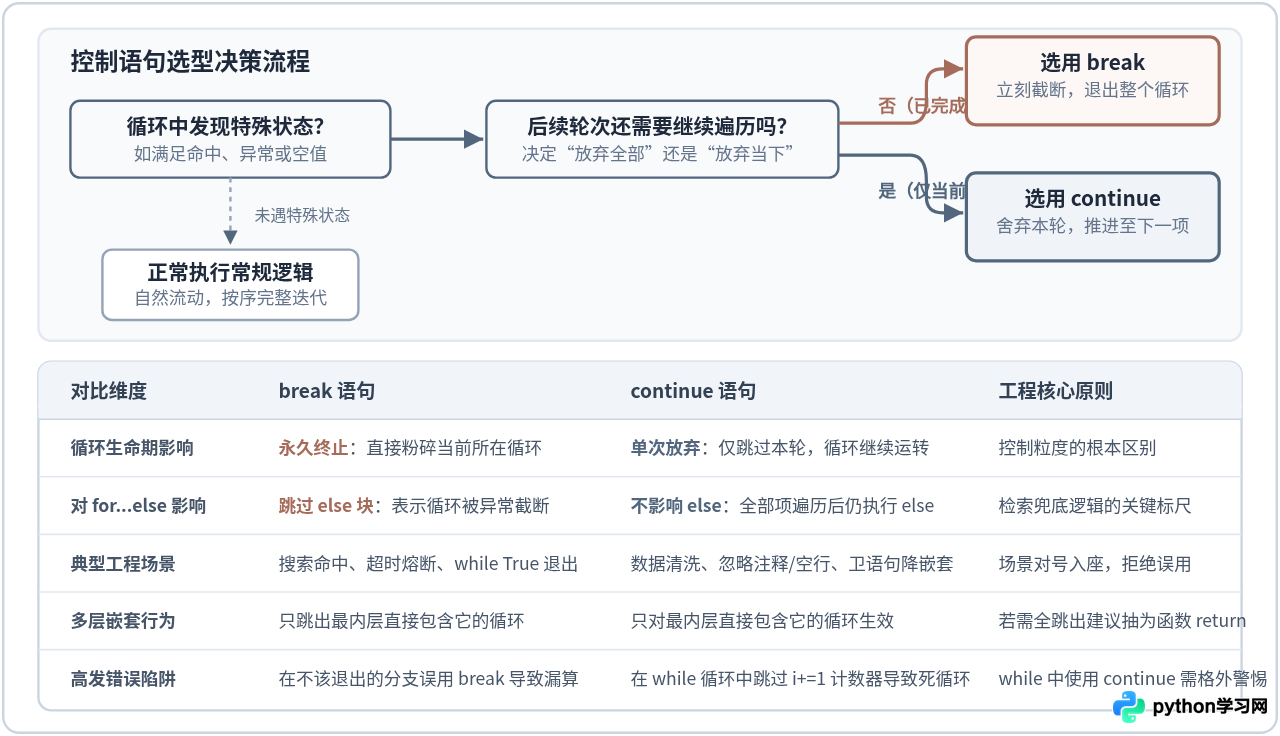
| 比较维度 | break | continue |
|---|---|---|
| 核心动作 | 终结整个循环结构 | 跳过本轮剩余语句,启动下一轮 |
| 作用范围 | 仅限直接包含它的最内层循环 | 仅限直接包含它的最内层循环 |
| 对 for...else 的影响 | 触发中断,跳过 else 块代码 | 不影响遍历完整性,正常执行 else 块 |
| 典型适用场景 | 元素检索命中、超时熔断、while True 退出 | 脏数据过滤、格式筛选、卫语句扁平化 |
| 高频失误风险 | 在需要过滤的场景误用导致后续数据丢失 | 在 while 循环中跳过自增导致无限死循环 |
掌握了 break 与 continue 的本质区别与适用边界,在编写复杂业务处理脚本时,就能随心所欲地驾驭数据流动,使代码在保持高执行效率的同时,具备优异的可读性与工程健壮性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









