

Python字符串替换性能对比:replace、translate与re.sub怎么选

发布时间:2026-10-23| 9人浏览过
核心选型结论:如果替换目标是已知且固定的完整子串,首选
str.replace,它在 C 底层紧凑循环中执行且没有任何编译开销;如果是对多个单个字符做批量替换、字符清洗或符号过滤,果断选用 str.maketrans 配合 str.translate,避免多层链式 replace 造成的重复内存拷贝;只有在需要通配符、字符类范围、大小写模糊匹配或动态回调计算时,才启用 re.sub,且在循环中必须预先编译正则对象以保证性能。
一、核心选型速查与性能特性
在 Python 的日常开发和数据预处理中,文本清洗与字符串替换是极高频的操作。虽然 str.replace()、str.translate() 与 re.sub() 都能实现将文本中特定内容替换为新字符的目的,但它们底层的算法设计和执行路径完全不同,性能差异往往可达数倍乃至几十倍。
| 方法名称 | 底层核心机制 | 单次/多次字符替换 | 模式匹配能力 | 性能层级与开销特征 |
|---|---|---|---|---|
str.replace() |
C 语言底层单趟快速扫描 | 单次单子串极快,多目标需链式调用 | 仅支持确切字面量 | 极快(单子串场景冠军);多层链式时产生多次内存复制 |
str.translate() |
C 底层 256 / 字典映射查表 | 多字符单趟批量映射、过滤删除 | 仅支持单字符到单字符/空 | 批量单字符场景极快;构建转换表有微小初始开销 |
re.sub() |
正则解析引擎与状态机回溯 | 单条复杂模式或批量规则捕获 | 极高(正则、捕获组、回调函数) | 较慢(状态机开销);高频场景需用 re.compile 减少编译损耗 |
二、底层机制与执行差异深度剖析
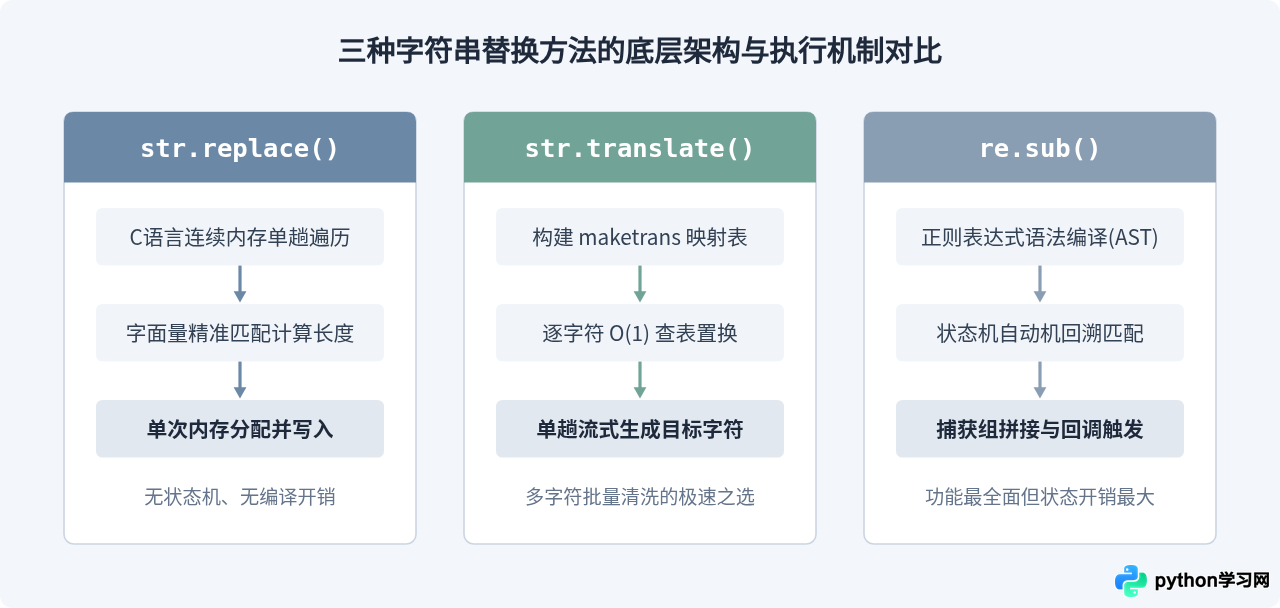
为什么三者的性能表现会有如此显著的断层?根本原因在于 Python 解释器在 C 语言层面对三种方法赋予的任务边界不同:
- str.replace() 的紧凑内存扫描:在 CPython 源码中,
str.replace()针对 ASCII 和宽字符采用高度优化的子串查找算法。当替换目标是确定的短字符串时,算法直接在连续内存块上定位偏移量,一次性计算新字符串所需的总字节数并分配内存,随后将匹配段与替换内容快速拷贝至目标内存区。整个过程没有解释器层面的额外语法解析,分支预测命中率极高。 - str.translate() 的直接查表算法:该方法由
str.maketrans()先构造一个转换字典(或长度为 256 的 ASCII 转换表)。在执行translate()时,C 语言底层遍历输入字符串的每一个字符代码点,直接在转换表中做一次 $O(1)$ 复杂度的查找并输出结果。无论你要同时替换 3 个还是 20 个不同的字符,都只需遍历原字符串一遍即可全部完成。 - re.sub() 的状态机与回溯:正则表达式需要先将模式表达式编译成字节码指令,并在匹配过程中启动有限状态自动机(NFA/DFA)。遇到量词、分支结构或字符组时,引擎还需要进行匹配试探与回溯;如果替换参数是函数,每次匹配成功还必须向 Python 虚拟机触发一次函数调用栈。因此在简单字符串替换场景下,正则引擎的调度开销远大于实际替换操作本身。
三、性能基准测试与操作步骤
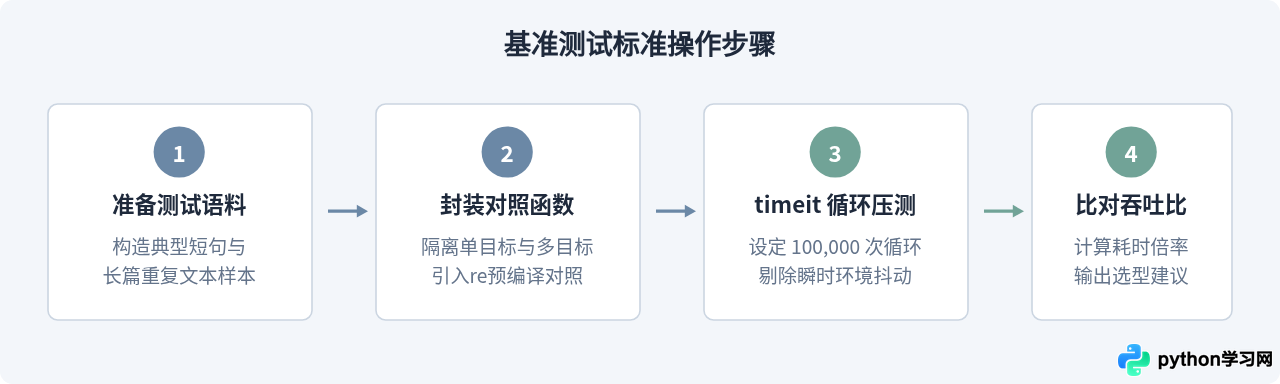
为了直观验证三种方法在不同场景下的耗时表现,我们通过标准库模块 timeit 构建一个基准测试实验。按照以下四个步骤可以在本地复现测试过程:
测试脚本实现代码
以下是使用标准库 timeit 模块编写的完整测试脚本:
import timeit
import re

# 1. 准备测试文本(约 1KB 的模拟数据)
raw_text = "The quick brown fox jumps over the lazy dog. 2026-10-20, user_id=98721; " * 15

# 场景 A:单个固定子串替换(将 "dog" 替换为 "cat")
def test_replace_single():
    return raw_text.replace("dog", "cat")

pattern_dog = re.compile(r"dog")
def test_resub_compiled():
    return pattern_dog.sub("cat", raw_text)

def test_resub_direct():
    return re.sub(r"dog", "cat", raw_text)

# 场景 B:批量字符清理(清洗标点符号与特殊字符:. , - ; = _)
trans_table = str.maketrans(".,-;=_", "      ")
def test_translate_batch():
    return raw_text.translate(trans_table)

def test_replace_chained():
    return (raw_text.replace(".", " ")
                    .replace(",", " ")
                    .replace("-", " ")
                    .replace(";", " ")
                    .replace("=", " ")
                    .replace("_", " "))

pattern_punct = re.compile(r"[.,\-;=_]")
def test_resub_batch():
    return pattern_punct.sub(" ", raw_text)

# 执行压测(每项运行 50,000 次)
runs = 50000
print("--- 场景 A:单目标字面量替换 ---")
print("str.replace:        ", timeit.timeit(test_replace_single, number=runs))
print("re.sub (预编译):     ", timeit.timeit(test_resub_compiled, number=runs))
print("re.sub (未编译直接调用):", timeit.timeit(test_resub_direct, number=runs))

print("\n--- 场景 B:多字符批量替换/清洗 ---")
print("str.translate:      ", timeit.timeit(test_translate_batch, number=runs))
print("链式 replace (6层):   ", timeit.timeit(test_replace_chained, number=runs))
print("re.sub 字符集替换:    ", timeit.timeit(test_resub_batch, number=runs))
测试结果分析
在常规 64 位 x86/ARM 平台 Python 3.11+ 环境下,上述代码的典型耗时比例表现如下:
- 在单目标替换场景中:
str.replace遥遥领先,耗时通常只有re.sub(预编译)的 $\frac{1}{3} \sim \frac{1}{4}$,更是未预编译re.sub的 $\frac{1}{8}$。这表明在无模式匹配需求时,引入正则只会带来无谓的计算开销。 - 在多字符清洗场景中:
str.translate展现出统治级性能,耗时通常仅为 6 层链式replace的 $\frac{1}{4} \sim \frac{1}{6}$,比使用[.,\-;=_]字符集的re.sub快近 10 倍。
四、链式 replace 的性能陷阱与 translate 的内存优势
很多开发者在需要替换多个字符时,容易顺手写出形如 text.replace('a', '1').replace('b', '2').replace('c', '3') 的链式调用。在文本较短或调用频次极低时,这种写法逻辑直观;但在高并发 Web 服务或大数据离线清洗中,它会引发严重的内存抖动与时间复杂度劣化。
内存陷阱成因:Python 中的
str 对象是不可变对象(Immutable)。每一次 replace() 调用,都必须开辟一块全新的内存缓冲区,将原字符串扫描一遍,并将结果完整复制进新对象。若链式调用执行了 6 次,整篇文本就会被完整遍历 6 次,同时中途产生了 5 个随生随灭的中间临时字符串,极大加重了垃圾回收器(GC)的内存分配压力。
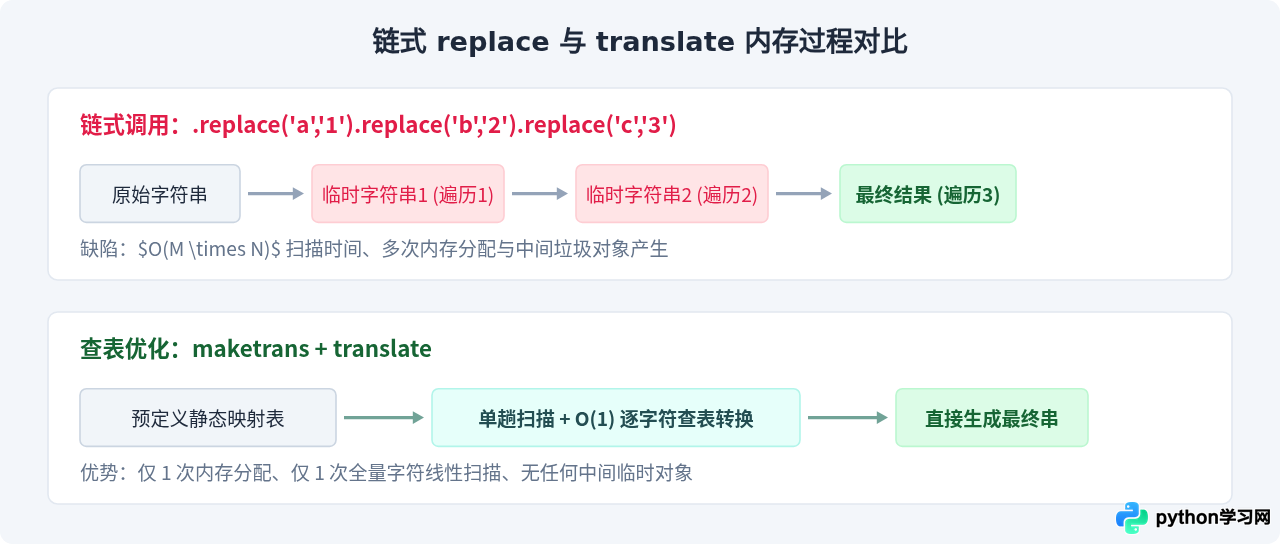
相比之下,str.translate 只在最初调用 str.maketrans 时建立一个映射表。随后的替换操作全程在 C 语言层面仅做单次线性扫描,一次性生成最终结果,彻底避免了多次分配缓冲区的消耗。
五、re.sub 的正确定位与预编译建议
尽管 re.sub 在字面量替换上速度垫底,但这并不意味着它缺乏应用价值。它的核心价值体现在规则抽象能力与动态变换灵活性:
- 动态计算与回调函数:
re.sub允许传入函数作为替换对象(repl参数)。例如需要将文本中所有匹配的华氏温度动态转换为摄氏温度、或将 Markdown 图片链接提取重新组装时,这是内置字符串方法无法做到的。 - 边界匹配与忽略大小写:匹配单词边界
\bcat\b,避免将category错误替换;或者开启re.IGNORECASE忽略大小写替换,此时使用replace往往需要拆解多次。 - 预编译优化(re.compile):如果在循环或频繁调用的函数中使用
re.sub,务必将正则模式提出至模块顶级作用域预先编译。虽然 Python 内部有对最近正则模式的缓存机制,但直接使用编译好的Pattern对象可以彻底消除查缓存与模式解析的额外 Python 函数栈调用。
六、全场景选型决策指南
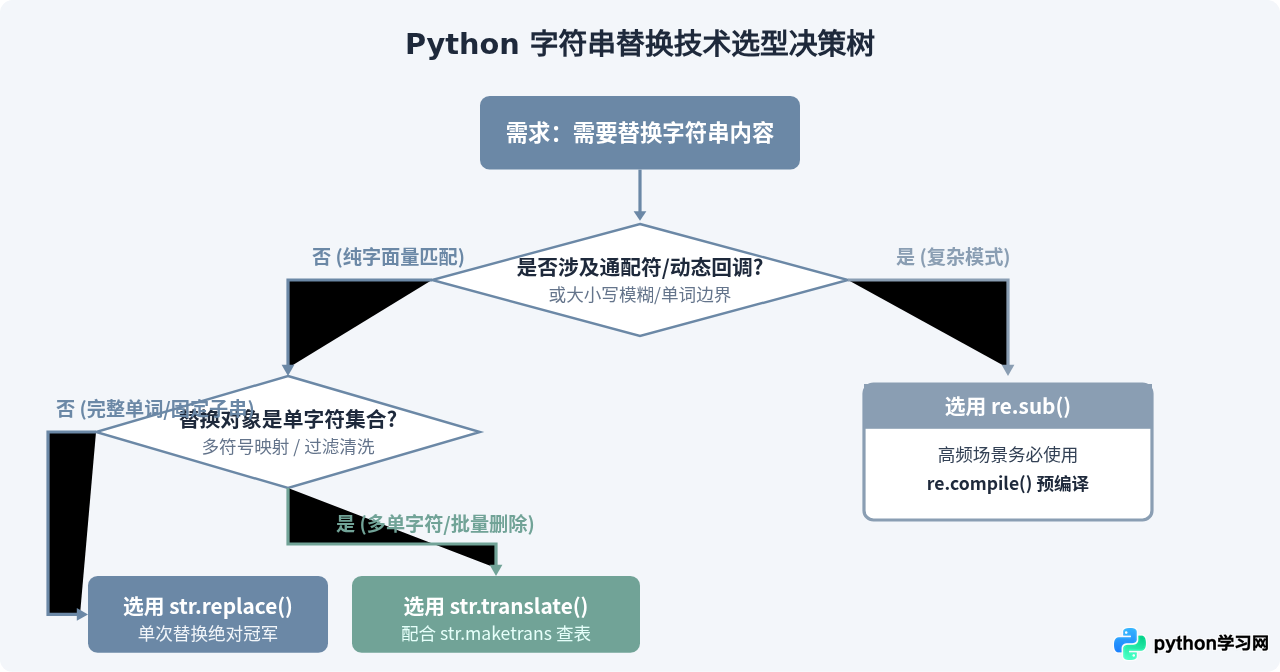
面对具体的工程需求,可以按照以下决策流程快速选定最优方法:
七、工程实践避坑清单
- 不要盲目追求一行代码:很多人习惯用正则单行解决问题,但在无需正则特性的简单替换中滥用
re.sub,不仅会让代码难以阅读,还会白白消耗数倍的 CPU 时间。 - 静态初始化转换表:使用
str.translate时,不要在循环体内部反复执行str.maketrans()。应将TABLE = str.maketrans(...)定义为模块常量或类属性,让多轮调用共享同一个已编译转换表。 - 注意不可变特性与返回值接收:初学者常犯错误
text.replace("old", "new")而不接收返回值。Python 字符串的任何替换方法都不会就地修改原字符串,必须显式赋值text = text.replace(...)。 - Unicode 多字节字符替换:
str.maketrans字典形式天然支持 Unicode(支持字符到字符串或None的映射,None代表删除该字符)。若需要批量剔除全角空白、隐藏控制字符或多语言标点,translate同样兼具极高速度与高准确度。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









