

Python怎么只替换字符串中第N次出现的字符?

在 Python 开发中,字符串自带的 str.replace(old, new, count) 方法只能限制替换的“最大次数”,即从前往后按顺序替换前 count 次,却无法直接指定“跳过前 N-1 次、只替换第 N 次”。要精准替换第 N 次出现的字符或子串,通常有两种高效实用的途径:一是利用 split() 将字符串按目标字符切片,再通过切片与 join() 精确重组;二是利用循环 find() 找到第 N 次出现的目标起始下标,再借助切片拼接完成替换。如果遇到需要模式匹配的复杂场景,还可以借助标准库 re.sub() 配合闭包计数器来实现。
一、认识原生 str.replace() 的能力边界与常见误区
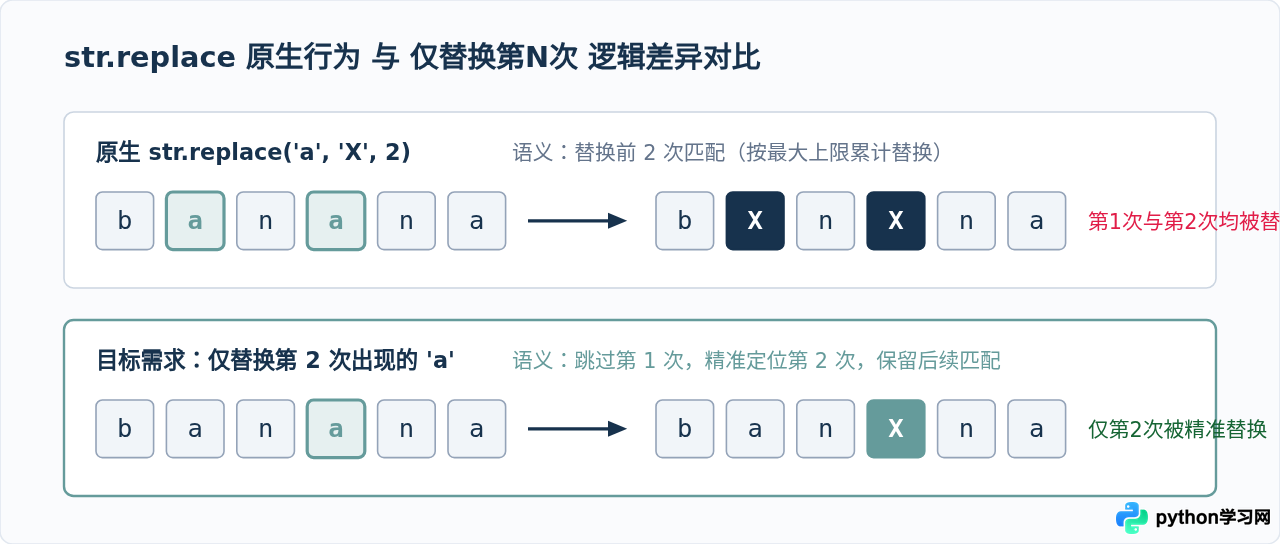
许多初学者在遇到这个问题时,容易对 str.replace() 的第三个参数产生误解。官方规范中,str.replace(old, new[, count]) 的 count 参数含义是“最多替换多少次”(maximum occurrences to replace)。
例如执行以下代码:
text = "banana"
result = text.replace("a", "X", 2)
print("示例输出:", result)
实际控制台输出:
示例输出: bXnXna可以看到,第 1 次和第 2 次出现的 'a' 全部被改成了 'X'。原生方法并不支持类似“只改第 2 个,前后的都不变”的语义。如果我们的需求是将 "banana" 中第 2 次出现的 'a' 替换为 'X'(预期得到 "banXna"),就必须使用专门的切分或定位逻辑。
二、方法一:使用 split() 与列表切片(最推荐、最简明)
处理中小长度字符串时,最优雅的解法是使用 str.split()。当一个字符串被目标子串切分后,原本存在目标字符的位置正好构成了切片列表各元素之间的“缝隙”。
假设我们要替换第 N 次出现的字符:
- 调用
text.split(old)得到一个片段列表parts。 - 检查列表长度:如果目标字符出现了
K次,切分后必然产生K + 1个片段。因此只要len(parts) > N,就说明目标字符至少出现了 N 次。 - 前
N个片段(即parts[:N])之间依然使用原始的old重新连接。 - 第
N个缝隙正是我们要修改的位置,插入新字符new。 - 剩下的片段(即
parts[N:])同样用原始的old重新连接。
def replace_nth_split(text, old, new, n):
    """使用 split 与切片拼接替换第 n 次出现的子串"""
    if n <= 0:
        return text
    parts = text.split(old)
    # 出现的次数等于 len(parts) - 1,不足 n 次则直接返回原文本
    if len(parts) <= n:
        return text
    return old.join(parts[:n]) + new + old.join(parts[n:])

# 运行测试
sample = "apple#banana#cherry#date"
out = replace_nth_split(sample, "#", "@", 2)
print("示例输出:", out)
实际控制台输出:
示例输出: apple#banana@cherry#date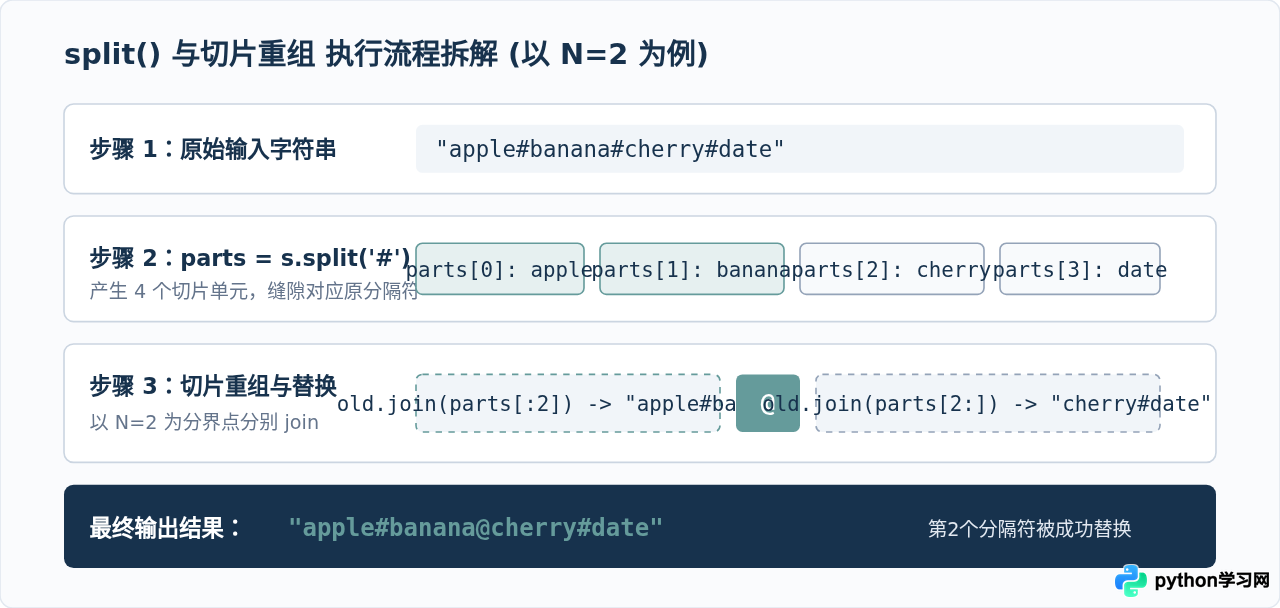
"#")还是多个字符的子串(如 "---")均完全有效,且底层由 Python 内部优化实现,代码仅需 3 行核心逻辑,易读性极高。
三、方法二:使用循环 find() 定位下标(超长文本低内存方案)
如果待处理的文本非常巨大(例如几百兆的日志文件或大文本),split() 会把整段字符串切分成大量小字符串对象并存入列表,带来明显的额外内存开销。
此时,使用 str.find() 沿原字符串向前推进游标定位索引是性能最优的解法。其核心逻辑如下:
- 初始化检索起始位置
start = 0。 - 循环执行
n次:每次调用text.find(old, start)。 - 如果某一次返回
-1,说明目标字符出现次数未达到n次,直接返回原字符串。 - 否则更新下一次检索起点为
start = idx + len(old)。 - 当循环走完
n次时,最后的idx就是第n次出现的目标起始下标。 - 通过切片拼接:
text[:idx] + new + text[idx + len(old):]。
def replace_nth_find(text, old, new, n):
    """通过循环 find 定位第 n 次出现的下标并切片替换"""
    if n <= 0 or not old:
        return text
    start = 0
    idx = -1
    for _ in range(n):
        idx = text.find(old, start)
        if idx == -1:
            return text  # 出现次数不足 n 次
        start = idx + len(old)
    # 利用下标切片完成精准替换
    return text[:idx] + new + text[idx + len(old):]

# 运行测试
log_line = "2026-10-14 13:30:00 [INFO] test-step-run-done"
res = replace_nth_find(log_line, "-", "_", 3)
print("示例输出:", res)
实际控制台输出:
示例输出: 2026-10-14 13:30:00 [INFO] test_step-run-done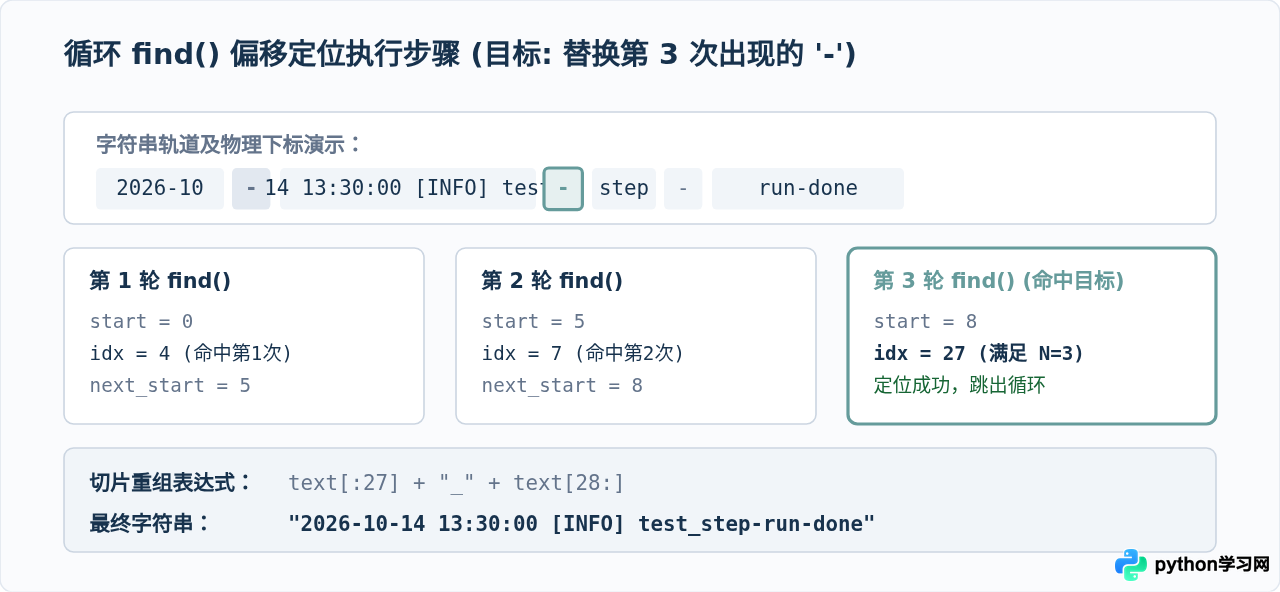
四、方法三:使用 re.sub() 与闭包计数(模式匹配场景)
前两种方法均适用于固定的字符或子串替换。如果替换目标不是固定文本,而是一种正则模式(例如:仅替换文本中出现的“第 3 个纯数字”,或者“第 2 个邮箱地址”),则应当使用标准库 re 模块中的 re.sub() 搭配替换回调函数。
re.sub(pattern, repl, string) 允许 repl 传入一个接收 Match 对象的函数。在该函数内部通过一个外部计数器(闭包或对象属性)记录匹配次数:
- 未达到第 N 次时,返回
match.group(0)(保持原文本不变)。 - 恰好达到第 N 次时,返回替换后的新内容
new。 - 超过第 N 次后,同样返回
match.group(0)。
import re

def replace_nth_regex(pattern, new, text, n):
    """使用正则表达式与计数回调替换第 n 次匹配的内容"""
    if n <= 0:
        return text
    count = 0

    def replacer(match):
        nonlocal count
        count += 1
        if count == n:
            return new
        return match.group(0)

    return re.sub(pattern, replacer, text)

# 场景:仅替换第 2 个数字包
raw_content = "ID: 100, Score: 85, Rank: 3"
res_regex = replace_nth_regex(r"\d+", "999", raw_content, 2)
print("示例输出:", res_regex)
实际控制台输出:
示例输出: ID: 100, Score: 999, Rank: 3可以看到,第 1 个数字 100 与第 3 个数字 3 均完好保留,唯独第 2 个数字 85 被精准替换成了 999。
五、工程化封装:通用安全的 replace_nth() 函数
在实际项目中,我们通常希望一个函数兼具健壮性、易用性与边界安全。下面将结合前面的分析,给出一个经过全面防御性校验的工程通用函数:
def replace_nth(text: str, old: str, new: str, n: int = 1) -> str:
    """
    仅替换字符串中第 n 次出现的指定字符或子串。

    参数:
        text: 原始字符串
        old: 需要被替换的字符或子串
        new: 替换后的新内容
        n: 目标出现的序号(从 1 开始计)

    返回:
        替换后的字符串;若 n <= 0、old 为空或出现次数不足 n,则返回原字符串
    """
    if not isinstance(text, str) or not isinstance(old, str) or not isinstance(new, str):
        raise TypeError("输入参数 text, old, new 必须为字符串类型")
    if n <= 0 or not old or not text:
        return text

    parts = text.split(old)
    if len(parts) <= n:
        return text

    return old.join(parts[:n]) + new + old.join(parts[n:])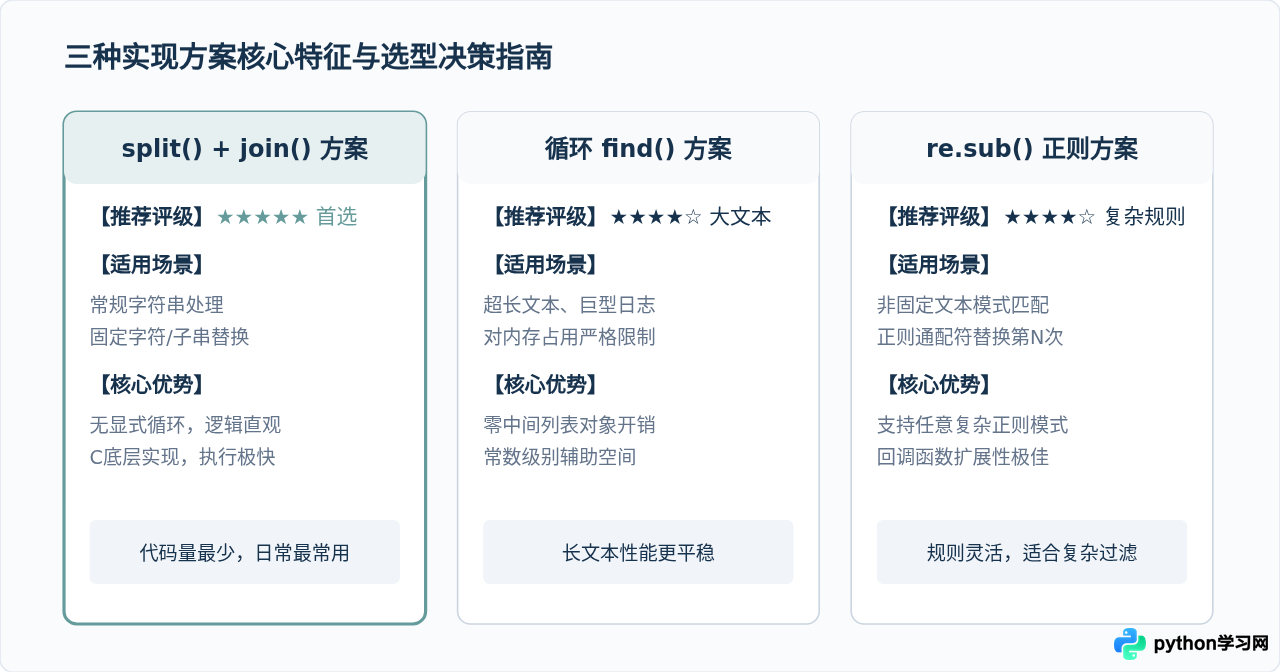
六、关键注意事项与避坑指南
- 牢记字符串的不可变性(Immutability):Python 中的
str对象在创建后内容不可更改。无论是replace()、切片还是join(),都只会生成并返回一个新的字符串对象,绝不会在原地修改变量。因此调用后必须显式赋值接收返回值,例如s = replace_nth(s, "old", "new", 2)。 - N 的边界与非法输入处理:传入
n <= 0时按业务逻辑应当视作无需替换或非法参数,通常直接返回原字符串;当old在原文本中出现的实际总次数小于n时,也应保证平稳退化返回原文本,避免报IndexError。 - 多字符子串切片长度计算:在使用基于下标的切片方法时(方法二),切片右边界必须使用
idx + len(old),切勿硬编码为idx + 1,否则一旦old包含 2 个及以上字符,会导致切片长度不匹配而产生内容截断错位。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









