

Python没有结构体?用dataclass实现类C数据聚合
深入解析如何在Python中利用标准库dataclass实现类C语言结构体的高效数据聚合。从原理剖析、样板代码消除到内存优化与避坑指南,全面掌握现代Python数据结构设计。
struct 的开发者初入 Python 往往会感到困惑:Python 原生并没有名为 struct 的纯数据聚合类型语法。直接使用普通类样板代码冗长,使用字典缺乏类型提示与静态安全,而内置元组又缺少字段语义。本文将直接展示如何利用 Python 标准库的 dataclass 构建轻量、具备静态类型注解且语法严谨的类 C 结构体,并剖析其核心运行机制与内存优化方案。
1. 问题的由来:Python 常见数据聚合方式的困境
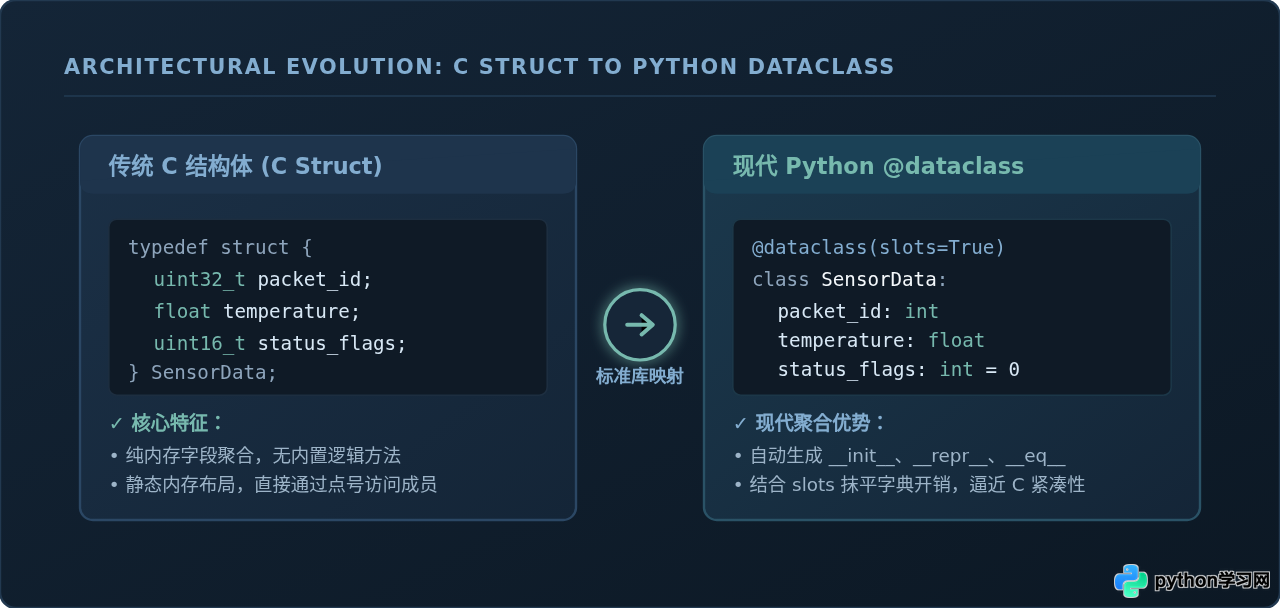
假设我们正在开发一个工业物联网数据采集模块,每秒需接收数万条包含传感器编号、时间戳、测量值及运行状态的数据包。在 C 语言中,一个 struct SensorRecord 可以干净利落地声明所有字段,既没有冗余的代码,也不会带来额外的调用包袱。
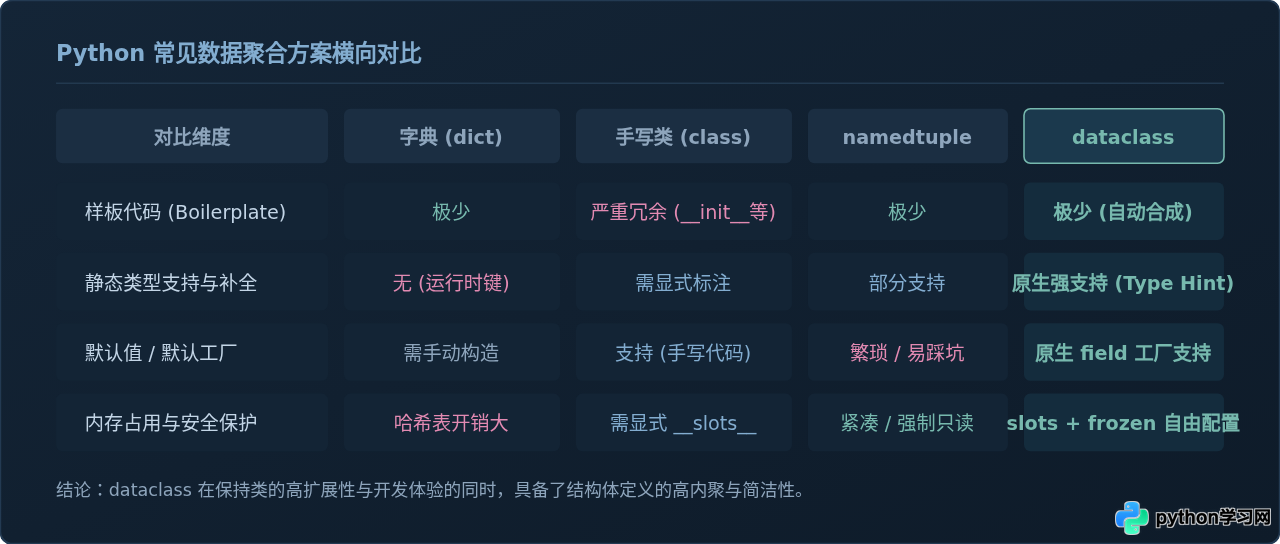
而在 Python 实践中,初学者通常会经历以下三种尝试,但各自都存在明显的工程缺陷:
- 使用基础字典 (dict):
data = {"id": 101, "temp": 36.5}。字典使用灵活,但无法享受 IDE 的自动补全与类型推导;字段名拼写错误(例如将temp错写为temprature)只能在运行时暴露,且每个字典实例都需要维护哈希表结构,内存占用高。 - 使用普通类 (class):定义类并手写
def __init__(self, id, temp): self.id = id...。这种方式不仅充满了机械重复的样板赋值,若想打印友好的调试日志,还需手动重写__repr__;若要比较两个实例属性是否相等,还需重写__eq__。 - 使用命名元组 (namedtuple):
namedtuple解决了点号访问和字段命名问题,但由于元组底层不可变特性,其无法优雅设置默认工厂、难以支持严谨的继承结构,且其索引遍历特性容易导致语义模糊。
2. 原理解析:@dataclass 底层是如何工作的?
dataclass 本质是一个类装饰器(Class Decorator)。它并不修改 Python 虚拟机的字节码解释规则,而是在类对象初次定义加载时,通过反射与类型注解解析完成自动合成。
其具体生成流水线如下:
- 收集字段注解:检查类对象的
__annotations__字典,按书写顺序收集每一个带有类型提示的属性名称。 - 动态构造函数签名:根据声明的字段名、默认值以及
field()的元数据,在内存中动态拼接__init__函数源码字符串。 - 字节码编译与注入:调用
exec()将函数源码编译为字节码对象,随后注入到类的命名空间(__dict__)中。 - 生成配套辅助方法:根据参数配置,同步注入可打印的
__repr__、逐字段对比的__eq__,以及排序比较方法(__lt__,__le__等)。
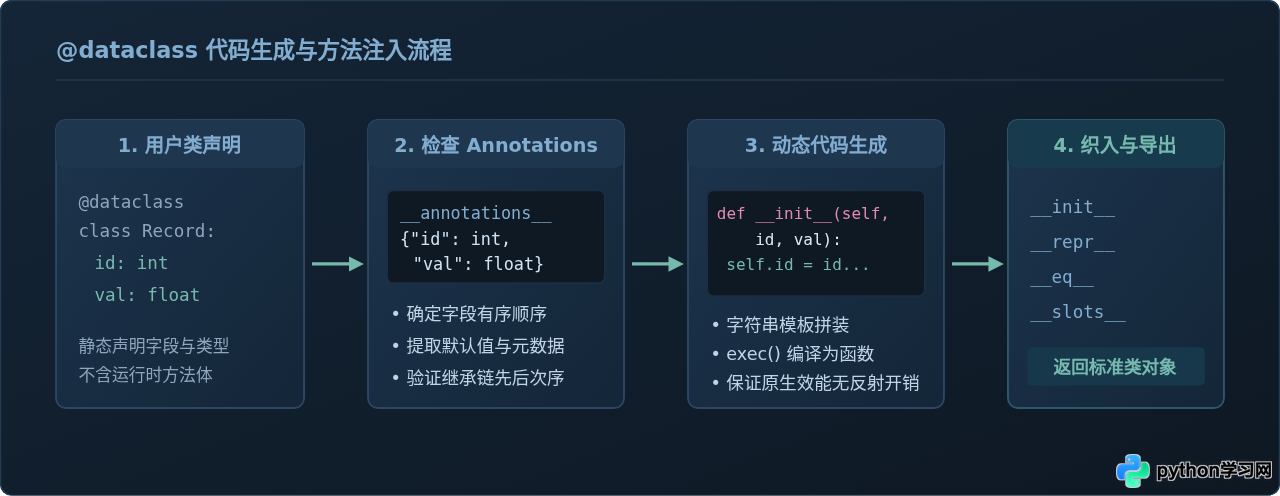
这意味着:实例在运行时的属性访问速度与手写 __init__ 完全一致。它不是在运行时通过 __getattr__ 进行动态代理拦截,而是在类定义完毕的瞬间,就已经拥有了高效的原生方法。
3. 实践步骤:构建健壮的“类 C 结构体”
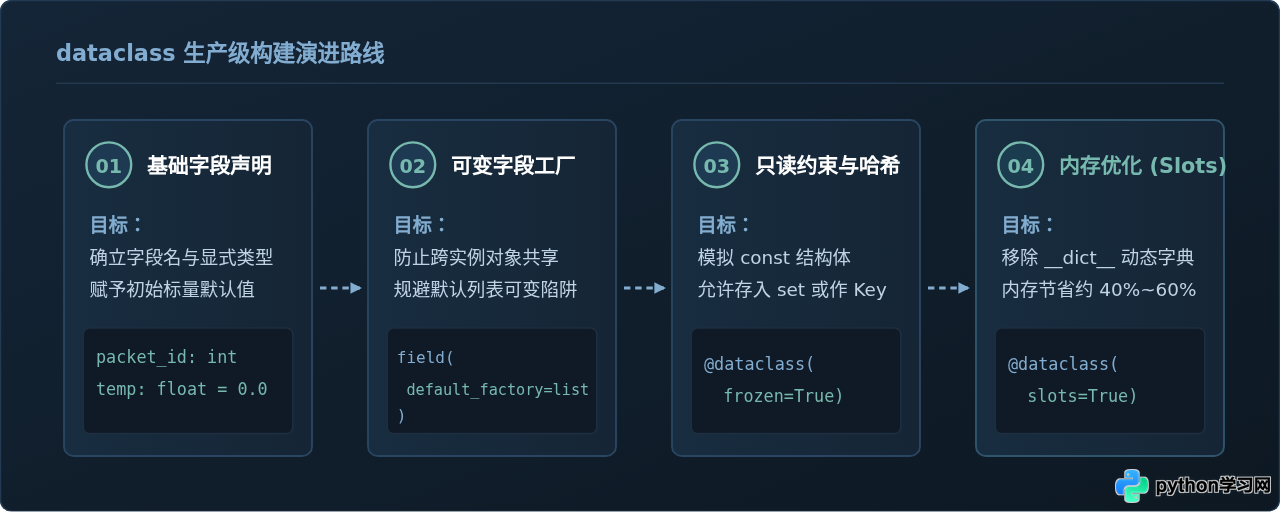
要用 dataclass 完整替代 C 结构体并适配工业级 Python 开发规范,建议按照以下四个步骤递进配置:
步骤 1:声明基础字段与类型注解
在 Python 中,所有用于生成结构体的字段都必须显式附带类型注解(哪怕只是 typing.Any)。未添加注解的类属性会被视为普通类变量,而不会被纳入实例初始化参数。
from dataclasses import dataclass

@dataclass
class SensorPacket:
    packet_id: int
    temperature: float
    humidity: float
    status_code: int = 0  # 标量默认值必须置于无默认值字段之后

# 示例调用
packet = SensorPacket(packet_id=1, temperature=24.5, humidity=60.2)
print(packet)
# 输出示例: SensorPacket(packet_id=1, temperature=24.5, humidity=60.2, status_code=0)
步骤 2:使用 default_factory 规避可变默认值陷阱
若结构体中包含数组、列表或字典等可变容器,千万不能直接赋默认值 tags: list = []。这在 Python 中会导致所有实例共享同一个内存列表对象。dataclass 在导入时会直接对此类写法抛出 ValueError,强制要求使用 default_factory:
from dataclasses import dataclass, field
from typing import List

@dataclass
class DeviceConfig:
    device_id: str
    # 必须通过 default_factory 提供独立构造工厂
    channels: List[int] = field(default_factory=list)
    metadata: dict = field(default_factory=dict)
步骤 3:模拟 C 语言 const 结构体(只读与哈希)
如果希望聚合的数据在实例化后不可篡改(类似于 C 中的常量指针或只读缓冲区),只需在装饰器中指定 frozen=True。一旦设置,任何对属性的修改操作都会触发 FrozenInstanceError。此外,只读结构体还会自动生成 __hash__ 方法,允许作为字典的 Key 或存入 set 集合:
@dataclass(frozen=True)
class Point3D:
    x: float
    y: float
    z: float

pt = Point3D(1.0, 2.0, 3.0)
# pt.x = 5.0  # 抛出 dataclasses.FrozenInstanceError: cannot assign to field 'x'
coordinate_cache = {pt: "Target_Alpha"}  # 可安全作为字典键
步骤 4:启用 slots=True 抹平内存差距(Python 3.10+)
传统 Python 类每个实例都持有一个动态字典 __dict__,用于支持随时随地动态绑定新属性。但结构体本质上是固定字段聚合,额外的 __dict__ 不仅浪费空间,还会拉低属性读写速度。自 Python 3.10 起,只需声明 @dataclass(slots=True),即可自动为类生成 __slots__,将属性以类似 C 紧凑数组指针的方式固定,不仅内存占用减少约 50%,还禁止了随意注入未定义属性的行为。
4. 容易踩坑的关键细节与排错指南
Python 函数参数语法规定:非默认参数不能跟随在默认参数之后。在 dataclass 中,子类继承同样遵循此规则。若父类中已有带默认值的字段,子类新增的非默认字段将会引发 TypeError。解决方法是将子类字段也赋予默认值,或使用 Python 3.10 引入的 kw_only=True 强制仅限关键字传参。
packet_id: int 仅在静态分析阶段(如 Mypy、Pyright)或 IDE 中提供警告,在运行时如果传入字符串 packet_id="ABC",标准 dataclass 默认不会报错。如果业务场景需要强制类型拦截,可以在 __post_init__ 钩子函数中执行断言校验,或者直接采用更重型的 Pydantic 数据模型。
不要混淆 dataclass 与标准库中的 import struct:struct 模块专注于二进制字节流(bytes)与 Python 原生类型(int, float)之间的打包和解包;而 dataclass 是在业务逻辑层实现面向对象的数据聚合。两者通常配合使用:先用 struct.unpack 解析原始字节,再将其装入 dataclass 实例中使用。
5. 总结与选型决策指南
Python 并非“没有结构体”,而是通过 dataclass 提供了更高阶、更安全的声明式聚合机制。在面临不同场景时,可以通过下图快速选型:
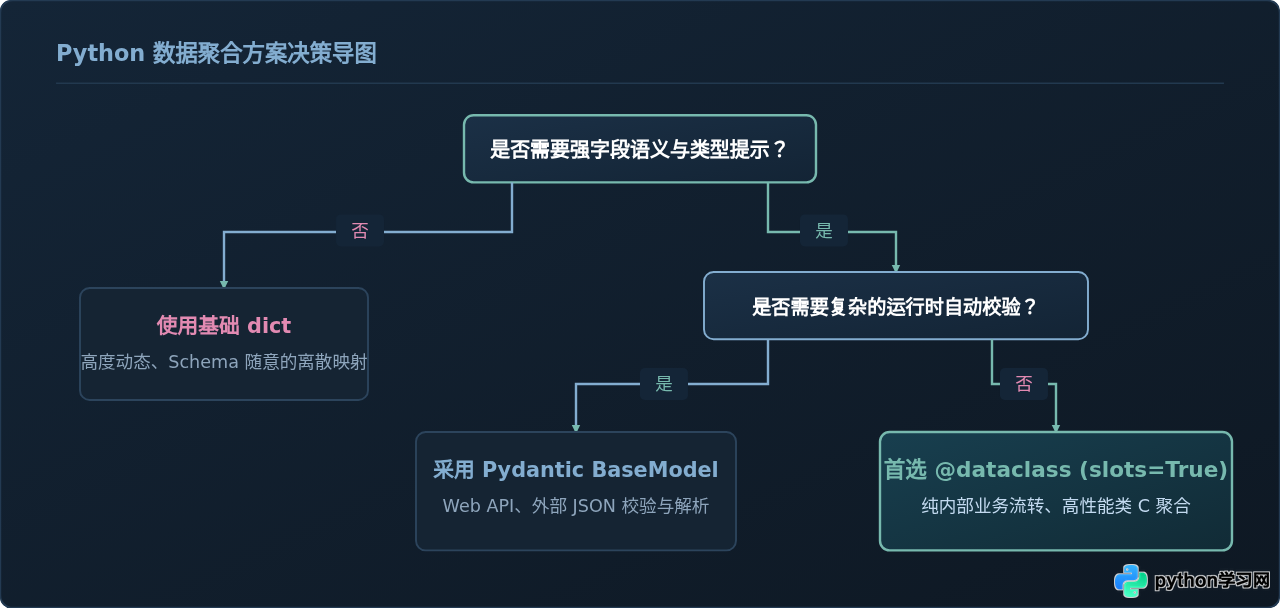
通过合理结合 @dataclass(slots=True, frozen=True),我们能够在纯 Python 环境中获得媲美 C 结构体的内存密度、零样板代码的开发体验以及完备的现代化类型检查保障。对于任何追求代码健壮性与可读性的工程项目而言,它都是取代原始字典与冗余类定义的标准解法。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









