

为什么修改Python元组元素会报错TypeError
深入解析在Python中尝试修改元组元素触发TypeError: 'tuple' object does not support item assignment的根本原因,从CPython底层内存结构、不可变序列设计初衷、引用边界与复合赋值陷阱展开,并给出规范的解决方案。
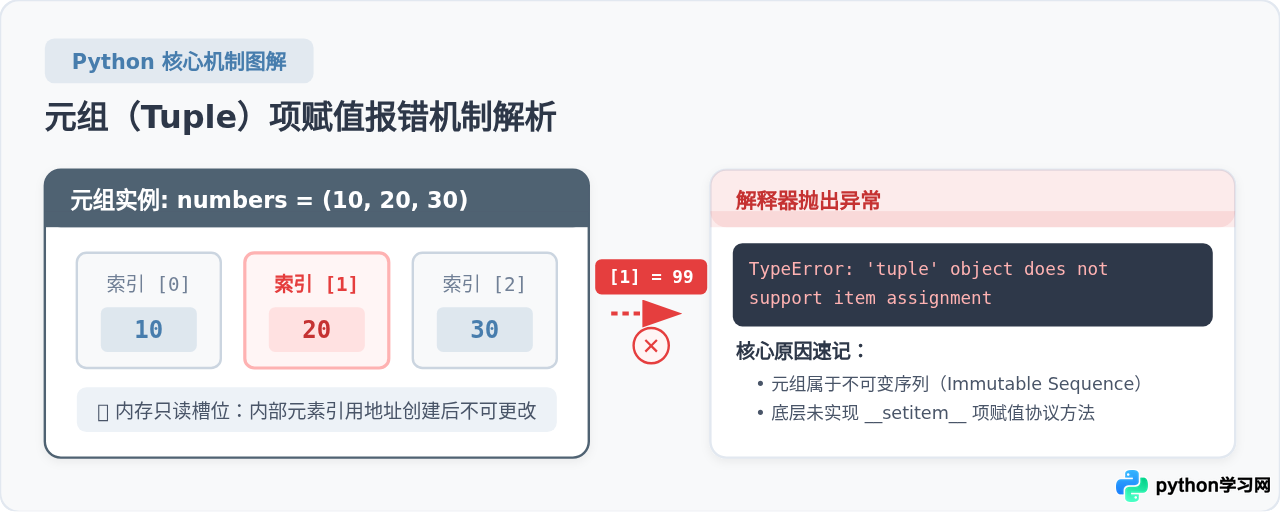
numbers[0] = 100)会立刻触发 TypeError: 'tuple' object does not support item assignment。该报错的根源在于:元组(tuple)在语言核心规范与底层 C 语言实现中均被严格设计为不可变序列(Immutable Sequence)。当解释器执行到项赋值语法时,会查询目标对象的底层协议槽位;而元组故意没有提供任何支持就地修改元素指针的接口方法(即未实现 __setitem__),解释器在校验失败后便按规则抛出类型错误(TypeError)。
报错现场复现与 Traceback 逐行分析
我们首先用一段最基础的示例代码来复现这一错误。在交互式 Python 终端(REPL)或 Python 脚本中执行如下操作:
# 示例代码:复现元组项修改报错
fruits = ("apple", "banana", "cherry")

# 尝试将第 2 个元素 "banana" 替换为 "orange"
fruits[1] = "orange"
运行上述代码后,Python 解释器会立即中断执行,并在终端输出如下异常堆栈信息:
# 运行结果(示例输出):
Traceback (most recent call last):
  File "demo.py", line 4, in <module>
    fruits[1] = "orange"
    ~~~~~~^^^
TypeError: 'tuple' object does not support item assignment
这段报错信息虽然简短,但每一处都精准指明了问题所在:
- 异常类型为
TypeError(类型错误):说明引发错误的并不是索引越界(如果是索引超出范围会抛出IndexError),也不是语法结构错误(SyntaxError),而是当前被操作对象所属的数据类型本身不支持这种操作行为。 - 详细描述
'tuple' object does not support item assignment:直接译为“'tuple' 对象不支持项赋值”。在 Python 规范中,通过下标定位并赋予新值的语法形态(如obj[key] = val)被称为项赋值(Item Assignment)。
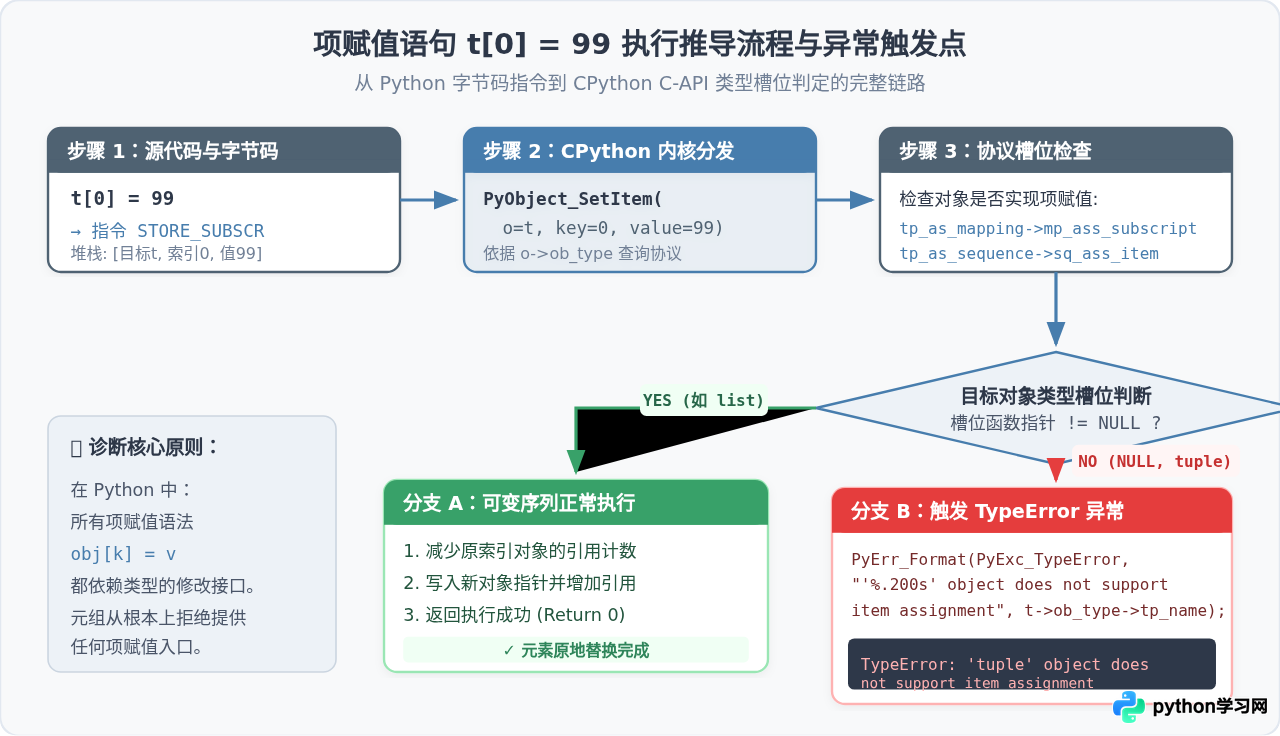
a[index] 对应的是读取接口 __getitem__,而赋值语句 a[index] = value 对应的则是写入接口 __setitem__。元组完整实现了前者以支持高效读取与切片,但故意彻底移除了后者。
从 CPython 底层内存模型看元组的不可变性
为什么 Python 要将元组设计为完全不支持项赋值?这需要从 CPython(官方 Python 解释器)的 C 语言内存布局与设计初衷进行解析。
在 CPython 源码中,可变序列(list)与不可变序列(tuple)分别由两个不同的核心结构体表示:
/* 简化自 CPython 源码 Include/cpython/tupleobject.h */
typedef struct {
    PyObject_VAR_HEAD
    PyObject *ob_item[1];  /* 定长指针数组,分配时按元组长度一次性申请 */
} PyTupleObject;

/* 简化自 CPython 源码 Include/cpython/listobject.h */
typedef struct {
    PyObject_VAR_HEAD
    Py_ssize_t allocated;  /* 列表的预分配缓冲容量 */
    PyObject **ob_item;    /* 二级指针,指向独立分配的动态数组 */
} PyListObject;
对比两个结构体的字段,可以清晰看到两者在架构定位上的根本差异:
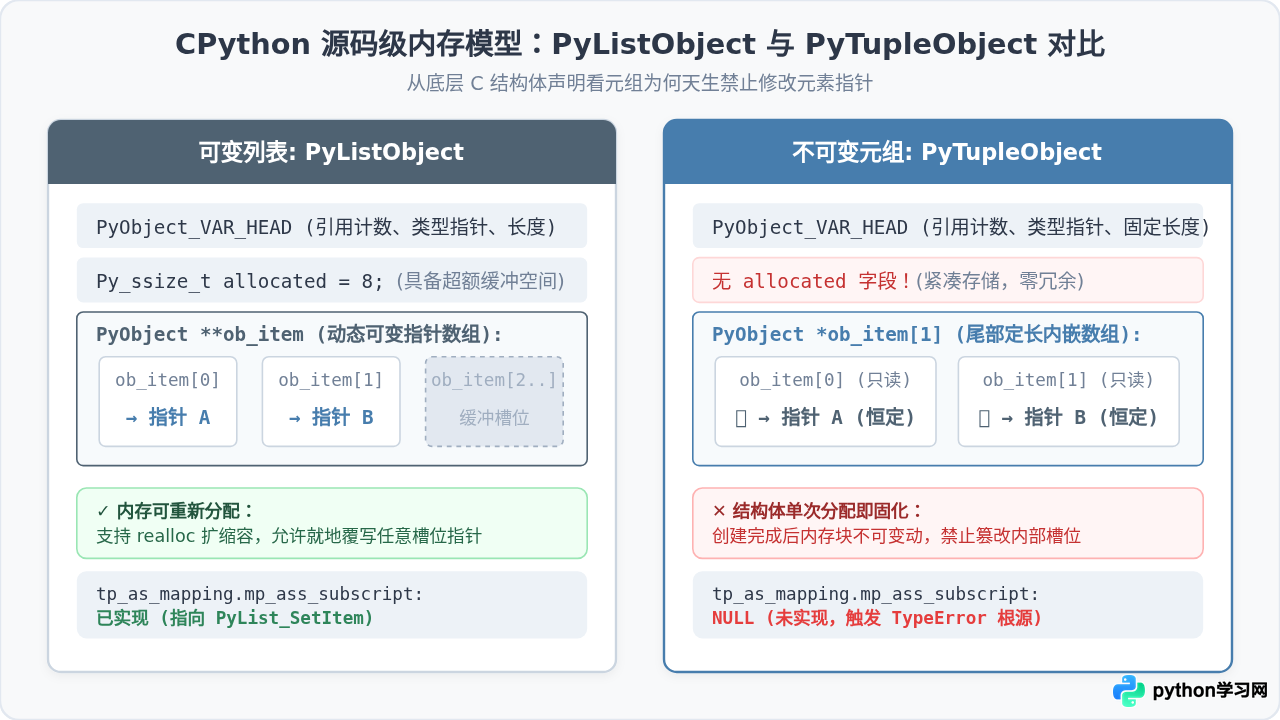
1. 内存分配与空间开销优化
列表为了支持随时 append、insert 和项赋值,必须包含 allocated 字段记录缓冲容量,其指针数组 ob_item 是在堆上独立二次分配的。
而元组在初始化创建的那一刻,其包含的元素个数就已经固定。CPython 会将元组的对象头(PyObject_VAR_HEAD)和固定长度的指针数组 ob_item 打包在同一块连续的物理内存中单次分配。这种内存连续且零额外缓冲的布局带来了三大直接好处:
- 极低的内存开销:由于没有任何预留缓冲槽位,相同元素数量下,元组占用的内存显著小于列表。
- 垃圾回收与空闲列表优化:CPython 对常见小型元组维持着内存池缓冲(Free Lists),重复创建和销毁元组的性能极高。
- CPU 缓存命中率更高:单次连续分配避免了指针的二次间接寻址,数据局部性更佳。
2. 字典键与集合元素的哈希安全性保障
在 Python 中,字典(dict)和集合(set)依赖对象的哈希值(hash())构建哈希表索引。如果一个对象作为字典的键,它的值却可以在程序运行中被任意修改,那么它的哈希值就会随之变化,或者导致哈希表中旧的槽位索引失效,造成哈希碰撞逻辑崩溃,使得键值对“凭空丢失”。
正因为元组坚决禁止项赋值,元组在包含只读元素时能够具备恒定不变的哈希值(可哈希,Hashable),从而安全地充当字典的键或集合的元素。
最易混淆的陷阱:“元组不可变”到底约束了什么?
很多刚接触 Python 的开发者常误以为“元组不可变”意味着“元组内的所有数据永远不能发生任何变化”。这种理解在遇到复合对象嵌套时,会带来极大的困惑。
实际上,元组的不可变性,仅严格约束元组自身内部持有的那组“对象引用(物理指针)”不可变更。元组槽位内存储的是目标对象在内存中的地址,只要这个地址指针没有发生重定向,元组的契约就没有被违反。
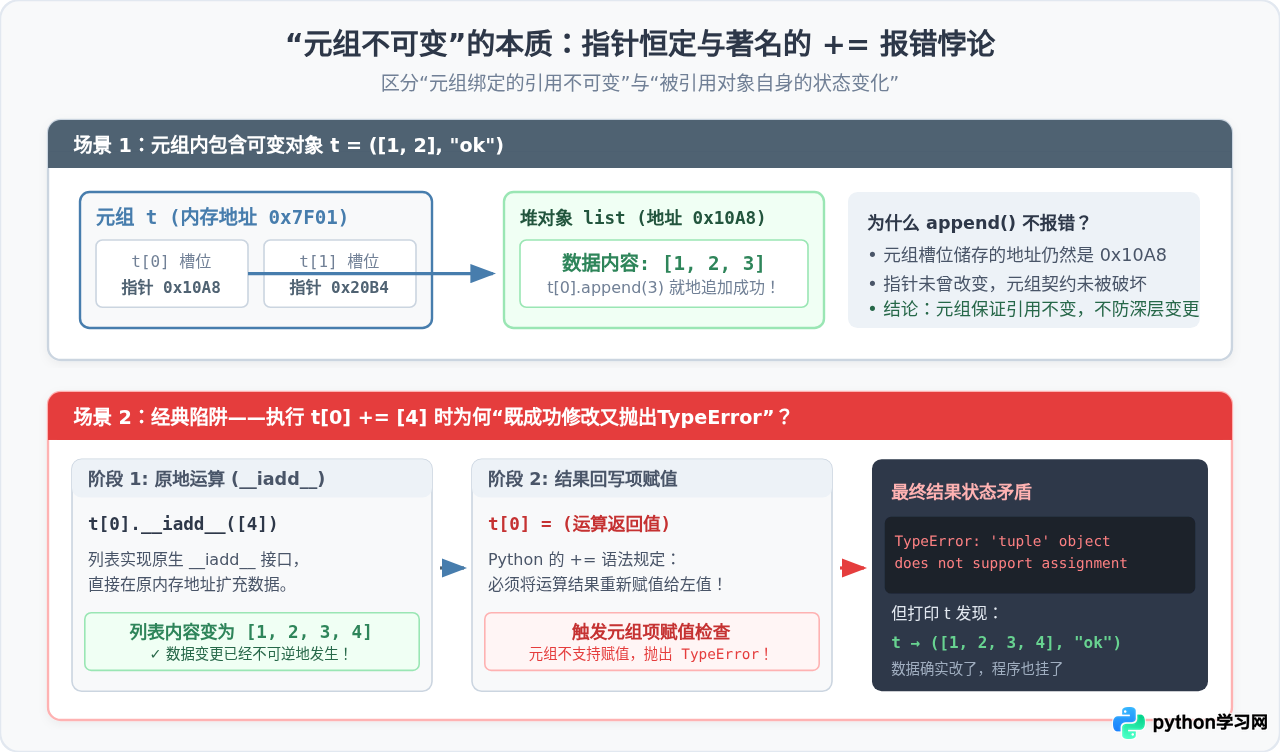
场景 1:直接调用嵌套列表的修改方法(成功执行)
如果元组的某个元素是一个可变对象(如列表 list),调用该列表的原地修改方法(如 append()、pop())是完全合法的:
# 包含列表的元组
mixed_tuple = ([1, 2], "hello")

# 正常执行!不会报错
mixed_tuple[0].append(3)

print(mixed_tuple)
# 输出: ([1, 2, 3], 'hello')
为什么没有报错?因为 mixed_tuple[0] 存储的依然是那个列表对象的内存地址(例如 0x10A8)。append() 方法直接修改了列表自身所占内存块里的数据,而没有改变 mixed_tuple[0] 所记录的引用指针。
场景 2:经典的 += 复合赋值陷阱(既成功修改又抛出异常)
下面的代码堪称 Python 面试和日常开发中最具迷惑性的经典案例:
# 经典的复合赋值陷阱
t = ([1, 2], "hello")

try:
    t[0] += [3, 4]
except TypeError as err:
    print(f"捕获到异常: {err}")

print("查看元组内容:", t)
执行这段代码,输出结果令人大吃一惊:
# 运行结果(示例输出):
捕获到异常: 'tuple' object does not support item assignment
查看元组内容: ([1, 2, 3, 4], 'hello')
列表中的元素确实被成功追加了,但程序却结结实实地抛出了 TypeError!这背后的执行逻辑分为两步:
-
第一步(原地自增):Python 遇到列表的
+=操作符时,首先调用列表的__iadd__特殊方法。对于列表而言,__iadd__会就地扩展元素并返回该列表对象自身的引用(内存地址不变)。此时列表内容已变为[1, 2, 3, 4]。 -
第二步(项回写赋值):根据 Python 的语法语义,表达式
a += b等价于a = a += b的回写赋值。因此,Python 接着尝试将第一步返回的结果通过项赋值赋给左侧的t[0]。 -
第三步(触发异常):由于左侧的目标容器是元组,在尝试项赋值时,解释器立刻检测到元组未实现
__setitem__,瞬间抛出TypeError。
+=、*= 等原地复合赋值操作符。如果有就地变更需求,请直接调用对象自带的显式方法(如 t[0].extend(...)),清晰明了且绝不报错。
规范解决路径:遇到需要修改元组时的正确方案
在实际工程开发中,如果你遇到了需要更改元组某个元素值的需求,说明当前数据流向需要灵活演进。以下是三种符合 Python 惯用实践(Pythonic)的规范处理方式:
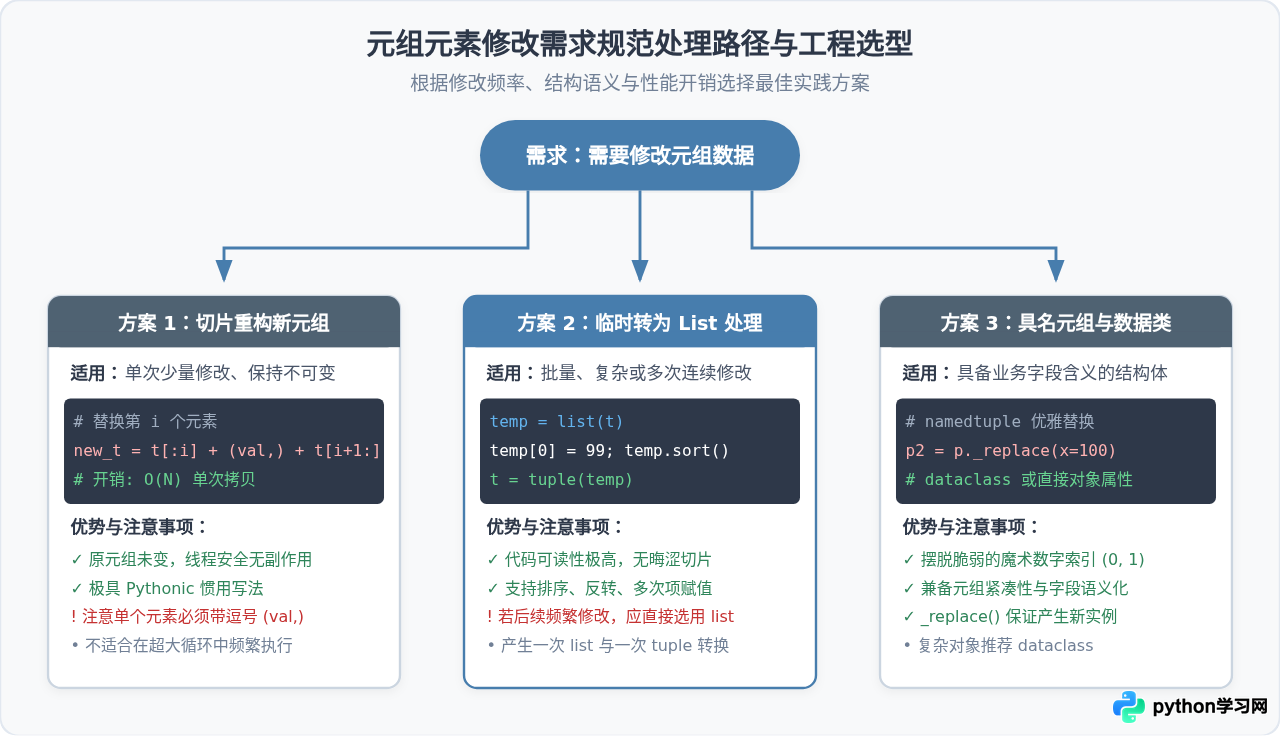
方案一:切片拆解与重构新元组(保留不可变性)
当你只需要单次修改元组中的某一个元素,且希望继续保持数据不可变特性时,可以通过元组切片相加的方式生成一个全新的元组:
# 原元组
coords = (10, 20, 30, 40)
index_to_modify = 2
new_value = 99

# 使用切片将前半部分、新元素、后半部分拼接为新元组
new_coords = coords[:index_to_modify] + (new_value,) + coords[index_to_modify + 1:]

print("原元组:", coords)       # 输出: (10, 20, 30, 40) - 保持原状
print("新元组:", new_coords) # 输出: (10, 20, 99, 40) - 成功重构(new_value,)。如果写成 (new_value),会被 Python 解释器仅视为普通的数学运算括号,进而报 TypeError: can only concatenate tuple (not "int") to tuple 错误。
方案二:转换为列表处理后再转回(适合批量修改)
当涉及多个元素的修改、删除、插入或原地排序时,最清晰直观的做法是将元组临时转换为列表,操作完成后再转回元组:
# 原元组
scores = (88, 72, 95, 60)

# 1. 转为可变列表
scores_list = list(scores)

# 2. 执行需要的修改操作
scores_list[1] = 85
scores_list.sort(reverse=True)

# 3. 转回不可变元组
updated_scores = tuple(scores_list)

print(updated_scores)  # 输出: (95, 88, 85, 60)
这种方式语义明确,代码可读性极佳。需要注意的是:如果你的业务场景在整个生命周期内需要频繁执行增删改查,那么从一开始就不应该定义为 tuple,而应该直接使用 list。
方案三:改用具名元组 namedtuple 或 dataclass(语义化工程选型)
如果元组被用来承载具备明确业务含义的结构化记录(例如数据库行记录、坐标点、配置项),使用数字下标(如 p[0]、p[1])本身就脆弱易错。标准库提供了更高维度的解决方案:
from collections import namedtuple

# 定义具名元组
Point = namedtuple("Point", ["x", "y", "label"])
p1 = Point(x=10, y=20, label="Point-A")

# namedtuple 原生自带 _replace() 方法,优雅生成替换后的新实例
p2 = p1._replace(y=99, label="Point-Modified")

print("原始实例:", p1)  # Point(x=10, y=20, label='Point-A')
print("替换实例:", p2)  # Point(x=10, y=99, label='Point-Modified')
namedtuple._replace() 方法在内部完成了新实例的构建,既保留了元组的内存紧凑性与不可变保护,又完全规避了手写切片的繁琐与容易出错的下标魔术数字。
方案选型对照与核心认知清单
为了在日常编码中快速做决定,我们可以通过下表系统梳理应对元组项修改的选型权衡:
| 处理策略 | 典型代码形态 | 适用场景 | 优势与成本权衡 |
|---|---|---|---|
| 切片拼接 | t[:i] + (val,) + t[i+1:] |
偶发单次修改,继续保持不可变契约 | 纯函数式无副作用;产生 O(N) 临时新对象 |
| 转 List 中转 | l = list(t); l[i] = v; t = tuple(l) |
批量多次修改、复杂过滤排序 | 逻辑清晰直白;产生两次内存类型转换 |
| 具名元组替换 | nt._replace(field=val) |
业务记录、配置参数、带字段名结构 | 高可读性、自文档化;内存占用极小 |
| 直接重构为 List | 初始化即使用 items = [...] |
高频动态增删改查的数据集合 | 最高执行性能,无需反复转换 |
- Python 抛出
TypeError: 'tuple' object does not support item assignment是语言为了保障内存紧凑、性能高效与哈希安全性而设置的正常保护屏障。 - 元组的不可变仅约束其内部直接保存的“对象指针”,不约束被引用对象内部的状态。
- 遇到修改诉求时,切片重构、
list()转换或namedtuple._replace()均是标准成熟的解法;若需要频繁就地更新,应果断在数据建模阶段采用list。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









