

CPython、Jython与PyPy:不同Python实现的底层语言对比
深入对比 CPython、Jython 与 PyPy 三大 Python 实现的底层宿主语言(C、Java、RPython),剖析其在编译执行机制、内存管理、GIL 锁及生态兼容性上的本质差异与工程选型指南。
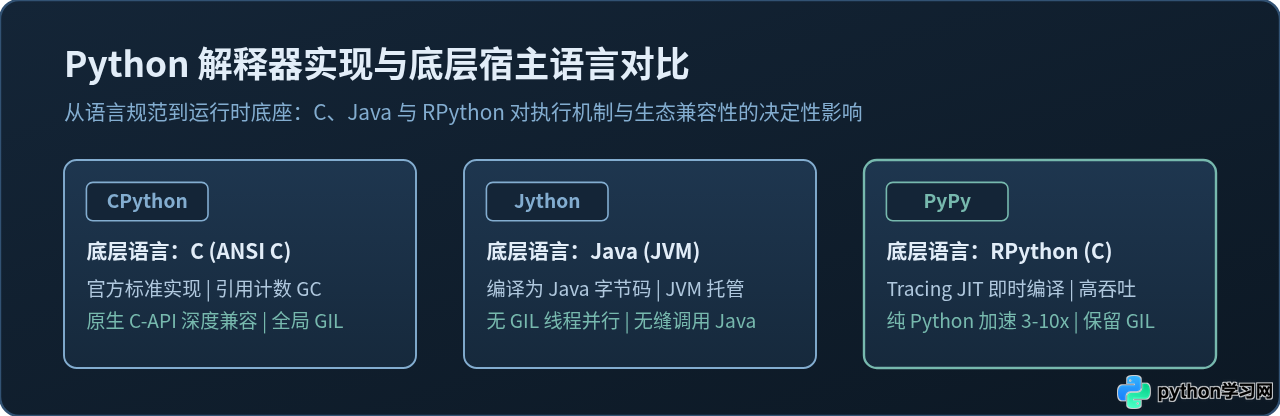
python main.py 时,执行行为完全取决于所选解释器的底层宿主语言。CPython 以 ANSI C 编写,凭借原生 C-API 奠定了科学计算生态的主导地位,但也带来了引用计数与全局解释器锁(GIL);Jython 以 Java 编写,将 Python 源码直接编译为 JVM 字节码,消除了 GIL 并提供原生的多线程并行,深度绑定 Java 企业生态;PyPy 则由 Python 严格子集 RPython 构建并自动翻译为底层 C 代码,依靠内置的 Tracing JIT 编译器在运行时动态生成原生机器码,将纯 Python 运算性能提升 3 至 10 倍。本文逐层拆解三种实现底座对执行机制、垃圾回收、并发能力与工程选型的本质影响。
一、语言规范与解释器底座:打破“Python 只有一种”的认知
许多初学者往往将“Python 语言语法”与“运行 Python 的具体软件”混为一谈。实际上,Python 是一份官方公开的语言规范(Python Language Reference),详细规定了语法、关键词、数据模型及标准库行为;而具体负责解析语法树、调度内存并调用底层硬件指令的程序被称为解释器实现(Runtime Implementation)。
假设我们正在开发一个高吞吐数据流处理系统,当代码中存在大量纯 Python 编写的复杂过滤与数学运算时,直接使用官方解释器可能会遭遇性能瓶颈;而在微服务架构中,若需要直接复用已有的 Java 类库(例如企业级 RPC 或大数据中间件),重新用 Python 封装或跨进程 RPC 往往带来不必要的延迟。此时,理解不同 Python 实现的底层宿主语言差异,便是技术选型的重要前提。
在当前运行环境中,可以通过以下命令快速验证当前正在运行的 Python 实现类型:
# 确认当前 Python 解释器实现及版本信息
import platform
import sys

print(f"实现名称: {platform.python_implementation()}")
print(f"编译器信息: {platform.python_compiler()}")
print(f"底层构建详情: {sys.version}")
在标准安装下,上述代码将输出 CPython 及 GCC/Clang/MSVC 编译信息;而在 Jython 或 PyPy 环境中,则会分别输出 Jython(伴随 JVM 版本)或 PyPy(伴随 PyPy 与对应 Python 语法版本的双重标识)。
二、CPython:以 C 语言构建的官方基石
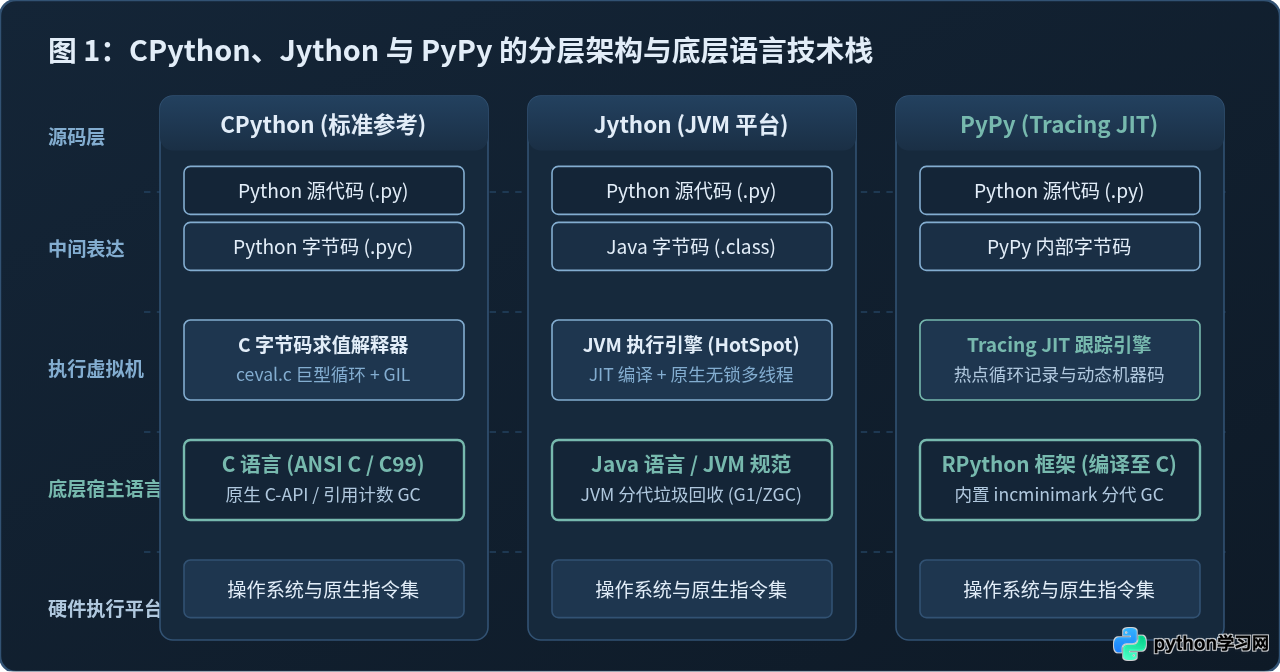
CPython 是 Python 官方(Python Software Foundation)维护的参考实现,由 Guido van Rossum 最初使用 ANSI C 语言开发。从 1991 年至今,它一直是绝大多数开发者机器上的默认安装版本。
1. 底层实现与编译执行链
CPython 的代码库主要由严格的 C 语言写成(核心代码位于 Python 源码仓库的 Python/、Objects/ 和 Modules/ 目录)。其标准工作流程包含两步:
- 编译阶段:解析器读取
.py文本文件,经由词法分析与语法分析生成抽象语法树(AST),随后字节码编译器将 AST 翻译为平台无关的 Python 字节码,并打包成PyCodeObject写入.pyc文件。 - 求值阶段:虚拟机的核心是
ceval.c文件中的一个庞大的switch-case循环。该循环逐条提取字节码指令(Opcode),通过 C 语言级别的指针操作在解释器调用栈(Evaluation Stack)上执行具体运算。
2. 内存管理:引用计数与分代 GC
CPython 中所有对象在底层均由包含 PyObject 头部的 C 结构体表示。每个对象内置一个 ob_refcnt 引用计数成员:
- 当变量被赋值、作为参数传递或加入列表时,C 宏
Py_INCREF()递增计数; - 当变量离开作用域、被
del删除或所在容器销毁时,Py_DECREF()递减计数; - 一旦引用计数降为 0,底层调用
tp_dealloc立即向内存池(obmalloc)归还系统内存。
为解决容器对象相互持有导致的循环引用无法释放问题,CPython 额外在 C 语言层面实现了一个三代分代垃圾回收器(Generational Cyclic GC,定义在 Modules/gcmodule.c 中),周期性扫描可能存在环状引用的链表。
3. GIL 与原生 C-API 生态
由于引用计数的增减遍布整个虚拟机,为了在多线程并发访问时保证内存操作的原子性,同时避免在每一个底层 C 数据结构上单独加锁导致的巨大性能开销,CPython 引入了全局解释器锁(Global Interpreter Lock, GIL)。GIL 确保在任意时刻,只有一个操作系统原生线程在执行 Python 字节码。这导致纯 CPU 密集型的多线程任务在 CPython 下无法利用多核性能。
但与此同时,C 语言底层带来了无可替代的优势:原生 C-API(Python.h)。外部 C/C++ 共享库可以毫无阻碍地与 CPython 内部数据结构直接对接,无缝操纵内存指针。正是这一底层特性孕育了 NumPy、SciPy、TensorFlow 和 PyTorch 等现代人工智能与数据科学的核心生态。
三、Jython:构建于 Java 虚拟机之上的企业级桥梁
Jython(最初名为 JPython)是 Jim Hugunin 等人完全使用 Java 语言重新实现的 Python。它的目标不是取代 CPython,而是将 Python 优雅的动态语法无缝带入 JVM 生态。
1. 从 Python 语法到 Java 字节码
Jython 与 CPython 最大的底层区别在于中间目标码的形式。CPython 生成自己的专用 Python 字节码,而 Jython 的编译器直接将 Python 源代码翻译为合法的 Java 虚拟机字节码(JVM Bytecode,即标准 .class 文件结构)。
这意味着在 JVM 看来,一段由 Jython 执行的 Python 代码与通过 javac 编译出来的普通 Java 类没有任何执行层面的本质区别。JVM 的 HotSpot 引擎可以直接对这些字节码进行即时编译(JIT),将其动态编译为高执行效率的原生机器码。
2. 无缝整合 Java 生态与无 GIL 优势
在 Jython 环境中,Python 代码可以直接 import 任意 Java 类库。如下示例展示了在 Jython 中直接操作 Java 标准类库与多线程并发的过程:
# Jython 运行示例:直接导入与操作 Java 类库
from java.util import ArrayList, HashMap
from java.lang import Thread, Runnable

# 像使用 Python 原生字典一样使用 Java HashMap
java_map = HashMap()
java_map.put("service", "payment-gateway")
java_map.put("cluster_nodes", 8)
print("Java Map 输出:", java_map.get("service"))

# 原生利用 JVM 多线程并行能力(无 GIL)
class Worker(Runnable):
    def run(self):
        tid = Thread.currentThread().getId()
        print(f"Jython 线程 [ID: {tid}] 正在真正并行执行 CPU 运算")

threads = [Thread(Worker()) for _ in range(4)]
for t in threads:
    t.start()
for t in threads:
    t.join()
因为 Jython 内部的所有对象都继承自 Java 的 org.python.core.PyObject 类,对象的生命周期完全由 JVM 的垃圾回收器(如 G1、ZGC 或 Parallel GC)管理,不再使用引用计数,因此Jython 内部完全没有 GIL 锁。Python 线程直接对应为底层的 Java Thread(操作系统内核级线程),可以在多核服务器上实现真正的 CPU 密集型并行运算。
.so 或 .pyd 文件)。因此,依赖 C 扩展的 NumPy、Pandas 和大部分科学计算库无法在 Jython 上原生运行。此外,Jython 社区目前的成熟版本主要停留在 Python 2.7 规范,针对 Python 3 的演进速度相对缓慢,主要适用于维护旧有 JVM 脚本系统或特定的企业级 Java 集成场景。
四、PyPy:基于 RPython 与 Tracing JIT 的性能利器
PyPy 是由 Armin Rigo、Maciej Fijalkowski 等编译器专家发起的研究级项目,现已成为工业界成熟的高性能 Python 替代方案。PyPy 的最引人瞩目之处不仅在于其极高的运行速度,更在于其自举(Bootstrap)设计与独特的底层宿主语言 RPython。
1. 宿主语言:什么是 RPython?
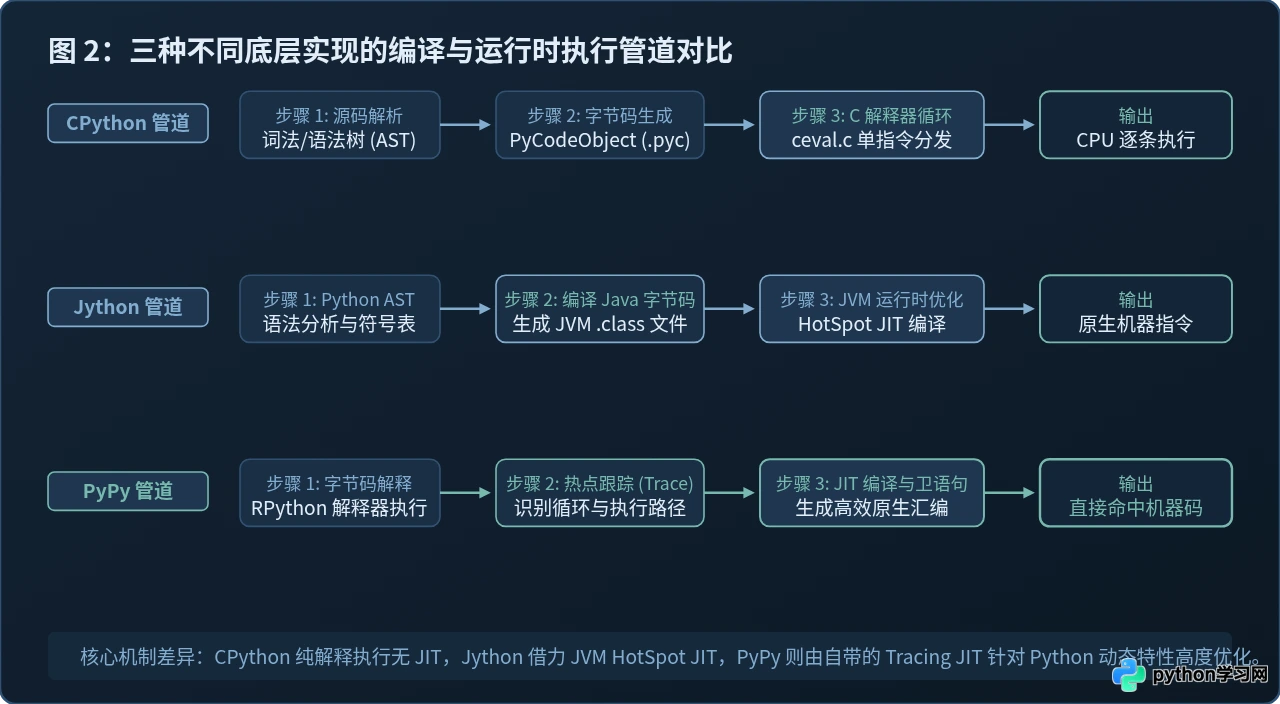
很多人误以为 PyPy 是“用纯 Python 写的 Python 解释器”,这并不严谨。PyPy 的解释器是用 RPython(Restricted Python) 编写的。
RPython 是 Python 语言的一个严格受限子集:
- 它保留了 Python 的核心语法、缩进和类定义;
- 它禁止在运行时动态修改类的属性或函数签名,变量必须具有类型一致性(可通过静态类型推导明确判定);
- RPython 配备了一个强大的翻译工具链(Translation Toolchain),能够静态分析 RPython 代码,自动注入内存分配器、异常处理机制和垃圾收集器,并最终将其编译为高质量的 ANSI C 源码,再调用 GCC/Clang 编译为机器码。
2. Tracing JIT:动态追踪即时编译
与 Jython 依赖 JVM 的通用方法级 JIT 不同,PyPy 拥有专为动态语言设计的追踪即时编译器(Tracing JIT):
- 热点探测:当程序开始运行时,PyPy 首先作为常规解释器逐行执行字节码,并记录各个循环与分支的执行频次。
- 记录轨迹(Trace):当某个循环迭代次数超过设定的阈值时,JIT 开启追踪器,记录该循环在一次典型迭代中走过的具体操作序列(Linear Trace)。
- 插入卫语句(Guard):由于 Python 是动态类型的,JIT 会在生成的机器码序列中插入轻量级的类型与条件断言。如果后续运行时变量类型未变,硬件将直接以机器指令全速执行;一旦断言失败(如浮点数变为了字符串),则跳回普通解释器继续处理。
- 优化与机器码内联:对追踪到的线型代码消除冗余装箱/拆箱(Boxing/Unboxing)、内联函数调用,并生成极度紧凑的原生汇编指令。
3. 内存与生态兼容(cpyext 与 cffi)
PyPy 使用了名为 incminimark 的增量分代垃圾回收器,放弃了引用计数机制。这使得 PyPy 中临时对象的分配与销毁开销极低。虽然 PyPy 保留了类似 CPython 的 GIL 机制,但凭借 Tracing JIT,纯 Python 编写的计算任务往往能达到 CPython 的 3 到 10 倍以上吞吐量。
在扩展库支持上,PyPy 提供了名为 cpyext 的兼容层来支持 C-API,但由于需要为动态对象临时构造 C 结构体并在两套内存管理系统间同步,频繁调用原生 C 函数反而可能拖慢速度。因此,在 PyPy 下与 C 语言交互时,强烈推荐使用 cffi(C Foreign Function Interface)。
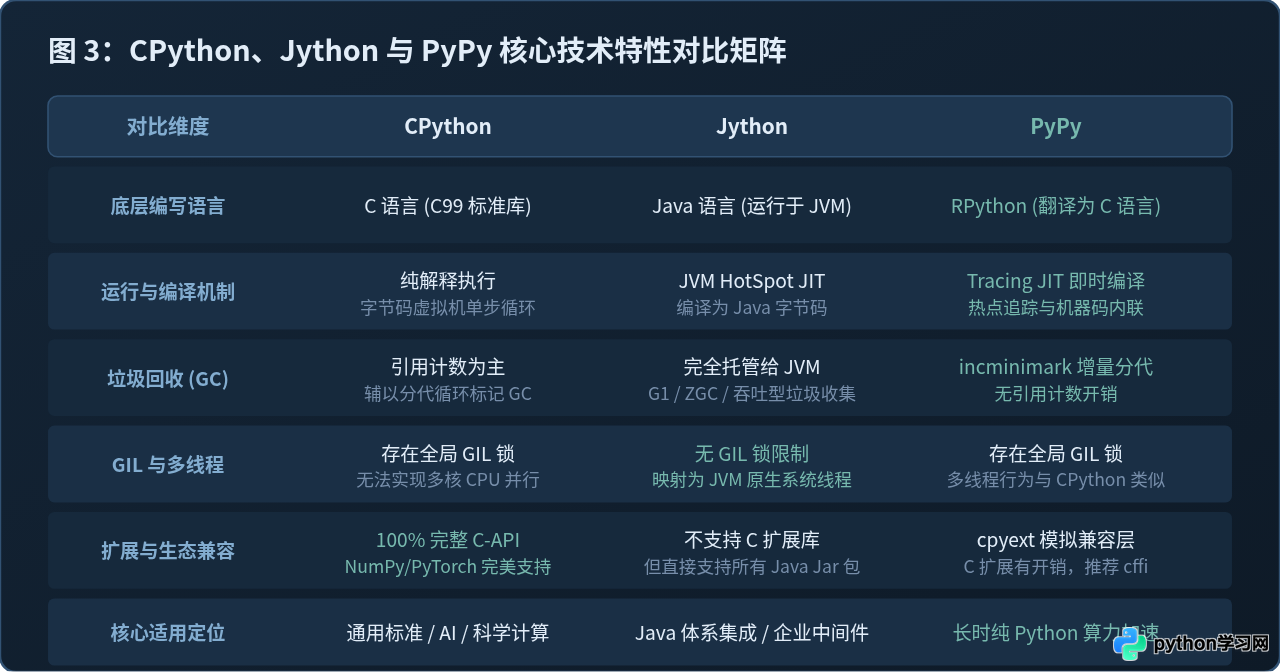
五、底层语言差异决定的四大核心运行时特性
| 技术指标 | CPython | Jython | PyPy |
|---|---|---|---|
| 底层宿主语言 | ANSI C (C99) | Java (运行于 JVM 规范) | RPython (编译至 C 语言) |
| 代码编译形态 | Python Bytecode (.pyc) | JVM Bytecode (.class) | PyPy Bytecode + 动态原生汇编 |
| 垃圾回收机制 | 引用计数为主 + 分代标记循环 GC | 完全委托 JVM (G1, ZGC 等) | incminimark 增量分代 GC |
| 全局解释器锁 (GIL) | 存在 (保护 C 引用计数安全) | 无 GIL (原生多核多线程) | 存在 (官方标准版保持 GIL) |
| C 原生库生态兼容 | 100% 完整 C-API 原生支持 | 不支持原生 C-API (.so/.pyd) | 通过 cpyext 模拟兼容 (首选 cffi) |
| 长时运行吞吐量 | 基准线 (单步解释) | 中等至较高 (依赖 JVM JIT) | 极高 (纯 Python 性能可达 3-10x) |
| 进程启动与内存开销 | 启动极快、常驻内存占用极小 | JVM 启动慢、内存占用大 | 启动较快,JIT 缓存占用较多内存 |
1. 内存模型与对象生命周期的确定性
在 CPython 中,由于引用计数的即时性,当执行 with open("log.txt") as f: 或对象离开作用域时,文件描述符和内存通常会被立即释放。很多开发者习惯了这种确定性行为。
但在 Jython 与 PyPy 中,由于底层分别使用了 JVM GC 和 incminimark 分代垃圾收集,没有引用计数,对象的终结(Finalization)是由后台 GC 线程异步触发的。如果在 Jython 或 PyPy 中编写未显式关闭文件的代码,文件句柄可能会长时间滞留未释放,从而引发 Too many open files 异常。因此,编写跨实现的 Python 代码时,必须严格使用上下文管理器(with 语句)管理外部资源。
2. 并发模型的本质分流
多线程在 CPython 中受制于 GIL,仅对网络 I/O、磁盘读写等阻塞操作有效,CPU 密集型计算必须转用 multiprocessing(多进程架构),这带来了跨进程序列化(IPC)与独立内存空间的额外开销。
Jython 由于底层为 Java,其多线程天然共享同一进程堆内存,且能均匀调度到所有可用 CPU 物理核心上,这在需要处理高并发共享内存计算的企业内部应用中极具优势。
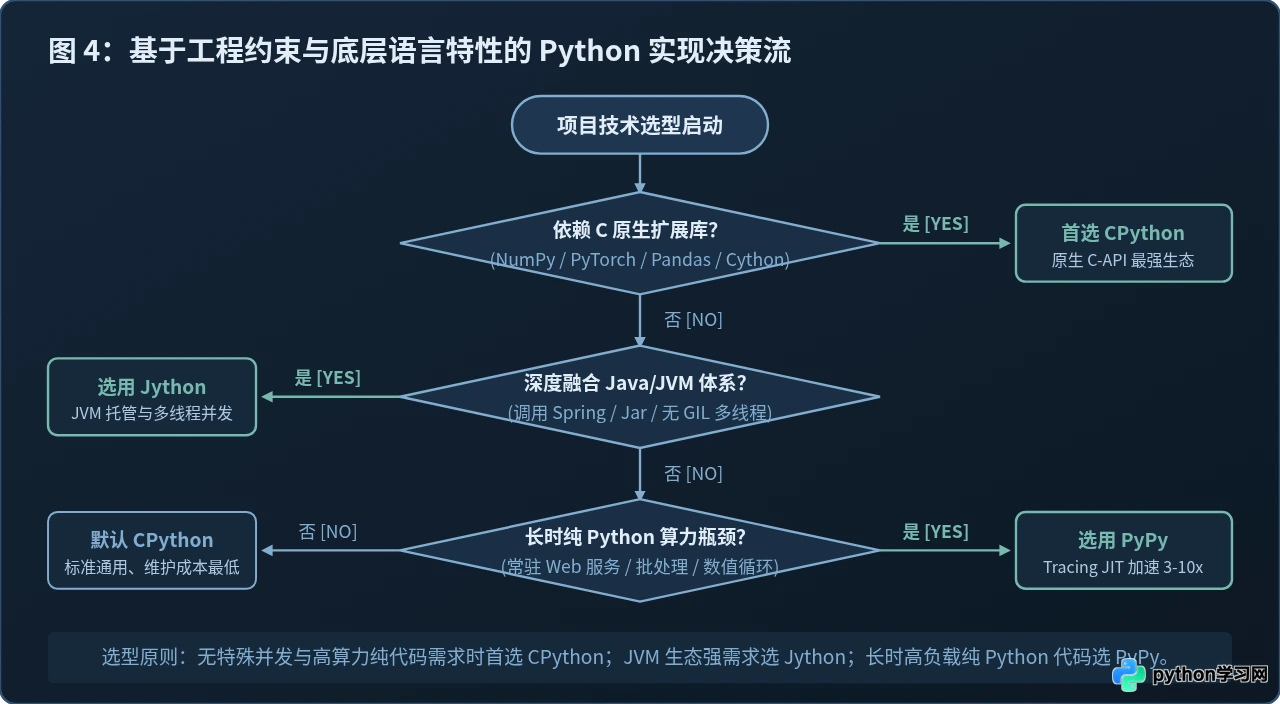
六、工程实践中的选型指南与决策路径
选型 Python 解释器时,切忌盲目追求某一指标(如纯基准测试的分数),而应紧扣项目的核心生态依赖与运行环境约束:
场景 1:现代人工智能、数据科学与常规后端开发(首选 CPython)
- 判定依据:如果业务依赖 NumPy、Pandas、PyTorch、TensorFlow、Scikit-learn、OpenCV、Cython 等底层以 C/C++/Fortran 编写的扩展库;
- 核心收益:100% 的生态兼容性,零二次适配风险,极短的脚本冷启动时间,官方社区版本更新的第一时间支持;
- 应对并发:采用异步 I/O(
asyncio)处理网络高并发,结合multiprocessing或 Celery 任务队列横向扩展 CPU 计算。
场景 2:长时运行、纯 Python 算法与高并发 Web 服务(首选 PyPy)
- 判定依据:项目主要由纯 Python 编写,包含大量的数值循环、JSON 深度解析、字符串处理、文本正则匹配或复杂的业务决策树逻辑;或者是长时运行的常驻进程(如 Django/FastAPI 后端、爬虫调度集群、自动化测试平台);
- 核心收益:在不修改现有业务逻辑的前提下,直接获得 3 倍到 10 倍的吞吐量提升;
- 注意事项:避免用于频繁拉起退出的短生命周期 CLI 工具(因为 JIT 尚未完成热身,启动开销略高于 CPython);若需与 C 交互,优先采用
cffi而非手写 C-API 扩展。
场景 3:与 Java 企业平台、大数据基础设施深度融合(选择 Jython)
- 判定依据:企业已有庞大的 Java/Spring 业务集群,需要将 Python 作为动态脚本引擎嵌入宿主程序;或者需要在现有 JVM 进程内部直接调度多核原生并发,无需处理进程间通信;
- 核心收益:零 RPC 成本直接调用 JAR 包类库与接口,享受 JVM 统一的监控排障体系;
- 注意事项:严格确认语法版本是否满足要求(大部分生产集群锁定在 Python 2.7 语法体系)。
七、常见技术误区排查与验证方法
并不是。如果代码的大部分执行时间都在调用底层由 C/BLAS 优化的矩阵乘法(例如
numpy.dot()),此时无论是 CPython 还是 PyPy,真正的计算瓶颈都在底层动态链接库中,PyPy 的 JIT 无法介入已编译好的原生代码;相反,PyPy 的 cpyext 胶水层调用原生库时还可能引入额外的桥接损耗。PyPy 施展性能魔法的关键前提是业务逻辑在 Python 代码层内部高频迭代。
长期以来,CPython 优先保证的是 C-API 的极致稳定性、简洁的调试模型以及极低的内存开销。引入 JIT 会显著增加虚拟机的代码复杂度、内存占用并破坏 ABI 契约。不过在 Python 3.11+ 开展的“Faster CPython”计划中,官方已逐步引入特化自适应解释器(Specializing Adaptive Interpreter),并在 Python 3.13 中试验性引入 Copy-on-Write JIT 及可选的无 GIL 构建(Free-threaded build),但其机制与设计目标依然围绕 C 语言生态展开。
快速上手基准测试与验证
在评估是否将 CPU 密集型任务从 CPython 迁移至 PyPy 时,可以使用标准库 timeit 进行直观验证。以下脚本计算大范围质数筛选以模拟纯动态代码的运行开销:
# benchmark_prime.py
import time
import platform

def count_primes(limit):
    count = 0
    for num in range(2, limit):
        is_prime = True
        for i in range(2, int(num ** 0.5) + 1):
            if num % i == 0:
                is_prime = False
                break
        if is_prime:
            count += 1
    return count

if __name__ == "__main__":
    impl = platform.python_implementation()
    print(f"当前测试解释器: {impl} (Python {platform.python_version()})")

    start_time = time.time()
    total = count_primes(100000)
    elapsed = time.time() - start_time

    print(f"计算完成: 质数数量 = {total}, 耗时 = {elapsed:.4f} 秒")
分别在 CPython 和 PyPy 下运行该脚本,读者可以清晰观察到底层 Tracing JIT 将 Python 循环动态转化为机器码带来的数倍执行提速。这正是由底层语言与虚拟机编译策略差异带来的最直接的工业价值体现。
八、总结
Python 解释器的底层实现语言,直接决定了其运行时的架构哲学与适用边界:
- CPython(底层:C) 是生态的基石,以极高扩展性和原生 C-API 赢得了全行业最广泛的工具链支持,是绝大部分日常开发与 AI 计算的必然选择;
- Jython(底层:Java) 构筑了打通 JVM 规范与动态语法的桥梁,以完全去 GIL 的原生多线程与免序列化的 Java 调用能力服务于特定企业级混合架构;
- PyPy(底层:RPython) 则展示了现代编译器技术的巅峰,通过严谨的元追踪即时编译,让动态语法与接近 C 语言的原生机器执行速度共存。
理解这三者底层底座的异同,不仅能够帮助开发者写出更符合解释器特性的高效代码,更能为复杂系统架构设计提供清晰、理性的技术选型依据。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









