

Python中大写字母和小写字母哪个大:基于Unicode码点的比较规则
深入解析Python中大小写字母比较机制,阐明基于Unicode与ASCII码点的比较规则、字符串字典序比较逻辑、排序应用及常见避坑指南。
在 Python 中直接比较单个英文字母的大小时,小写字母比大写字母更大。例如在交互式环境中执行 'a' > 'A',返回结果为 True;执行 'z' > 'Z' 同样返回 True。初学者常误以为“大写”在地位或规模上更大,但 Python 的判定依据并不是日常生活中的文字概念,而是每个字符在 Unicode 编码表中的码点(Code Point)数值。本文将详细解释这套比较规则的底层原理、多字符字符串的比较机制,以及在实际编码与排序中的应用与注意事项。
一、核心判定机制:Unicode 码点与 ord() 函数
在 Python 内部,所有字符都对应一个唯一的整数编号,即 Unicode 码点。当使用关系运算符(<、<=、>、>=、==、!=)比较两个字符时,Python 会自动比较它们各自对应的整数码点值。
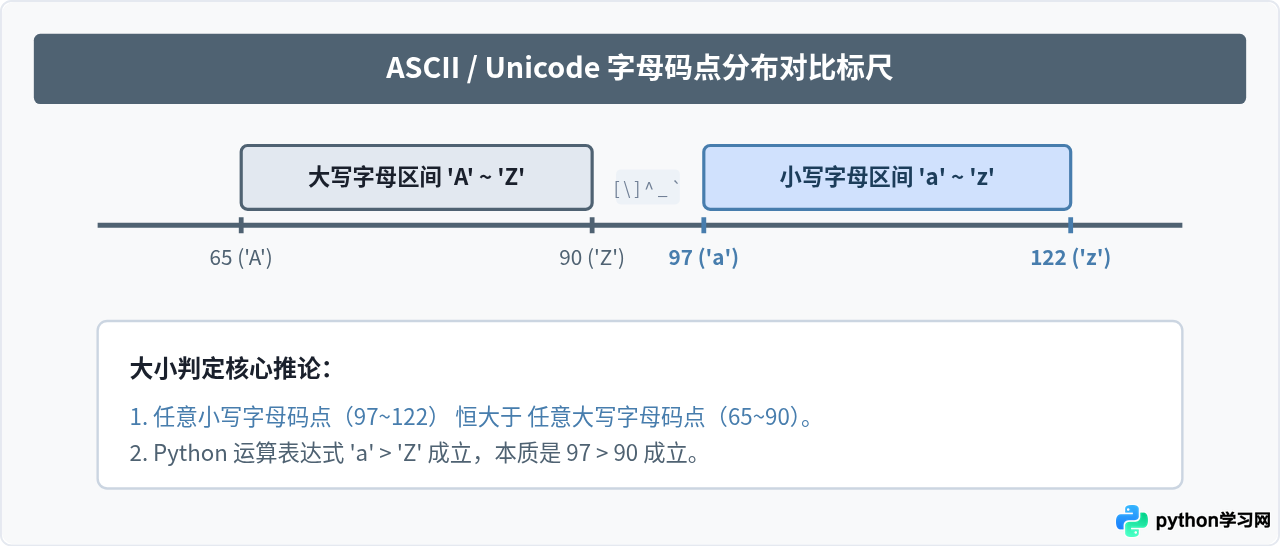
通过 Python 内置函数 ord(),可以查看任意单字符的十进制码点数值;反之,使用 chr() 函数可以将整数码点转回对应字符。ASCII 编码是 Unicode 编码的子集(占用 0 到 127 范围),标准 26 个英文字母的码点连续排列:
- 大写英文字母
'A'到'Z'的码点区间为 65 至 90。 - 小写英文字母
'a'到'z'的码点区间为 97 至 122。
# 示例代码:验证字符与对应码点数值
print(ord('A'))  # 输出: 65
print(ord('Z'))  # 输出: 90
print(ord('a'))  # 输出: 97
print(ord('z'))  # 输出: 122

# 比较运算的实际等价逻辑
print('a' > 'A')          # 输出: True
print(ord('a') > ord('A'))  # 输出: True (即 97 > 65)
print('b' > 'Z')          # 输出: True (即 98 > 90)
从数据可以看出,即使是最小的英文小写字母 'a'(码点 97),也比最大的英文大写字母 'Z'(码点 90)还要大。因此,在纯字母比较的场景下,任何小写字母都大于所有大写字母。
二、多字符字符串的比较推导流程
当比较由多个字符组成的字符串时,Python 遵循字典序(Lexicographical Order)原则。字典序不是根据字符串总长度或字符码点求和来判断,而是从左至右逐位比较:
- 逐位对齐比对:同时从两字符串索引 0 的字符开始,比较对应位置字符的码点值。
- 首位差异决胜负:一旦在某个位置发现两字符码点不同,该位置码点较大者对应的字符串整体即被判定为更大,比较立即结束,不再看后续字符。
- 完全相同看长度:如果遍历完其中一个短字符串的所有字符,对应位置都完全相等,则长度较长的字符串更大;若长度与内容均相同,则两字符串相等。
# 示例 1:首字符即存在大小写差异
# 'A' (65) 小于 'a' (97),所以整个 "Apple" 小于 "apple"
print("Apple" < "apple")  # 输出: True

# 示例 2:虽然 "BANANA" 字母更多且有更大字母,但首字符 'B' (66) 小于 'a' (97)
print("BANANA" < "apple")  # 输出: True

# 示例 3:前缀相同时比长度
print("Python" < "Python3")  # 输出: True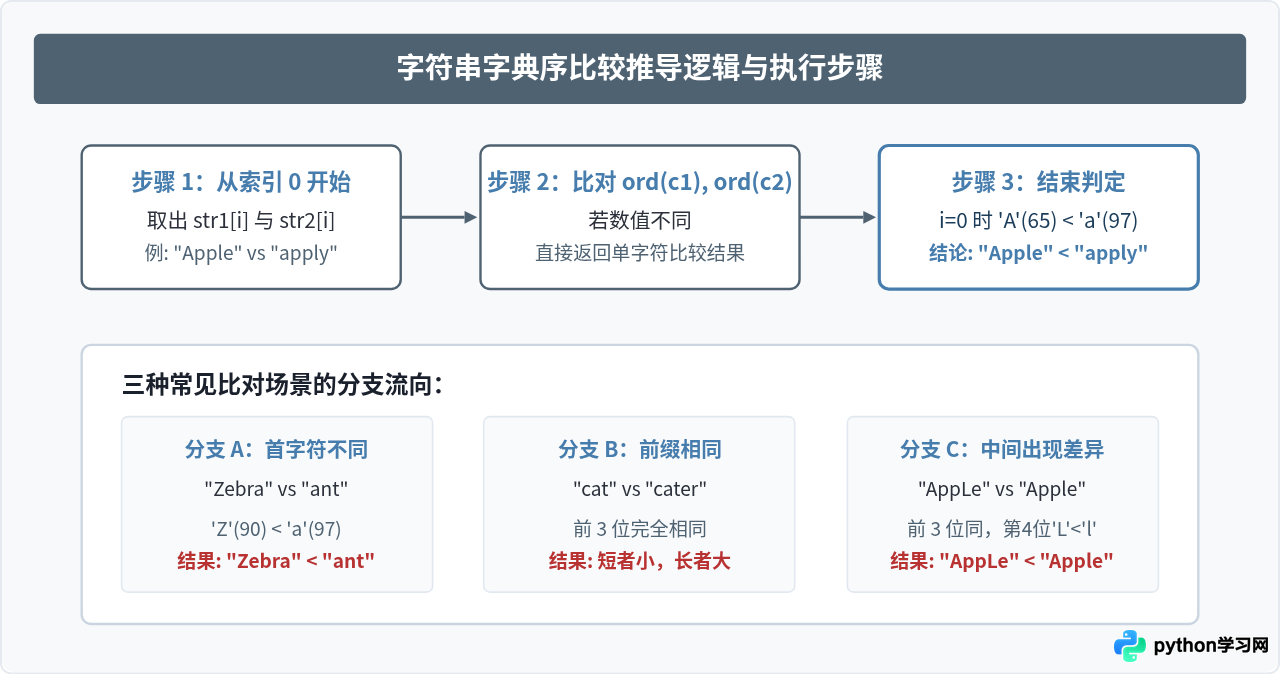
三、对列表排序的影响及忽略大小写排序方法
由于小写字母大于大写字母,Python 内置的 sorted() 函数以及列表的 sort() 方法在默认状态下,会呈现所有大写开头的单词排在所有小写开头的单词之前的现象。这通常被称为“ASCII 排序”或“机器顺序”。
# 默认排序的表现
words = ["banana", "Apple", "cherry", "Banana"]
print(sorted(words))
# 输出结果为: ['Apple', 'Banana', 'banana', 'cherry']
如果业务需求是按照常规字典的字母顺序(即不区分大小写,A/a 都排在 B/b 之前),就不能使用默认的字符比较,而需要利用 key 参数指定预处理函数:
- 使用
key=str.lower:在比较时将每个元素临时转换为小写字母比较。 - 使用
key=str.casefold:这是更推荐的现代做法。相比lower(),casefold()实现了 Unicode 完整大小写折叠算法,能正确处理德语'ß'等特殊字母的等价转换。
# 忽略大小写的自然字母序排序
words = ["banana", "Apple", "cherry", "Banana"]
sorted_words = sorted(words, key=str.casefold)
print(sorted_words)
# 输出结果为: ['Apple', 'banana', 'Banana', 'cherry']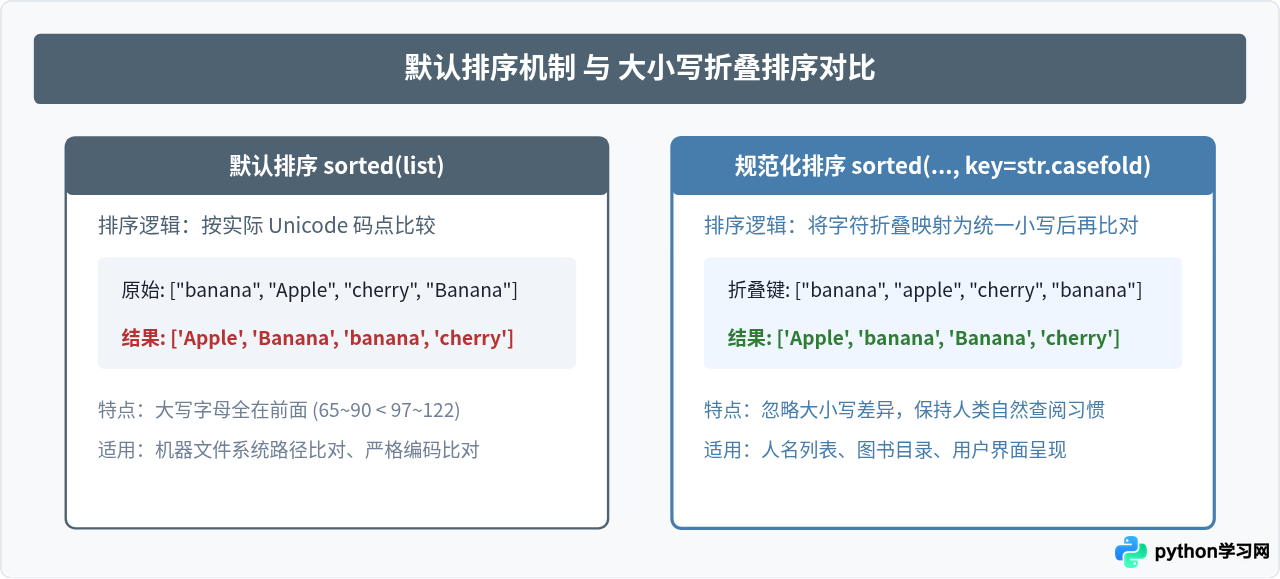
四、开发中的常见边界情况与注意事项
注意:字符串比较只能在同类型(字符串之间)发生。在 Python 3 中,尝试将字符串与数字进行比较(例如 'A' > 65)会直接抛出 TypeError: '>' not supported between instances of 'str' and 'int',Python 不会自动把字符串转为数字码点进行跨类型运算。
除了常规的英文字母,Unicode 码点比较规则还涉及以下几类开发中常遇到的情景:
| 字符分类 | 典型代表 | Unicode 码点区间 | 相对大小结论 |
|---|---|---|---|
| 数字字符 | '0' ~ '9' |
48 ~ 57 | 小于所有英文字母('9' < 'A' 为 True) |
| 大写英文字母 | 'A' ~ 'Z' |
65 ~ 90 | 大于数字字符,小于小写英文字母 |
| 常用英文标点 | '!'、'@' 等 |
33 ~ 47, 58 ~ 64 | 除个别特殊符号外,大多在字母之前 |
| 小写英文字母 | 'a' ~ 'z' |
97 ~ 122 | 大于大写字母和数字字符 |
| 中文汉字 | '中'、'国' |
19968 起 (0x4E00) | 远大于所有基础英文字母('中' > 'z' 为 True) |
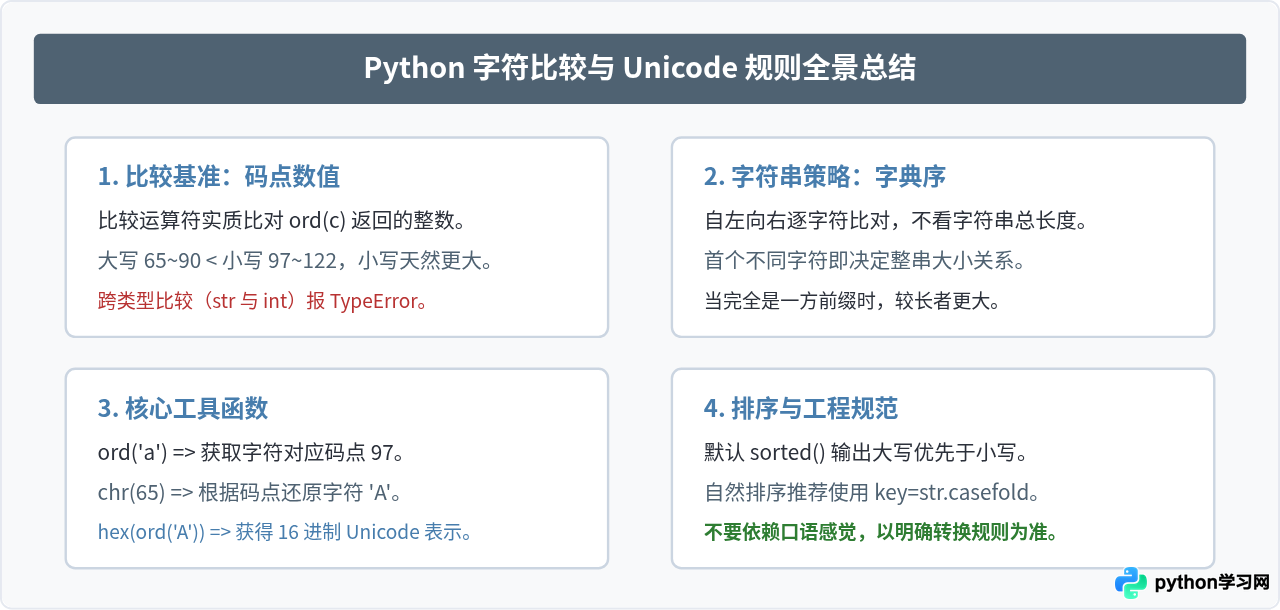
五、总结
回到文章标题的问题:在 Python 中,小写字母比大写字母更大。这一规则源于底层的编码标准定义:小写英文字母的 Unicode/ASCII 码点(97~122)大于大写英文字母(65~90)。只要理解了“字符比较本质就是整数比较”以及“多字符按字典序自左向右逐位判定”这两条核心逻辑,就能准确推导任何字符串的比较结果,并在需要自然字母排序时,熟练运用 key=str.casefold 实现符合人类直觉的排序。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









