

Python基础语法专项练习:字符串、列表与字典经典习题
针对Python基础语法中的字符串、列表与字典三大核心数据结构,提供结构化经典习题演练,涵盖回文检测、保序去重、列表分块、词频统计与字典反转,并附带执行机制图示与避坑指南。
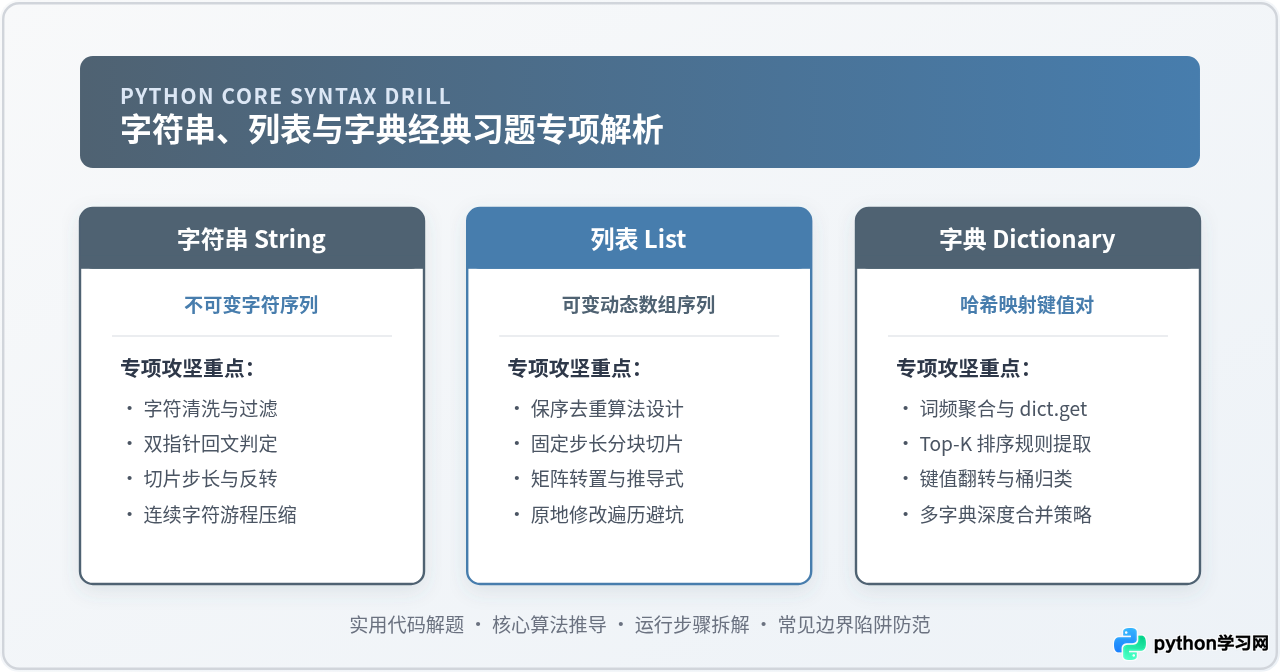
一、字符串经典专项练习
Python中的字符串是不可变序列(immutable sequence),这意味着任何对字符串的增删改操作都不会在原对象上发生,而是生成全新的字符串。在练习字符串习题时,核心考察点通常集中在切片步长运用、字符遍历清洗、双指针边界控制以及重复子序列的统计。
习题1:规范化回文串检测(忽略大小写与非字母数字)
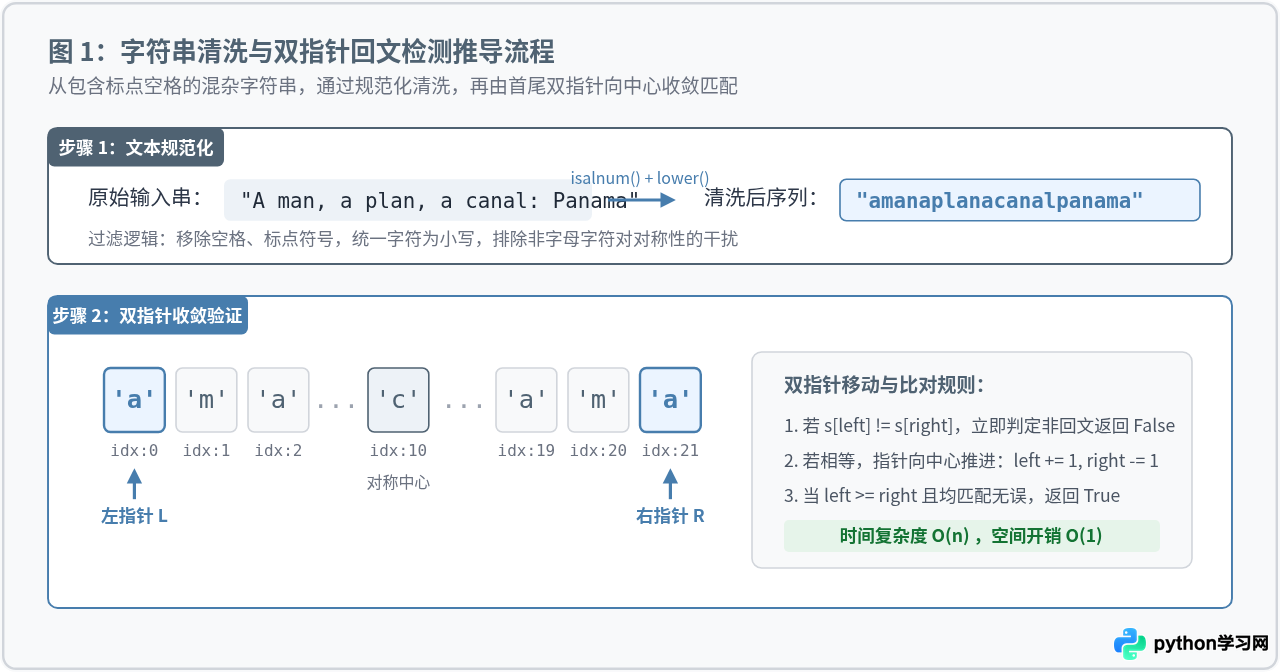
题目要求:给定一个字符串,判断其在剔除所有非字母、非数字字符并将全部字母转换为小写之后,是否属于回文串(正读与反读完全一致)。要求代码具备良好的时间与空间表现。
解题思路:解决该题有两种主流思路。第一种是先通过列表推导或生成器清洗字符串,保留 c.isalnum() 的字符并调用 lower(),随后与切片反转 s[::-1] 比较;第二种则是利用首尾双指针向中心推进,空间复杂度可优化至 O(1)。以下展示两种实现并进行对比。
def is_palindrome_slice(s: str) -> bool:
    # 步骤1:清洗非字母数字并统一小写
    cleaned = ''.join(ch.lower() for ch in s if ch.isalnum())
    # 步骤2:利用切片步长-1进行反转对比
    return cleaned == cleaned[::-1]

def is_palindrome_twopointer(s: str) -> bool:
    left, right = 0, len(s) - 1
    while left < right:
        # 跳过左侧非字母数字
        while left < right and not s[left].isalnum():
            left += 1
        # 跳过右侧非字母数字
        while left < right and not s[right].isalnum():
            right -= 1
        # 大小写不敏感比对
        if s[left].lower() != s[right].lower():
            return False
        left += 1
        right -= 1
    return True

# 验证测试用例
test_case_1 = "A man, a plan, a canal: Panama"
test_case_2 = "race a car"
print("测试样例1结果(切片法):", is_palindrome_slice(test_case_1))
print("测试样例1结果(双指针):", is_palindrome_twopointer(test_case_1))
print("测试样例2结果(双指针):", is_palindrome_twopointer(test_case_2))测试样例1结果(双指针): True
测试样例2结果(双指针): False
习题2:连续重复字符游程压缩
题目要求:实现一个简易字符串压缩函数,将连续出现的相同字符替换为“字符+出现频次”的形式,例如 "aaabbc" 转换为 "a3b2c1"。若输入为空字符串则返回空字符串。
解题思路:维护一个当前字符指针与计数器。在遍历字符串时,比较当前字符与前一个字符是否相同:若相同则计数器加1;若不同,则将前一个字符及其计数值追加至临时结果列表中,重置计数器为1。最后务必处理字符串末尾的一组字符。避免在循环中直接使用 str += ... 进行字符串拼接,因为字符串不可变性会导致频繁分配内存,产生 O(n²) 开销;采用 list.append() 并在循环结束后 ''.join() 可将总复杂度稳定在 O(n)。
def compress_string(s: str) -> str:
    if not s:
        return ""

    parts = []
    current_char = s[0]
    count = 1

    for i in range(1, len(s)):
        if s[i] == current_char:
            count += 1
        else:
            parts.append(f"{current_char}{count}")
            current_char = s[i]
            count = 1
    # 追加最后一组字符统计
    parts.append(f"{current_char}{count}")
    return ''.join(parts)

print("压缩测试 1 ('aaabbc'):", compress_string("aaabbc"))
print("压缩测试 2 ('a'):", compress_string("a"))
print("压缩测试 3 (''):", repr(compress_string("")))压缩测试 2 ('a'): a1
压缩测试 3 (''): ''
二、列表核心专项练习
列表是Python中最灵活的可变序列(mutable sequence)。与字符串不同,列表支持原地(in-place)修改、添加与切片赋值。列表练习的重点在于掌握推导式书写、分块切片算法、多维列表处理,以及避免在原地循环迭代中增删元素导致的“漏检”与“索引越界”。
习题3:列表去重并严格保持初始出现顺序
题目要求:给定包含重复项的列表,去除其中重复出现的元素,但必须保留元素第一次出现时的相对先后顺序。
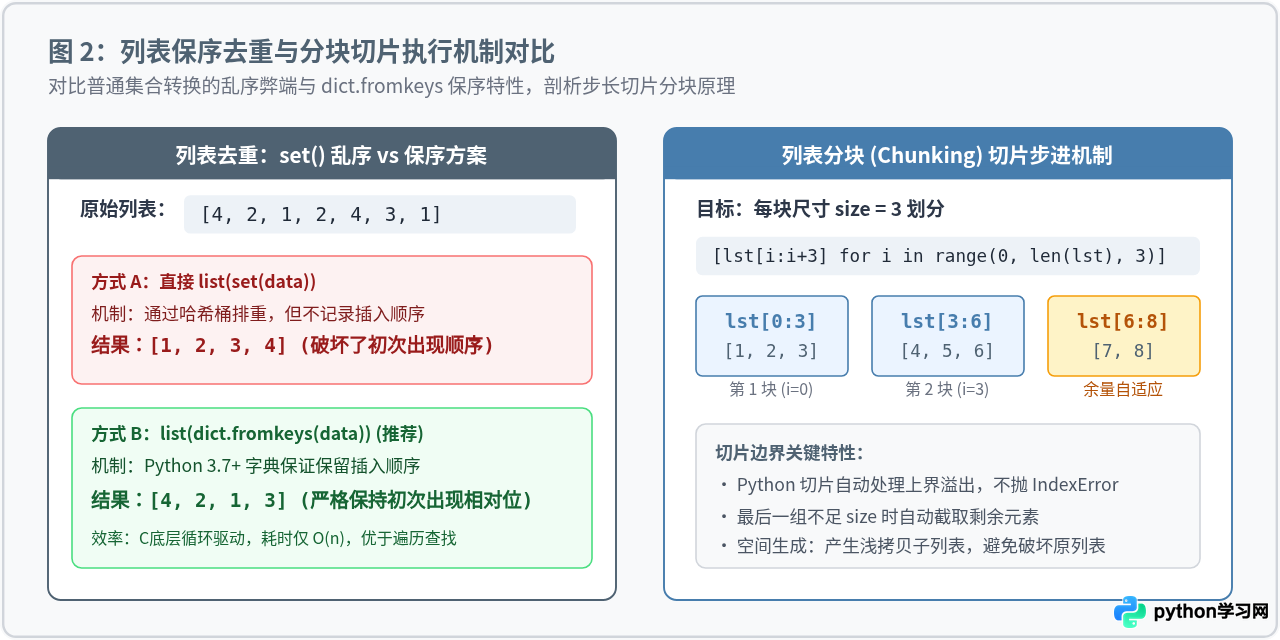
解题思路:若直接调用 list(set(data)),集合内部根据哈希值排布桶,会彻底破坏原有的相对顺序。常见保序解法有两种:一是利用辅助 seen = set() 配合列表推导式;二是利用 Python 3.7+ 字典保证插入顺序的语言规范,调用 list(dict.fromkeys(data))。后者完全在底层C代码中执行,性能优秀且语法最为精简。
def deduplicate_keep_order(items: list) -> list:
    # 方式一:利用 Python 3.7+ 字典保序特性(效率最高)
    return list(dict.fromkeys(items))

def deduplicate_with_seen(items: list) -> list:
    # 方式二:辅助集合法(适用于元素较多需精细控制的场景)
    seen = set()
    result = []
    for x in items:
        if x not in seen:
            seen.add(x)
            result.append(x)
    return result

sample_data = [4, 2, 1, 2, 4, 3, 1, 5]
print("原始列表数据:       ", sample_data)
print("直接 set 去重(乱序):", list(set(sample_data)))
print("保序去重(推荐方案):", deduplicate_keep_order(sample_data))直接 set 去重(乱序): [1, 2, 3, 4, 5]
保序去重(推荐方案): [4, 2, 1, 3, 5]
习题4:列表固定尺寸分块(Chunking)与矩阵转置
题目要求:编写两个函数:函数一将一维长列表按照固定大小 size 切分成若干子列表(最后一组不足 size 时容纳剩余所有元素);函数二将给定的二维矩阵(列表嵌套列表)进行行列转置。
解题思路:分块时利用 range(0, len(lst), size) 产生步长,配合切片 lst[i:i+size];Python 切片会自动截断到列表末尾,天然具备安全边界。转置二维矩阵时,既可以使用列表推导式提取每一列,也可以利用 zip(*matrix) 进行解包重组。
def chunk_list(lst: list, size: int) -> list:
    if size <= 0:
        raise ValueError("分块大小 size 必须大于 0")
    return [lst[i:i + size] for i in range(0, len(lst), size)]

def transpose_matrix(matrix: list) -> list:
    if not matrix or not matrix[0]:
        return []
    # 列表推导式形式:按列索引遍历
    cols = len(matrix[0])
    return [[row[c] for row in matrix] for c in range(cols)]

numbers = [1, 2, 3, 4, 5, 6, 7, 8]
print("分块处理 (size=3):", chunk_list(numbers, 3))

matrix_demo = [
    [1, 2, 3],
    [4, 5, 6]
]
print("转置前矩阵:", matrix_demo)
print("转置后矩阵:", transpose_matrix(matrix_demo))转置前矩阵: [[1, 2, 3], [4, 5, 6]]
转置后矩阵: [[1, 4], [2, 5], [3, 6]]
三、字典高频专项练习
字典是Python中的键值对哈希映射容器(hash map)。字典的键必须是可哈希(hashable)对象,即不可变对象(如字符串、整数、元组),而值可以是任何对象。字典的查询、插入与更新平均时间复杂度为 O(1)。掌握字典习题的核心在于熟悉 get() 与 setdefault() 默认值处理、多规则排序以及多字典合并。
习题5:高频单词统计与Top-K提取
题目要求:统计一组文本中每个单词的出现频次,并返回出现频次最高的前 k 个单词。当频次相同时,按单词字典序升序排列。
解题思路:首先使用常规字典结合 freq[word] = freq.get(word, 0) + 1 累加计数;随后使用 sorted() 对键值对排序,定义多重键规则 key=lambda x: (-x[1], x[0]),负号代表频次降序,x[0] 代表字典序升序;最后截取前 k 项返回。
def top_k_frequent_words(words: list, k: int) -> list:
    # 步骤1:字典词频统计
    freq = {}
    for w in words:
        freq[w] = freq.get(w, 0) + 1

    # 步骤2:多维度排序(-频次 降序,单词 升序)
    sorted_items = sorted(freq.items(), key=lambda item: (-item[1], item[0]))

    # 步骤3:截取前 k 个键名
    return [item[0] for item in sorted_items[:k]]

word_list = ["apple", "banana", "apple", "cherry", "banana", "banana", "date"]
print("Top-2 高频词:", top_k_frequent_words(word_list, 2))
print("Top-3 高频词:", top_k_frequent_words(word_list, 3))Top-3 高频词: ['banana', 'apple', 'cherry']
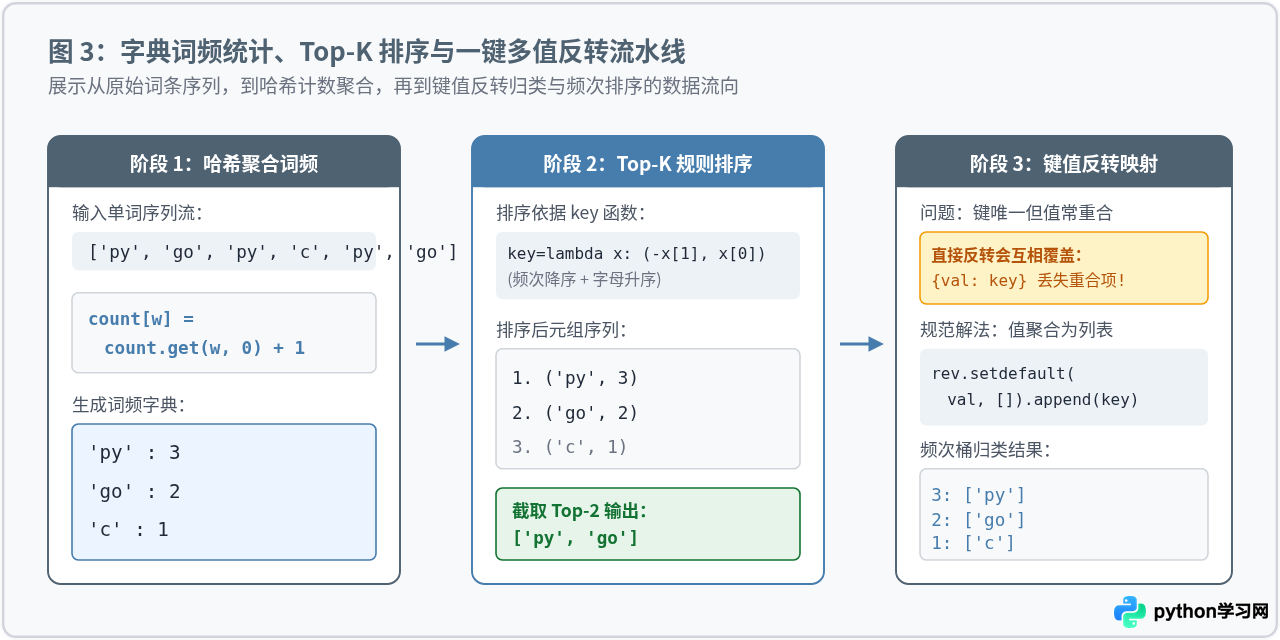
习题6:字典反转与一键多值归类(解决重复值覆盖问题)
题目要求:将一个给定字典的键与值对调。如果原字典中存在多个不同的键映射到同一个值(即值重复),反转后的字典必须将原有的所有键聚合成一个列表,而不能直接覆盖。
解题思路:若直接写 {v: k for k, v in d.items()},当出现相同 v 时,后出现的键会无情覆盖前面的键,造成数据丢失。标准解法是遍历原字典,以 v 作为新字典的键,利用 setdefault(v, []).append(k) 将每个原键追加进对应的列表中。
def invert_dict_grouped(source: dict) -> dict:
    inverted = {}
    for k, v in source.items():
        # 若键 v 不存在则先初始化为空列表,然后执行 append
        inverted.setdefault(v, []).append(k)
    return inverted

student_courses = {
    "Alice": "Math",
    "Bob": "Physics",
    "Charlie": "Math",
    "David": "Chemistry",
    "Eva": "Physics"
}

inverted_result = invert_dict_grouped(student_courses)
print("学生-选课映射:", student_courses)
print("课程-学生反转分组:", inverted_result)课程-学生反转分组: {'Math': ['Alice', 'Charlie'], 'Physics': ['Bob', 'Eva'], 'Chemistry': ['David']}
四、综合实战演练与高频易错陷阱
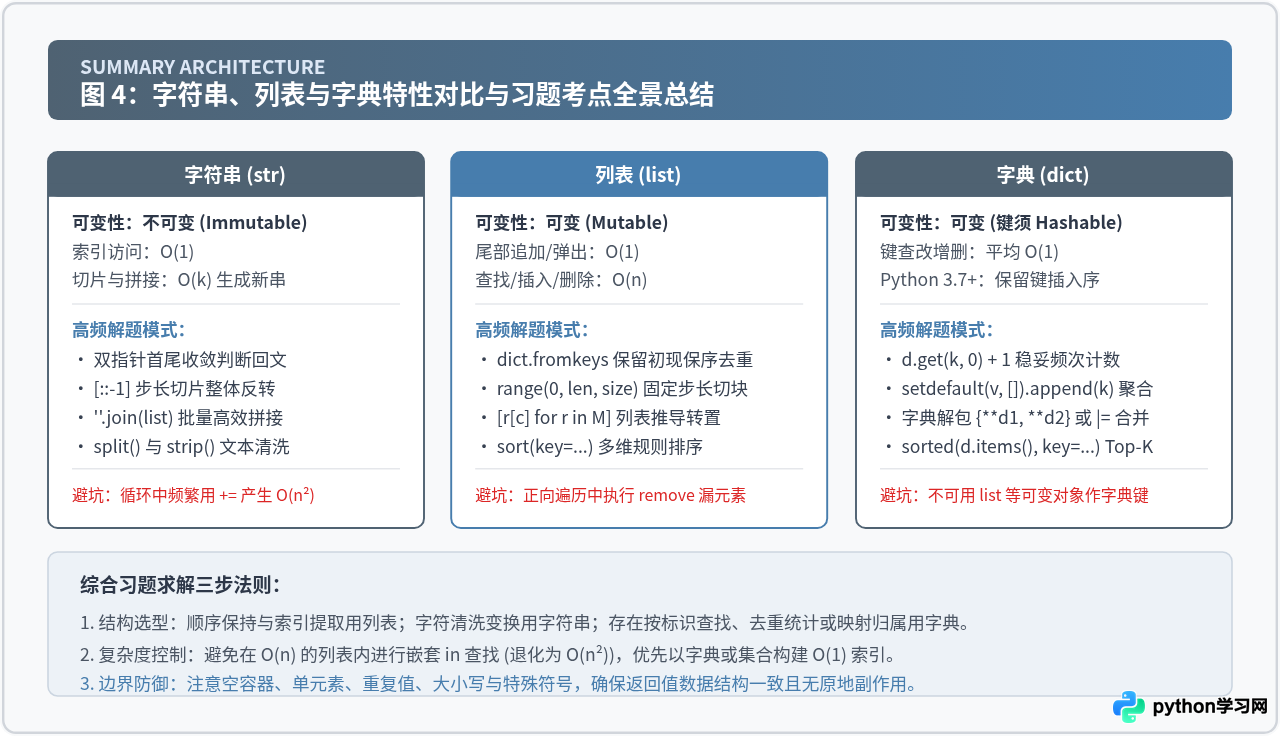
在实际工程中,极少有单一数据结构的孤立操作。综合场景往往需要“字符串解析 -> 列表清洗筛选 -> 字典哈希聚合”贯通协同。以下通过一段典型的结构化日志解析实例展示三大结构的联合运用,并梳理初学者最常踩入的避坑清单。
习题7:综合场景——日志流水数据解析与分类统计
题目要求:给定一段服务器请求原始日志字符串,格式形如 "GET /api/user 200\nPOST /api/login 401\nGET /api/user 200"。请统计各个路径的请求次数以及状态码分布情况。
def parse_and_aggregate_logs(raw_log: str) -> dict:
    # 步骤1:利用字符串按行分割与空白切分
    lines = raw_log.strip().splitlines()
    summary = {}

    for line in lines:
        parts = line.strip().split()
        if len(parts) != 3:
            continue
        method, path, status_code = parts

        # 步骤2:字典嵌套结构初始化与累计
        if path not in summary:
            summary[path] = {"total_requests": 0, "status_counts": {}}

        summary[path]["total_requests"] += 1
        sub_status = summary[path]["status_counts"]
        sub_status[status_code] = sub_status.get(status_code, 0) + 1

    return summary

log_sample = """
GET /api/user 200
POST /api/login 401
GET /api/user 200
GET /api/order 200
POST /api/login 200
"""

log_report = parse_and_aggregate_logs(log_sample)
for path, data in log_report.items():
print(f"路径 {path}: 总请求 {data['total_requests']}, 状态码分布 {data['status_counts']}")路径 /api/login: 总请求 2, 状态码分布 {'401': 1, '200': 1}
路径 /api/order: 总请求 1, 状态码分布 {'200': 1}
- 不可在正向遍历列表时执行
remove或del:删除元素会导致列表长度缩短、后方元素下标前移,而遍历游标依然单调递增,必然导致紧随其后的相邻重复项被直接跳过漏检。若需边遍历边筛选,请使用列表推导式生成新列表,或倒序遍历for i in range(len(lst)-1, -1, -1)。 - 切勿使用可变对象(如列表、字典)作为字典的键:字典通过哈希值定位底层桶槽。列表等可变对象没有固定的哈希值(未实现
__hash__),直接用作键会抛出TypeError: unhashable type: 'list'。若需复合键,可转换为不可变元组tuple(lst)。 - 注意
dict.get()与布尔真值判断的边界:当字典的值本身可能为数字0、空字符串""或布尔值False时,不要写val = d.get(k) or default_value,因为此时有效值0会被错误判定为假值从而触发默认值替代;应明确使用d.get(k, default_value)。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









