

Python基础语法详解:变量、列表与循环控制

掌握 Python 编程的第一步,是建立对数据存储与流程调度机制的精准认知。本文针对 Python 基础中最核心的三大支柱——变量命名与内存引用、列表序列的高效组织,以及 for/while 循环流程与跳转控制,进行系统性拆解与对比剖析,帮助读者从代码底层逻辑理解程序运行过程。
一、变量与对象引用机制
在许多静态类型语言(如 C 或 Java)中,变量常被视作容纳特定类型数据的“实体盒子”。但在 Python 中,变量的本质是附加在内存对象上的标签或引用指针。这一设计赋予了 Python 动态类型的灵活性,同时也决定了其独特的赋值行为。
1. 变量命名与动态赋值
Python 采用简洁的赋值语法。变量无需提前声明类型,类型由右侧被赋值的具体对象自动决定:
# 变量动态赋值示例
total_count = 10           # 整数类型 int
unit_price = 19.9          # 浮点类型 float
product_name = "智能传感器"  # 字符串类型 str
is_active = True           # 布尔类型 bool
变量命名应当遵循规范:只能使用英文字母、数字和下划线,且不能以数字开头;Python 关键字(如 if, for, class)不可作为变量名。在 PEP 8 风格指南中,推荐使用小写字母与下划线拼接的“蛇形命名法”(snake_case)。
2. 引用传递与可变性区别
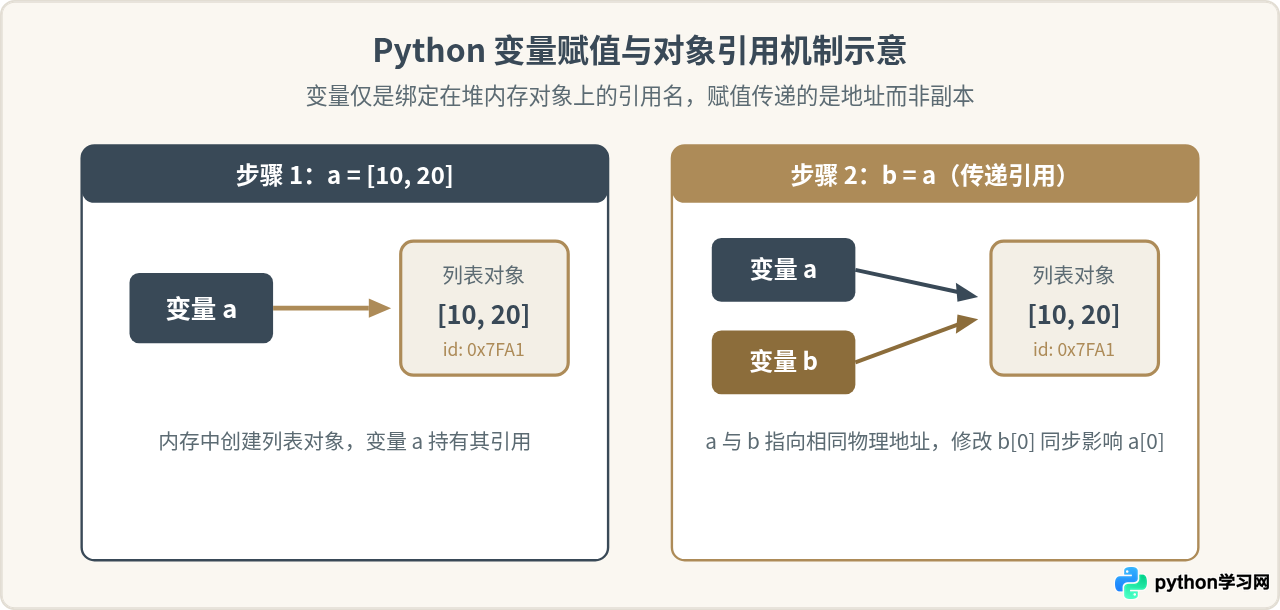
执行 a = [10, 20] 时,Python 先在堆内存中创建列表对象 [10, 20],然后让标识符 a 指向该对象所在的内存地址。如果紧接着执行 b = a,实际上并没有拷贝列表的内容,而是让 b 指向了同一个列表对象。
二、列表(List)核心操作与序列机制
列表是 Python 中最常用的可变序列类型,支持存储任意类型的对象组合,具备动态扩容能力,并提供了丰富的内置方法。
1. 正向与反向双向索引
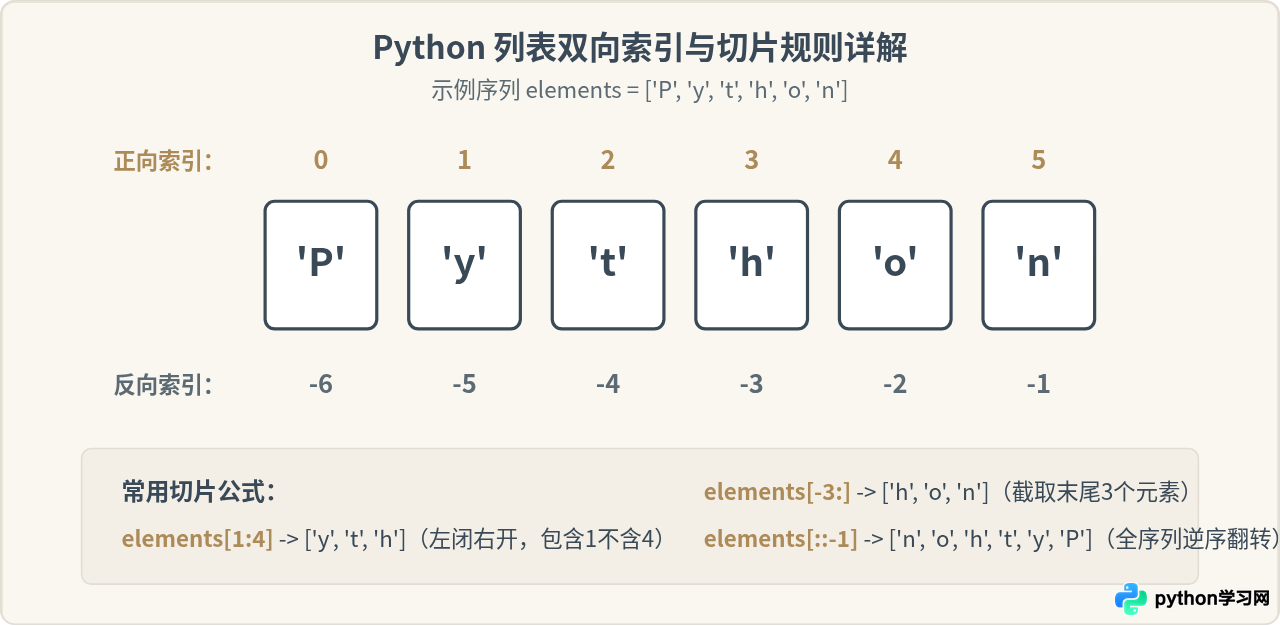
Python 列表支持双向索引机制:从序列起点向右访问时,下标从 0 依次递增;从末尾向左反向寻址时,下标从 -1 依次递减。这一设计消除了传统语言中获取尾部元素需显式计算 len(list) - 1 的繁琐。
2. 切片语法与步长控制
切片是提取子序列的核心语法,形式为 list[start:stop:step]:
- start:起始下标(包含该元素)。若省略,正向步长时默认为 0。
- stop:结束下标(不包含该元素,即左闭右开区间)。若省略,默认为序列尽头。
- step:步长与方向。为正数时正向移动,为负数时反向移动。
3. 常用内置操作方法
列表提供了丰富的就地修改方法与查询接口,常见分类如下:
| 操作方法 | 功能说明 | 复杂度 / 影响 |
|---|---|---|
list.append(x) |
在列表末尾追加单个元素 x |
时间复杂度 O(1),就地修改 |
list.extend(iterable) |
将可迭代对象中的所有元素平铺追加到末尾 | 时间复杂度 O(k),避免多层嵌套 |
list.insert(index, x) |
在指定下标处插入元素,后续元素后移 | 时间复杂度 O(n) |
list.pop([index]) |
移除并返回指定下标处的元素(默认末尾) | 末尾弹出为 O(1),指定头部为 O(n) |
list.remove(value) |
移除列表中首次出现的指定值,不存在则抛出 ValueError | 需遍历查找,时间复杂度 O(n) |
三、循环控制:for 与 while 的流程调度
循环结构用于重复执行特定业务逻辑。Python 提供了两类核心循环:基于迭代器协议的 for 循环,以及基于条件状态判定的 while 循环。
1. for 迭代循环与 range 序列
Python 的 for 循环是真正的迭代器驱动循环,它并不依赖计数器下标,而是逐一取出序列或集合中的元素:
# 方式 1:直接遍历元素
fruits = ["apple", "banana", "cherry"]
for fruit in fruits:
    print(fruit)

# 方式 2:配合 range(start, stop, step) 计数
for i in range(0, 5, 2):
    print(i)  # 输出 0, 2, 4

# 方式 3:配合 enumerate 同时获取下标与元素
for idx, item in enumerate(fruits):
    print(f"索引 {idx}: {item}")
2. while 循环与退出状态管理
while 循环在指定的布尔表达式为 True 时持续运行。编写 while 循环的关键,在于保证循环体内部必须存在能够改变判定条件的步进语句,否则将导致死循环。
3. break 与 continue 流程跳转
当遇到特定业务条件时,可以使用两个关键字控制循环跳转:
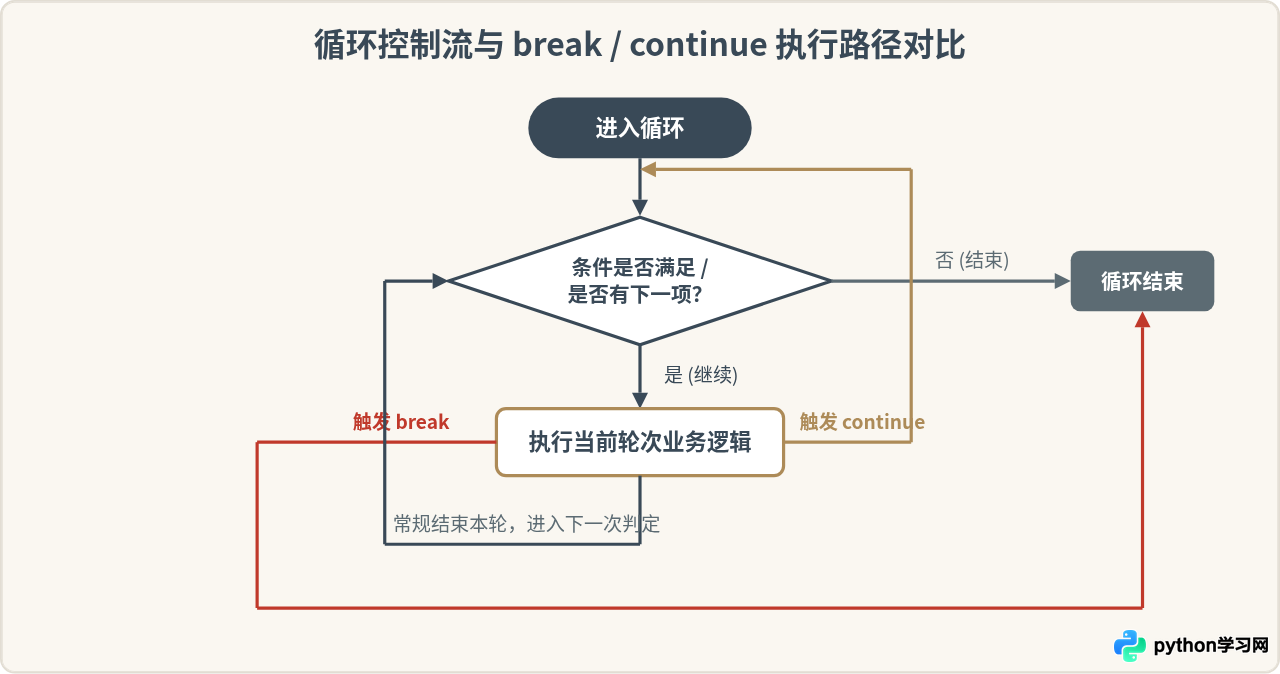
- break:彻底终结当前整个循环,程序执行点直接跳转到循环结构之后的第一行语句。
- continue:提前终止本次循环迭代,直接跳过当前轮次剩余代码,返回循环头部进行下一次条件判定。
四、常见开发陷阱与应对规范
在实际编写 Python 代码时,因混淆变量引用与循环机制引发的 Bug 非常常见。以下总结三个典型陷阱及标准解决方案。
错误示范:for item in my_list: if condition: my_list.remove(item)。
原因剖析:删除元素会导致列表长度实时收缩,后续元素的索引向前平移,而 for 循环计数器单调递增,必然导致紧随其后的元素被跳过漏检。
正确做法:遍历原列表的浅拷贝副本 for item in my_list[:]:,或者采用列表推导式构建过滤后的新列表:my_list = [x for x in my_list if not condition]。
错误示范:matrix = [[0] * 3] * 3。
原因剖析:乘法复制的是内层列表对象的指针引用。修改 matrix[0][0] = 1 会导致三行数据的首个元素全部变为 1。
正确做法:使用列表推导式生成独立的子列表对象:matrix = [[0 for _ in range(3)] for _ in range(3)]。
原因剖析:在分支较多、存在 continue 语句的 while 循环中,若更新控制变量的语句写在 continue 之后,会导致跳过步进,陷入无限循环。
正确做法:将计数器自增放在分支前,或封装在 try...finally 块中保证步进必执行。
五、综合架构总结与速查体系
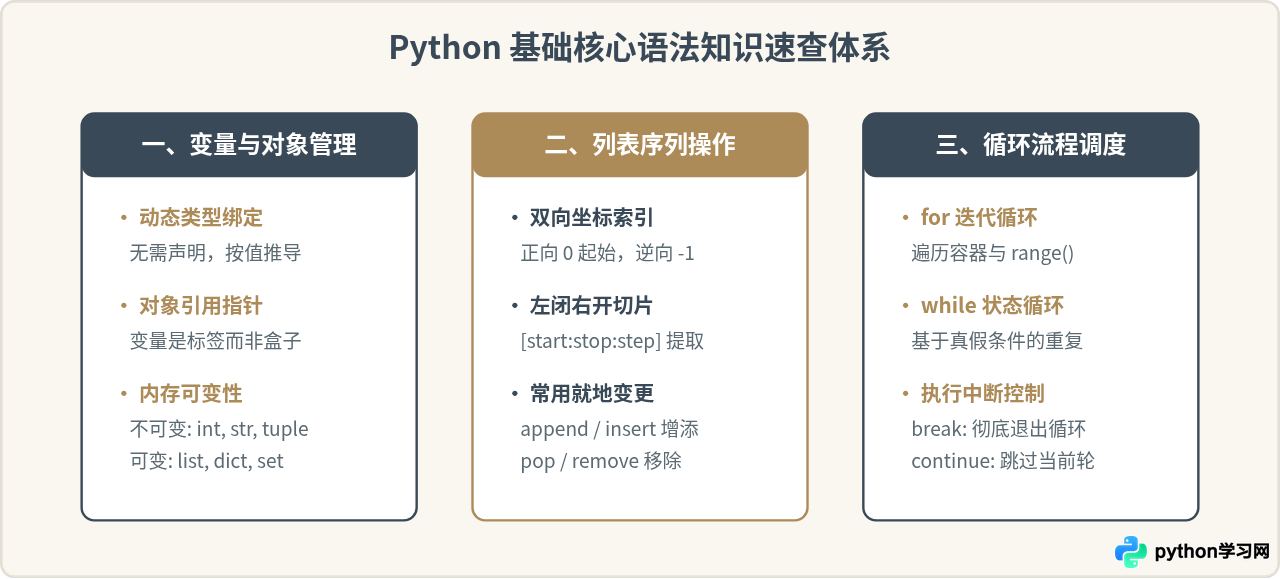
综合运用变量、列表和循环,是解决复杂编程问题的前提。下图提炼了三者之间的依赖与协作关系:
结语
变量是数据的指引,列表是数据的集合容器,而循环控制则是程序按照预定逻辑自动化运转的驱动引擎。厘清三者的内在关联,能够有效避免引用共享与动态遍历中的隐蔽问题,为后续深入面向对象编程、函数式抽象以及数据处理奠定坚实的语法基础。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









