

Python机器学习入门库指南:Scikit-learn与TensorFlow适用场景

许多初学者在进入Python机器学习领域时,容易被繁杂的框架名称所困扰。有时一个普通的表格回归任务被强行套用复杂的深度神经网络,耗费数小时搭建反向传播与调参,最终表现反而不及普通随机森林;而面对非结构化的图像分类或文本生成时,又试图用简单的统计模型硬解,导致特征工程难以维系。理解Scikit-learn与TensorFlow的本质区别,是构建有效算法方案的第一步。
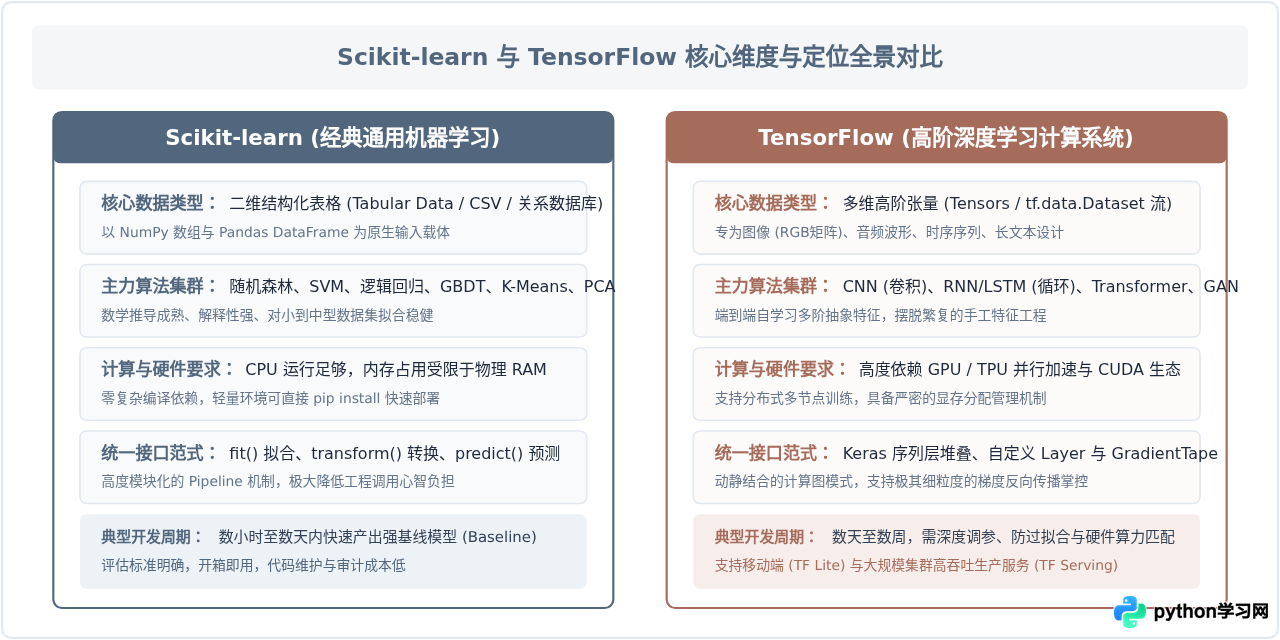
一、Scikit-learn:结构化表格数据与统计建模的标准利器
Scikit-learn(简称 sklearn)是建立在 NumPy、SciPy 和 Matplotlib 基础之上的经典机器学习工具包。如果你的项目数据是一张或几张结构化的二维数据表,例如用户订单行为、客户流失预测、房产交易特征评估、传感器时间截面指标等,Scikit-learn 几乎始终是首选方案。
1. 统一简洁的 API 设计哲学
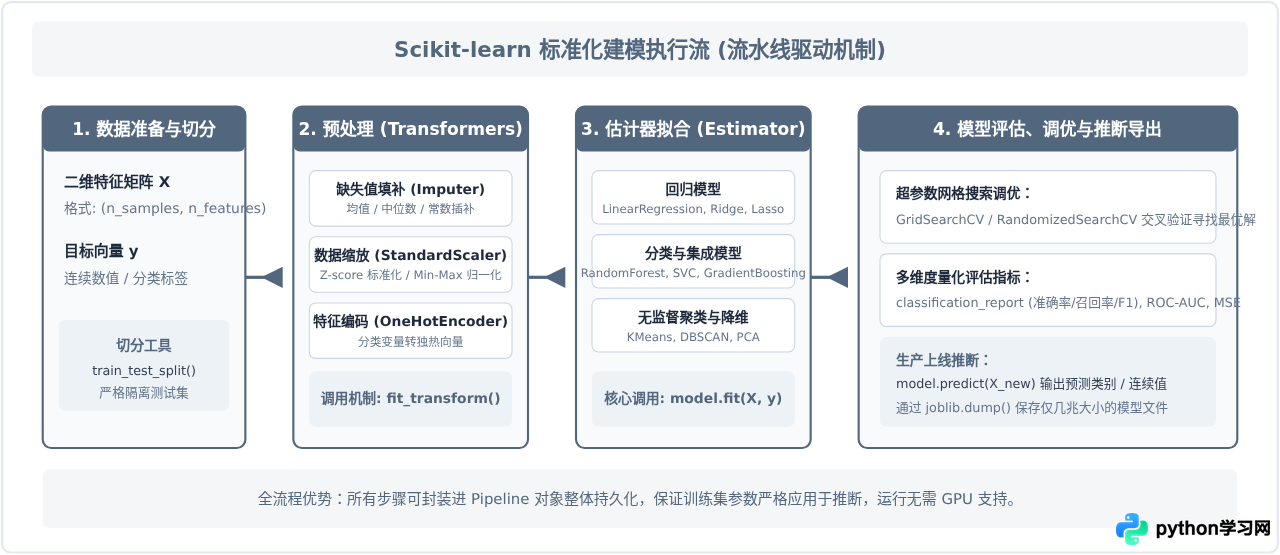
Scikit-learn 取得成功的最关键因素之一是其严格一致的面向对象接口范式。无论你调用的是最简单的线性回归,还是高维支持向量机或随机森林,调用方式高度统一:
- Estimator(估计器):所有模型都通过
model.fit(X_train, y_train)学习参数; - Transformer(转换器):用于特征预处理的工具(如标准化
StandardScaler)统一遵循fit_transform()与transform()机制,杜绝数据泄露; - Predictor(预测器):训练完成后通过
model.predict(X_test)或predict_proba()输出标签或概率。
2. Scikit-learn 最小可运行实战代码
以下示例展示了从数据集加载、训练集/测试集切分、数据标准化到随机森林分类器训练与评估的完整可运行代码。你可以将其直接保存为本地 Python 脚本运行:
import numpy as np
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report, accuracy_score

# 1. 加载经典分类数据集 (30个连续特征的表格数据)
data = load_breast_cancer()
X, y = data.data, data.target

# 2. 严格切分训练集与测试集 (分层抽样)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# 3. 特征工程:仅在训练集上拟合均值方差,并在测试集上应用相同变换
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

# 4. 构建并拟合分类估计器
clf = RandomForestClassifier(n_estimators=100, max_depth=5, random_state=42)
clf.fit(X_train_scaled, y_train)

# 5. 测试集预测与指标评估
y_pred = clf.predict(X_test_scaled)
print(f"测试集准确率: {accuracy_score(y_test, y_pred):.4f}")
print("\n分类指标明细:")
print(classification_report(y_test, y_pred, target_names=data.target_names))代码运行说明:上述脚本仅需普通 Python CPU 环境即可在不到 1 秒内完成。运行后将输出约 95% 以上的高准确率及精确率、召回率指标。对于结构化表格数据,随机森林与梯度提升树往往能在极短时间内达到接近理论上限的性能。
二、TensorFlow:非结构化数据与深度网络的工业级框架
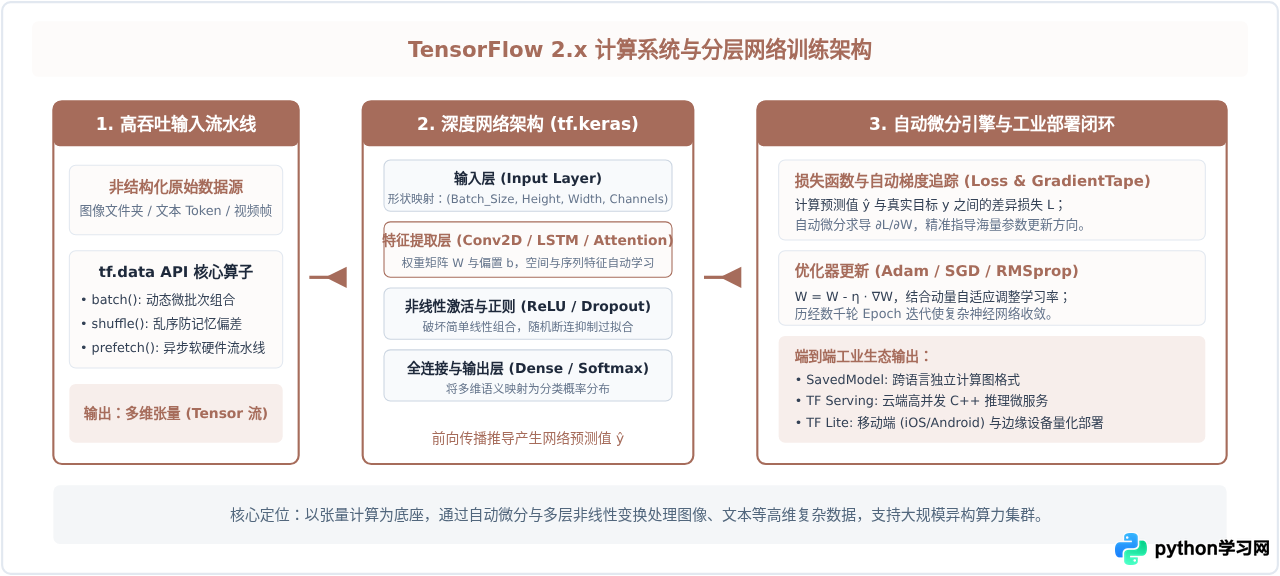
当输入数据从整齐的二维数字表格转向复杂的高维感知数据——如分辨率为 256x256 的彩色图像、变长语音信号、长篇自然语言文本,或是需要学习非线性时序依赖的复杂系统时,手工提取特征变得极其困难,Scikit-learn 的传统统计算法开始面临维度灾难。此时,TensorFlow 与深度神经网络大显身手。
1. TensorFlow 的核心机制
- 张量 (Tensor) 与图计算:输入由标量扩展为多维张量。在底层,TensorFlow 2.x 采用 Eager Execution(动态执行)保证调试直观,同时通过
@tf.function装饰器一键转化为高性能静态计算图; - Keras 高阶抽象:在早期版本中,定义一个全连接层需要手动声明权重和偏置张量变量;而在集成 Keras 后,只需堆叠
layers.Dense或layers.Conv2D; - 生态级工程部署能力:TensorFlow 不仅是一个算法包,它拥有完善的工业基础设施(TF Serving 提供微秒级 RPC 接口,TF Lite 针对移动端边缘设备剪枝量化)。
2. TensorFlow 最小可运行实战代码
以下示例展示如何利用 tf.keras 搭建一个多层感知机(MLP)网络,完成数据的分批次训练与评估:
import tensorflow as tf
from tensorflow import keras
from tensorflow.keras import layers
import numpy as np

# 1. 模拟生成结构化多维数据 (1000个样本,20个输入维度,3分类任务)
np.random.seed(42)
X_dummy = np.random.randn(1000, 20).astype(np.float32)
y_dummy = np.random.randint(0, 3, size=(1000,)).astype(np.int32)

# 2. 利用 tf.data 封装高效流式数据管道
train_ds = tf.data.Dataset.from_tensor_slices((X_dummy[:800], y_dummy[:800])).shuffle(500).batch(32)
test_ds = tf.data.Dataset.from_tensor_slices((X_dummy[800:], y_dummy[800:])).batch(32)

# 3. 采用 Sequential 容器构建深度神经网络
model = keras.Sequential([
    layers.Input(shape=(20,)),
    layers.Dense(64, activation='relu'),
    layers.Dropout(0.2),  # 引入 Dropout 减轻过拟合风险
    layers.Dense(32, activation='relu'),
    layers.Dense(3, activation='softmax')  # 3分类输出各类别概率
])

# 4. 配置优化器、损失函数与监控指标
model.compile(
    optimizer=keras.optimizers.Adam(learning_rate=0.001),
    loss=keras.losses.SparseCategoricalCrossentropy(),
    metrics=['accuracy']
)

# 5. 执行模型训练
history = model.fit(train_ds, validation_data=test_ds, epochs=10, verbose=1)

# 6. 验证集结果评估
loss, acc = model.evaluate(test_ds, verbose=0)
print(f"\nTensorFlow 模型评估完成 - 测试集损失: {loss:.4f}, 准确率: {acc:.4f}")代码运行说明:上述脚本使用 Keras 声明了 2 个隐藏层并加入激活函数。如果计算机具备 NVIDIA GPU 且配置了 CUDA 环境,TensorFlow 将自动把计算图分发至 GPU 执行;若仅有 CPU,它也会自动降级运行,但对于大网络而言 CPU 耗时会大幅增加。
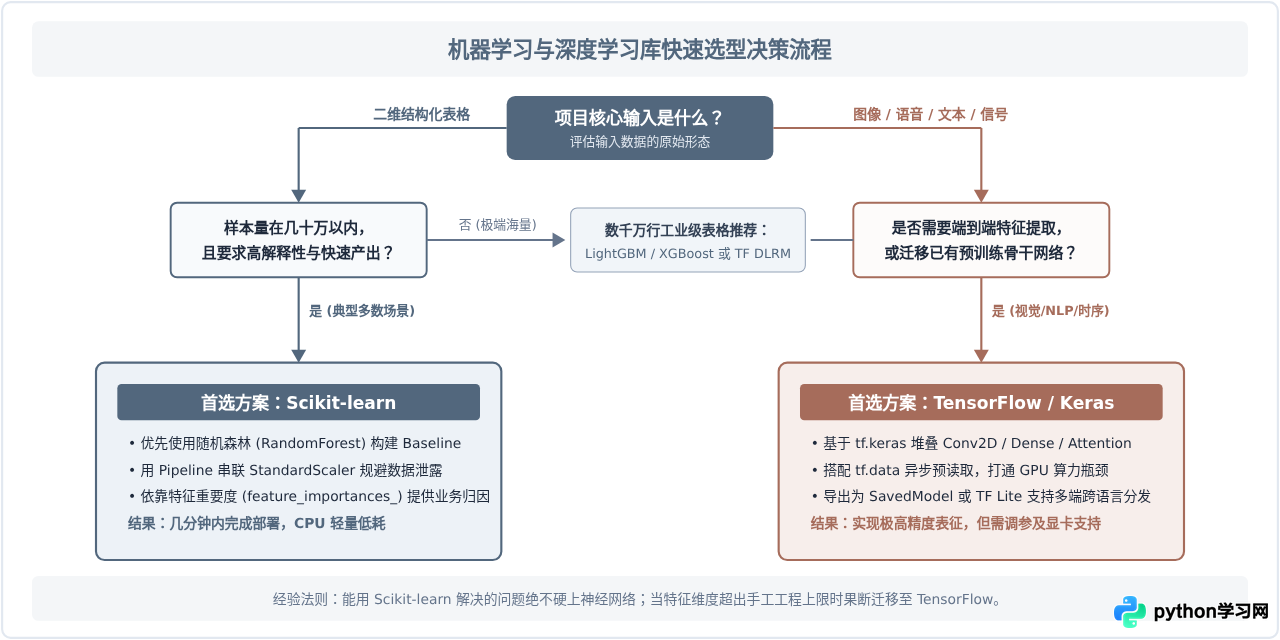
三、适用场景横向对比与选型决策树
在面对具体的业务与学习需求时,应该如何抉择?下表总结了两者的技术选型核心考量:
| 考量维度 | Scikit-learn 适用场景 | TensorFlow 适用场景 |
|---|---|---|
| 数据形态 | 表格型数据、关系型数据库导出、CSV、数值型特征矩阵 | 图像、视频帧、语音音频、长篇文本、复杂拓扑关系 |
| 数据样本规模 | 几百条到几十万条(受物理内存直接约束) | 百万级、千万级以上,支持流式批次读取 |
| 硬件依赖与算力 | 纯 CPU 即可高效运行,几乎无显存要求 | 高度依赖英伟达 GPU / 专用 TPU 硬件集群加速 |
| 解释性与合规性 | 极高(线性系数、决策树路径、特征重要度明确) | 黑盒属性强,通常依赖 Grad-CAM、SHAP 间接归因 |
| 开发与维护成本 | 几行代码即可构建基线,超参数调优直观稳定 | 网络架构设计复杂,学习率、正则、批大小调参成本高 |
| 工业部署生态 | 以轻量级序列化文件(.pkl / .joblib)为主,嵌入微服务 | TF Serving 高并发微服务、TF Lite 边缘端推理、TF.js 网页端 |
四、实际工程中的协作模式与常见避坑指南
在实际生产环境中,Scikit-learn 与 TensorFlow 往往不是非此即彼的对立关系,成熟的数据团队通常将二者结合使用:
1. 前后串联的协同范式
- 前置探索与快速基线(Baseline):无论最终是否需要深度模型,在拿到业务数据的第一时间,先用 Scikit-learn 的逻辑回归或决策树跑出一个 baseline,能够迅速检验数据质量、是否存在严重的数据泄露或标签失衡,并以此作为后续复杂深度模型的及格线;
- 轻量级数据降维与特征初筛:利用 Scikit-learn 中的
PCA或特征选择器过滤上千个稀疏特征,缩减输入维度后再传入神经网络,可以大幅缩短 TensorFlow 的反向传播训练时长。
1. 不要在小样本表格数据上过度迷信深度学习:当样本量只有数百或数千条时,深度神经网络庞大的参数空间极易在训练集上迅速过拟合,且缺乏可解释性,最终泛化能力往往显著弱于正则化后的岭回归或支持向量机。
2. 注意数据缩放的上下文隔离:无论是使用 sklearn 的
StandardScaler 还是深度学习的标准化,必须严格遵守“仅使用训练集(train set)拟合均值与方差,再变换测试集”的原则,绝不可在切分前对整体数据调用 fit_transform,否则将产生隐蔽的数据泄露。
五、总结
对于 Python 机器学习的初学者而言,理清库的边界是建立系统化工程思维的前提:
- 如果你的任务是统计分析、表格数据挖掘、轻量级分类回归或无监督聚类,优先且坚定地选择 Scikit-learn。它小巧、严谨、API 设计规范,能够让你专注于理解数据特征本身与机器学习基础原理;
- 如果你的任务涉及计算机视觉(CV)、自然语言处理(NLP)、语音处理或大规模端到端自学习网络,请选用 TensorFlow。它所提供的多维张量流、自动求导与硬件加速体系,将为你提供坚实的深度学习底座。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









