

Python并发编程实战:何时使用threading,何时切换至multiprocessing
深入解析Python中threading与multiprocessing的核心区别与选型逻辑。通过GIL原理解析、典型代码示例、进程迁移实战与常见误区剖析,帮助开发者在I/O密集型与CPU密集型任务间做出精准架构决策。
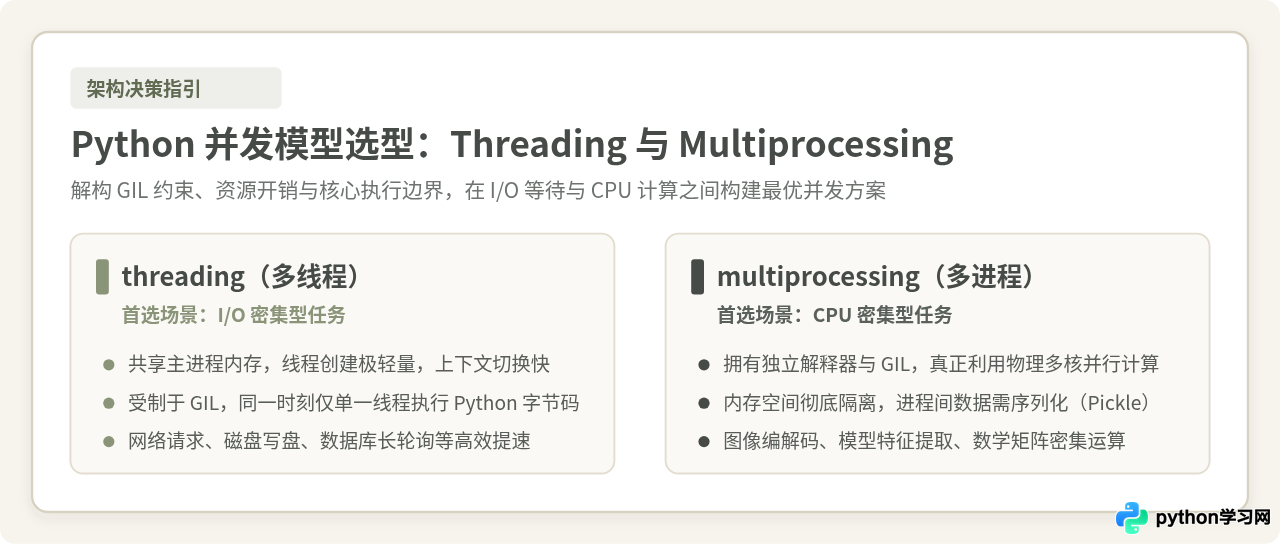
在 Python 并发编程中,选型的核心依据只有一个:任务的耗时瓶颈究竟发生在“外部 I/O 等待”还是“CPU 密集计算”。当任务大部分时间在等待网络响应、磁盘读写或数据库返回时,选用开销极小且共享内存的 threading(多线程)即可成倍提升吞吐;而当单核 CPU 占用持续达到 100%、耗时来自密集的算法逻辑或数据加工时,多线程受制于全局解释器锁(GIL)无法提速甚至会更慢,此时必须果断切换至 multiprocessing(多进程),通过独立的解释器与独立内存空间全量释放物理多核算力。
一、底层机制:为什么 Python 会产生这种并发分化?
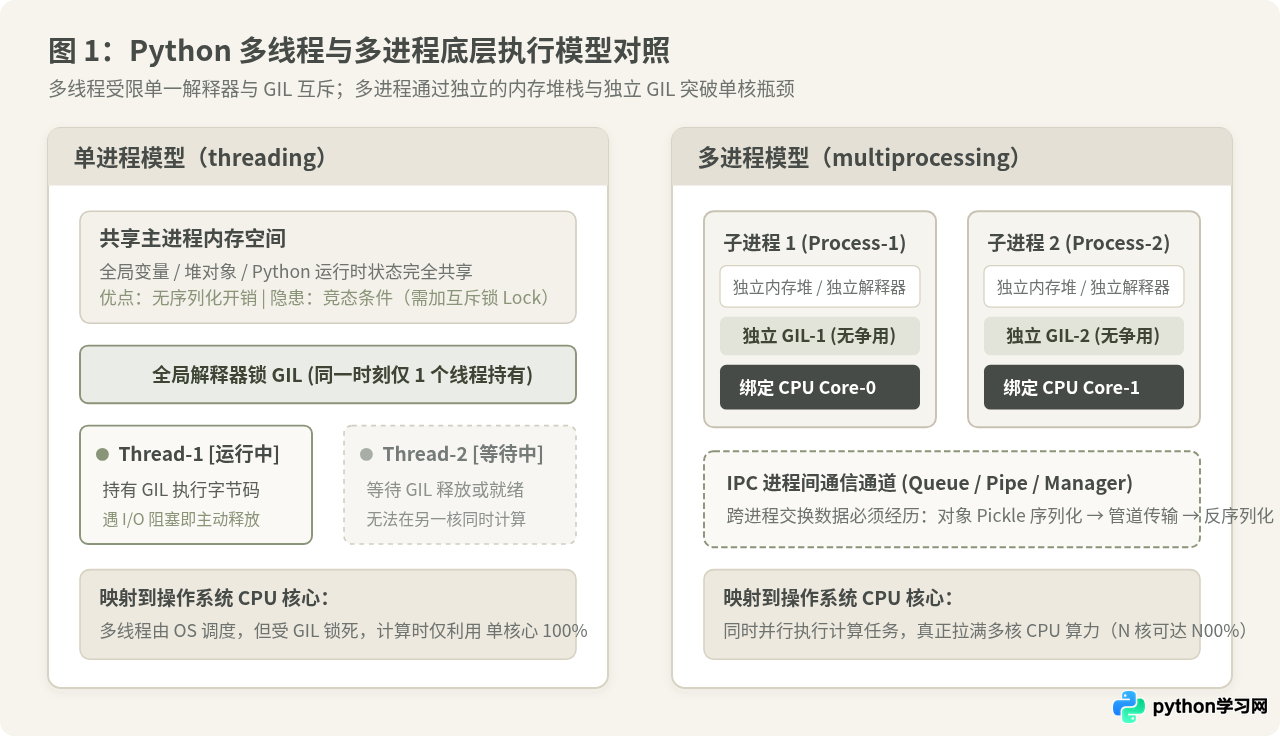
很多开发者在初次接触 Python 并发时都会遇到一个困惑:既然现代操作系统早已支持抢占式多线程调度,为什么在 Python 中启动多个线程却无法同时利用多个 CPU 核心跑满算力?答案源于 CPython 解释器的核心设计——全局解释器锁(Global Interpreter Lock,简称 GIL)。
GIL 是 CPython 内部的一个互斥同步锁。为了保障解释器内部引用计数内存管理(Reference Counting)与 C 扩展的数据安全,GIL 强制规定:在任意给定的时刻,同一个进程内只允许一个线程持有 GIL 并执行 Python 字节码。无论服务器拥有 8 核、16 核还是 64 核,同一个 Python 进程下的所有线程在执行纯 Python 代码时,本质上都是在同一枚核心上轮流交替运行。
这种说法看似合理,但实际上只在“纯 CPU 计算”场景下成立,在工程实践中是完全片面的。
成立的边界:如果你的循环体内是纯 Python 计算(例如计算斐波那契数列或遍历处理大列表),多线程确实无法提速。由于多个线程在单个核上频繁争夺 GIL 并触发操作系统上下文切换,多线程的总体耗时甚至会比单线程更长。
需要修正的关键事实:Python 线程在遇到底层 I/O 操作时(例如调用 socket.recv()、select() 或等待磁盘文件读写),会主动释放 GIL,让出控制权给其它线程运行。当网络数据包到达并触发中断时,该线程再重新申请获取 GIL 继续处理数据。因此,在 I/O 等待占主要时长的网络爬虫、API 调用与日志写入中,多线程能够重叠各个连接的等待时间,带来数倍到数十倍的性能提升。
此外,许多用 C 语言编写的高性能计算库(如 NumPy 的底层 BLAS 矩阵运算、OpenCV 图像滤波等),在进入重量级底层 C 计算循环前都会显式声明 Py_BEGIN_ALLOW_THREADS 释放 GIL。在这些场景下,即使使用 Python 的 threading,底层的 C 线程也能真正跑满多核 CPU。
二、场景推导:何时使用 threading?何时切换至 multiprocessing?
面对具体业务时,不需要凭直觉猜测,只需沿着任务特征进行系统推导。下图总结了从瓶颈定位到选型决策的完整推导路径:
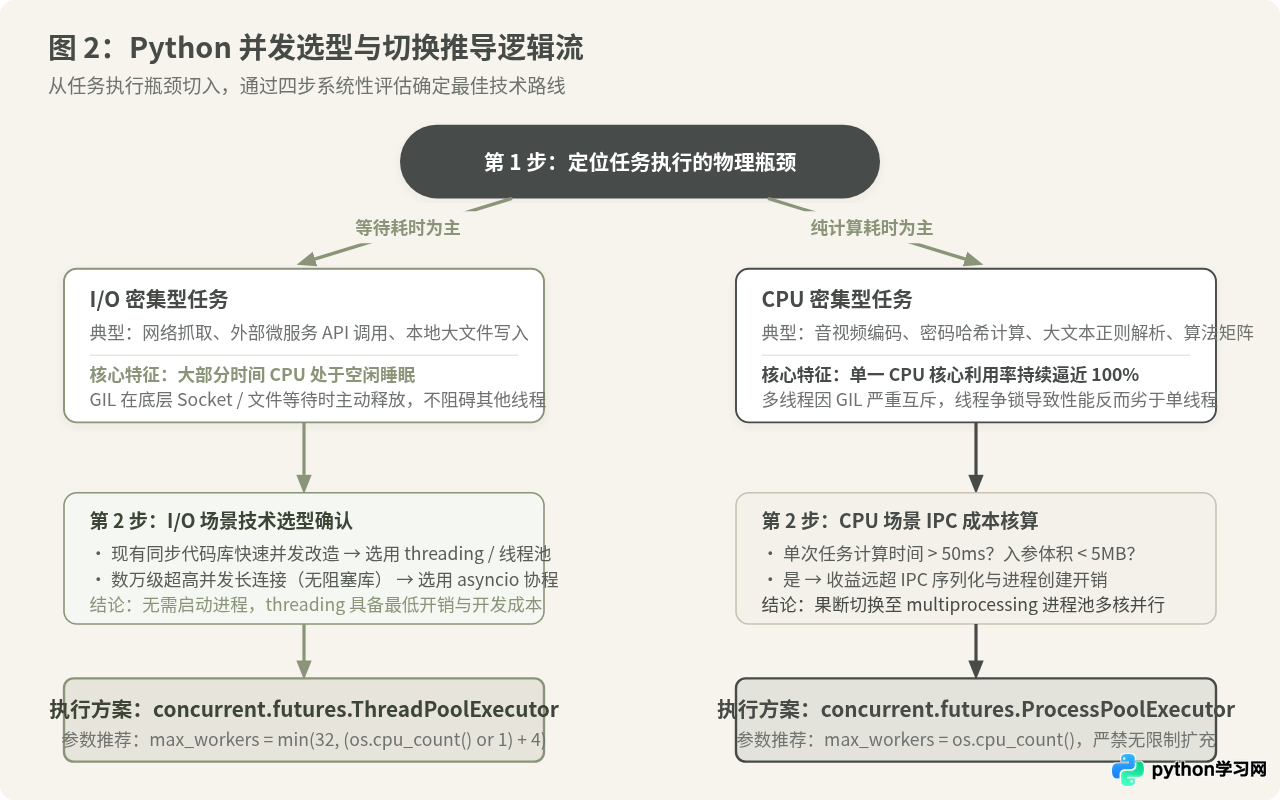
1. 坚守使用 threading 的三大典型场景
- 批量网络请求与爬虫抓取:例如同时抓取 50 个网页或调用外部第三方 API。发起 HTTP 请求只需几毫秒,但等待远程服务器响应往往需要数百毫秒至数秒。此时 CPU 完全闲置,使用轻量级的线程池(几十个线程仅占数十兆内存)即可高效并发挂起。
- 异步日志落盘与并发文件存储:将计算或网络产出的数据分发到多个本地文件或远程对象存储服务,线程可以在磁盘与网络 I/O 阻塞期间无缝交替。
-
需要频繁共享复杂内存状态的应用:多线程天生驻留在同一进程空间中,共享缓存字典、队列或内存对象无需任何序列化包装,读取效率极高(写入时只需辅以轻量级的互斥锁
threading.Lock)。
2. 必须切换至 multiprocessing 的三大触发信号
- 单核 CPU 利用率持续达到 100%,多线程耗时未降反升:任务瓶颈在于执行繁重的 Python 循环、大数据集清洗、密集文本正则匹配或自定义算法。此时单进程无法跨核扩展,必须通过多进程为每个 CPU 核心分配一个独立子进程。
-
图像处理、音视频转码与密码哈希碰撞:例如批量将用户上传的高清图片进行缩放与 WebP 压缩,或执行 PBKDF2/Argon2 密码哈希生成。这些任务在运行期间需要持续消耗算力,多进程并行能够将耗时缩短至原先的
1 / CPU物理核心数。 - 任务要求高容错隔离与内存垃圾彻底回收:某些 C 语言扩展或外部动态链接库在处理异常输入时可能发生段错误(Segmentation Fault)。在多线程下,一个线程崩溃会导致整个服务进程直接退出;而多进程下子进程崩溃被主进程捕获后可原地自动重启。此外,对于容易产生内存碎片的长周期任务,子进程执行完毕后直接销毁,操作系统会无条件回收其占据的全部物理内存。
绝对不是。在很多开发者盲目使用多进程后,常常发现性能反而急剧恶化。原因在于多进程引入了不可忽视的工程代价:
① 进程初始化与衍生开销:创建一个线程仅需分配一个几十 KB 到 1MB 的栈空间;而创建一个 Python 子进程,必须启动一个全新的解释器、加载基础模块与标准库。在 macOS 与 Windows 上,默认使用 spawn 启动模式,每次派生子进程的耗时可能长达数十至数百毫秒。
② IPC 进程间通信与 Pickle 序列化瓶颈:进程间内存相互隔离。当主进程向子进程分发任务时,所有入参都必须在主进程中通过 pickle 序列化为二进制流,经过系统管道(Pipe/Socket)传输到子进程,子进程再进行反序列化。如果向子进程传递一个 200MB 的大字典或原始矩阵,序列化与传输所耗费的时间甚至会远远超过计算本身节约的时间。
结论:只有当单次子任务的计算耗时显著大于进程启动与 IPC 传输成本时(通常子任务纯计算耗时超过 50ms),切换到多进程才能获得正向性能收益。
三、标准代码范式:基于 concurrent.futures 的统一接口
Python 标准库提供了底层的 threading.Thread 与 multiprocessing.Process,但在现代生产开发中,强烈建议优先使用 concurrent.futures 模块。它通过统一的 Executor 抽象,让多线程与多进程的代码骨架保持一致,大大降低了迁移和维护难度。
1. threading 标准范式:批量下载与网络请求
在 I/O 密集型任务中,使用 ThreadPoolExecutor。线程数可以合理上浮,通常设为 min(32, (os.cpu_count() or 1) + 4) 或更高(视下游服务的承受能力而定):
import time
import urllib.request
from concurrent.futures import ThreadPoolExecutor, as_completed

# 模拟待请求的 URL 列表(I/O 密集型)
URL_TARGETS = [
    "https://httpbin.org/delay/1",
    "https://httpbin.org/delay/1",
    "https://httpbin.org/delay/1",
    "https://httpbin.org/delay/1",
]

def fetch_url(url: str, timeout: int = 5) -> dict:
    """单个网络请求任务:I/O 等待时自动释放 GIL"""
    start = time.perf_counter()
    req = urllib.request.Request(url, headers={"User-Agent": "Mozilla/5.0"})
    with urllib.request.urlopen(req, timeout=timeout) as resp:
        content_length = len(resp.read())
    cost = time.perf_counter() - start
    return {"url": url, "size": content_length, "cost_sec": round(cost, 2)}

def run_io_tasks():
    # I/O 密集型可适度调大工作线程数(例如 8 ~ 32)
    with ThreadPoolExecutor(max_workers=4) as executor:
        future_map = {executor.submit(fetch_url, url): url for url in URL_TARGETS}
        for future in as_completed(future_map):
            url = future_map[future]
            try:
                res = future.result()
                print(f"[成功] {res['url']} 耗时: {res['cost_sec']}s, 长度: {res['size']}")
            except Exception as exc:
                print(f"[失败] {url} 产生异常: {exc}")

if __name__ == "__main__":
    start_total = time.perf_counter()
    run_io_tasks()
    print(f"多线程总运行耗时: {time.perf_counter() - start_total:.2f} 秒")
2. multiprocessing 标准范式:密集型数学与散列计算
在 CPU 密集型任务中,使用 ProcessPoolExecutor。工作进程数通常精准设置为机器的物理核心数(os.cpu_count()),防止进程过多引发操作系统频繁换页与调度抖动:
import hashlib
import os
import time
from concurrent.futures import ProcessPoolExecutor

# 必须位于模块顶层,确保可被子进程 pickle 序列化导入
def cpu_intensive_hash(seed: int) -> tuple:
    """纯 CPU 密集运算:寻找满足前导零条件的散列值"""
    target_prefix = "00000"
    nonce = 0
    start = time.perf_counter()
    while True:
        payload = f"task_{seed}_{nonce}".encode("utf-8")
        digest = hashlib.sha256(payload).hexdigest()
        if digest.startswith(target_prefix):
            return (seed, nonce, digest, round(time.perf_counter() - start, 3))
        nonce += 1

# 必须放置在 if __name__ == '__main__': 保护块下,防止 spawn 递归创建
if __name__ == "__main__":
    tasks = list(range(100, 108))
    cpu_cores = os.cpu_count() or 4
    print(f"检测到 CPU 核心数: {cpu_cores},启动多进程并行计算...")

    t0 = time.perf_counter()
    with ProcessPoolExecutor(max_workers=cpu_cores) as executor:
        # 使用 map 自动保持输入输出次序
        results = executor.map(cpu_intensive_hash, tasks)
        for seed, nonce, digest, cost in results:
            print(f"Seed: {seed} | 迭代: {nonce} 次 | 耗时: {cost}s | 摘要: {digest[:16]}...")

    print(f"多进程计算总计耗时: {time.perf_counter() - t0:.2f} 秒")
四、从 threading 迁移至 multiprocessing 的四步实战法
很多项目在最初由于代码量小或并发需求低,普遍采用多线程编写。当业务量上升、计算瓶颈出现时,若直接把 ThreadPoolExecutor 换成 ProcessPoolExecutor,往往会遇到崩溃或死锁报错。遵循以下四个步骤,可以确保平滑安全地完成架构迁移:
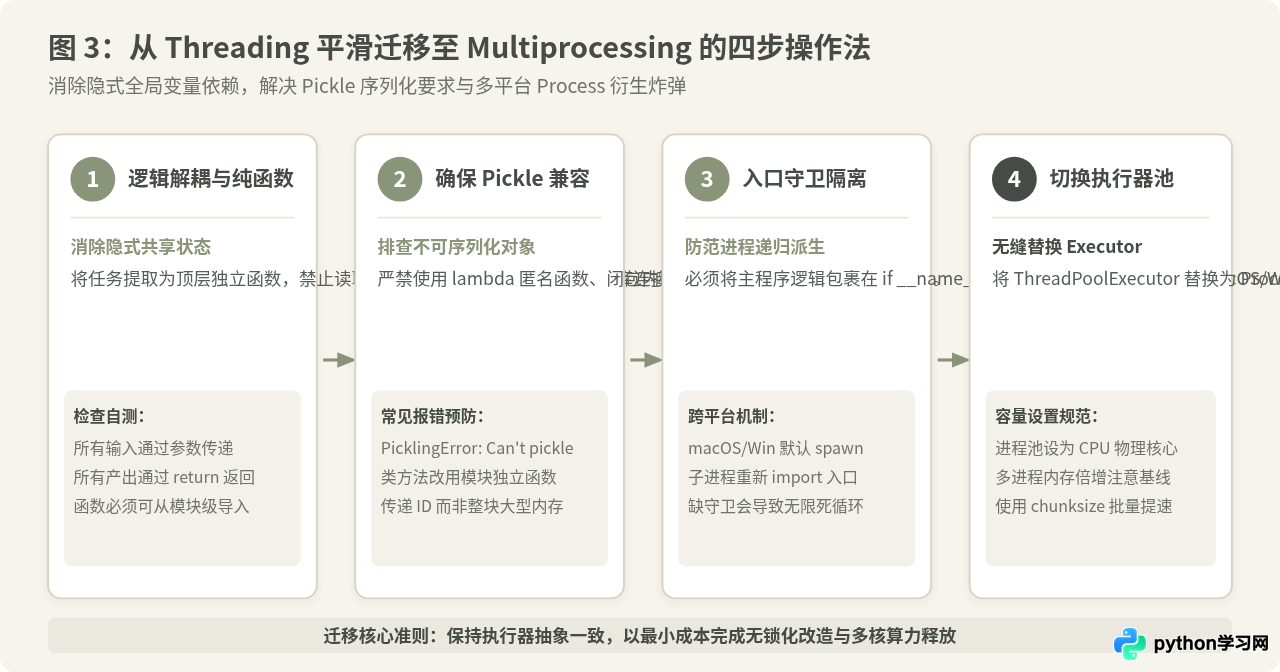
-
第一步:提取并解耦纯函数(消除全局隐式状态)
多线程下各个 Worker 经常直接读取或修改父作用域内的全局变量、类属性或数据库连接。多进程下各个子进程拥有独立的内存地址空间,对父进程全局变量的修改完全互不影响。必须将任务重构成“纯函数”:所有依赖数据通过函数形参传入,所有运算结果通过return返回。 -
第二步:严格消除不可序列化(Pickle)对象
跨进程调用依赖pickle库将函数与参数打包。以下对象无法被 pickle,会导致PicklingError:lambda匿名函数;- 定义在函数内部的闭包函数(Nested Functions);
- 处于打开状态的本地文件句柄、数据库网络连接、Socket 客户端;
- 生成器(Generators)或含有未绑定闭包的类实例方法。
initializer)中完成注册。 -
第三步:强制添加
if __name__ == '__main__':入口守卫
在 Linux 上历史默认使用fork,子进程会复制父进程的内存镜像;但在 Windows 和 macOS 上(Python 3.8+ 默认模式),统一采用更安全的spawn启动模式。在spawn下,子进程会启动一个干净的 Python 解释器,并重新 import 启动主脚本。如果主脚本中没有放置if __name__ == '__main__':守卫,子进程重新导入时会再次执行进程池创建逻辑,导致无限递归派生出成百上千个子进程,瞬间耗尽系统资源导致死机(俗称 Process Bomb)。 -
第四步:配置合理的 Worker 数量与分块大小(chunksize)
对于快速执行完毕的大量小任务(如 100,000 个数值计算),如果一条条向进程池分发,IPC 调度通信开销将压垮系统。通过在executor.map(func, iterable, chunksize=1000)中设定合理的chunksize,可以将成批的数据打包传输,显著降低系统调用与序列化消耗。
五、全维度对比总结与自查矩阵
为了帮助团队在技术评审与代码设计中快速对齐思路,下表和全维度对比图总结了两套并发模型在生产环境中的关键指标表现:
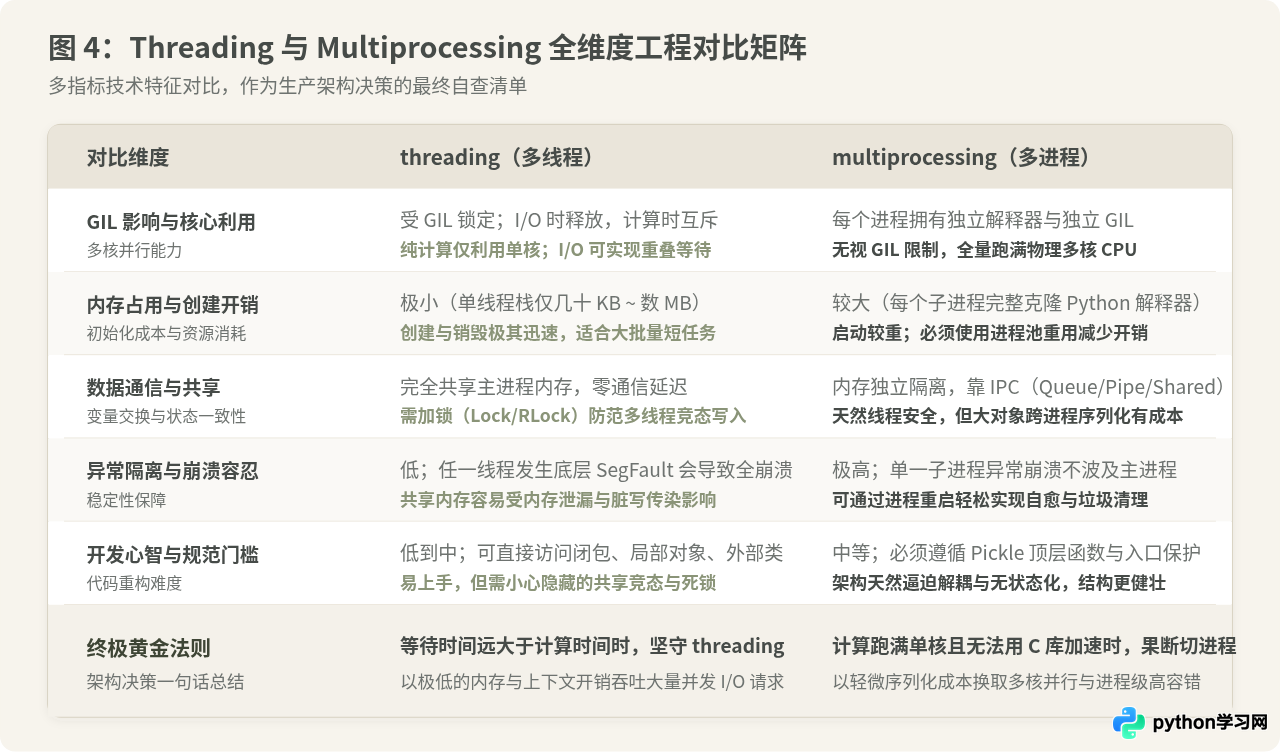
| 对比维度 | threading(多线程) | multiprocessing(多进程) |
|---|---|---|
| 核心适用瓶颈 | I/O 密集型(网络等待、文件读写、数据库阻塞) | CPU 密集型(图像处理、加密哈希、重度数据处理) |
| GIL 约束表现 | 同一个进程内同一时刻仅执行一个 Python 线程 | 每个进程拥有独立解释器,彻底绕过单进程 GIL |
| 物理多核利用率 | 纯计算时仅 1 个核跑满(~100%),无法利用多核 | 完全跑满 N 个物理 CPU 核心(可达 N × 100%) |
| 内存空间与开销 | 共享主进程内存,单线程仅需数 KB 至数 MB | 每个子进程独立复制解释器环境,内存倍增 |
| 数据通信代价 | 零复制、零延迟(直接指针访问,需 Lock 防竞态) | 必须经过 Pickle 序列化 + 管道/Socket 传输 |
| 容错性与崩溃隔离 | 差(单个线程触发 C 层段错误将摧毁整个进程) | 高(单一子进程崩溃不波及主进程,天然隔离) |
| 启动与销毁开销 | 微秒级,轻量迅捷 | 毫秒至数百毫秒(尤其是 spawn 模式),较重 |
| 并发规模上限 | 通常推荐几十至上千个(受系统线程上限与栈影响) | 严格受限于物理 CPU 核心数,通常等于 cpu_count |
决策自查清单(Checklist)
- 如果你的主要逻辑是调用外部网络 API、爬取网页或等待本地文件与数据库,坚决使用
threading,不要平白增加多进程的内存与通信开销。 - 如果任务属于极端高并发(如数万个并发长连接),甚至可以考虑从
threading进一步升级为基于事件循环的asyncio协程。 - 如果你的任务需要持续执行密集的矩阵乘法、图像像素处理、大数据筛选且 CPU 单核已经锁死在 100%,果断切换至
multiprocessing。 - 切换前务必核对:函数是否位于模块顶级?参数与返回值是否可序列化?是否已加入
if __name__ == '__main__':守卫?数据单次计算是否大于 50ms?全部通过后即可放心地享受多核并行加速带来的极致性能。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









