

Python人工智能入门:新手怎么搭建开发环境与运行第一个AI程序

很多初学者在刚开始接触人工智能时,常常被各种前置概念和工具软件打乱阵脚:有人推荐直接安装体积庞大的集成包,有人强调必须配置复杂的显卡驱动,还有人在终端里不断遭遇“命令未找到”或包版本冲突。其实,学习 AI 编程的第一步并不需要复杂的配置,关键在于建立一个干净、受控且符合现代软件规范的基础开发环境。本文将带领初学者在纯净的 Python 环境下,通过规范的步骤搭建好开发沙箱,并编写、运行一个轻量却完整的机器学习分类程序。
一、准备与安装 Python 运行时环境
搭建开发环境的第一步是获取并安装稳定的 Python 运行时。目前人工智能生态中最常用的 Python 版本集中在 3.10 至 3.12 之间。过旧的版本(如 3.8 及以下)很多现代库已不再维护;而刚刚发布的最新小版本由于部分第三方底层 C/C++ 扩展尚未提供预编译二进制轮子(Wheel),容易在安装时触发编译失败。因此,选择官方维护成熟的稳定版本最为稳妥。
在 Windows 系统运行官方安装程序(.exe)时,初始安装界面的最下方有一个名为 “Add python.exe to PATH” 的复选框,必须手动将其勾选。如果遗漏该选项,系统的环境变量将无法识别
python 与 pip 指令,导致在后续的命令行终端中执行命令时报错。
安装完成后,我们需要打开操作系统自带的终端工具(Windows 用户使用 PowerShell 或 CMD,macOS 用户使用终端 Terminal),通过输入以下两条基础命令验证运行时是否已经正确接入:
python --version
pip --versionpip 24.0 from C:\Users\Username\AppData\Local\Programs\Python\Python311\Lib\site-packages\pip (python 3.11)
如果终端能够准确显示出 Python 的版本号以及配套的包管理工具 pip 的版本信息,说明系统底层的 Python 运行时已经成功就绪。
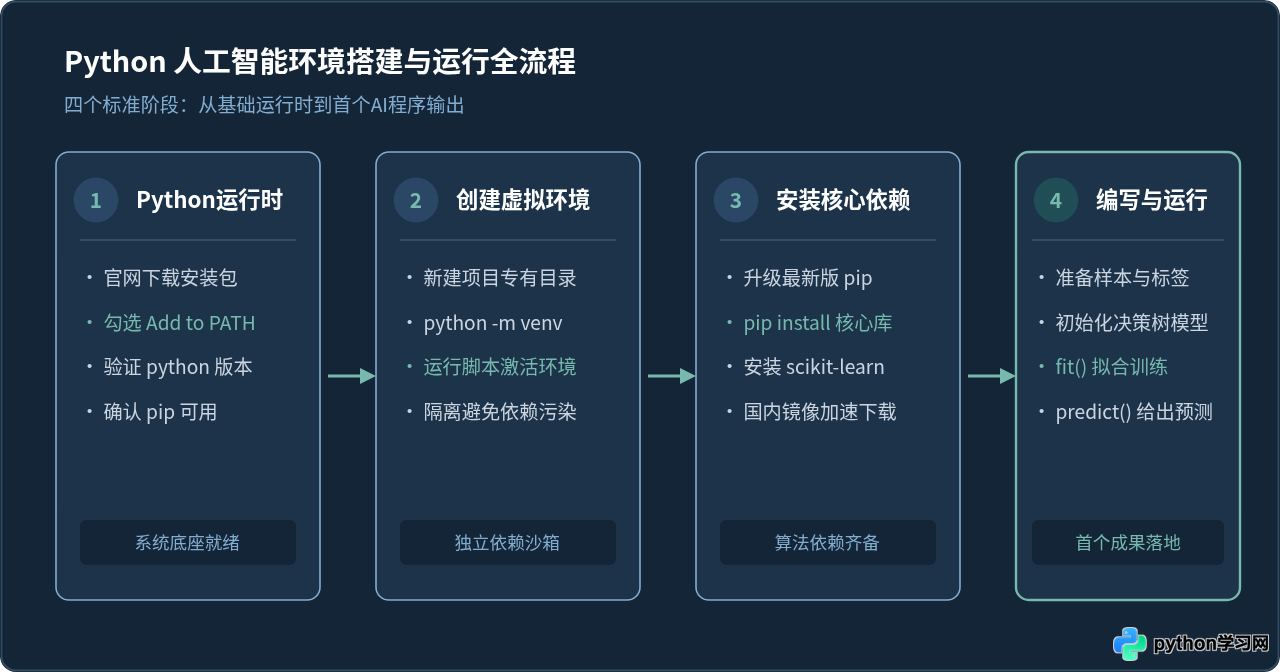
图1:Python 人工智能开发环境搭建与程序运行的四个标准步骤
二、使用 venv 搭建独立的虚拟环境
很多初学者会直接通过 pip install 把所有机器学习库安装在系统的全局 Python 路径下。在刚开始学习的一个月内这种做法看似没有问题,但随着接触的项目增多,灾难往往随之而来:项目 A 依赖特定版本的库(例如 numpy 1.24),而项目 B 需要使用最新的 API(例如 numpy 2.0),全局安装会导致两个项目的依赖相互覆盖,最终让整个开发环境陷入无法运行的报错循环。
解决这个问题的现代标准工程方案是:每个项目拥有独立的虚拟环境(Virtual Environment)。虚拟环境是一个独立的目录树,内部包含特定 Python 解释器的副本以及该项目专有的库。Python 官方自 3.3 版本起便内置了 venv 模块,无需额外安装任何第三方工具。
1. 创建项目目录与虚拟沙箱
首先在磁盘中选择合适的位置创建项目专用文件夹,并生成虚拟环境目录:
# 创建并进入项目目录
mkdir ai_quickstart
cd ai_quickstart

# 使用 venv 模块创建名为 ai_env 的虚拟环境
python -m venv ai_env
执行该命令后,当前目录下会生成一个名为 ai_env 的文件夹。该文件夹中已经包含独立的 Python 执行文件和纯净的第三方库目录。
2. 激活虚拟环境
环境创建后并不会自动启用,我们需要在终端中执行对应的激活脚本:
# Windows 系统(PowerShell 终端):
.\ai_env\Scripts\Activate.ps1

# Windows 系统(传统 CMD 终端):
.\ai_env\Scripts\activate.bat

# macOS 或 Linux 系统:
source ai_env/bin/activate观察终端命令提示符的最左侧。如果出现了带有括号的环境名标识,例如
(ai_env) PS C:\ai_quickstart>,即表明当前终端的所有 Python 与 pip 指令均已指向隔离的沙箱环境。在此状态下安装的任何库都不会影响操作系统其他部分。
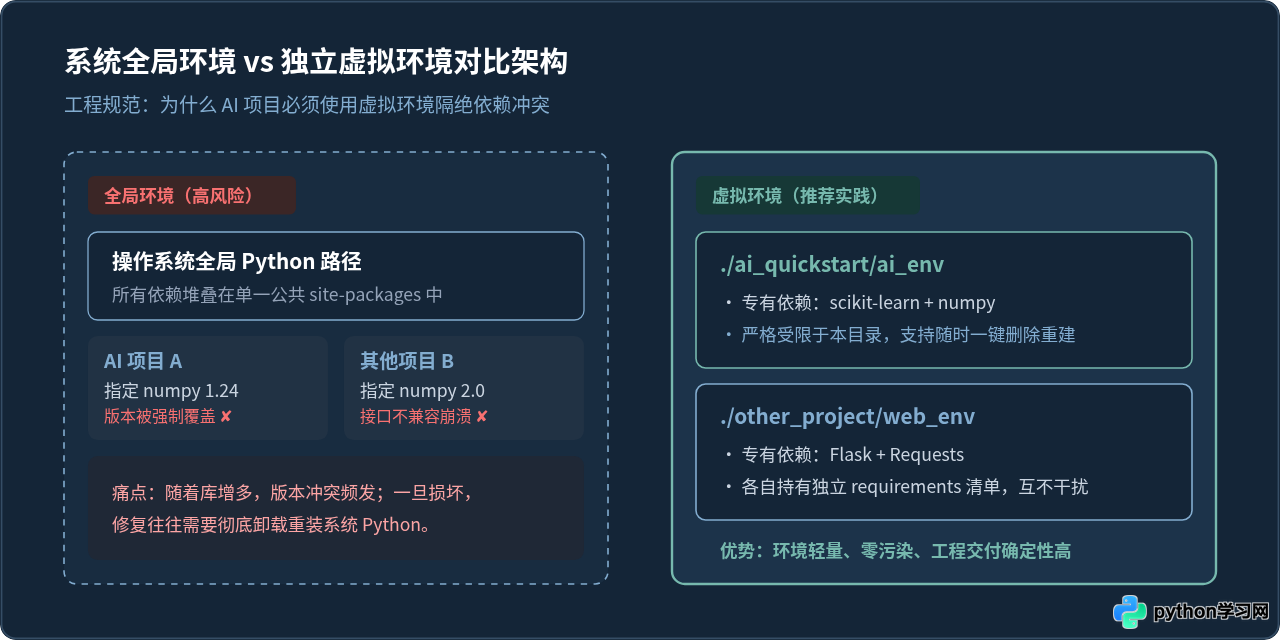
图2:系统全局环境与虚拟环境独立沙箱的架构对比
三、安装人工智能核心依赖库
对于刚刚迈入 AI 领域的初学者,最合适的第一门工具不是需要配置数吉字节模型权重的深度学习框架,而是业界最经典的机器学习库——scikit-learn(通常简称 sklearn)。它内置了完备的统计学习模型、经典的算法实现以及数据预处理工具,体积轻量且不依赖专门的 GPU 硬件,几乎可以在任何普通的个人电脑上流畅运行。
在已经激活的虚拟环境中,首先升级 pip 自身,然后安装 scikit-learn 以及底层矩阵计算库 numpy:
# 升级环境内部的 pip 到最新版本
python -m pip install --upgrade pip

# 安装机器学习核心库
pip install scikit-learn numpy
由于国内访问官方 PyPI 源偶尔会出现连接超时,如果下载速度缓慢或中断,可以在命令后添加国内镜像源参数进行加速(例如使用清华大学镜像源):
pip install scikit-learn numpy -i https://pypi.tuna.tsinghua.edu.cn/simple安装完成后,可以在命令行运行单行检测代码,验证库是否能被 Python 正确引入并打印版本号:
python -c "import sklearn; print('scikit-learn 安装成功,版本为:', sklearn.__version__)"四、编写并运行第一个人工智能程序
很多初学者以为人工智能就是一堆高深莫测的代码,但其本质与传统编程的区别非常直观:传统编程是人类程序员手工编写详尽的条件分支(if-else)去处理输入;而机器学习则是向算法提供历史样本(数据 + 正确答案),由算法自主学习特征与答案之间的数学规律,并构建出一个能够对未知事物做出预测的“模型”。
接下来,我们在 ai_quickstart 目录下新建一个名为 main.py 的代码文件,通过经典的“水果分类问题”来体验完整的机器学习闭环。我们让计算机根据两个物理特征——重量(克)与表面质感(光滑为 0,粗糙为 1),学会自主判断一个水果是苹果还是橙子。
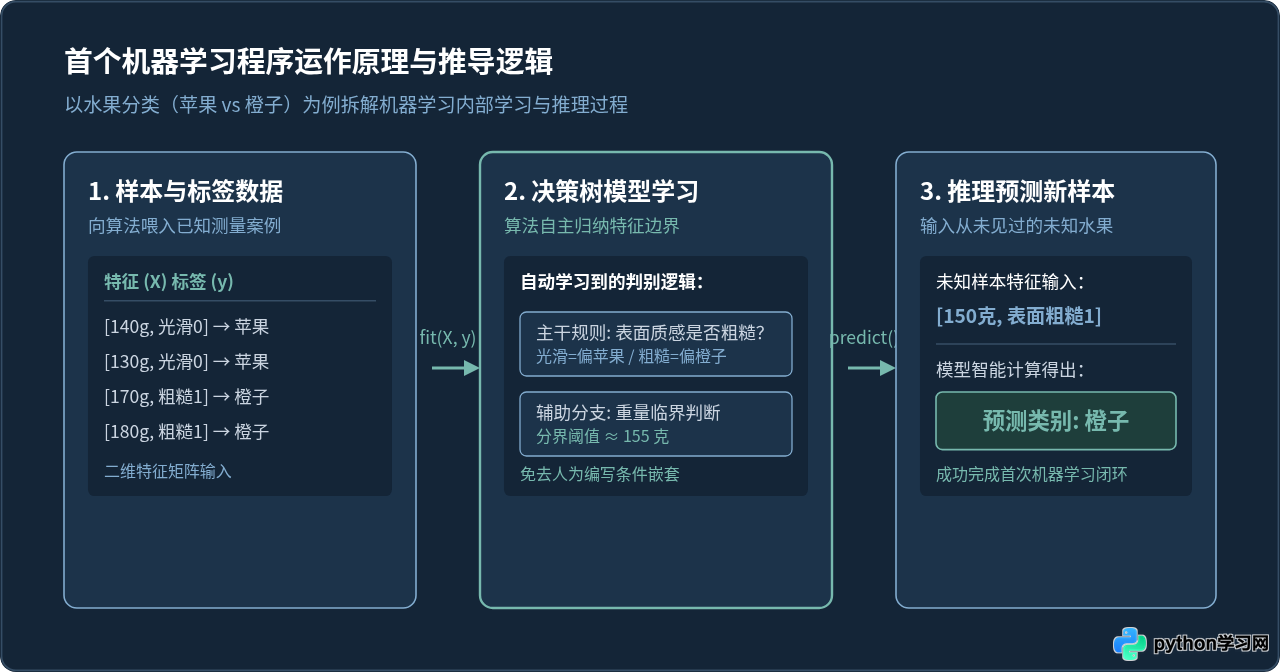
图3:第一个机器学习程序的学习过程与预测机制推导
编写完整代码(main.py)
将以下代码复制并保存到 ai_quickstart/main.py 中:
# 引入经典的决策树分类算法
from sklearn.tree import DecisionTreeClassifier

# 1. 准备训练数据
# 特征 X:每个子列表包含两个维度的特征 [重量(克), 表面质感(0代表光滑,1代表粗糙)]
features = [
    [140, 0],  # 140克,表面光滑 -> 苹果
    [130, 0],  # 130克,表面光滑 -> 苹果
    [150, 0],  # 150克,表面光滑 -> 苹果
    [170, 1],  # 170克,表面粗糙 -> 橙子
    [180, 1],  # 180克,表面粗糙 -> 橙子
    [160, 1]   # 160克,表面粗糙 -> 橙子
]

# 标签 y:对应每一个样本的正确答案
labels = ["苹果", "苹果", "苹果", "橙子", "橙子", "橙子"]

# 2. 初始化决策树分类模型
classifier = DecisionTreeClassifier()

# 3. 拟合训练(让算法在数据中寻找分类规律)
print("正在训练决策树模型...")
classifier.fit(features, labels)
print("模型训练完毕!")

# 4. 给出新样本,让模型自主进行推理判断
# 假设我们手里有一个新采摘的水果:重量 145 克,表面质感较粗糙 (1)
unknown_fruit = [[145, 1]]
prediction = classifier.predict(unknown_fruit)

# 5. 输出预测结果
print(f"对于未知样本特征 [重量: 145g, 粗糙度: 1],AI 模型的预测结果是:【{prediction[0]}】")
运行与结果解读
在确保虚拟环境处于激活状态的前提下,在终端执行以下命令运行脚本:
python main.py模型训练完毕!
对于未知样本特征 [重量: 145g, 粗糙度: 1],AI 模型的预测结果是:【橙子】
仔细观察这个结果:在原始训练样本中,最轻的橙子重量是 160 克,最重的苹果是 150 克。新样本的重量是 145 克(偏向苹果),但其表面质感是 1(粗糙)。决策树模型根据拟合过程学到的多维度信息权重,综合判定质感特征在当前尺度下更具区分性,因此准确得出了“橙子”的结论。这行简短的代码,已经完整包含了数据准备、模型初始化、拟合学习(fit)以及新数据推理(predict)这一标准机器学习全流程。
五、新手高频报错与排障路线
在初次搭建环境的过程中,只要某个环节出现疏漏,终端就会抛出错误提示。新手面对错误往往不知所措,其实常见问题基本都集中在以下三个典型场景:
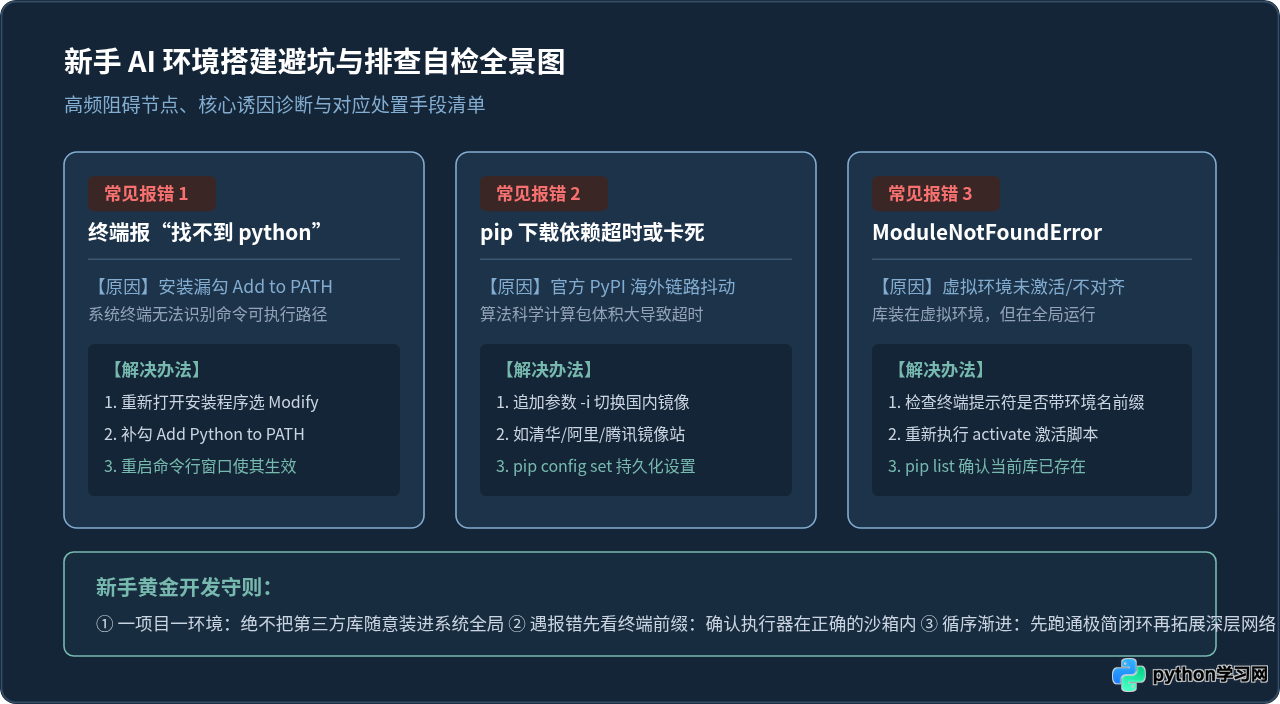
图4:新手搭建 AI 开发环境的排障自检与核心解决路径
1. 'python' 不是内部或外部命令
这是 Windows 平台最普遍的问题,表明系统的 PATH 环境变量中找不到 python.exe。解决办法是找到当初下载的安装包再次双击打开,在出现的维护界面中点击 “Modify”,勾选包含环境变量相关的配置项并完成修复;完成后必须彻底关闭当前命令行窗口并重新开启,新环境变量才能在新终端中生效。
2. No module named 'sklearn'
明明在终端运行了 pip install scikit-learn,但在运行代码时依然报找不到模块。排查的核心是检查运行时的环境与安装时的环境是否一致。观察终端提示符最左侧是否有 (ai_env)。如果打开了新的终端窗口而没有再次运行 activate 激活命令,系统执行的依然是未安装任何第三方库的全局 Python。重新运行激活脚本后再执行即可解决。
3. 保存依赖清单以备迁移
当一个项目的代码调试成功后,建议使用 pip 导出当前虚拟环境中所有确切安装的依赖与版本号,生成标准的清单文件:
pip freeze > requirements.txt将来如果换了新电脑或需要把代码分享给其他人,接收者只需同样创建并激活一个新的干净虚拟环境,随后通过一条命令即可瞬间完全还原一模一样的环境:
pip install -r requirements.txt六、总结与下一步方向
搭建开发环境与运行第一个程序,是学习人工智能过程中最具决定性意义的一步。回顾整个过程,我们其实只完成了四件核心事情:
- 安装并验证了官方稳定版的 Python 运行时,确保命令终端能够直接调用。
- 利用 Python 原生内置的
venv工具创建了完全独立的项目沙箱,杜绝了后续依赖冲突的可能。 - 安装了轻量、免复杂驱动配置的经典机器学习库
scikit-learn。 - 编写并运行了基于决策树的样本训练与预测程序,体会了“数据驱动建模”的 AI 核心思维。
现在,你的本地环境已经具备了完整的现代机器学习开发能力。接下来,你可以尝试往训练集中增加更多样本与更多维度的特征(例如颜色、糖度等),也可以尝试探索 scikit-learn 中支持的其他经典模型(如 K近邻算法、支持向量机或随机森林),逐步建立起对人工智能算法规律的深层理解。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









