

NumPy list转array指定dtype:避免数据丢失与类型错误
本文解析NumPy中list转array时指定dtype的机制。通过代码示例展示类型推断、强制转换导致的数据丢失及异常处理,强调dtype是存储约束而非业务校验,并提供np.asarray的性能优化建议。
在Python数据处理中,将列表转换为NumPy数组时直接指定dtype,能明确数据的存储格式并满足API要求。但必须清楚,dtype执行的是底层类型转换,而非业务逻辑校验:浮点数转整数会直接截断小数,非法字符串会抛出异常。这里的Array特指NumPy的ndarray,而非Python标准库的array.array。
以下示例基于Python 3.12.14与NumPy 2.3.5环境验证,语法在Windows及其他支持NumPy的平台通用。
类型推断如何改变数据表示
Python列表允许混合存储不同类型对象,而NumPy数组要求所有元素具有相同的dtype。若构造时不指定类型,NumPy会尝试推断一个能容纳所有输入值的类型。
import numpy as np

values = [1, 2.5]
a = np.array(values)
print(a.tolist(), a.dtype)
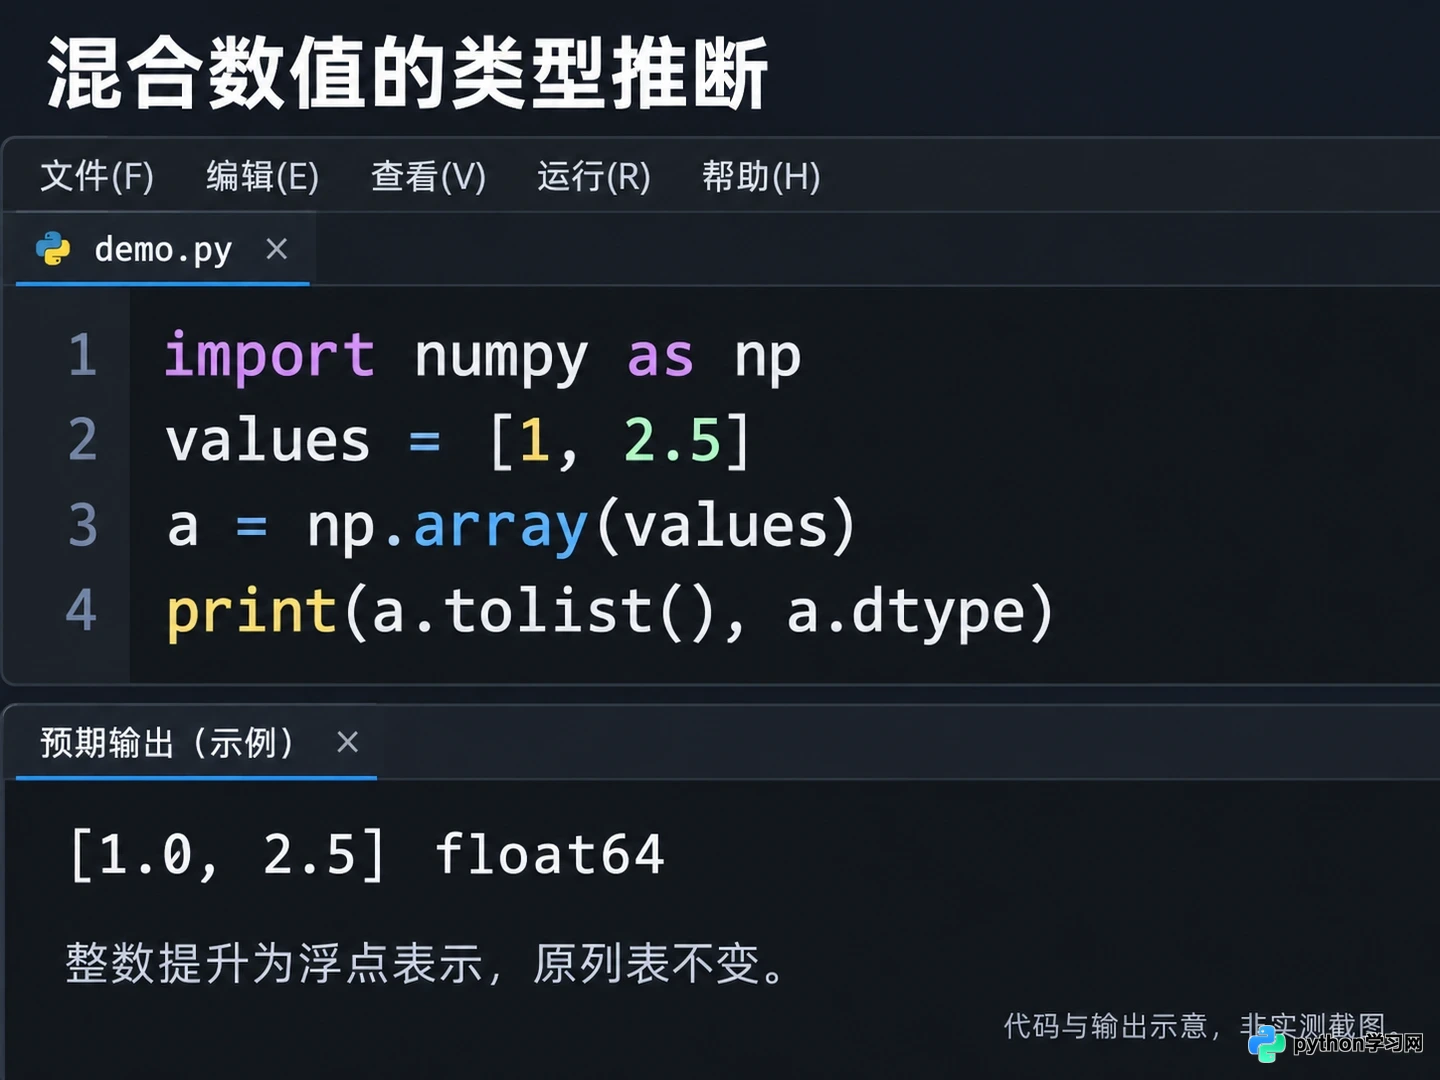
列表包含混合类型时,NumPy自动推断为float64
输出结果为[1.0, 2.5] float64。由于列表中同时存在整数和浮点数,NumPy将整数1提升为浮点形式以保持一致性。这并非修改了原列表,而是生成了新的数组表示。
若需明确结果类型,可在构造时显式声明:
b = np.array(values, dtype=np.float64)
print(b.tolist(), b.dtype)
输出仍为[1.0, 2.5] float64。显式指定的作用在于约束输入边界,确保调用方对结果类型有确定性预期,而非单纯为了性能优化。
强制转换引发的数据静默丢失
当业务要求统一为整数时,直接强制转换可能导致精度丢失。例如测量数据中的小数部分会被直接舍弃:
c = np.array([1, 2.5], dtype=np.int64)
print(c.tolist(), c.dtype)

强制dtype转换会截断小数部分
输出为[1, 2] int64。转换过程没有报错,但2.5的小数部分永久丢失。数组构造成功不代表业务数据完整,若需保留精度,应选择浮点类型或在转换前执行明确的舍入操作。
对于字符串转数值的情况,dtype不会自动处理无法解析的内容:
d = np.array(['12', '30'], dtype=np.int64)
print(d.tolist(), d.dtype)

try:
    np.array(['12', 'unknown'], dtype=np.int64)
except ValueError as exc:
    print(type(exc).__name__)
输出显示合法字符串转换成功,而包含unknown的列表则抛出ValueError。dtype不会将非法值自动填充为0或NaN,也不会跳过错误项。在数据清洗阶段,应先处理异常值再转换,避免捕获异常后继续用残缺数据计算。
入口指定与对象复用策略
从列表创建数组时,最直接的方式是np.array(values, dtype=目标类型)。若已有数组需转换类型,应使用astype方法并接收返回值,切勿直接修改arr.dtype属性,后者仅改变数据解释方式而不转换底层字节,极易导致数据错乱。
当接口同时兼容列表和数组时,推荐使用np.asarray。它接受dtype参数,且在输入已是符合要求的数组时可能复用对象,减少内存拷贝:
x = np.array([1, 2.5], dtype=np.float64)
y = np.asarray(x, dtype=np.float64)
print(y is x)

np.asarray在类型匹配时复用原数组对象
输出为True,表明y与x指向同一内存对象。这意味着后续对y的修改会影响x。若需隔离数据,应显式调用copy();而从Python列表创建数组时,无论如何都会生成新对象,无法与原列表共享存储。
需注意,若数据包含前导零编号等语义信息,转整数会破坏格式,此时应保留字符串类型。dtype=object虽能存储任意Python对象,但会丧失NumPy的向量化计算优势。对于嵌套列表长度不一致的情况,仅修改dtype无法解决形状问题,需先规整数据结构。
在数据进入计算流程前,应同时确认值域、形状与类型。dtype仅负责底层存储表示,数据是否允许被如此转换,始终由业务规则决定。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









