

Python编程初学者常犯的错误有哪些?怎么高效调试代码
系统梳理Python初学者最容易遇到的语法错误、名称错误、类型异常与逻辑陷阱,并详解如何阅读Traceback及运用breakpoint交互调试与日志排错。
初学 Python 时,终端抛出的鲜红错误信息往往令人困惑,但这并非坏事,而是解释器在指引问题所在。解决代码错误的核心路径分为两部分:首先系统识别语法、名称、类型与逻辑四类高频初学者陷阱;其次掌握科学的 Traceback 逆向排查法与交互式调试工具,快速定位变量偏差并验证修复。
一、初学者最常犯的四类 Python 错误
Python 语法以简洁著称,但初学者在脱离教程独立编写代码时,常会因为标点习惯、执行上下文或对象可变性等细节触发异常。理清这些错误的表现与触发机理,是写出稳健代码的第一步。
1. 语法与缩进错误(SyntaxError & IndentationError)
此类错误发生在代码被 Python 解释器解析(编译成字节码)阶段,尚未开始实际运算:
- 遗漏语句末尾的冒号:在
if、for、while、def、class声明行末尾遗漏英文冒号:。 - 混淆中英文标点符号:误输入全角括号
()、中文引号“”或中文逗号,,解释器通常会在符号位置提示SyntaxError: invalid character。 - 混用制表符与空格:Python 3 严格禁止在同一代码块中混用 Tab 和空格。不同编辑器对 Tab 宽度的渲染不一,极易引发
IndentationError: unexpected indent或对齐错乱。建议统一在编辑器中设置「按 Tab 键输入 4 个空格」。
# 常见错误示例:遗漏冒号且混用全角括号
def calculate_score(scores):  # 错误:使用了中文冒号
    total = sum(scores)
      average = total / len(scores)  # 错误:缩进层级不一致 (IndentationError)
    return average
2. 运行时名称与作用域错误(NameError & UnboundLocalError)
当程序语法正确但在运行期间找不到对应标识符时,就会抛出名称错误:
- 变量名大小写拼错或未定义先使用:Python 对大小写敏感,
userName与username属于完全不同的变量。若在赋值前引用该变量,立即触发NameError。 - 函数内部修改外部同名变量:在函数内部对某个变量名进行赋值操作时,Python 会默认将其标记为局部变量。如果在赋值前读取了该变量,解释器不会回退读取全局变量,而是直接抛出
UnboundLocalError: local variable referenced before assignment。
# 常见错误示例:UnboundLocalError
counter = 0

def increase():
    # 试图直接自增全局变量,未声明 global 或使用参数传递
    counter += 1  # 报错:UnboundLocalError: local variable 'counter' referenced before assignment

increase()
3. 数据类型与容器操作错误(TypeError & IndexError / KeyError)
初学者容易忽略不同对象类型在内存中的行为差异与合法操作边界:
- 隐式字符串与数值拼接:执行
"当前分数为: " + score(其中score为整数),Python 不会自动将整数转换为字符串,会抛出TypeError: can only concatenate str (not "int") to str。正确方式是使用 f-string:f"当前分数为: {score}"。 - 列表索引越界(IndexError):访问
items[len(items)]。由于 Python 索引从 0 起始,长度为N的列表最大合法下标是N - 1。 - 字典读取不存在的键(KeyError):直接使用
data["age"]取值。若键不存在即刻报错。健壮写法应采用data.get("age", default_value)或提前使用in关键字检查。
4. 隐蔽的逻辑与设计陷阱(可变对象作默认参数)
最令初学者困惑的逻辑 Bug 往往不直接抛出异常,而是产生不符合预期的运算结果。最典型的便是将可变对象(如列表、字典)作为函数形参的默认值:
# 陷阱:函数的默认形参在 def 定义时即被创建一次,后续调用共享同一引用
def append_worker(item, container=[]):
    container.append(item)
    return container

print(append_worker("A"))  # 输出: ['A']
print(append_worker("B"))  # 输出: ['A', 'B'](预期常常是单个 ['B'])

# 正确防范模式:使用 None 作为哨兵值并在函数体内显式创建新对象
def append_worker_safe(item, container=None):
    if container is None:
        container = []
    container.append(item)
    return container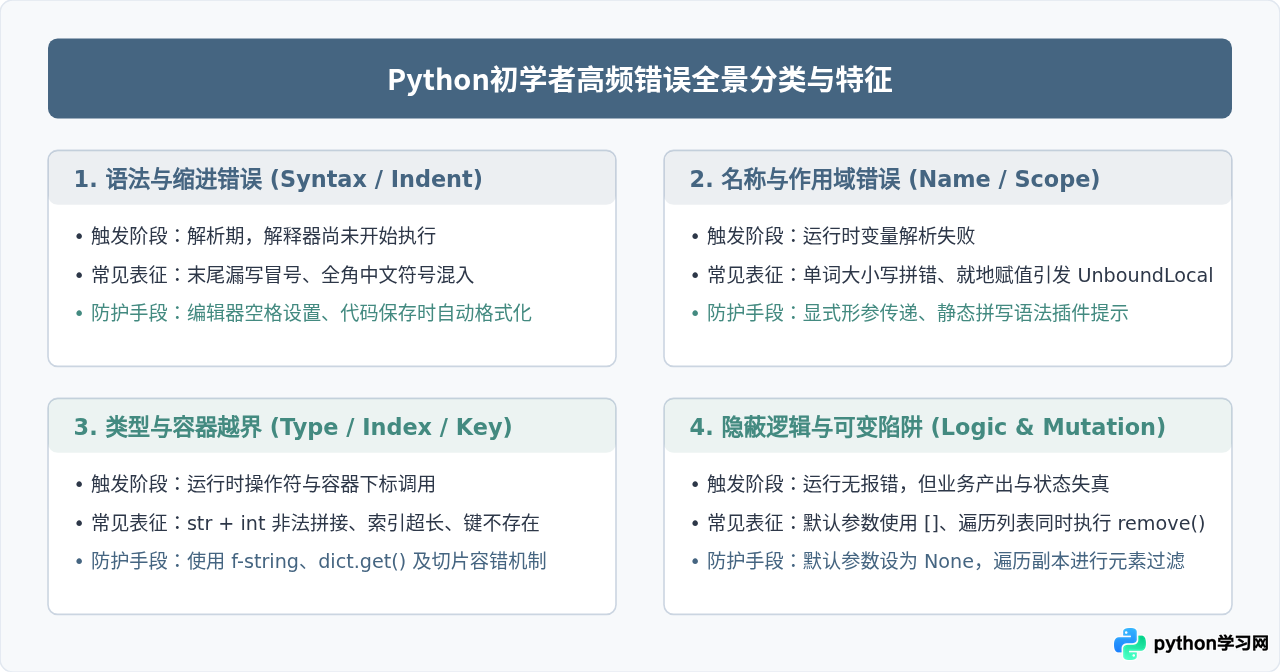
二、高效阅读 Python 错误回溯(Traceback)
遇到报错时,慌乱地重写整段代码往往事倍功半。Python 的回溯信息(Traceback)是一张精确的故障诊断单,只要掌握「自底向上」的阅读顺序,绝大部分 Bug 都能在两分钟内锁定具体行。
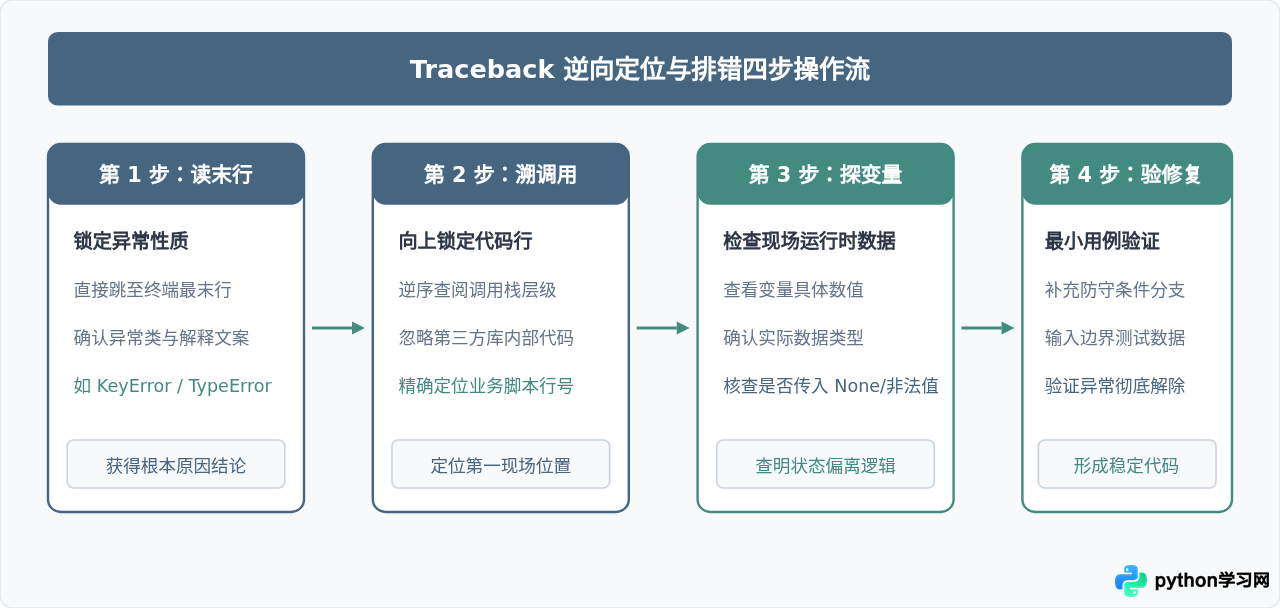
1. Traceback 倒序阅读法则
典型的 Traceback 结构包含调用链层级与具体异常信息。标准排查遵循三步走:
- 看最后一行(根因概括):最后一行永远是异常类的名称(如
ZeroDivisionError)以及具体的报错描述(如division by zero)。这一行直接指明了破坏程序运行的根本事实。 - 看倒数第二段代码位置(故障现场):向上查找最近的一个由你编写的
.py文件路径、行号以及引发报错的具体代码语句。如果该语句调用了第三方库或内置模块,Traceback 会深入展示库内部实现,但问题根源绝大多数出在你的调用参数上。 - 追溯调用栈路径(上下文环境):如果这是多层函数嵌套调用,顺着
File "...", line ... in ...自下而上逐层查看是谁调用了当前函数,当时传入了什么关键参数。
# 典型 Traceback 样例解析
Traceback (most recent call last):
  File "main.py", line 18, in <module>
    process_user_data(raw_payload)
  File "main.py", line 9, in process_user_data
    validated_age = int(user_info["age"])
KeyError: 'age'
在上述样例中:最后一行 KeyError: 'age' 说明试图按 'age' 取字典值失败;倒数第二块明确指出位于 main.py 的第 9 行 validated_age = int(user_info["age"])。此时排查重点直接收敛到:user_info 字典到底包含哪些键?为什么没有传入 'age'?
三、高效调试 Python 代码的进阶工具与技巧
初学者最熟悉的调试手段通常是在代码各处插入 print()。虽然直接,但在逻辑复杂、循环庞大或多模块协作时,到处散落的 print 会严重污染控制台,事后清理极易遗漏。采用正规的调试工具可以使排查效率提升数倍。
1. 现代断点利器:内置 breakpoint() 与 pdb
自 Python 3.7 起,标准库引入了统一断点函数 breakpoint()。只需在怀疑出现偏差的代码前插入这一行,运行程序时,解释器就会在控制台暂停,并进入交互式调试会话:
# 使用 breakpoint() 进入交互式调试
def calculate_tax(income, deductions):
    taxable = income - deductions
    breakpoint()  # 程序运行到此处自动挂起,进入 pdb 交互环境
    if taxable <= 0:
        return 0
    return taxable * 0.2

calculate_tax(50000, 12000)
终端进入 (Pdb) 提示符后,可以使用以下核心单字母指令高效排查:
p 变量名或pp 表达式:打印当前环境下的变量值或结构化输出复杂对象。n(Next):单步执行到下一行代码,不进入调用的子函数内部。s(Step):单步步入,遇到函数调用时深入该函数内部逐行执行。c(Continue):恢复程序正常执行,直到遇到下一个断点或运行结束。q(Quit):立即终止整个程序,退出调试器。
2. 规范化信息追踪:使用 logging 替代 print
对于需要持续跟踪的排查场景,应使用标准库 logging。它支持分级输出(DEBUG, INFO, WARNING, ERROR),并能自动附带时间戳与模块名,上线前只需一行配置即可屏蔽所有调试日志:
import logging

# 配置日志输出格式与过滤等级
logging.basicConfig(level=logging.DEBUG, format="%(asctime)s [%(levelname)s] %(message)s")

def process_order(order_id, amount):
    logging.debug(f"正在处理订单 #{order_id}, 金额: {amount}")
    if amount < 0:
        logging.error(f"订单 #{order_id} 出现非法负数金额!")
        return False
    return True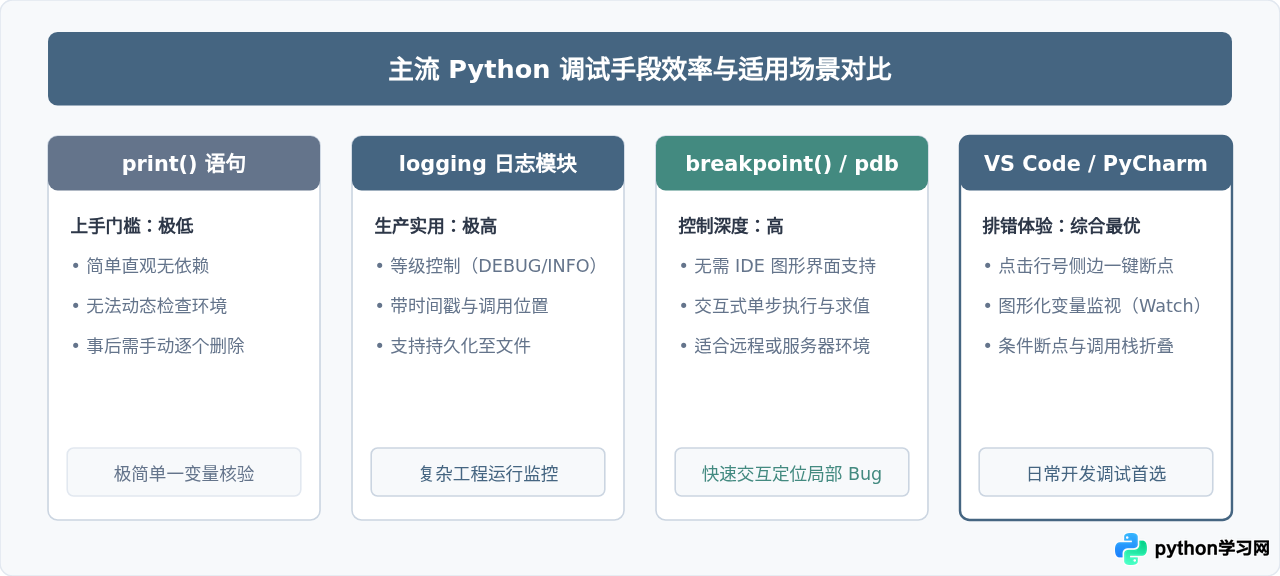
四、建立防御性编程习惯与长效排错闭环
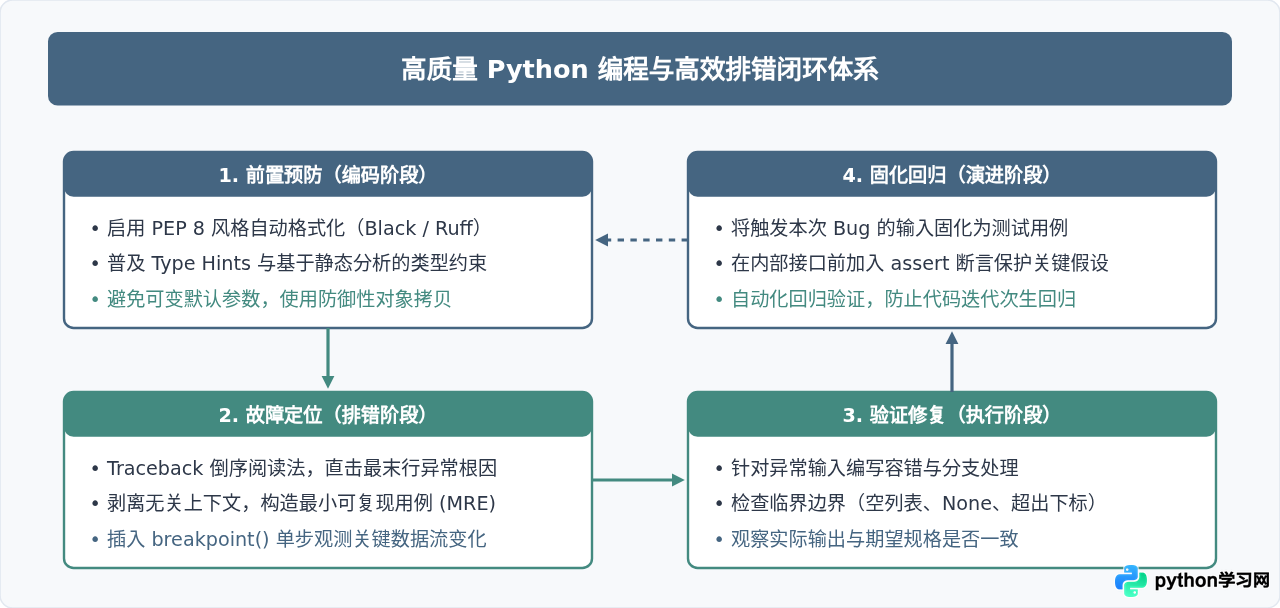
最高效的调试,实际上是在代码编写早期就通过工具和规范阻止错误的发生。建立以下三项工程习惯,可以让代码质量产生质的提升:
1. 引入类型注解(Type Hints)与静态检查
Python 是一门动态类型语言,但从 3.5 版本开始全面支持类型注解。使用类型提示,配合 VS Code 的 Pylance 或独立的 mypy 工具,可以在不运行代码的情况下静态发现绝大多数 TypeError 和 NoneType 操作:
from typing import List, Optional

# 使用类型注解标明期望输入与输出类型
def parse_scores(names: List[str], raw_data: dict) -> Optional[float]:
    if not names:
        return None
    total = sum(raw_data.get(name, 0) for name in names)
    return total / len(names)
2. 编写最小可复现用例(MRE)
当一段 200 行的代码出现莫名其妙的错误时,切忌在原地反复试错。新建一个测试脚本,将怀疑出错的那个函数、那两行核心表达式和一段假数据提取出来独立运行。将问题代码与其他业务逻辑剥离的过程,80% 的概率就已经看清了诱因。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









