

学Python爬虫前需要掌握哪些前置知识?HTTP与HTML解析基础清单
全面梳理学习Python爬虫前必须掌握的核心前置知识,包括HTTP请求响应原理、常见状态码与请求头、HTML骨架与DOM树结构,以及CSS选择器与XPath语法对照清单,帮助新手建立扎实的爬虫底层认知。
一、认识爬虫的技术底层:网络交互与文档抽取
在编写任何 Python 脚本之前,首先需要理清爬虫在技术链条中所处的位置。广义上的网络爬虫,运行过程可以清晰地划分为两个基本动作:第一步是通过网络向目标服务器发起请求并接收对方返回的内容;第二步是从接收到的文本中精确定位并提取出我们关心的字段。
无论是使用简单的 urllib、requests,还是大型异步框架 Scrapy,底层都没有超出这两个动作的范畴。如果把爬虫比作一次“点外卖”的过程,HTTP 协议就是你与店家交流的通话规则和订单单据,而 HTML 与 DOM 则是外卖送达后打包盒里的分类格。不明白订单怎么填、暗号怎么对,商家就不会发货;看不懂分类结构,就无法从繁杂的包装里挑出真正需要的食材。
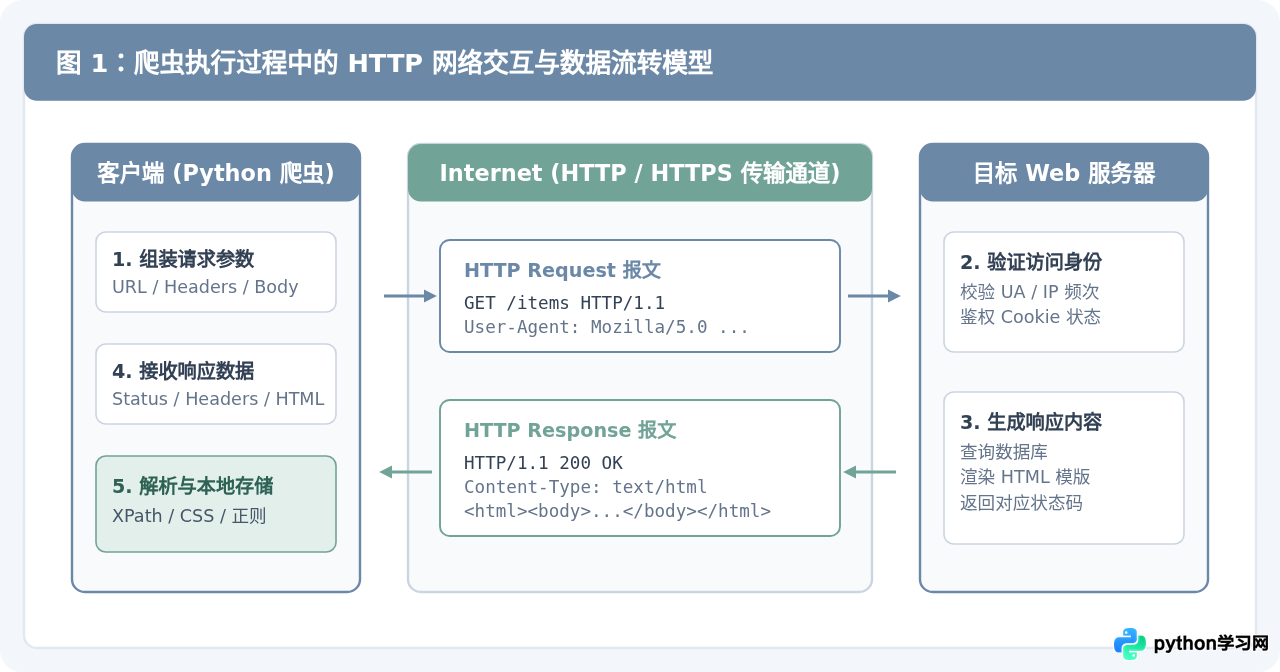
二、HTTP 核心知识:搞懂通信报文与状态逻辑
HTTP(超文本传输协议)是互联网信息传递的核心协议。在编写代码发起网络调用前,必须熟悉以下四个层面的核心内容:
1. 常见请求方法(Method)
HTTP 规范定义了多种与资源交互的方法,爬虫中最常用的是 GET 和 POST:
- GET 请求:主要用于获取数据。请求的参数通常直接拼接在 URL 路径之后(例如
https://example.com/search?keyword=python&page=1)。GET 请求没有独立的请求体,可以被浏览器收藏和缓存。 - POST 请求:主要用于提交数据,常见于用户登录、表单提交或带有多重筛选条件的复杂查询。POST 的参数放在请求体(Request Body)中,URL 表面看不到具体载荷。编写登录爬虫时必须抓包确认提交的数据格式是
application/x-www-form-urlencoded(表单形式)还是application/json。
2. HTTP 响应状态码(Status Code)
服务器在收到请求后,会返回一个由三位数字组成的状态码,用来传达处理结果。能够准确判断状态码,是编写稳健爬虫重试与容错机制的前提:
- 200 OK:请求成功,响应体包含所需的数据。但这并不意味着一定抓到了正确内容,有时反爬系统会返回带有 200 状态码的验证码页面。
- 301 / 302 重定向:301 代表永久重定向,302 代表临时重定向。通常在响应头包含
Location字段,指明资源的新地址。默认情况下大多数库会自动跟随跳转。 - 400 Bad Request:请求参数格式错误或缺失必要字段。
- 401 Unauthorized 与 403 Forbidden:401 说明未通过身份认证(需要登录或 Token);403 则意味着服务器理解请求但拒绝执行,这是爬虫被网站风控拦截的最常见状态码之一(如 IP 被封禁、缺少特定 Header)。
- 404 Not Found:请求的资源不存在,通常是 URL 拼写错误或该资源已被下线。
- 500 / 502 / 503 服务端错误:500 代表目标服务器内部逻辑崩溃;502 与 503 则通常表示反向代理网关超时或服务暂时过载。面对 5xx 错误,爬虫应采取延时退避与重试策略,而不是盲目高频重发。
3. 爬虫必须伪装的关键请求头(Headers)
如果不主动设置请求头,Python 的 requests 库会默认发送类似 User-Agent: python-requests/2.31.0 的标识。几乎所有具有防护意识的网站都会直接拒绝这类请求。以下是必须重点掌握的四个请求头字段:
- User-Agent (UA):告知服务器当前发起请求的操作系统、浏览器内核及版本。这是最基础的伪装项,必须配置真实的桌面端或移动端浏览器 UA。
- Referer:记录当前请求是从哪个网页跳转而来的。许多图床、下载接口和防盗链系统会校验 Referer 来源域名是否合法。
- Cookie:用于在无状态的 HTTP 协议中保持会话状态。里面包含用户的会话 ID、登录凭证或反爬指纹。抓取需要登录后才能查看的页面时,必须携带正确的 Cookie。
- Host:指定所请求的服务器域名或 IP 地址,在访问多域名共享同一 IP 的虚拟主机服务时尤为关键。

三、HTML 与 DOM 树:爬虫眼中的网页结构
通过 HTTP 协议成功拿到服务器返回的网页文本后,接下来需要对其进行解析。对于静态网页而言,响应正文就是一段超长且充满各种尖括号的 HTML 源码。
浏览器在拿到这段源码后,并不会直接将其当作纯字符串来渲染,而是由内核引擎进行词法与语法分析,构建出一棵内存中的文档对象模型树(Document Object Model,简称 DOM 树)。爬虫的数据提取工作,本质上就是在这棵 DOM 树上按图索骥,找到对应的节点并取出其中的文字或链接属性。
1. 标签、属性与层级关系
一段标准的 HTML 由标签(Tag)、属性(Attribute)以及节点包裹的内容组成:
- 成对标签与自闭合标签:如
<div>...</div>、<p>...</p>为成对标签;而<img>、<br>、<input>通常为自闭合标签。 - 属性(Attributes):标签上往往带有键值对,用于定义样式或标识身份。对爬虫而言最重要的属性是
id(全页面理论上唯一)和class(用于标记组件类型,一个标签可有多个 class,用空格隔开),以及存储超链接的href和存储图片地址的src。 - 节点层级:包含父节点(Parent)、子节点(Child)、后代节点(Descendant)以及兄弟节点(Sibling)。明确节点间的相对位置,是在没有唯一 class 时精准定位的关键技巧。

四、解析语法双子星:CSS 选择器与 XPath 对照实战
理解了 DOM 树之后,提取数据的工具主要是 CSS 选择器 与 XPath 路径表达式。两者各有优势:CSS 选择器语法简洁直接,与前端样式规则完全一致;而 XPath 功能更为强大,不仅支持从父节点向下查找,还支持顺着轴向上查找父级、筛选兄弟节点,并内建了丰富的文本匹配函数。
1. CSS 选择器与 XPath 核心语法对照表
| 匹配目标 | CSS 选择器语法 | XPath 语法 | 说明 |
|---|---|---|---|
| 按标签名选择 | p 或 div |
//p 或 //div |
匹配所有该标签节点 |
| 按 ID 精确定位 | #header |
//*[@id='header'] |
根据元素唯一 ID 查找 |
| 按 Class 类名匹配 | .article-item |
//*[contains(@class, 'article-item')] |
XPath 建议用 contains 防多类名漏选 |
| 直接子节点 | ul > li |
//ul/li |
只匹配下一层直接子元素 |
| 所有后代节点 | div.content p |
//div[@class='content']//p |
跨越多层递归匹配 |
| 提取属性值 | 通过函数提取(如 el['href']) |
//a/@href 或 //img/@src |
XPath 可直接在语法末尾提取属性 |
| 提取节点文本 | 通过属性提取(如 el.text) |
//h1/text() 或 //p//text() |
XPath 可直接获取当前节点文本 |
| 指定索引位置 | li:nth-child(1)(从1起算) |
(//li)[1](从1起算) |
二者在标准中都是以 1 开始计数 |
| 根据文本内容筛选 | 不支持直接根据包含文本筛选 | //a[contains(text(), '下一页')] |
XPath 独特优势,爬虫处理翻页极常用 |
<div class="post-item active featured">),若使用 CSS 选择器,写成 .post-item.active 即可同时匹配;若使用 XPath,直接写 [@class='post-item'] 会匹配失败,必须使用 [contains(@class, 'post-item')]。

五、浏览器开发者工具(DevTools):前置排查必备技能
学习爬虫绝不能只盯着 Python 编辑器,大部分工作其实发生在浏览器的开发者工具中(按 F12 或 Ctrl+Shift+I / Cmd+Option+I 打开)。掌握以下两个面板的使用,能省去 80% 盲目猜错的时间:
1. Elements 面板 vs Network 面板的陷阱
这是新手最容易跌入的深坑:在 Elements 面板里能看到的标签,爬虫用 requests 请求下来却根本不存在。
原因是 Elements 面板展示的是浏览器已经执行完 JavaScript 脚本后、实时更新渲染出的最终 DOM 树;而传统的爬虫库(如 requests)只相当于在 Network 面板中抓取第一个 HTML 文档的原始响应文本(Response)。如果目标数据是通过前端 Ajax / Fetch 异步加载回来的,或者是通过 Vue / React 客户端渲染的,原始 HTML 里只有一个空的 <div id="app"></div> 骨架。
Response 标签页,使用 Ctrl+F 搜索你要抓取的具体文字。如果在 Response 里能搜到,说明是服务端渲染,直接用 requests + BeautifulSoup / XPath 解析;如果搜不到,就必须在 Network 面板筛选 Fetch/XHR 抓取其背后的 JSON 数据接口,或者使用 Selenium / Playwright 等无头浏览器自动化工具。
2. 控制台极速验证语法
不需要每次修改解析表达式都重新运行一遍 Python 脚本。Chrome / Edge 控制台自带内置调试函数:
$$('div.article-item a'):直接在控制台验证 CSS 选择器,回车后会列出所有选中的 DOM 元素及总数量。$x('//div[@id="main"]//h2/text()'):直接在控制台验证 XPath 表达式,回车即刻查看匹配到的文本或节点数组。
六、学前自我检查清单
在正式开启具体 Python 爬虫项目前,对照以下基础清单自测。当清单中的每一项你都能清楚说出“是什么”以及“在哪里排查”时,再进入 requests、lxml、Scrapy 或 Playwright 的学习,就能事半功倍。

总结
掌握了 HTTP 协议与 HTML/DOM 解析,就相当于拿到了进入网络爬虫大门的“通用钥匙”。在这个坚实的基础上,下一步学习具体的 Python 库(如 requests 负责发送请求、BeautifulSoup 或 parsel 负责提取节点、pandas 负责结构化存储)就会变得直观明了。每当你遇到爬虫运行异常时,请习惯性地回到网络报文和 DOM 结构中去寻找真相,这正是专业爬虫开发者与普通脚本调用者的本质区别。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









