

Python入门实战:编写自动化文件整理脚本
面向Python初学者的实战教程,讲解如何使用Python内置的标准库pathlib与shutil编写自动化文件整理脚本,实现按扩展名自动归类杂乱文件并避免同名覆盖。
日常使用电脑时,浏览器的“下载”目录或桌面上经常堆积成百上千个不同类型的文件。手动按类型逐一建立文件夹并拖拽移动费时费力,而利用 Python 的标准库编写一个自动化文件整理脚本,只需要几十行代码就能根据扩展名自动建立子目录并将文件安全归类。本文将完整介绍这个脚本的设计思路、标准库选用、代码实现与防坑细节。
一、整体归类方案与核心流程
文件整理的核心逻辑可以概括为一个明确的映射机制:程序读取目标文件夹内的所有项目,过滤出普通文件,提取每个文件的扩展名后查找预设的分类规则,最后将文件移动到对应的子目录中。
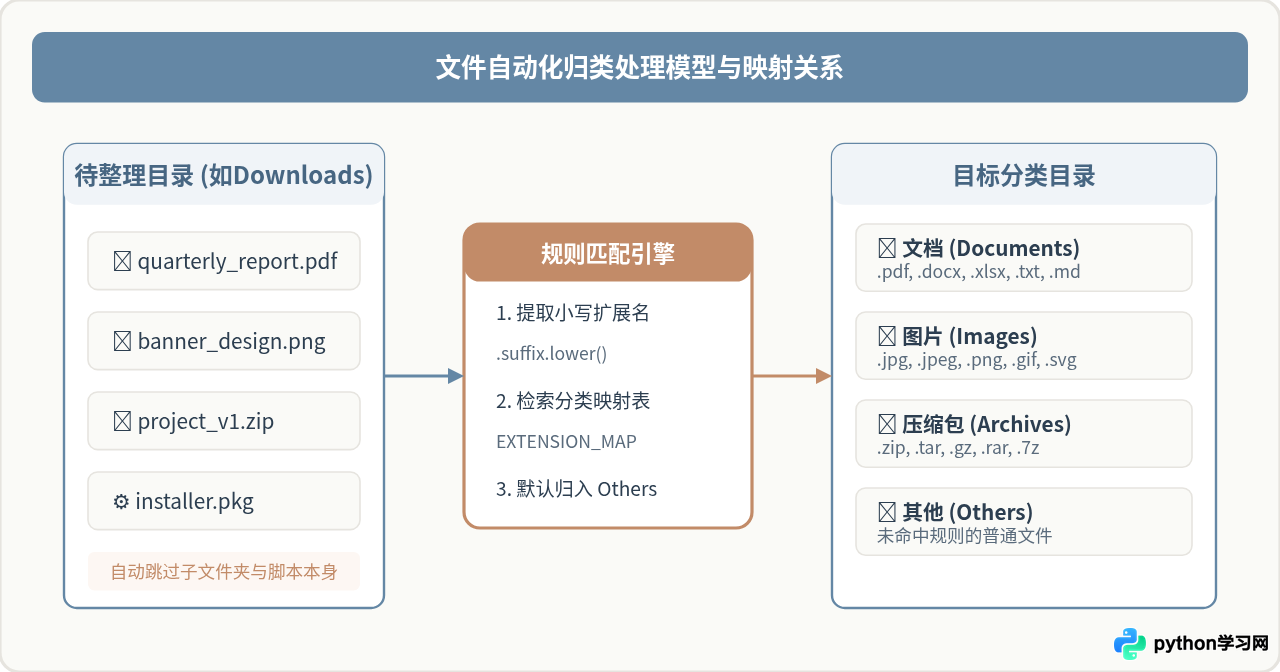
在设计规则时,我们要特别注意三个边界情况:
- 排除子目录:整理只应作用于当前目录下的直属文件,不能把已经归类好的子文件夹本身再次移动。
- 排除脚本本身:如果脚本文件放置在待整理目录下运行,不能把自己归类到某个文件夹中,否则后续可能找不到执行文件。
- 大小写敏感问题:Windows 系统对文件名大小写不敏感,而 macOS 与 Linux 区分大小写。在提取扩展名后统一转换为小写(如
.PNG转换为.png),可以避免漏匹配。
二、标准库选择:为什么优先使用 pathlib
在早期 Python 代码中,文件路径操作通常依赖 os 和 os.path 模块,移动文件依赖 shutil 模块。自 Python 3.4 引入 pathlib 之后,面向对象的路径操作方式成为了官方推荐的最佳实践。
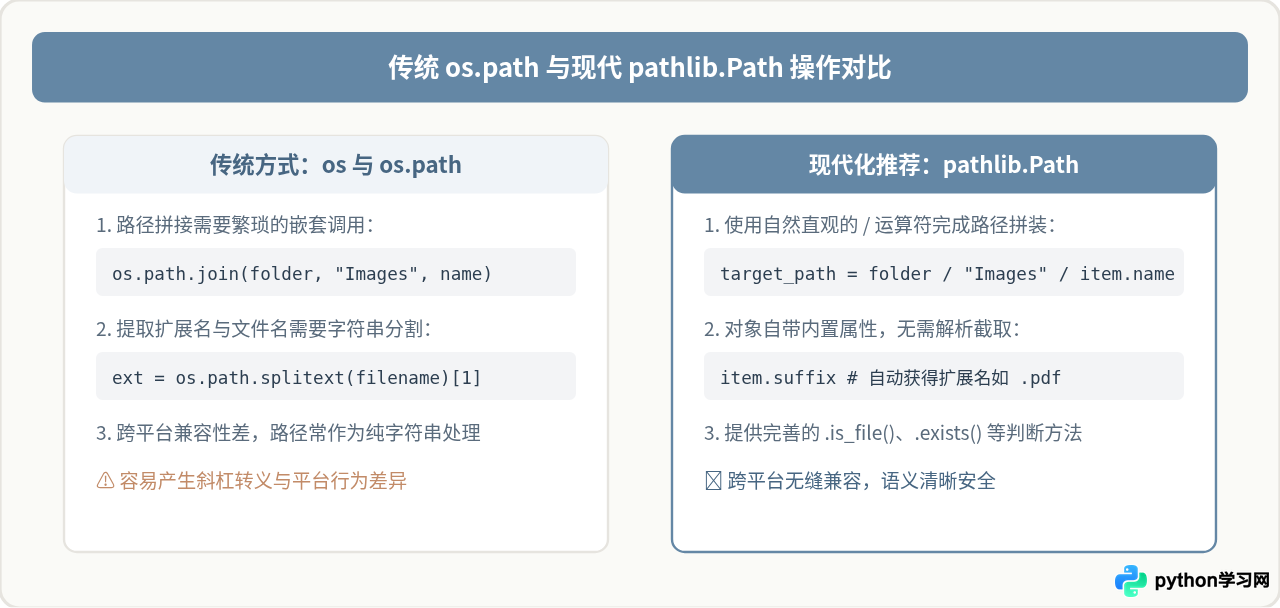
在文件移动的最后一步,我们搭配使用 shutil.move。shutil 是 Python 标准库中处理高级文件操作的工具,不仅能处理同磁盘分区下的快速重命名移动,还能在跨分区时自动进行复制并删除源文件,非常稳健。
三、核心执行步骤与实现细节
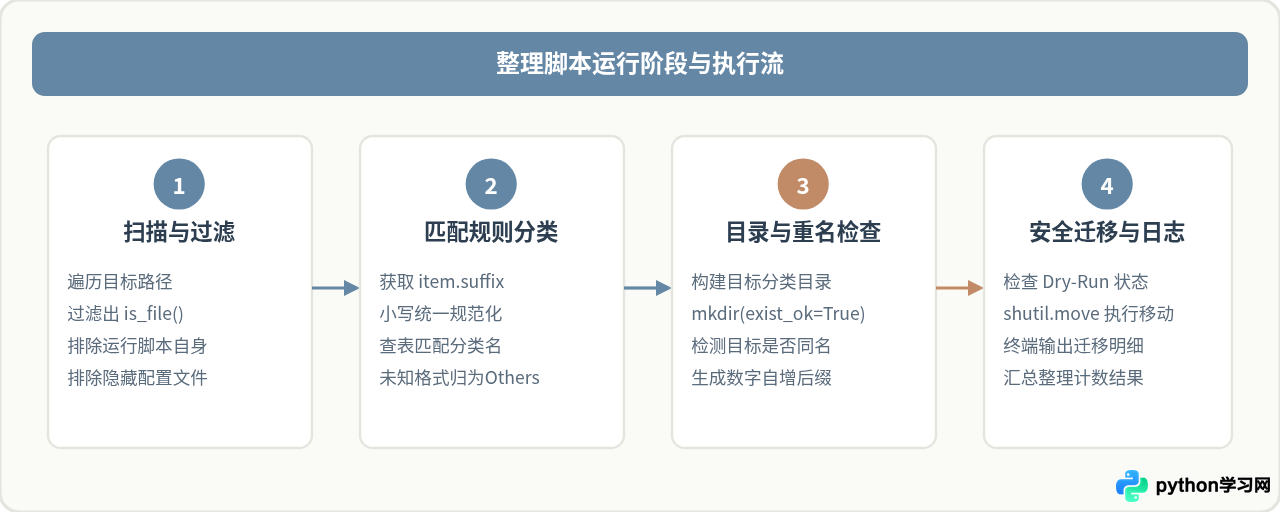
编写自动化整理脚本主要分为四个有序步骤,每个步骤承担单一职责:
1. 规则映射表的定义
在脚本开头,我们用一个 Python 字典将常见扩展名映射为语义清晰的中英文分类目录名。为了便于扩展,规则采用“目标文件夹名: 扩展名集合”的方式组织:
CATEGORIES = {
    "文档": {".pdf", ".docx", ".doc", ".xlsx", ".xls", ".pptx", ".txt", ".md"},
    "图片": {".jpg", ".jpeg", ".png", ".gif", ".webp", ".svg", ".bmp"},
    "压缩包": {".zip", ".tar", ".gz", ".7z", ".rar"},
    "安装包": {".dmg", ".pkg", ".exe", ".msi", ".deb"},
    "音视频": {".mp4", ".mov", ".mkv", ".mp3", ".wav", ".flac"},
    "代码与脚本": {".py", ".sh", ".json", ".yaml", ".yml", ".sql"}
}
2. 目标同名防覆盖机制
新手编写文件整理脚本最容易忽视的隐患是文件覆盖。如果目标子文件夹中已经存在一个同名文件(例如 report.pdf),直接调用移动方法可能在部分平台或底层实现中导致静默覆盖丢失历史数据。
为了保障数据绝对安全,我们在移动前必须检查目标文件是否已存在。如果已存在,则通过递增序号为其重命名,例如 report_1.pdf、report_2.pdf:
def get_unique_path(target_path: Path) -> Path:
    """若目标文件已存在,自动生成带递增序号的安全路径"""
    if not target_path.exists():
        return target_path

    parent = target_path.parent
    stem = target_path.stem
    suffix = target_path.suffix
    counter = 1

    while True:
        new_path = parent / f"{stem}_{counter}{suffix}"
        if not new_path.exists():
            return new_path
        counter += 1
四、完整可运行脚本
以下是具备防误删、预演模式(Dry-Run)和同名冲突处理的完整脚本代码。你只需保存为 organize_files.py 即可直接运行:
import shutil
from pathlib import Path

# 分类规则字典
CATEGORIES = {
    "文档": {".pdf", ".docx", ".doc", ".xlsx", ".xls", ".pptx", ".txt", ".md"},
    "图片": {".jpg", ".jpeg", ".png", ".gif", ".webp", ".svg", ".bmp"},
    "压缩包": {".zip", ".tar", ".gz", ".7z", ".rar"},
    "安装包": {".dmg", ".pkg", ".exe", ".msi", ".deb"},
    "音视频": {".mp4", ".mov", ".mkv", ".mp3", ".wav", ".flac"},
    "代码与数据": {".py", ".sh", ".json", ".yaml", ".yml", ".sql"}
}

def get_unique_path(target_path: Path) -> Path:
    """防止同名文件覆盖,若存在则追加 _1, _2 序号"""
    if not target_path.exists():
        return target_path
    parent = target_path.parent
    stem = target_path.stem
    suffix = target_path.suffix
    counter = 1
    while True:
        new_path = parent / f"{stem}_{counter}{suffix}"
        if not new_path.exists():
            return new_path
        counter += 1

def organize_directory(target_dir: str, dry_run: bool = True):
    """
    整理指定目录下的文件
    :param target_dir: 待整理的文件夹路径
    :param dry_run: 是否为预演模式(默认为 True,只打印操作不移动文件)
    """
    folder = Path(target_dir).resolve()

    if not folder.exists() or not folder.is_dir():
        print(f"❌ 路径无效或不是文件夹: {folder}")
        return

    print(f"📂 正在扫描目录: {folder}")
    if dry_run:
        print("💡 当前为【预演模式 (Dry-Run)】,不会真正移动任何文件。\n" + "-" * 50)
    else:
        print("⚡ 当前为【正式执行模式】,即将开始移动文件...\n" + "-" * 50)

    # 统计信息
    stats = {"moved": 0, "skipped": 0}
    current_script_name = Path(__file__).name if "__file__" in globals() else ""

    for item in folder.iterdir():
        # 只处理文件,跳过所有子目录
        if not item.is_file():
            continue

        # 排除脚本自身与系统隐藏文件(以.开头)
        if item.name == current_script_name or item.name.startswith("."):
            stats["skipped"] += 1
            continue

        # 获取小写扩展名
        file_suffix = item.suffix.lower()
        target_category = "其他"

        for category, extensions in CATEGORIES.items():
            if file_suffix in extensions:
                target_category = category
                break

        # 规划目标路径
        dest_folder = folder / target_category
        dest_file = dest_folder / item.name

        if not dry_run:
            dest_folder.mkdir(parents=True, exist_ok=True)
            safe_dest_file = get_unique_path(dest_file)
            shutil.move(str(item), str(safe_dest_file))
            print(f"已移动: {item.name} -> {target_category}/{safe_dest_file.name}")
        else:
            print(f"[预演] 计划移动: {item.name} -> {target_category}/{item.name}")

        stats["moved"] += 1

    print("-" * 50)
    print(f"✅ 处理完成!统计:共处理 {stats['moved']} 个文件,跳过 {stats['skipped']} 个文件。")

if __name__ == "__main__":
    # 请根据实际情况修改要整理的目录路径
    # 例如:Path.home() / "Downloads" 代表当前用户主目录下的“下载”文件夹
    target_path = Path.home() / "Downloads"

    # 建议首次运行保持 dry_run=True,确认输出符合预期后改为 False
    organize_directory(target_path, dry_run=True)
dry_run=True(预演模式)。终端会以 [预演] 计划移动: ... 打印出每个文件即将被归类的目标,但并不会对磁盘文件做任何实际改动。仔细核对输出后,再把参数改为 dry_run=False 运行即可安全归类。
五、安全防错与进阶运行建议
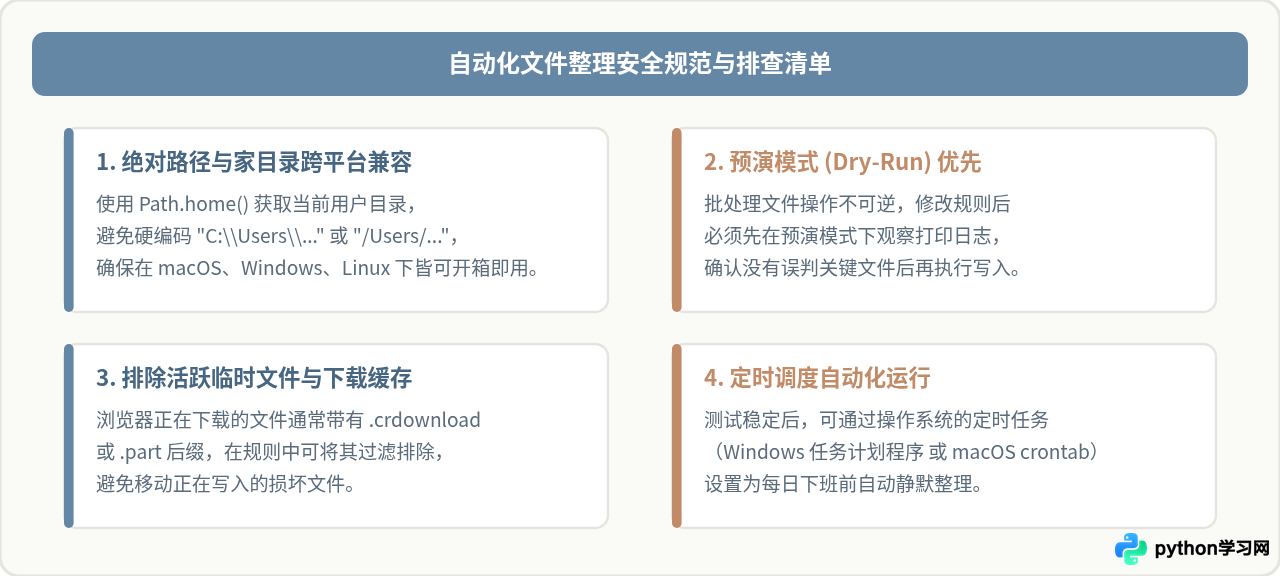
在开发与使用自动化批处理脚本时,除了完成基本功能外,保证执行过程的可控性与容错性同样关键。以下是推荐的防错核对要点:
通过本文的实战练习,我们不仅掌握了 pathlib.Path 与 shutil 的常用操作,还体会到了用代码解决实际日常琐事的效率优势。根据个人需求,你还可以进一步扩展脚本,比如增加按文件修改年份/月份归类、自动解压归档包等定制功能。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









