

Python Requests模块基础:怎么实现HTTP数据抓取自动化
系统介绍如何使用Python Requests模块构建高可用的HTTP数据抓取自动化流程,涵盖请求参数配置、Session会话保持、超时防御、自动重试机制与数据解析落盘实战。
实现HTTP数据抓取自动化的关键,在于将单次手动请求升级为具有参数批量调度、连接状态复用、网络抖动容错以及数据规范解析的程序流水线。Python的Requests模块提供了优雅且功能完备的HTTP接口抽象,开发者通过组合使用会话对象(Session)、超时控制(Timeout)、请求适配器(HTTPAdapter)与JSON序列化,即可在极短的代码量下搭建出无人值守、高可用的自动化数据采集任务。
一、自动化HTTP数据抓取的系统化架构
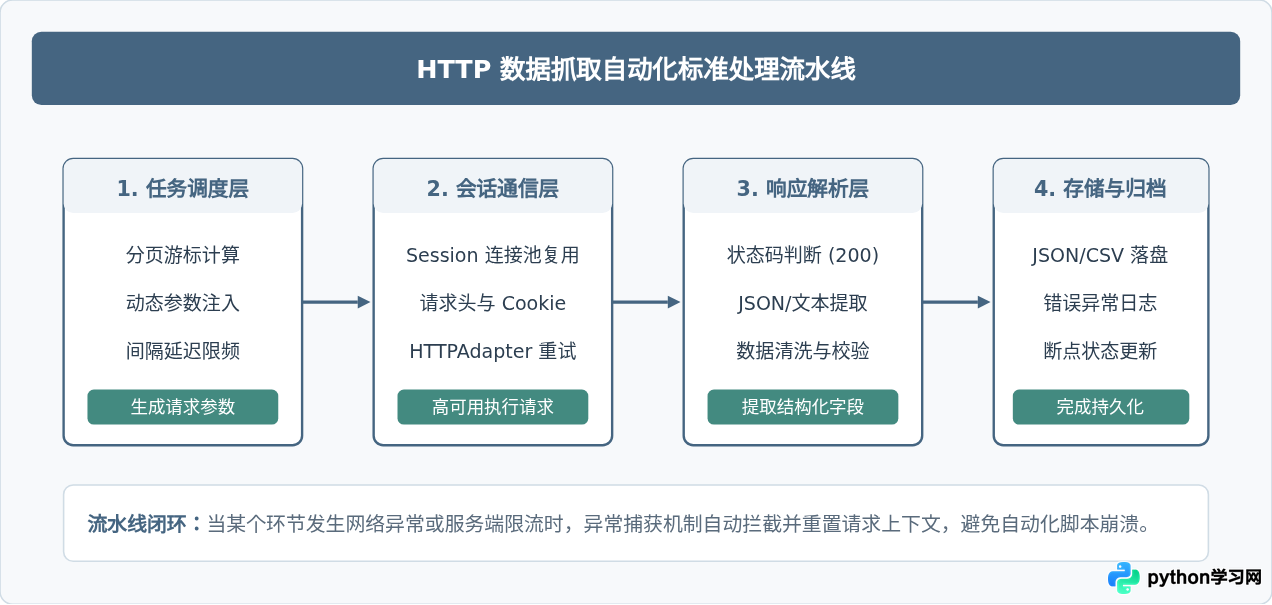
在编写具体代码前,必须建立清晰的自动化抓取架构视图。常规的手工采集往往只关注某一次请求是否成功,而自动化任务则需要在无人工干预的情况下长期运行,核心流程包括四个环环相扣的阶段:
- 任务队列与参数调度:负责管理待抓取的目标URL列表、分页游标、查询参数与时间间隔。
- 网络会话与适配层:借助Session对象持久化连接池,统一挂载请求头(User-Agent、Token)与自动重试策略。
- 响应验证与内容提取:严格校验HTTP状态码,根据数据类型解析结构化JSON或HTML文档片段。
- 数据持久化与错误兜底:将有效数据落盘存储(如写入JSON/CSV),并将无法处理的异常记录到日志中,保证流程不崩溃中断。
二、Requests 基础:构建标准自动化请求
自动化抓取通常首先面对的是目标接口的调用规范。Requests 库通过简单的接口封装了底层的复杂网络协议。在终端环境中运行以下命令即可安装依赖:
pip install requests1. 动态参数构建与查询传参
很多初学者喜欢手动用字符串拼接 URL(如 url + "?page=" + str(page)),这种方式在遇到中文、空格或特殊标点符号时极易出现 URL 编码错误。自动化采集应始终将查询参数交由 params 字典处理:
import requests

def fetch_page(page_index, category):
    base_url = "https://api.example.com/v1/articles"
    # 参数字典自动负责 URL 编码及连接符拼接
    query_params = {
        "page": page_index,
        "page_size": 20,
        "category": category,
        "format": "json"
    }

    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
        "Accept": "application/json"
    }

    # 发起请求
    response = requests.get(base_url, params=query_params, headers=headers)
    return response
2. 规范化响应处理
在自动化逻辑中,绝不能假设每次请求都能得到预期的 JSON 结果。必须按步骤验证响应有效性:
response.status_code:首先确认状态码为 200,或者调用response.raise_for_status()直接在出现 4xx/5xx 时抛出异常。response.json():目标接口返回结构化数据时优先调用;如果返回的是 HTML,则使用response.text配合解析工具。response.encoding:当中文解析出现乱码时,检查该属性,必要时显式设置为response.encoding = 'utf-8'。
三、核心机制:使用 Session 会话实现高效率与状态保持
频繁调用 requests.get() 会为每一次请求新建一个底层的 TCP 连接,并在接收完毕后关闭套接字。在连续抓取成百上千个页面的自动化场景中,这会带来巨大的握手延迟与本地端口资源浪费。requests.Session() 对象解决了这一瓶颈。
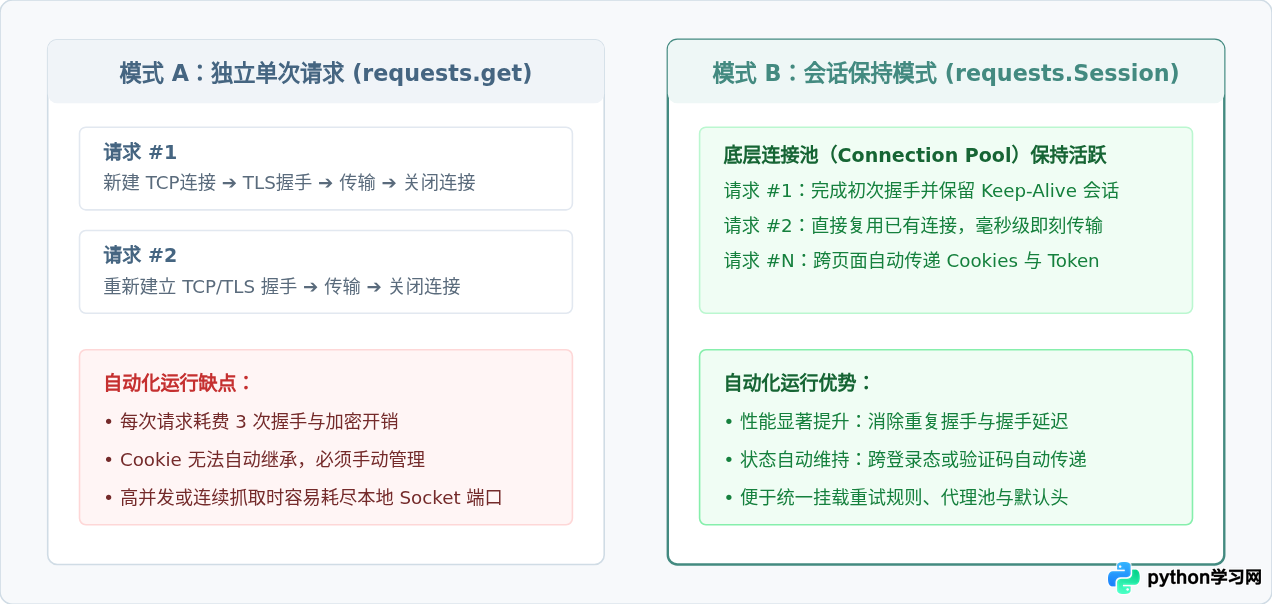
Session 对象在自动化中的具体用法如下。只需要实例化一个 session,并在整个抓取生命周期中持续使用它发送请求:
import requests

# 创建会话对象
session = requests.Session()

# 为整个会话配置全局统一的请求头
session.headers.update({
    "User-Agent": "DataCollectorBot/1.0",
    "Authorization": "Bearer sample_token_string"
})

# 发起多次抓取,自动共享 Cookie 与底层 TCP 连接
resp1 = session.get("https://api.example.com/v1/user/login")
resp2 = session.get("https://api.example.com/v1/user/profile")
四、自动化抓取的生命线:超时防御与自动重试机制
如果说 Session 决定了抓取的速度,那么超时和重试则决定了抓取的存活率。在自动化运维中,由于目标服务器负载波动或跨网络延迟,请求可能卡死在握手或数据读取阶段。默认情况下,Requests 的请求没有超时限制(即无限等待),一旦某个请求挂起,整个自动化任务就会永久僵死。
1. 显式配置超时参数(Timeout)
编写自动化抓取代码时,必须为每一个网络请求指定 timeout。建议采用元组形式分别指定“连接超时”与“读取超时”:
# timeout=(连接超时秒数, 读取响应超时秒数)
response = session.get("https://api.example.com/data", timeout=(3.05, 10))
2. 使用 HTTPAdapter 实现指数退避重试
遇到服务器偶发性的 500、502、503 错误或短暂网络丢包时,直接让脚本崩溃报错是不可接受的。通过在 Session 上挂载 requests.adapters.HTTPAdapter 和 urllib3.util.Retry,可以在底层实现自动指数退避重试:
from requests.adapters import HTTPAdapter
from urllib3.util import Retry

def create_resilient_session():
    session = requests.Session()

    # 定义重试策略
    retry_strategy = Retry(
        total=3,                       # 最多重试 3 次
        backoff_factor=1,             # 退避系数:重试间隔分别为 1s, 2s, 4s
        status_forcelist=[429, 500, 502, 503, 504], # 触发重试的状态码
        allowed_methods=["GET", "POST"] # 允许重试的请求方法
    )

    # 挂载到 http:// 和 https:// 协议前缀
    adapter = HTTPAdapter(max_retries=retry_strategy)
    session.mount("http://", adapter)
    session.mount("https://", adapter)

    return session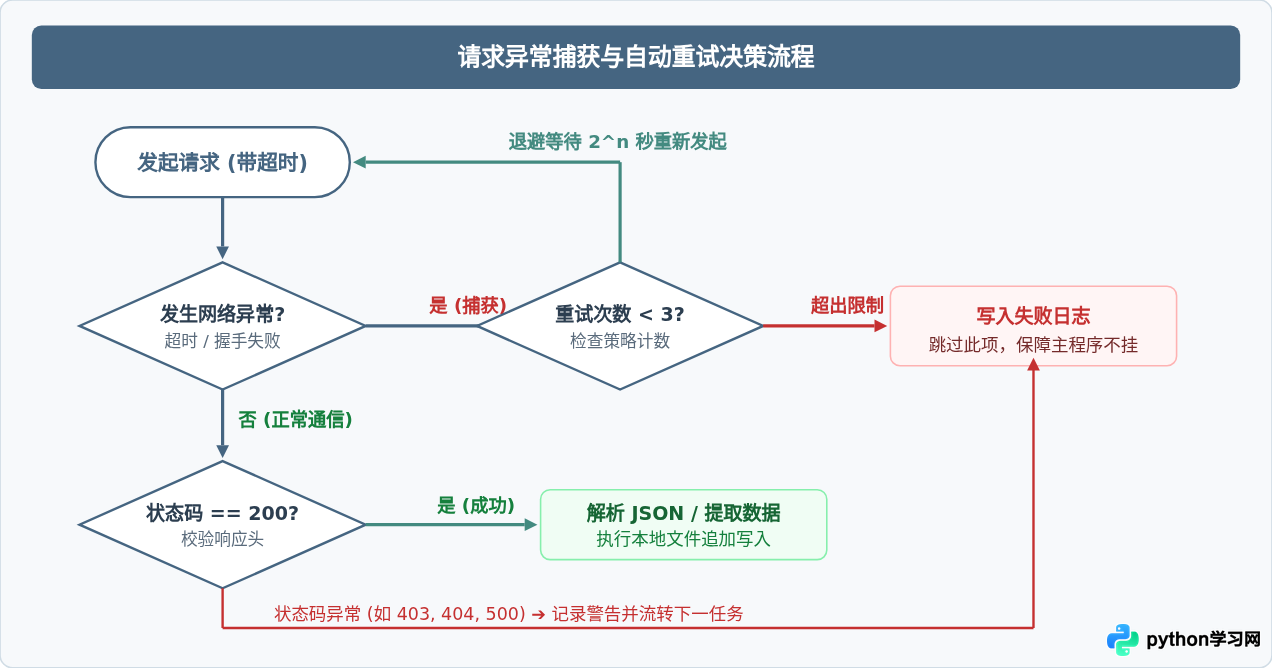
五、实战落地:完整的自动化分页数据抓取程序
下面我们将上述所有核心知识串联起来,实现一个标准的自动化数据抓取脚本。该脚本具备多页自动遍历、参数动态构造、请求间隔限频(避免触发对方风控)、高可用会话池与最终结果落盘功能:
import time
import json
import logging
import requests
from requests.adapters import HTTPAdapter
from urllib3.util import Retry

# 配置基础日志记录
logging.basicConfig(
    level=logging.INFO,
    format="%(asctime)s [%(levelname)s] %(message)s"
)

class AutomatedDataCollector:
    def __init__(self, base_url, max_retries=3):
        self.base_url = base_url
        self.session = self._init_resilient_session(max_retries)

    def _init_resilient_session(self, max_retries):
        session = requests.Session()
        session.headers.update({
            "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36",
            "Accept": "application/json"
        })

        # 配置指数退避重试规则
        retry_rule = Retry(
            total=max_retries,
            backoff_factor=0.8,
            status_forcelist=[429, 500, 502, 503, 504],
            allowed_methods=["GET"]
        )
        adapter = HTTPAdapter(max_retries=retry_rule)
        session.mount("http://", adapter)
        session.mount("https://", adapter)
        return session

    def crawl_pages(self, total_pages=5, delay_seconds=1.5):
        collected_data = []

        for page in range(1, total_pages + 1):
            params = {
                "page": page,
                "limit": 20,
                "order": "desc"
            }
            logging.info(f"正在抓取第 {page}/{total_pages} 页数据...")

            try:
                # 设定双超时:连接超时 3 秒,读取超时 10 秒
                response = self.session.get(self.base_url, params=params, timeout=(3.0, 10.0))

                # 遇到非 200 响应触发 HTTPError
                response.raise_for_status()

                payload = response.json()
                items = payload.get("data", {}).get("items", [])

                if not items:
                    logging.info(f"第 {page} 页未检测到更多数据,提前结束。")
                    break

                collected_data.extend(items)
                logging.info(f"第 {page} 页抓取成功,获取记录数: {len(items)}")

            except requests.exceptions.Timeout:
                logging.error(f"第 {page} 页请求超时,已达到最大重试限制,跳过该页。")
            except requests.exceptions.HTTPError as err:
                logging.error(f"第 {page} 页服务端响应错误: {err}")
            except requests.exceptions.RequestException as err:
                logging.error(f"第 {page} 页网络异常: {err}")

            # 自动化抓取的礼貌休眠,降低目标服务器负载与被封禁概率
            time.sleep(delay_seconds)

        return collected_data

    def save_to_file(self, data, file_path="output_dataset.json"):
        with open(file_path, "w", encoding="utf-8") as f:
            json.dump(data, f, ensure_ascii=False, indent=2)
        logging.info(f"数据抓取完成,共保存 {len(data)} 条记录至 {file_path}")

if __name__ == "__main__":
    # 使用公开测试 API 或自身业务接口进行自动化抓取
    TARGET_API = "https://jsonplaceholder.typicode.com/posts"
    collector = AutomatedDataCollector(base_url=TARGET_API)
    results = collector.crawl_pages(total_pages=3, delay_seconds=1.0)
collector.save_to_file(results, "posts_output.json")HTTPAdapter 会自动重试;若重试耗尽,try...except 会保证后续页面继续处理,最后安全将已有数据写入 posts_output.json。
六、自动化生产环境中的关键注意事项
将抓取脚本部署到自动化定时任务(例如 Linux Crontab、Airflow 或云函数)中时,需重点防范以下工程陷阱:
- 请求频率限制(Rate Limiting):自动化程序运行速度远高于人类操作。不要在循环内发起裸请求,必须通过
time.sleep()保持固定或轻微浮动的间隔,尊重目标站点的robots.txt与并发限制。 - 代理池轮换(Proxy Pool):高频自动化任务常被目标服务器封锁单源 IP。Requests 允许在 Session 级别或单个请求中传入
proxies={"http": "http://user:pass@ip:port", "https": "http://user:pass@ip:port"}实现无缝切 IP。 - 流式下载大文件:如果抓取内容包含大型图片或归档压缩包,不要直接使用
response.content将全部内容加载入内存,应设置stream=True并使用iter_content(chunk_size=8192)分块边下边存,避免程序内存溢出。
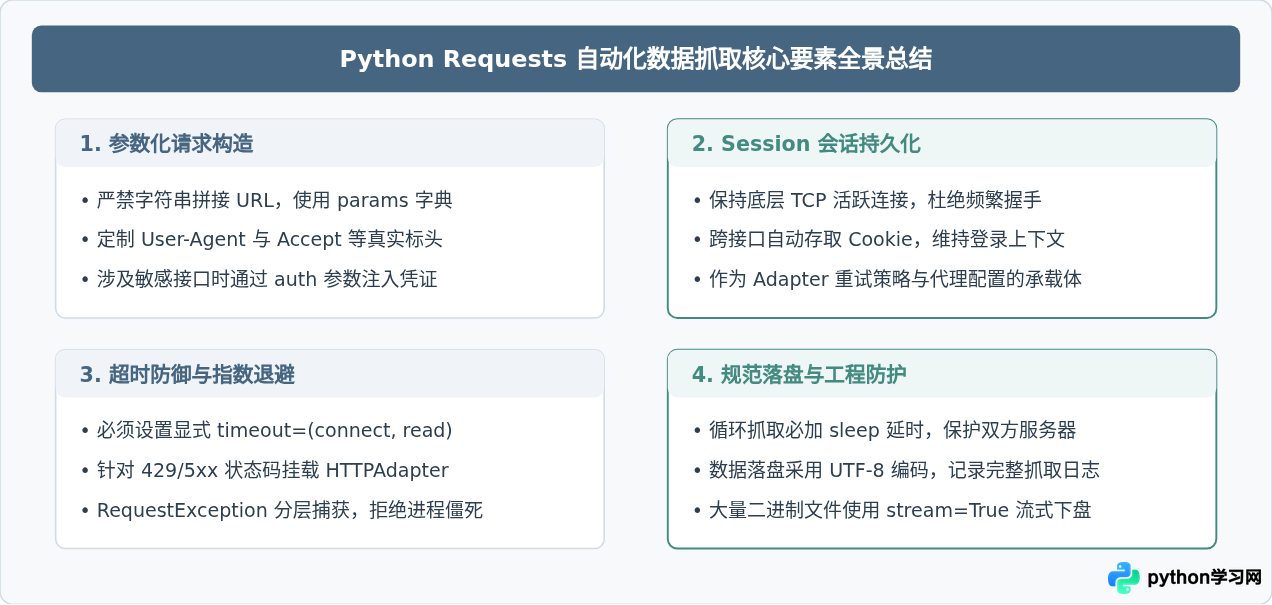
掌握了从参数化构造、Session 连接复用到超时重试与规范化落盘的全流程,开发者即可告别脆弱脆弱易崩的手工脚本,编写出能抵御网络波动、长期稳定运行的工业级 HTTP 自动化抓取程序。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









