

按场景查找Python标准库:文件处理、网络请求与数据序列化模块映射
发布时间:2026-10-27| 6人浏览过
Python 拥有“开箱即用(Batteries Included)”的丰富标准库体系。在受限网络环境、基础脚本运维或追求零第三方依赖的生产场景下,清晰掌握各功能模块的映射边界,能够帮助开发者准确且迅速地写出健壮、高效的原生代码。本文围绕文件处理、网络请求与数据序列化三大高频场景,逐一梳理标准库模块的定位、场景映射及最佳实践。
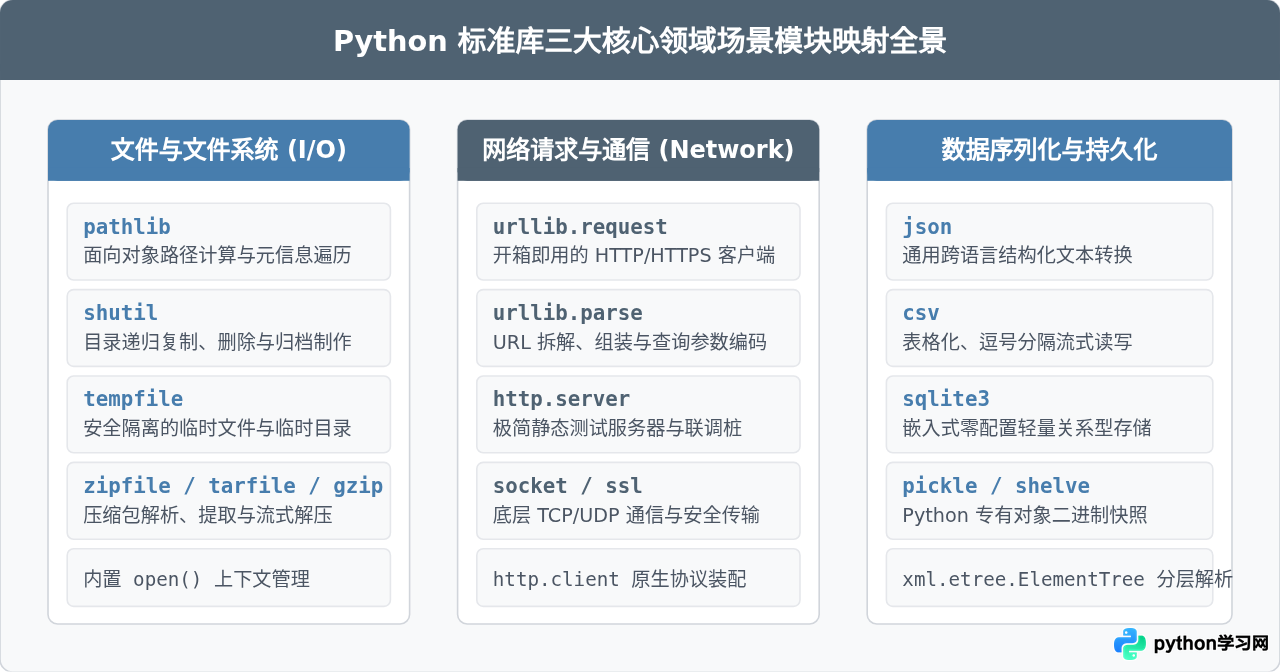
三大核心领域标准库映射全景
标准库各个模块并非孤立存在,而是依照“底层驱动协议、中间数据格式、高层便捷接口”的结构进行分工协作。面对具体任务时,优先选用高层抽象模块往往能减少样板代码,而在需要定制协议或极度追求控制粒度时,再向下沉淀到底层模块。
文件处理场景:路径管理、目录操作与归档
在早期 Python 脚本中,文件处理通常混杂着 os、os.path 和 glob。现代 Python 代码已经全面推崇以面向对象方式管理路径与文件元数据。
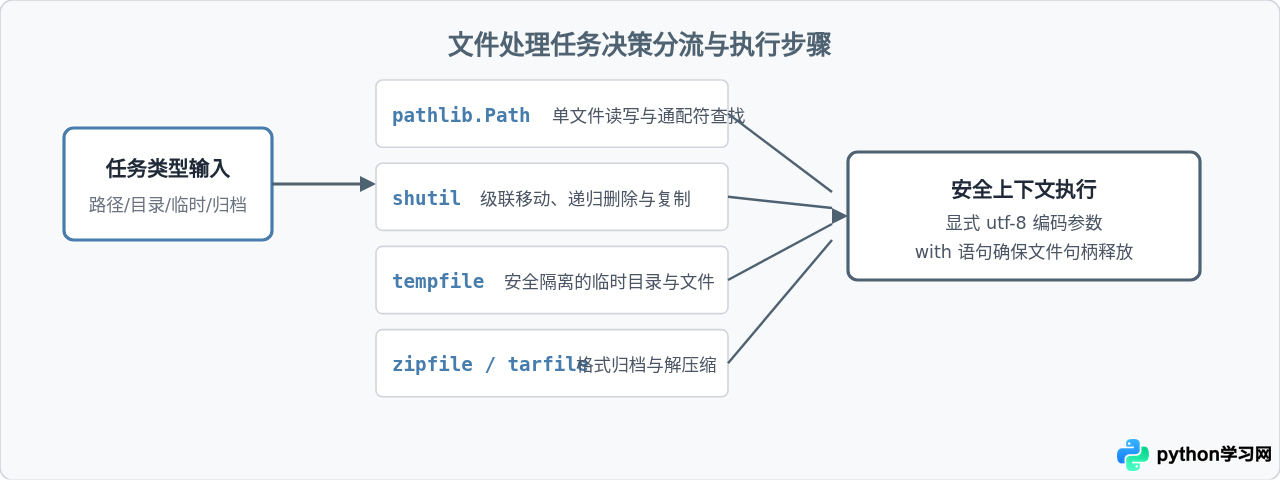
场景选型与模块指引
- 单文件路径计算、检查与简单读写:优先选用
pathlib。它通过除号/重载运算符实现跨平台路径拼接,并封装了read_text()、write_text()等高频方法。 - 整目录递归复制、强制级联删除与整体打包:选用
shutil。pathlib刻意不提供递归删除整目录的方法,目的是规避误删风险,这种高阶重操作应交由shutil.rmtree()和shutil.copytree()。 - 自动化任务中的中间缓存与安全隔离:选用
tempfile。避免在工作目录下硬编码tmp.txt,防止并发冲突及权限泄漏。 - 压缩文件提取与分析:按格式分别对应
zipfile、tarfile或流式解压gzip。
代码示例:路径扫描与临时归档工作流
以下示例展示如何结合 pathlib、tempfile 与 shutil,在隔离环境中生成报表文件并打包,整个过程无需第三方库:
from pathlib import Path
import tempfile
import shutil

# 1. 使用 pathlib 构建基础目录结构并写入文件
base_dir = Path("workspace_demo")
report_dir = base_dir / "reports"
report_dir.mkdir(parents=True, exist_ok=True)

report_file = report_dir / "summary.txt"
report_file.write_text("状态: 检查完成\n耗时: 12ms\n", encoding="utf-8")

# 2. 结合 tempfile 在受控临时目录中组织待归档数据
with tempfile.TemporaryDirectory() as tmp_str:
    tmp_path = Path(tmp_str)
    archive_source = tmp_path / "package_root"
    archive_source.mkdir()

    # 复制工作成果到临时打包区
    shutil.copy2(report_file, archive_source / "summary_copied.txt")

    # 3. 利用 shutil 生成 zip 格式压缩包
    zip_output = base_dir / "final_report"
    shutil.make_archive(str(zip_output), format="zip", root_dir=str(archive_source))
    print(f"压缩包已生成: {zip_output}.zip")

# 清理演示目录
shutil.rmtree(base_dir)
注意事项:在 Windows 平台上使用内置
open() 或 pathlib.Path.write_text() 时,默认字符集可能是 gbk 或 cp936。务必始终显式声明 encoding="utf-8",避免跨平台运行时出现中文乱码或解码异常。
网络请求与传输场景:从协议封装到底层套接字
当项目需要调用外部 Web API 或在局域网内进行节点探活,且环境不允许执行 pip install requests 时,Python 标准库的 urllib 系列组件是唯一的原生利器。
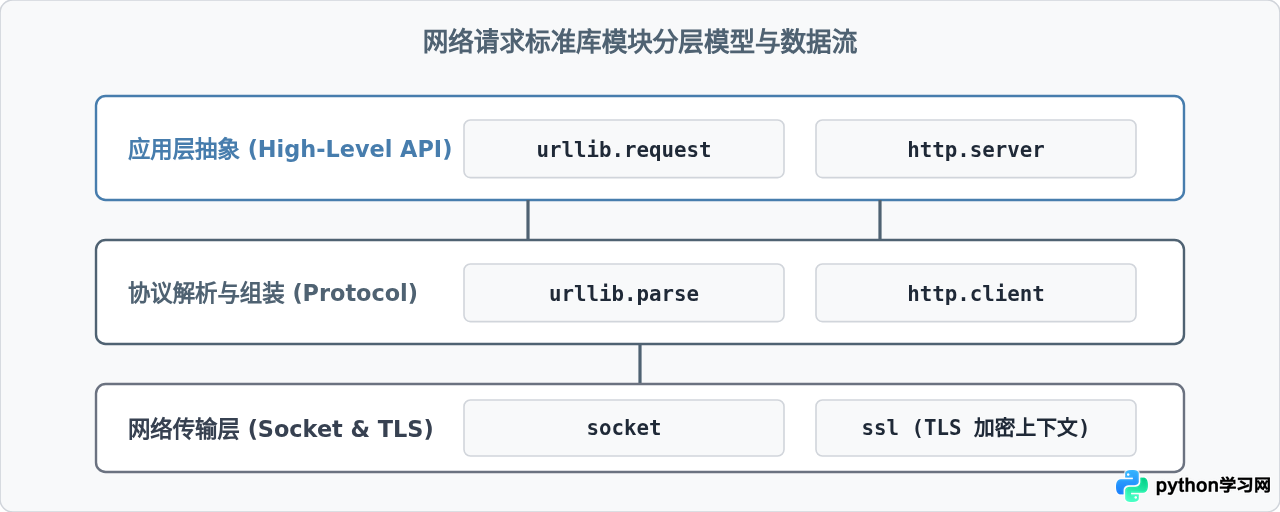
模块分层与场景映射
- RESTful API 调用与网页内容获取:使用
urllib.request.Request配合urllib.request.urlopen。可以配置超时、自定义 Header(如 User-Agent、Token 认证),读取二进制或解码字符串。 - Query 参数组装与转义:使用
urllib.parse.urlencode()处理字典参数,使用quote()/unquote()处理单个特殊字符,使用urlparse()解构 URL 结构。 - 本地轻量调试与假桩搭建:使用
http.server。既可以通过终端命令python -m http.server 8000快速分享目录,也可以在脚本中继承SimpleHTTPRequestHandler拦截测试请求。 - 底层传输控制与私有协议交互:使用
socket。用于精确控制 TCP 握手、超时探测或 UDP 广播。
代码示例:原生标准库发起带认证与超时的 GET/POST 请求
在没有 requests 库时,通过配置 Request 对象的 Header 与参数,可以完整实现业务接口调用:
import urllib.request
import urllib.parse
import json

# 1. 组装 URL 参数
base_url = "https://httpbin.org/get"
query_params = {
    "module": "urllib.request",
    "version": "python3"
}
full_url = f"{base_url}?{urllib.parse.urlencode(query_params)}"

# 2. 构造请求头与请求对象
headers = {
    "User-Agent": "NativePythonClient/1.0",
    "Accept": "application/json"
}
req = urllib.request.Request(full_url, headers=headers)

# 3. 执行请求并必须显式设定 timeout
try:
    with urllib.request.urlopen(req, timeout=8.0) as resp:
        # 获取状态码与响应体
        status_code = resp.status
        content_type = resp.headers.get_content_charset() or "utf-8"
        raw_body = resp.read()

        parsed_data = json.loads(raw_body.decode(content_type))
        print(f"请求状态: {status_code}, 远端接收参数: {parsed_data.get('args')}")
except urllib.error.HTTPError as err:
    print(f"HTTP 响应异常: {err.code} - {err.reason}")
except urllib.error.URLError as err:
    print(f"网络连接故障: {err.reason}")
避坑警示:
urllib.request.urlopen() 如果不传 timeout 参数,默认将等待操作系统的全局 socket 超时(可能长达数分钟甚至无限挂起)。在任何网络请求代码中,务必显式设定 timeout。
数据序列化与持久化:格式特性与安全选型
数据序列化用于内存对象与外部介质(磁盘、网络流)之间的互相转换。标准库提供了多种方案,但它们在跨语言兼容性和反序列化安全性上存在本质区别。
模块功能定位
json(首选标准):用于 Web API 交互与配置文件。只支持基本数据类型(dict、list、str、int、float、bool、None),跨语言兼容性最佳且默认解析安全。csv(流式数据):针对逗号分隔表格数据。标准库的csv.DictReader和csv.DictWriter可以将字典直接映射为包含表头的行数据,内存占用极小。sqlite3(嵌入式存储):当数据存在多维度过滤、关系关联或单文件结构化检索需求时,sqlite3远优于自建的大型 JSON 文件,支持完整的 ACID 事务。pickle与shelve(专有二进制与安全红线):能够无缝序列化几乎所有 Python 自定义类对象。但pickle绝不能反序列化未经验证的不可信数据,因为其还原过程能够调用任意 Python 构造函数,极易被利用执行恶意命令。
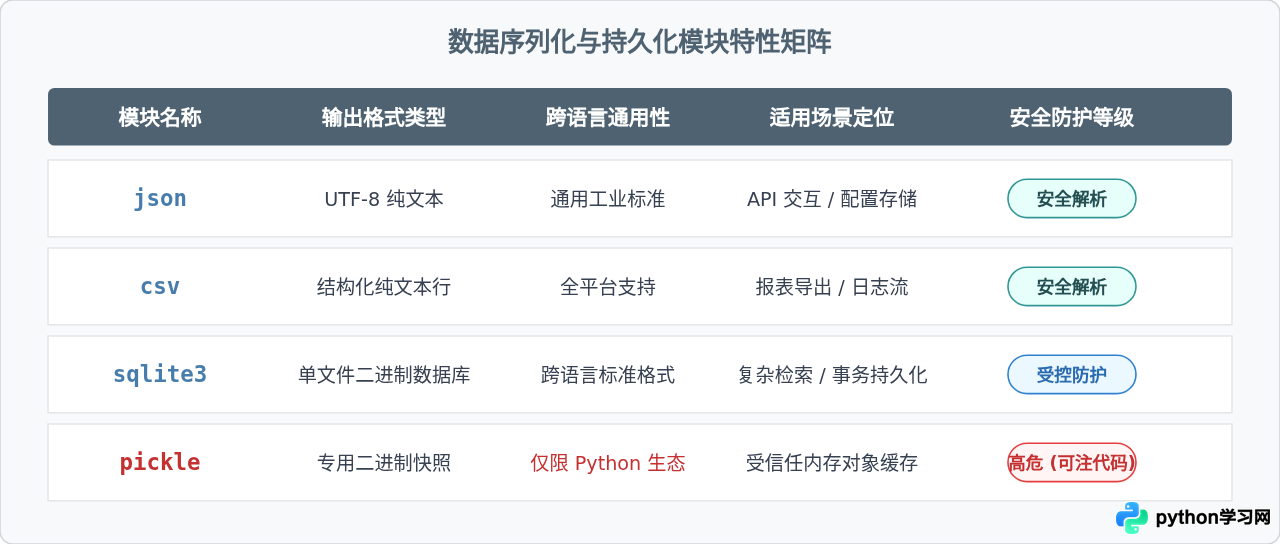
代码示例:自定义 JSON 编码器与 SQLite 事务控制
在处理 datetime 等非原生 JSON 支持的类型时,继承 json.JSONEncoder 可以实现优雅扩展;而针对结构化数据,使用 sqlite3 参数化查询能杜绝注入并保证事务安全:
import json
import sqlite3
from datetime import datetime

# 1. 扩展 json 序列化能力
class ComplexEncoder(json.JSONEncoder):
    def default(self, obj):
        if isinstance(obj, datetime):
            return obj.strftime("%Y-%m-%d %H:%M:%S")
        return super().default(obj)

payload = {
    "task": "数据同步",
    "updated_at": datetime.now(),
    "items": [101, 102]
}
json_output = json.dumps(payload, cls=ComplexEncoder, ensure_ascii=False)
print("JSON 格式化输出:", json_output)

# 2. 使用 sqlite3 内存模式进行事务操作
with sqlite3.connect(":memory:") as conn:
    cursor = conn.cursor()
    cursor.execute("CREATE TABLE records (id INTEGER PRIMARY KEY, content TEXT)")

    # 使用占位符防止 SQL 注入
    cursor.executemany(
        "INSERT INTO records (content) VALUES (?)",
        [("配置项 A",), ("配置项 B",)]
    )
    conn.commit()

    cursor.execute("SELECT id, content FROM records WHERE id = ?", (1,))
    row = cursor.fetchone()
    print(f"数据库记录命中: ID={row[0]}, 内容={row[1]}")
模块选型快速速查指南
为了在实际编码中快速查表匹配,下表总结了日常研发中最常见的任务场景及其对应的推荐标准库模块与替代方案:
| 场景需求 | 首选标准库模块 | 底层/备选模块 | 核心选型要点 |
|---|---|---|---|
| 跨平台文件路径拼接、目录创建、遍历 | pathlib |
os.path, glob |
语法优雅,用 / 拼接,替代旧版繁琐的 os.path.join |
| 整目录移动、删除或生成 .zip / .tar 包 | shutil |
zipfile, tarfile |
shutil.make_archive 几行代码即可完成标准压缩归档 |
| 单元测试或数据计算的临时隔离区 | tempfile |
手动构造临时路径 | 离开 with 上下文自动物理清理,避免磁盘残留碎片 |
| 原生 HTTP GET / POST 接口调用 | urllib.request |
http.client |
零依赖场景首选,务必配合 urllib.parse 与显式 timeout |
| 局域网静态测试文件快速分发 | http.server |
socket |
命令行 python -m http.server 一键启动本地站点 |
| 微服务或跨语言系统数据交换 | json |
csv |
标准通用,默认解析安全,避免在跨网络场景使用 pickle |
| 纯单机轻量级关系数据与配置缓存 | sqlite3 |
shelve |
支持索引、事务与复杂 SQL 检索,单文件易于分发管理 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









