

适合新手练手的Python爬虫静态网站推荐
专为Python爬虫新手整理的静态网站练手推荐与实践指南,详解Quotes to Scrape、Books to Scrape等站点的抓取方法、核心解析原理及避坑要点。
学习 Python 爬虫最有效的方法,是从结构规范、无反爬干扰的静态网站开始动手实践。本文推荐四个专为初学者设计的静态练习网站,梳理从页面探测、发送请求、DOM解析到结构化存储的核心流程,并提供完整的可执行代码与避坑指南,帮助初学者扎实掌握爬虫基础技能。
一、新手入门为何必须首选静态网站
在网络数据抓取中,静态网页指服务器返回的 HTML 文本已经包含了页面上呈现的全部文字和链接信息。初学者在浏览器中打开目标网页,只需右键点击并选择“查看网页源代码”,如果能够直接通过搜索找到目标内容,该网页即为标准的静态页面。
与依赖 JavaScript 异步渲染、动态 API 接口或频繁弹出滑块验证码的动态网站相比,静态网站的核心优势在于路径明确。初学者不需要学习逆向工程、参数解密或配置无头浏览器(如 Selenium、Playwright),只需要掌握两个核心标准库工具:负责发送网络请求的 requests 库,以及负责解析 HTML 节点的 BeautifulSoup(或 lxml)。把精力聚焦在 HTTP 协议基础、DOM 树节点定位和数据清洗上,能够迅速建立清晰的数据抓取心智模型。
二、精选适合新手练手的静态网站推荐
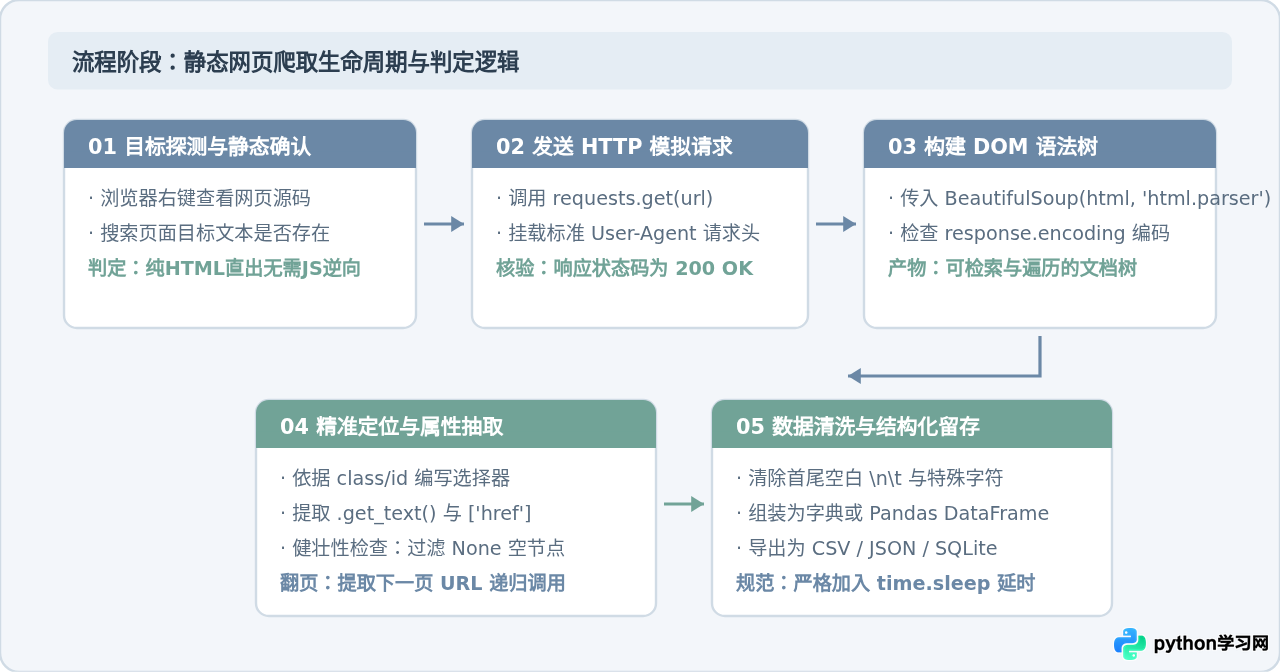
为了让学习循序渐进,以下精选了四个不同难度梯度的静态练手网站。这些网站均公开提供抓取测试,无封禁风险,结构规整。
1. Quotes to Scrape(名言抓取练习站)
网址:http://quotes.toscrape.com
特点介绍:这是业界公认最经典的新手爬虫练习沙盒。网站每页陈列 10 条名人名言,包含名言文本内容、作者姓名、作者简介链接以及标签列表。底部带有标准的“Next →”分页按钮。
核心练习目标:
- 使用
soup.select('div.quote')遍历列表容器; - 从单个容器内提取文本(
.get_text())与超链接属性(['href']); - 获取下一页的相对路径,利用
urllib.parse.urljoin拼接完整 URL,实现多页循环抓取。
2. Books to Scrape(模拟图书电商站)
网址:http://books.toscrape.com
特点介绍:该站点模拟了一个拥有 1000 本图书的完整在线书店,包含侧边栏 50 个分类目录、书籍缩略图、书名、价格、星级评级(通过 class 类名如 star-rating Three 体现)及库存状态。
核心练习目标:
- 跨层级两阶段抓取:先抓取列表页获取所有图书的详情页 URL,再发起二次请求进入详情页抓取完整简介、UPC 编码及库存数量;
- 清洗带有英镑符号(如
£51.77)的价格字符串,转化为纯浮点数; - 将英文字符评分(One, Two, Three, Four, Five)映射转换为整数数值。
3. ScrapeThisSite - Countries of the World(全球国家基础信息库)
网址:https://www.scrapethissite.com/pages/simple/
特点介绍:该页面平铺展示了全球 250 个国家与地区的基础统计信息,包括国家名称、首都、人口数量和国土面积。页面数据密度高,结构对称。
核心练习目标:
- 练习单页面批量结构化数据卡片的定位与解析;
- 对纯数字字段(如人口与面积)进行字符串清洗与数据类型转换;
- 将提取的字典列表直接灌入
pandas.DataFrame,并保存为标准的 CSV 数据报表。
4. 静态中文内容站点(如经典文学作品列表或技术博客归档)
特点介绍:在掌握英文沙盒站点后,初学者需要过渡到真实中文静态页面。例如古典诗词收录站的分类列表、个人静态技术博客的归档页(如 Hexo、Hugo 构建的静态站点)。
核心练习目标:
- 掌握中文字符编码识别(处理
utf-8与gbk编码转换,避免终端打印乱码); - 应对真实网络环境中的字段缺失异常(如某些条目缺少副标题或标签时的容错处理);
- 规范化设置
User-Agent请求头,模拟常规桌面浏览器访问。
三、静态网页解析原理:DOM 树与选择器定位
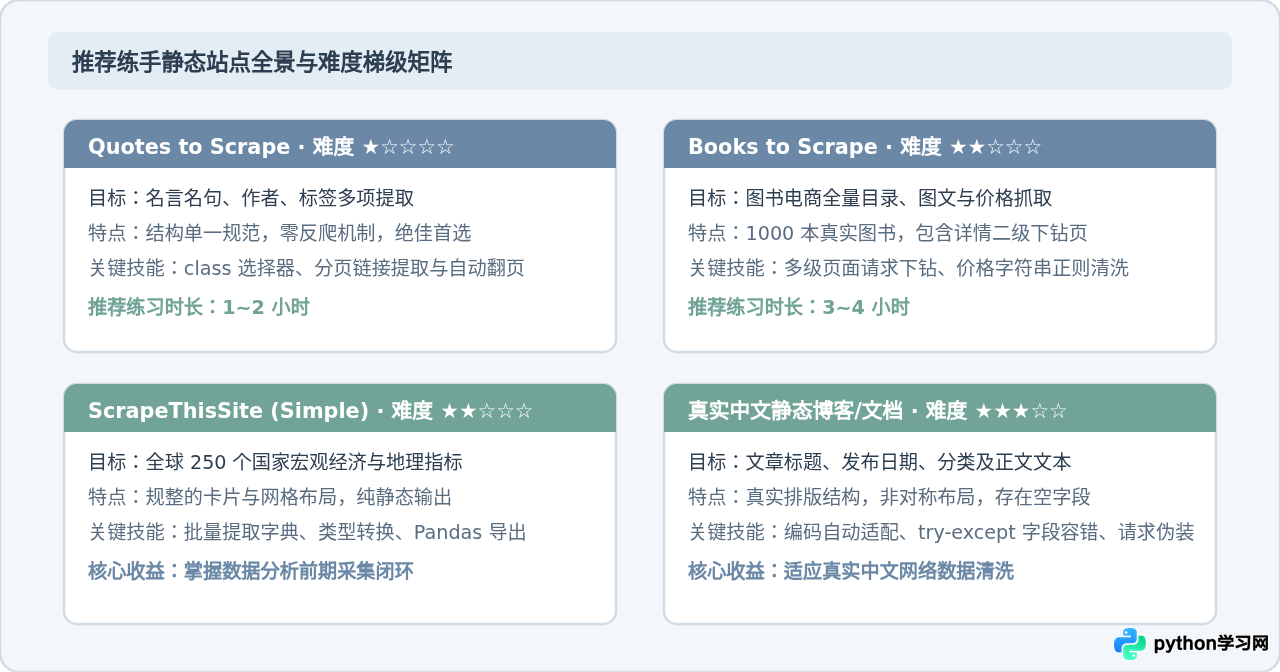
当通过 requests.get() 获取到网页源码后,返回的是一段连续的 HTML 字符串。计算机无法直接理解这段文本中的层级关系,因此需要通过解析库将字符串转化为“文档对象模型”(DOM 树)。
在 DOM 树中,所有的 HTML 标签都是树上的节点:外层标签是父节点,内层标签是子节点,并列标签是兄弟节点。定位所需数据主要有两种选择器语法:
- CSS 选择器(推荐初学者首选):与前端样式表语法完全一致。例如
div.quote表示匹配 class 包含 quote 的 div 标签;span.text表示匹配 class 为 text 的 span 标签;div.quote > span.text表示只选取直接子节点。 - XPath 路径表达式:基于 XML 路径的查询语言。例如
//div[@class="quote"]表示全局搜索类名为 quote 的 div;/span/text()提取子标签文本;/@href直接获取属性值。XPath 在向上查找父级或进行多条件复合筛选时表达能力极强。
四、完整实操代码:多页抓取与 CSV 导出
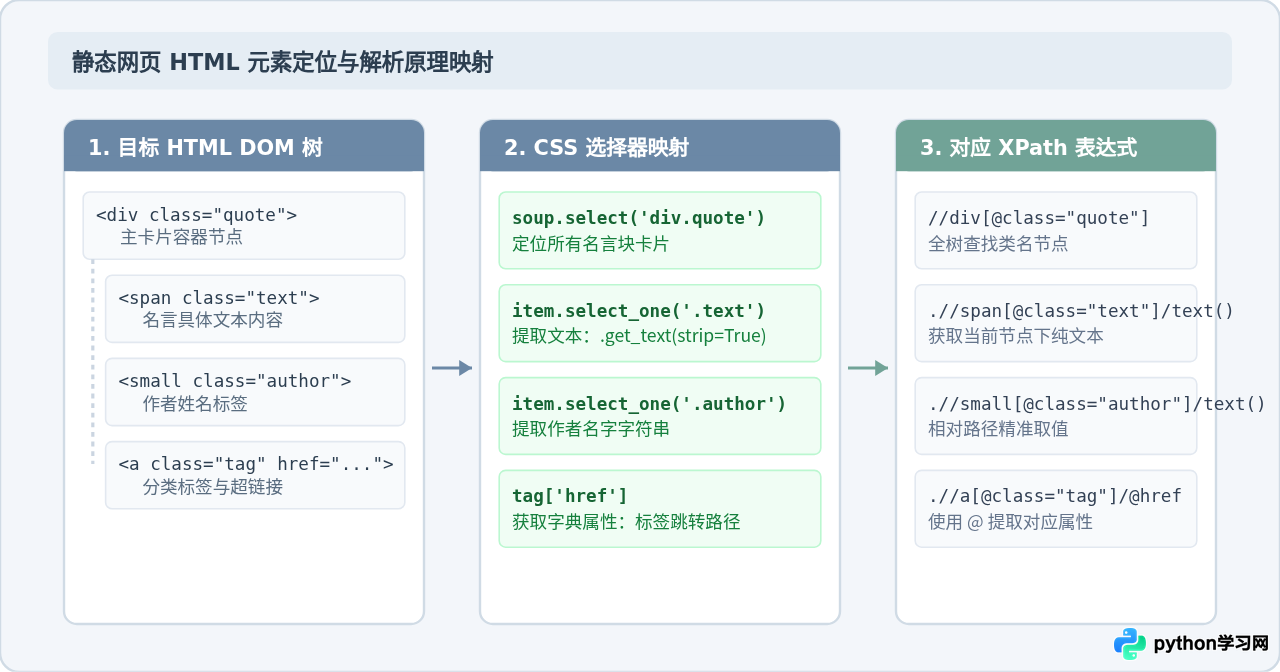
下面给出一段完整的 Python 脚本。代码以 http://quotes.toscrape.com 为抓取目标,演示如何自动翻页抓取全部名言,并将结果保存为规范的 CSV 文件。
环境依赖安装命令:
pip install requests beautifulsoup4完整抓取代码实现:
import csv
import time
from urllib.parse import urljoin
import requests
from bs4 import BeautifulSoup

def scrape_quotes_to_csv(output_filepath="quotes.csv", max_pages=5):
    """
    抓取 Quotes to Scrape 网站名言并导出为 CSV 文件。
    :param output_filepath: 导出的 CSV 文件路径
    :param max_pages: 最大抓取页数限制,保护目标服务器
    """
    base_url = "http://quotes.toscrape.com"
    current_url = base_url

    # 必须设置标准浏览器 User-Agent,这是爬虫开发的基础礼仪
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
    }

    quotes_data = []
    page_count = 0

    print(f"开始抓取任务,目标站点: {base_url}")

    while current_url and page_count < max_pages:
        page_count += 1
        print(f"正在爬取第 {page_count} 页: {current_url}")

        try:
            response = requests.get(current_url, headers=headers, timeout=10)
            response.raise_for_status()  # 若状态码非 200 则抛出异常
        except requests.RequestException as e:
            print(f"请求失败: {current_url},错误信息: {e}")
            break

        soup = BeautifulSoup(response.text, "html.parser")
        quote_elements = soup.select("div.quote")

        for q in quote_elements:
            # 提取名言文本
            text_el = q.select_one("span.text")
            text = text_el.get_text(strip=True) if text_el else ""

            # 提取作者
            author_el = q.select_one("small.author")
            author = author_el.get_text(strip=True) if author_el else ""

            # 提取多个标签,使用分号连接
            tag_elements = q.select("div.tags a.tag")
            tags = ";".join([tag.get_text(strip=True) for tag in tag_elements])

            quotes_data.append({
                "page": page_count,
                "quote": text,
                "author": author,
                "tags": tags
            })

        # 寻找下一页按钮
        next_button = soup.select_one("li.next a")
        if next_button and "href" in next_button.attrs:
            # 自动把相对路径拼接为完整绝对路径
            current_url = urljoin(base_url, next_button["href"])
            # 礼貌等待 1 秒,避免对练手站点造成请求风暴
            time.sleep(1.0)
        else:
            print("已到达末页,没有更多下一页按钮。")
            current_url = None

    # 将数据写入 CSV 文件(使用 utf-8-sig 编码保证 Excel 打开无乱码)
    fieldnames = ["page", "quote", "author", "tags"]
    with open(output_filepath, mode="w", encoding="utf-8-sig", newline="") as f:
        writer = csv.DictWriter(f, fieldnames=fieldnames)
        writer.writeheader()
        writer.writerows(quotes_data)

    print(f"抓取完成!共抓取 {len(quotes_data)} 条记录,已保存至 {output_filepath}")

if __name__ == "__main__":
    scrape_quotes_to_csv()
运行控制台示例输出(示例输出):
开始抓取任务,目标站点: http://quotes.toscrape.com
正在爬取第 1 页: http://quotes.toscrape.com
正在爬取第 2 页: http://quotes.toscrape.com/page/2/
正在爬取第 3 页: http://quotes.toscrape.com/page/3/
正在爬取第 4 页: http://quotes.toscrape.com/page/4/
正在爬取第 5 页: http://quotes.toscrape.com/page/5/
抓取完成!共抓取 50 条记录,已保存至 quotes.csv
五、新手练手常见问题排查与避坑指南
排查方法:这是初学者最容易遇到的问题。首先打印
response.text[:500],确认返回的内容是不是目标 HTML;其次检查浏览器开发者工具“Elements”面板里的节点是不是被 JavaScript 动态渲染后才生成的。如果审查元素里有、但查看网页源码中没有,说明目标内容为动态渲染,不适合使用基础静态爬虫直接抓取。
AttributeError: 'NoneType' object has no attribute 'get_text'?排查方法:这表明你的
select_one() 没有找到匹配的节点,返回了 None,随后调用 .get_text() 导致程序崩溃。在生产与实战中,务必对查询结果做判空防护,例如使用三元表达式:el.get_text(strip=True) if el else ""。
\xe4\xbd\xa0\xe5\xa5\xbd 等乱码?排查方法:
requests 库会依据 HTTP 响应头推测编码,但有时推测错误。在获取 response.text 之前,显式指定编码方式:response.encoding = response.apparent_encoding 或直接赋值 response.encoding = 'utf-8'。
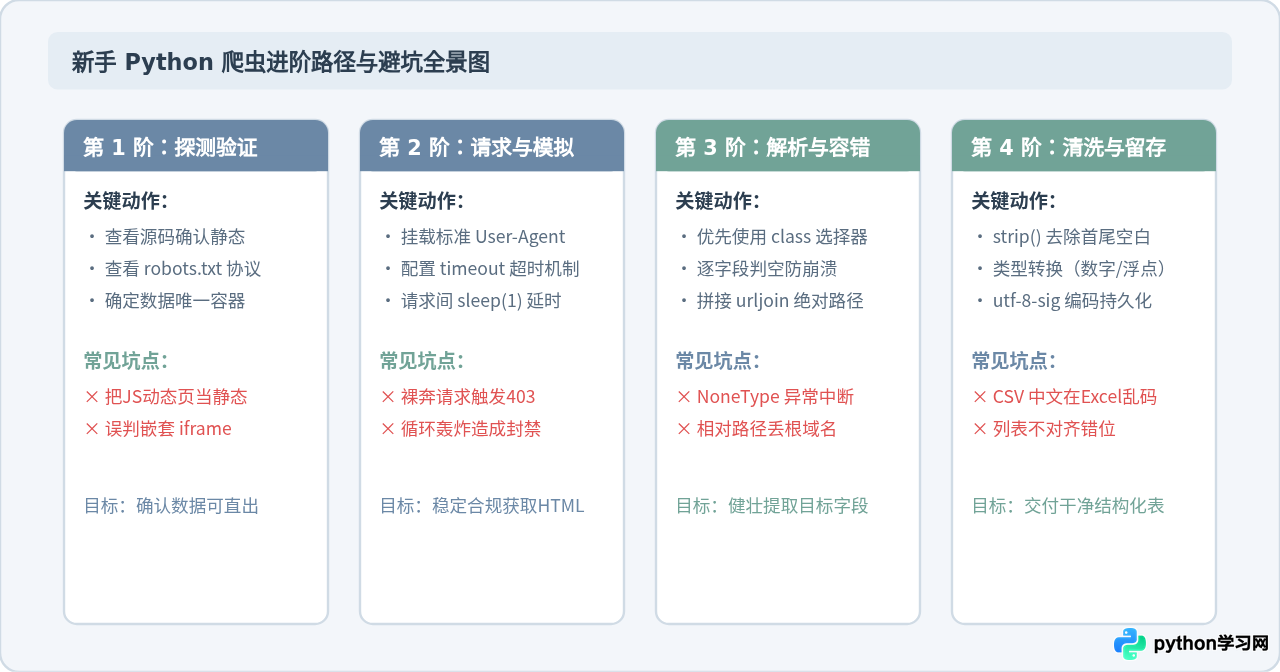
六、总结
掌握静态网站数据抓取是成为合格 Python 爬虫工程师的坚实第一步。通过在 Quotes to Scrape 和 Books to Scrape 等练习沙盒中反复演练,能够熟练打通“发送请求 -> 树形解析 -> 节点抽取 -> 分页迭代 -> 本地保存”的完整链路。在此基础之上,未来进一步探索动态接口逆向与自动化测试框架时,便能做到概念清晰、游刃有余。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









