

Python微服务全链路监控:集成Prometheus与Grafana实战指南
本文详细介绍如何在Python微服务架构中集成Prometheus与Grafana,涵盖指标埋点、多进程模式适配、Prometheus配置抓取、Grafana大盘搭建及生产避坑指南。
prometheus_client 库采集运行指标,配合 Prometheus 定期抓取时序数据,最终在 Grafana 中构建契合 RED(请求量、错误率、响应耗时)原则的实时看板,并给出多进程部署环境下的关键适配方案。
一、架构设计与指标数据流转机制
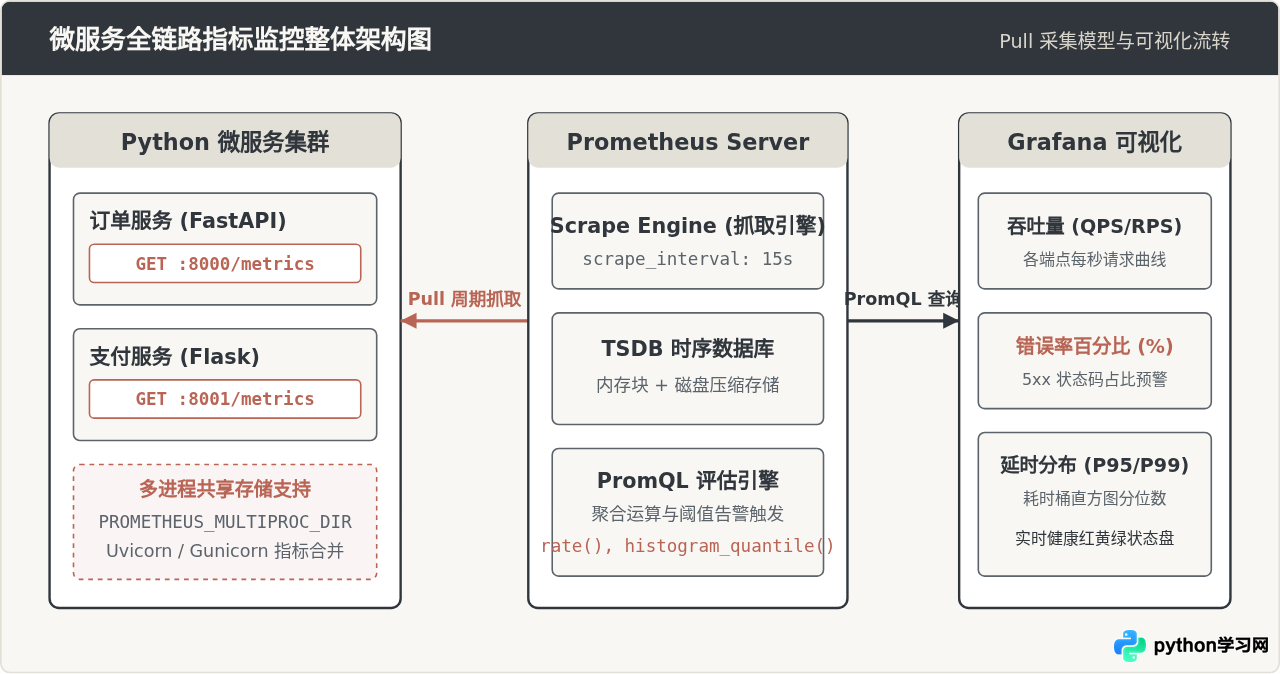
构建微服务监控体系,首要任务是明确指标数据从产生到展现的流动闭环。不同于传统的集中式日志推送模式,Prometheus 采用 Pull(拉取)模型。每个 Python 微服务实例作为一个 Exporter 节点,通过 HTTP 协议暴露标准的 /metrics 端点。
Prometheus Server 根据配置文件中定义的作业计划,定期向各微服务实例发起 HTTP GET 请求抓取文本格式的监控指标,并写入本地 TSDB(时间序列数据库)。Grafana 则作为可视化展现层,通过 PromQL 语言向 Prometheus 查询指定时间窗口内的聚合数据,实时渲染为吞吐量趋势折线图、错误率仪表盘与时延分位数热力图。
二、Python 微服务埋点实战(FastAPI 示例)
在微服务中落地可观测性,最通用的度量模型是 Tom Wilkie 提出的 RED 方法论:
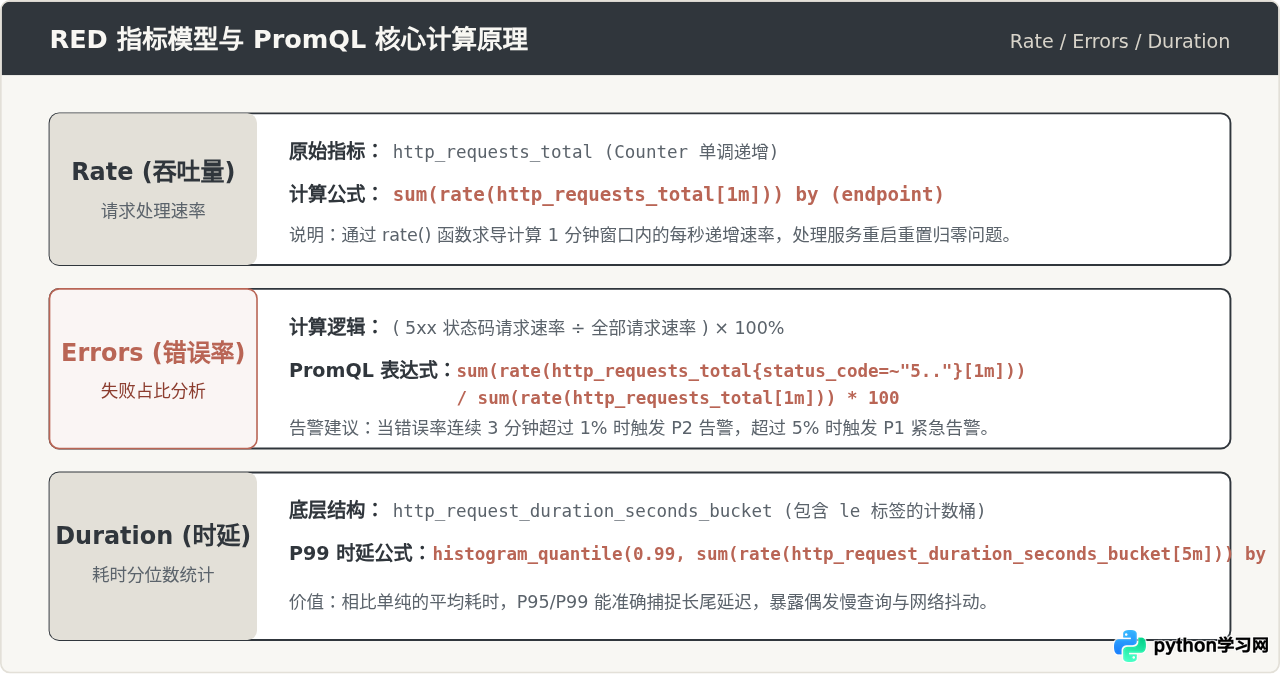
- Rate(请求速率):服务每秒处理的请求数量。
- Errors(错误速率):每秒失败的请求数量(如 HTTP 5xx 或未捕获异常)。
- Duration(响应耗时):请求处理所花费的时延分布,重点关注 P90、P95、P99 分位数。
在 Python 中,推荐使用官方维护的 prometheus_client 库。下面以生产常用的 FastAPI 为例,编写一个统一中间件,自动捕获请求路径、方法、HTTP 状态码及响应耗时:
import time
from fastapi import FastAPI, Request, Response
from prometheus_client import (
    Counter,
    Histogram,
    Gauge,
    generate_latest,
    CONTENT_TYPE_LATEST,
    REGISTRY
)

app = FastAPI(title="OrderService")

# 1. 计数器:统计 HTTP 请求总数(满足 Rate 与 Errors 计算)
HTTP_REQUESTS_TOTAL = Counter(
    "http_requests_total",
    "Total HTTP Requests",
    ["method", "endpoint", "status_code"]
)

# 2. 直方图:统计请求耗时分布(满足 Duration 计算,推荐自定义符合微服务 SLA 的桶区间)
HTTP_REQUEST_DURATION_SECONDS = Histogram(
    "http_request_duration_seconds",
    "HTTP Request Latency in seconds",
    ["method", "endpoint"],
    buckets=[0.01, 0.05, 0.1, 0.25, 0.5, 1.0, 2.5, 5.0]
)

# 3. 仪表盘:统计当前正在执行中的请求并发量
HTTP_REQUESTS_IN_PROGRESS = Gauge(
    "http_requests_in_progress",
    "Current active HTTP requests in processing",
    ["method", "endpoint"]
)

@app.middleware("http")
async def prometheus_middleware(request: Request, call_next):
    endpoint = request.url.path
    # 忽略监控端点本身,避免自身抓取干扰业务数据
    if endpoint == "/metrics":
        return await call_next(request)

    method = request.method
    HTTP_REQUESTS_IN_PROGRESS.labels(method=method, endpoint=endpoint).inc()
    start_time = time.time()

    status_code = 500
    try:
        response: Response = await call_next(request)
        status_code = response.status_code
        return response
    except Exception:
        raise
    finally:
        latency = time.time() - start_time
        HTTP_REQUEST_DURATION_SECONDS.labels(method=method, endpoint=endpoint).observe(latency)
        HTTP_REQUESTS_TOTAL.labels(method=method, endpoint=endpoint, status_code=str(status_code)).inc()
        HTTP_REQUESTS_IN_PROGRESS.labels(method=method, endpoint=endpoint).dec()

@app.get("/metrics")
def metrics():
    """暴露给 Prometheus 抓取的端点"""
    return Response(content=generate_latest(REGISTRY), media_type=CONTENT_TYPE_LATEST)

@app.get("/api/v1/orders")
async def list_orders():
    # 模拟业务处理
    return {"status": "success", "orders": [{"id": 1001, "item": "Keyboard"}]}
解决方案:必须在启动服务前配置环境变量
PROMETHEUS_MULTIPROC_DIR 指向一个干净的临时共享目录(如 /tmp/prometheus_multiproc),并在代码中使用 prometheus_client.multiprocess.MultiProcessCollector 初始化 CollectorRegistry。
三、全链路集成实施四步流
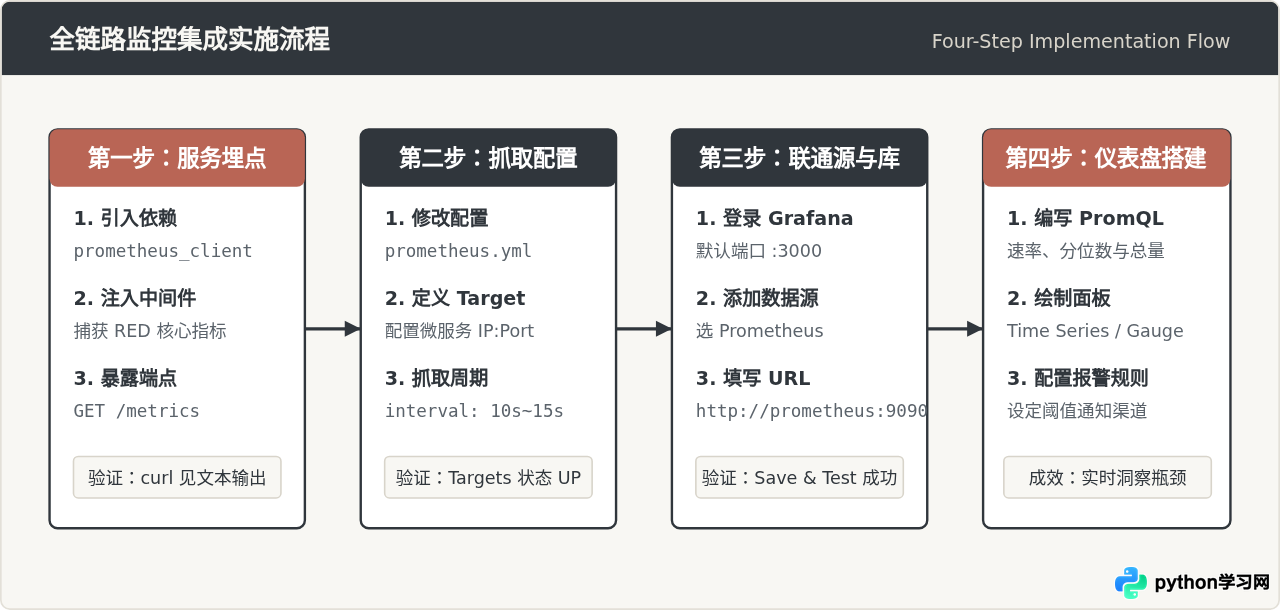
将上述 Python 埋点接入整个可观测体系,需要严格遵循“微服务埋点 -> Prometheus 任务发现 -> Grafana 数据源联通 -> 指标与看板呈现”的标准步骤。
四、环境编排与 Prometheus 采集配置
为了保证部署环境一致性,通常使用 Docker Compose 对 Prometheus 与 Grafana 进行轻量化编排管理。
1. prometheus.yml 核心配置文件
在配置文件中明确定义抓取任务(scrape_job)与服务实例的通信地址:
global:
  scrape_interval: 15s      # 全局抓取频率
  evaluation_interval: 15s  # 告警规则评估周期

scrape_configs:
  - job_name: "prometheus"
    static_configs:
      - targets: ["localhost:9090"]

  - job_name: "python_microservices"
    metrics_path: "/metrics"
    scheme: "http"
    static_configs:
      - targets: ["order_service:8000", "payment_service:8001"]
        labels:
          environment: "production"
          cluster: "core-zone"
2. docker-compose.yml 部署清单
version: "3.8"

services:
  prometheus:
    image: prom/prometheus:v2.48.0
    container_name: prometheus
    restart: always
    volumes:
      - ./prometheus.yml:/etc/prometheus/prometheus.yml:ro
      - prometheus_data:/prometheus
    ports:
      - "9090:9090"
    command:
      - "--config.file=/etc/prometheus/prometheus.yml"
      - "--storage.tsdb.path=/prometheus"
      - "--storage.tsdb.retention.time=15d"

  grafana:
    image: grafana/grafana:10.2.2
    container_name: grafana
    restart: always
    ports:
      - "3000:3000"
    volumes:
      - grafana_data:/var/lib/grafana
    environment:
      - GF_SECURITY_ADMIN_PASSWORD=admin
    depends_on:
      - prometheus

volumes:
  prometheus_data:
  grafana_data:
执行 docker-compose up -d 启动容器后,访问 http://<宿主机IP>:9090/targets,若 python_microservices 任务状态呈现绿色 UP,即代表指标收集通路完全建立。
五、Grafana 仪表盘与核心 PromQL 表达式解析
数据进入 Prometheus 之后,必须转换为运维与研发能够直接决策的可视化面板。PromQL 提供了强大的时序聚合运算能力。
常用指标查询速查表
| 监控维度 | PromQL 查询语句 | Grafana 推荐面板类型 |
|---|---|---|
| 服务总体吞吐量 (QPS) | sum(rate(http_requests_total[1m])) |
Time Series(折线图) |
| 各端点请求分布 | topk(5, sum(rate(http_requests_total[5m])) by (endpoint)) |
Bar Chart 或 Pie Chart |
| 当前活跃连接数 | sum(http_requests_in_progress) |
Stat(大数字卡片)/ Gauge |
| P95 响应耗时(秒) | histogram_quantile(0.95, sum(rate(http_request_duration_seconds_bucket[5m])) by (le)) |
Time Series / Heatmap |
| 节点 CPU 使用率 | 100 - (avg by (instance) (rate(node_cpu_seconds_total{mode="idle"}[1m])) * 100) |
Gauge(仪表盘) |
六、生产环境常见问题与避坑决策
在实际生产部署中,如果不注重设计细节,监控系统本身可能会成为微服务的性能负担甚至导致 OOM。以下是排查与规避典型问题的决策指引:
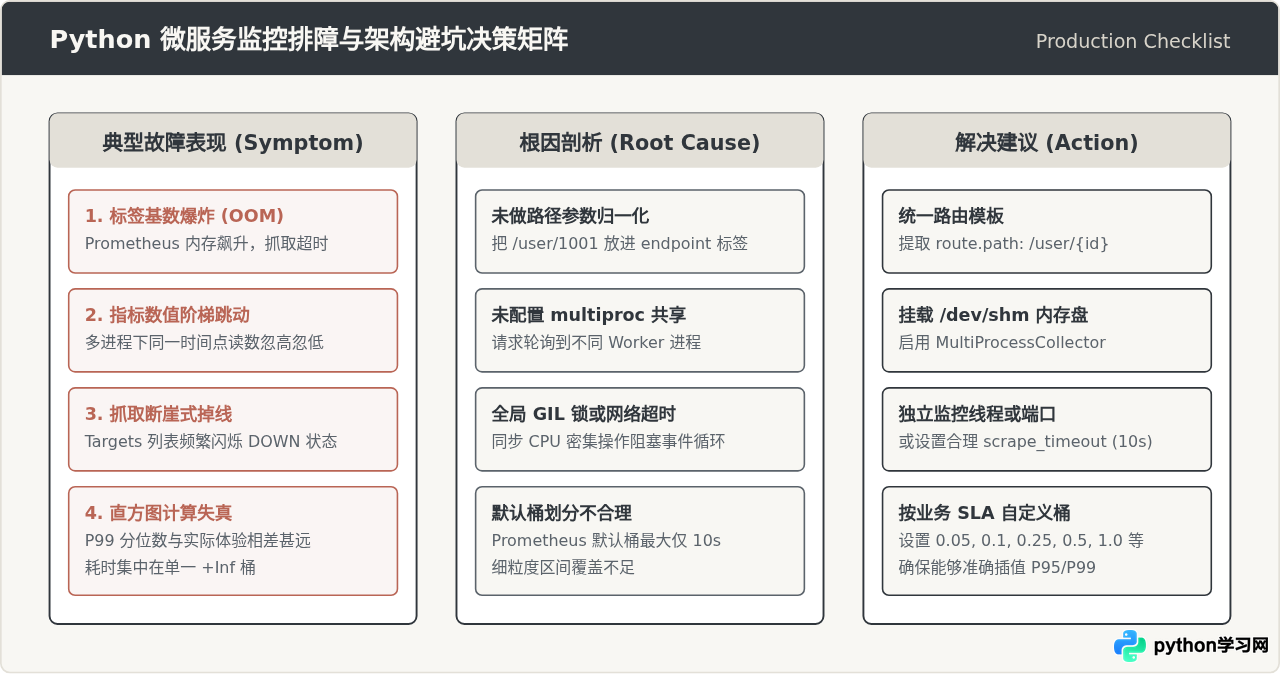
核心排坑细则:
-
杜绝高基数(High Cardinality)标签:
Prometheus 时序数据的内存消耗直接与“指标名 + 标签键值对组合数量”挂钩。切勿在标签中放入诸如
user_id、order_no、带有查询参数的完整 URL 等无限动态值。端点名称务必归一化为路由模板(例如/api/orders/{id})。 -
抓取超时与业务线程隔离:
若 Python 微服务存在重度阻塞操作(例如同步 I/O 或密集计算),FastAPI 默认事件循环可能无法及时响应 Prometheus 的拉取请求,导致报出
context deadline exceeded。建议将耗时任务放入后台线程池(Celery 或asyncio.to_thread),保证/metrics端点轻量瞬时响应。 - 合理设置保留时间与抓取间隔: 在微服务数量较多(数百个 Pod)时,15 秒通常是成本与精度的最优平衡点。将 TSDB 数据保留时间按需设置为 15d 到 30d,超出部分可考虑对接 Thanos 或 VictoriaMetrics 实施低成本冷热分层归档。
七、总结
本文系统性梳理了 Python 微服务在 Prometheus 与 Grafana 体系下的全链路度量方案。从底层指标定义(Counter、Histogram、Gauge)与基于 FastAPI 的 RED 中间件封装,到 Prometheus 抓取配置与 Docker Compose 部署落地,再到 Grafana 核心 PromQL 计算与多进程避坑实践,构建了一个清晰可复制的微服务监控闭环。通过遵循低基数标签原则与多进程共享内存方案,开发者能够以极低的服务开销,换取毫秒级的线上隐患洞察与故障定位能力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









