

Python IndexError:list index out of range报错原因与修复
深入解析 Python 中常见的 IndexError: list index out of range 报错原因,涵盖正负索引机制、常见触发场景、排查流程与安全取值防御策略,助你彻底避免索引越界异常。
在 Python 开发中,IndexError: list index out of range(列表索引超出范围)是最常见且排查最直观的异常之一。它的核心含义非常直接:程序试图使用一个不存在的下标位置去访问列表元素。本文将系统拆解该报错背后的索引工作机制、四大典型诱发场景、标准排查步骤以及防御性编码策略,帮助你在编写代码时有效规避越界风险。
一、为什么会发生 IndexError?理解 Python 列表索引机制
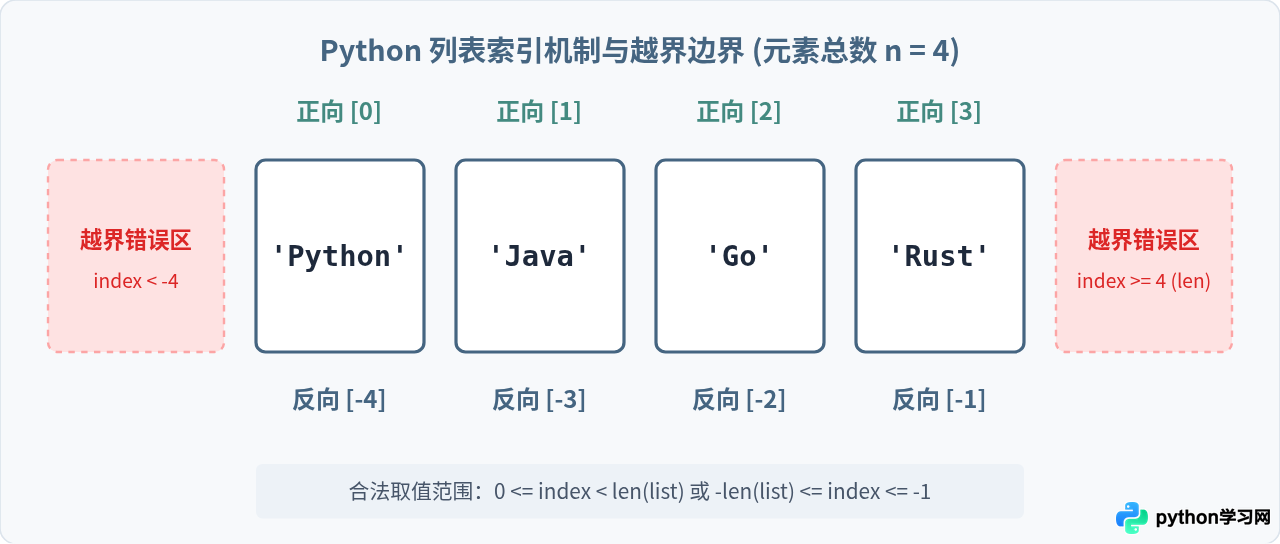
Python 列表(list)是一个有序且基于连续整型下标定位的序列结构。若列表包含 n 个元素,其有效访问范围受到严格约束:
- 正向索引(从前向后):有效范围为
0到n - 1。第一个元素位于下标0,最后一个位于n - 1。试图读取n或更大值即发生越界。 - 负向索引(从后向前):有效范围为
-1到-n。最后一个元素位于下标-1,首个元素位于-n。试图读取-(n + 1)或更小值亦发生越界。 - 空列表(
n = 0):长度为 0,无论使用任何下标(包括[0]或[-1])都会直接触发IndexError。
二、四大高频错误场景与代码剖析
虽然越界的本质都是索引超限,但在具体业务逻辑中,触发该异常的场景通常有迹可循:
1. 差一错误(Off-by-one):误将长度当作末尾下标
初学者容易直觉认为长度为 3 的列表最大下标是 3,从而直接调用 list[len(list)]。由于索引从 0 开始,长度为 len 的列表其末位元素下标永远是 len - 1。
# 错误示例
fruits = ["apple", "banana", "orange"]
print(fruits[len(fruits)])  # 抛出 IndexError: list index out of range,因为最大索引是 2

# 修复方式:使用 len - 1 或负索引 -1
print(fruits[len(fruits) - 1])  # 正确: orange
print(fruits[-1])               # 更优雅的 Pythonic 方式: orange
2. 空列表未判断直接取值或赋值
在数据处理中,查询函数可能返回一个空列表 []。如果未对返回结果做非空校验就尝试提取第一个元素 data[0],或者试图通过 data[0] = value 给空列表扩容,都会立即抛出异常。
# 错误示例
results = []
first_item = results[0]  # 抛出 IndexError

# 错误示例:试图通过下标给空列表插入元素
results[0] = "first"    # 抛出 IndexError!Python 列表不能通过越界下标直接赋值扩展

# 修复方式:使用 append 追加,或读取前先判断
results.append("first")
if results:
    first_item = results[0]
3. 循环遍历时动态修改或删除元素
在基于下标的 for i in range(len(lst)): 循环中,若内部调用了 lst.pop(i) 或 del lst[i],列表的实际长度变短了,但原先根据初始长度生成的 range 序列仍会继续走到较大的数字,导致后续访问越界。
# 错误示例
nums = [10, 20, 30, 40]
for i in range(len(nums)):
    if nums[i] == 20:
        nums.pop(i)  # 列表长度缩小为 3,当循环走到 i=3 时抛出 IndexError
4. 字符串分割或解构赋值长度不足
使用 split() 分割文本提取特定列时,若某行数据缺失分隔符或格式不符合预期,生成的列表项数可能低于预期。
# 错误示例
line = "User123"  # 缺少逗号分隔的内容
parts = line.split(",")
user_id = parts[0]
user_role = parts[1]  # 抛出 IndexError: list index out of range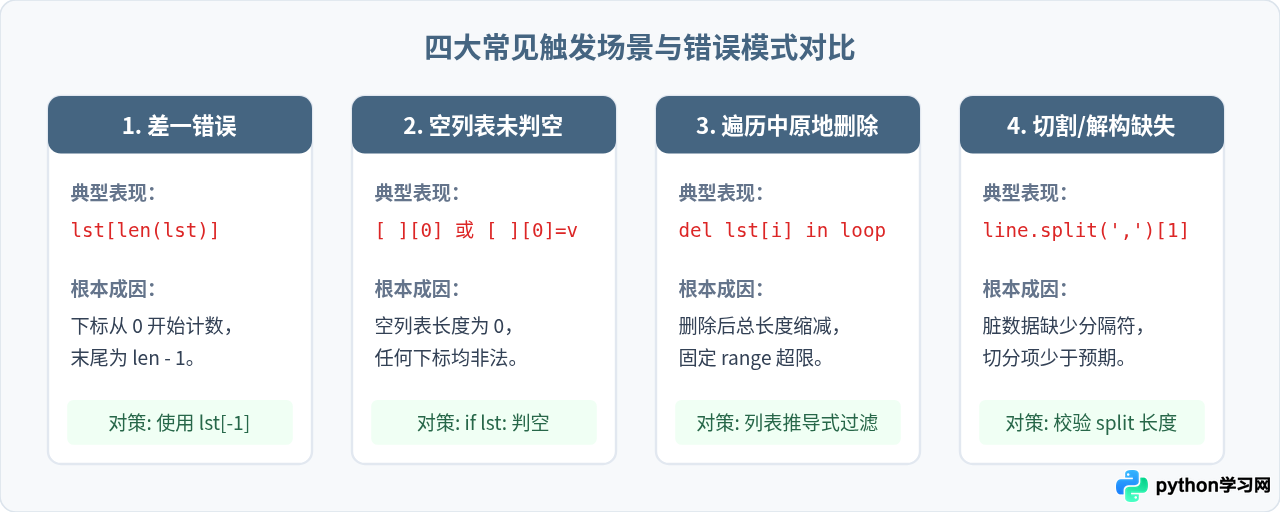
三、系统排查四步法:如何准确定位错误源头
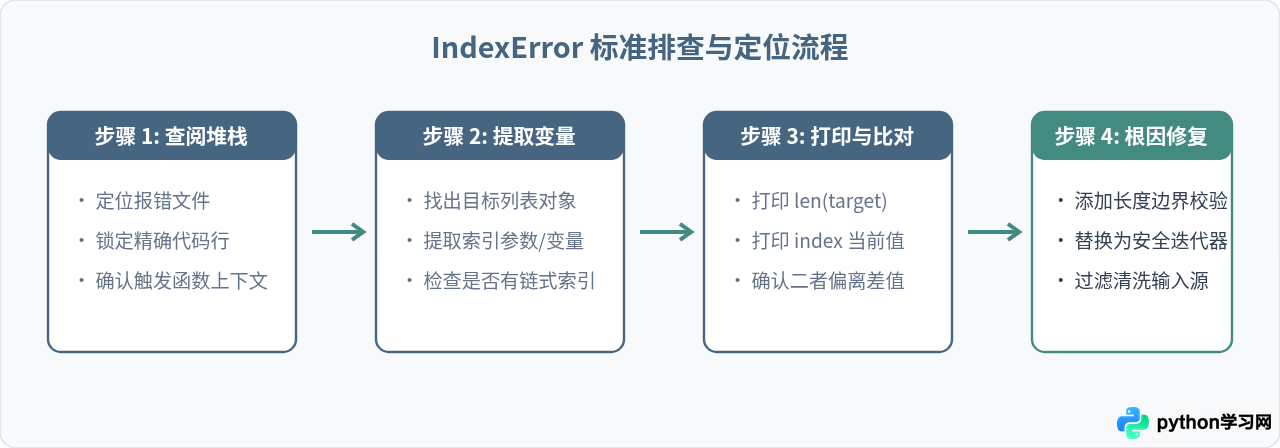
当终端或日志抛出 IndexError 时,不要盲目猜测,建议遵循以下四个标准排查步骤:
- 精确定位代码行:查看 Traceback(堆栈回溯)的最底部一行,获取触发异常的文件路径与具体行号。
- 识别操作对象与索引值:在该行代码中找出发生
[]索引操作的变量名,以及被传入的下标计算表达式。 - 核实运行时实际长度与索引:在报错行上方加入日志或利用断点检查
len(target_list)与实际传入的index。 - 追溯数据生产路径:若列表长度为 0 或低于预期,顺着数据流向上游排查:是否是文件读入了空行?接口返回了空数组?还是正则匹配失败?
四、工程修复与防御性编程实践
彻底解决索引越界不仅需要修正眼前报错的代码,更需要在编程习惯上采取更加健壮的实现模式:
1. 优先使用元素直接迭代或 enumerate()
除非确实需要根据特定步长或逆序操作底层索引,否则在 Python 中应尽可能直接对列表进行迭代,无需计算和维护 i 变量:
items = ["A", "B", "C"]

# 不推荐:手动维护下标容易越界
for i in range(len(items)):
    print(items[i])

# 推荐:直接按元素迭代,零越界可能
for item in items:
    print(item)

# 推荐:如果同时需要索引序号,使用 enumerate()
for i, item in enumerate(items):
    print(f"Index {i}: {item}")
2. 使用前进行显式范围检查
在根据动态外部输入(如用户参数、配置文件字段)提取特定下标时,务必先进行边界检查:
def get_item_safely(lst, target_index):
    # 支持正负索引的安全检查
    if -len(lst) <= target_index < len(lst):
        return lst[target_index]
    return None  # 或返回设定的默认值
3. 利用切片(Slicing)天然防越界的特性
Python 的切片语法 lst[start:end] 对越界行为极其宽容:当下标超出实际长度时,切片不会抛出 IndexError,而是优雅地返回空列表或截断后的实际可用子序列。
data = ["apple", "banana"]

# 直接索引会报错
# item = data[5]  # 抛出 IndexError

# 切片则天然安全
sub_items = data[5:6]  # 返回 [],不报错
first_element = data[:1]  # 返回 ['apple'],即使 data 为空也返回 []
4. 捕获异常(try-except IndexError)作为兜底防护
对于外部不可控数据或偶发性越界,可以使用异常捕获机制兜底。但注意不要滥用 try-except 掩盖原本可以提前预测并避免的逻辑错误:
try:
    target_value = api_response_list[0]
except IndexError:
    target_value = "default_value"
    # 记录警告日志供追踪分析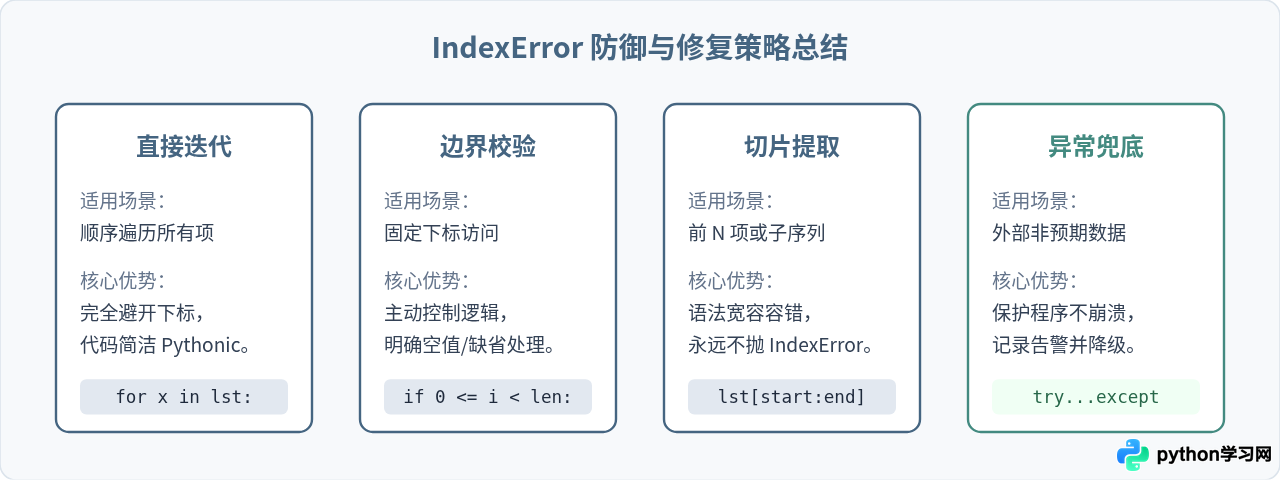
五、总结与速查清单
解决 IndexError: list index out of range 并不复杂,关键在于树立对列表边界的敏感度:
| 排查要点 | 危险写法 | 安全写法 |
|---|---|---|
| 末位元素获取 | lst[len(lst)] |
lst[-1](确保 len(lst) > 0) |
| 全量元素遍历 | for i in range(len(lst)): ... lst[i] |
for item in lst: 或 enumerate(lst) |
| 动态条件剔除 | del lst[i](在正向索引循环中) |
[x for x in lst if keep(x)](列表推导式) |
| 未知长度切分 | line.split(",")[2] |
parts = line.split(","); val = parts[2] if len(parts) > 2 else "" |
| 获取子区间 | 遍历下标手动组装 | lst[:k](利用切片天然容错特性) |
[] 下标取值之前,始终先向自己提问:“这个列表在极端情况下是否可能为空?传入的下标是否必定小于它的当前长度?”养成良好的边界防御习惯,即可从根本上告别 IndexError。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









