

Python for循环怎么使用enumerate获取索引
详细介绍在Python中如何使用内置函数enumerate在for循环中优雅且高效地获取元素索引,包含基本语法、自定义起始索引、解包技巧、原理解析以及与range(len())的对比。
在 Python 中遍历列表、元组等可迭代对象时,如果既需要访问元素本身,又需要知道当前元素所处的位置序号(索引),最标准且高效的做法是使用内置函数 enumerate()。它能够在无需手动维护额外计数器变量的前提下,在循环过程中自动将序列中的每一项包装为 (索引, 元素) 形式的元组,配合解包语法即可直接在循环头中赋值给两个变量。本文将完整介绍 enumerate() 的使用步骤、自定义起始计数值、运行机制、与传统写法的对比以及注意事项。
一、使用 enumerate 获取索引的标准步骤
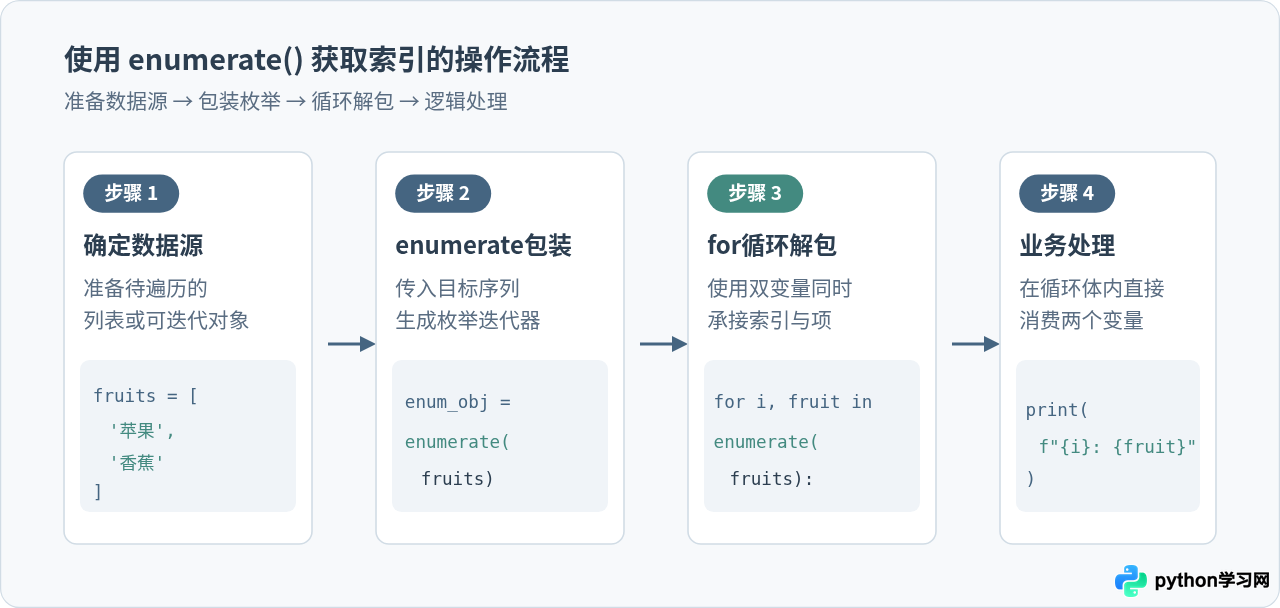
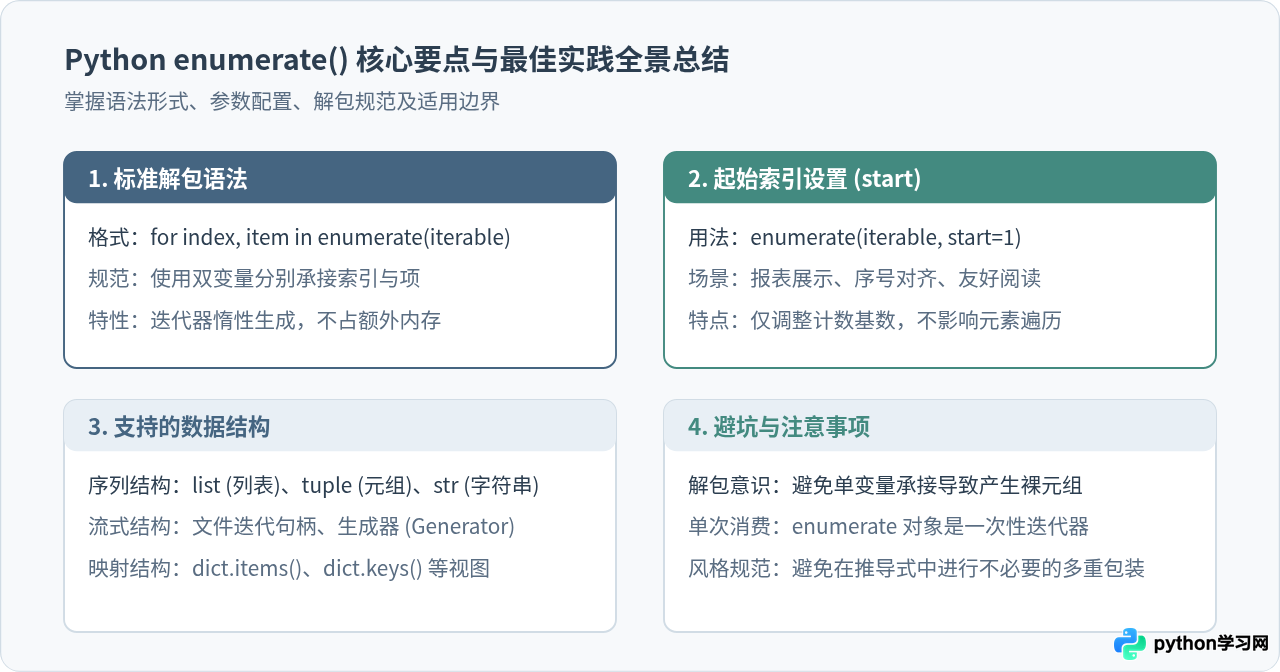
在编写 for 循环时,直接将待遍历的数据集合传入 enumerate() 函数中。随后在 for 关键字后同时定义两个变量,分别用于接收当前的整数索引与对应的元素值。
fruits = ['苹果', '香蕉', '橙子', '葡萄']

for index, fruit in enumerate(fruits):
    print(f"索引: {index}, 水果: {fruit}")
示例输出:
索引: 0, 水果: 苹果
索引: 1, 水果: 香蕉
索引: 2, 水果: 橙子
索引: 3, 水果: 葡萄上述代码的执行逻辑非常直观:每次循环迭代时,enumerate(fruits) 都会产生一个包含当前计数与元素的元组,Python 的元组解包机制自动将第 0 项赋值给 index,第 1 项赋值给 fruit。无需在循环体之前声明 i = 0 并在循环末尾执行 i += 1。
二、自定义起始索引:设置 start 参数
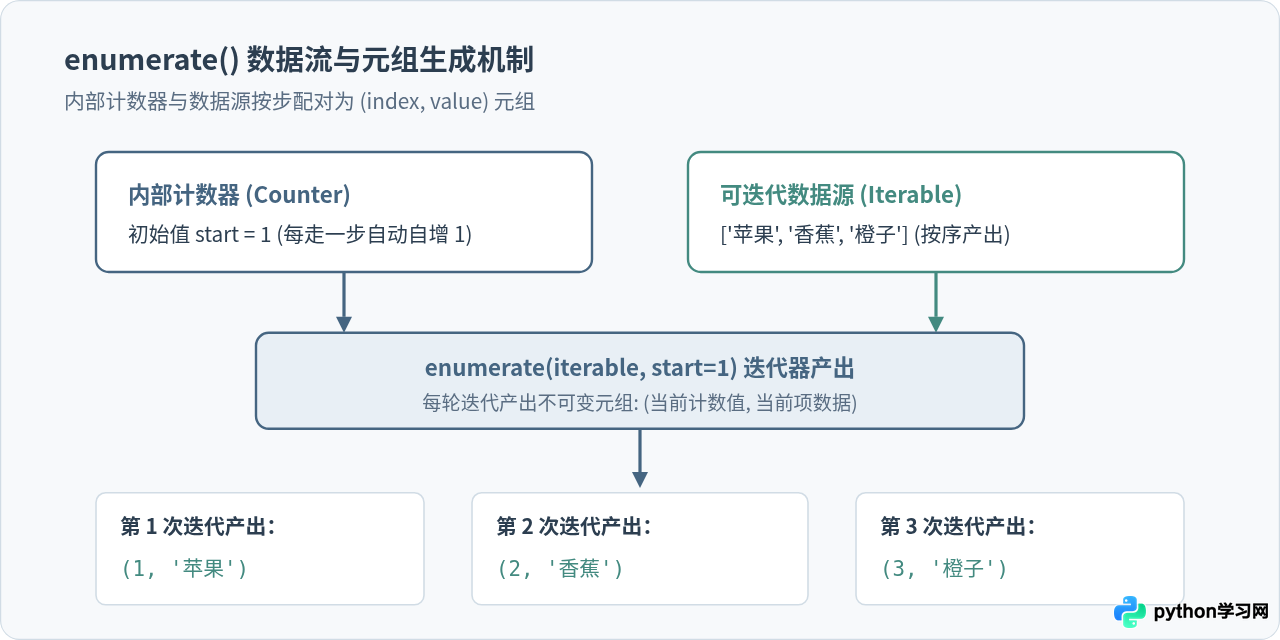
在计算机内部,数组或列表通常从 0 开始计数,但在面向用户的界面、打印序号或排版清单时,人们更习惯于从 1 开始编号。enumerate() 提供了一个可选参数 start,用于指定计数的初始数值。
tasks = ['需求梳理', '系统设计', '编码实现', '测试部署']

# 将 start 参数设为 1
for step, task in enumerate(tasks, start=1):
    print(f"步骤 {step}: {task}")
示例输出:
步骤 1: 需求梳理
步骤 2: 系统设计
步骤 3: 编码实现
步骤 4: 测试部署start 参数只改变返回的序号数值,绝不会跳过列表中的任何元素,也不会影响原列表的内部结构或切片位置。如果需要负数或特定偏移(例如从 100 开始),也可以直接传入对应的整数。
三、为什么推荐 enumerate 而不是 range(len())
很多刚从 C/C++ 或 Java 转到 Python 的开发者,习惯通过下标循环遍历:
# 不推荐的传统方式
fruits = ['苹果', '香蕉', '橙子']
for i in range(len(fruits)):
    item = fruits[i]
    print(i, item)
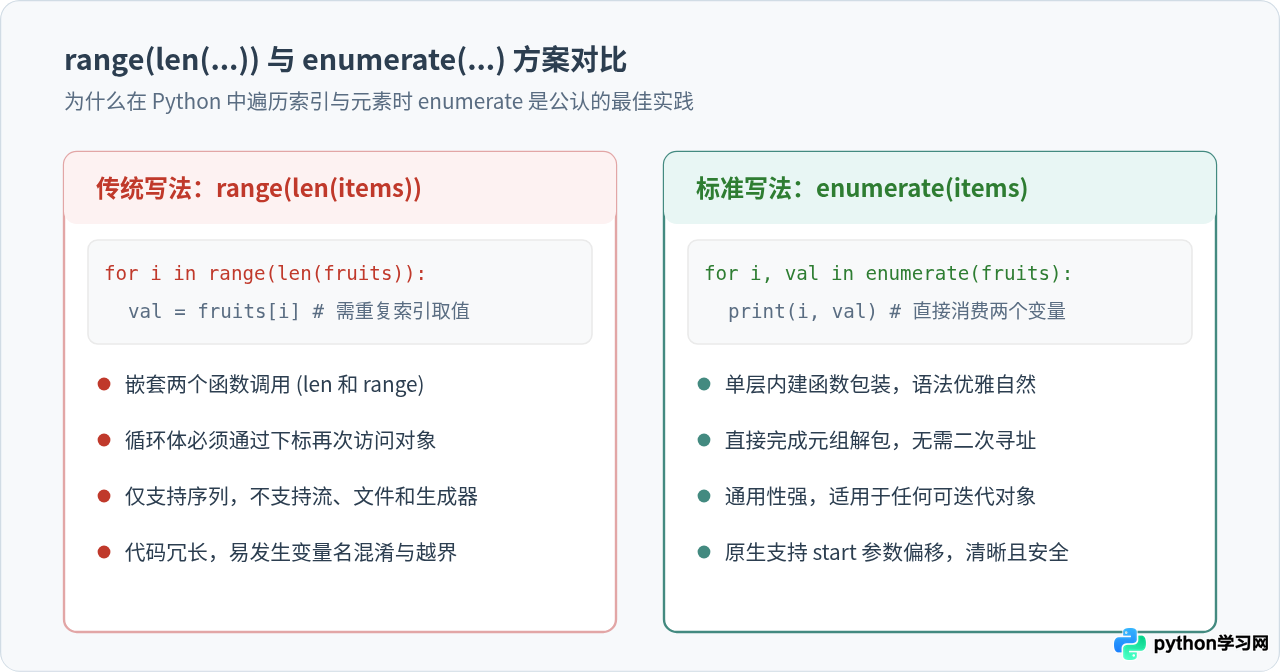
这种写法在 Python 中被视为“反模式”,原因在于:
- 繁琐且易读性差:
range(len(...))嵌套了两个内建函数,且在循环体内部还必须通过fruits[i]再次索引取值。 - 容易越界与变量污染:当循环体内有复杂条件或切片操作时,手写的下标变量容易在修改时发生名称混乱或索引越界。
- 通用性差:
range(len(...))严格要求对象必须支持len()以及下标随机访问(例如列表或元组)。如果对象是一个文件迭代器、数据库游标或生成器函数,则根本无法使用len();而enumerate()支持任何可迭代对象。
四、常见应用场景与进阶技巧
1. 在列表推导式中直接生成字典映射
利用 enumerate() 可以极速将列表转换为“元素到索引”或“索引到元素”的字典映射:
names = ['Alice', 'Bob', 'Charlie']
name_to_index = {name: idx for idx, name in enumerate(names)}
# 结果: {'Alice': 0, 'Bob': 1, 'Charlie': 2}
2. 嵌套循环定位矩阵坐标
在处理二维列表或矩阵数据时,外层与内层分别使用 enumerate(),可以直接获取当前单元格的行号 r 与列号 c:
matrix = [
    [10, 20, 30],
    [40, 50, 60]
]

for row_idx, row in enumerate(matrix):
    for col_idx, val in enumerate(row):
        print(f"坐标 ({row_idx}, {col_idx}) = {val}")
五、容易混淆的注意事项与避坑指南
- 忘记解包只声明一个变量:如果写成
for item in enumerate(fruits):,循环变量item接收到的是元组实体(如(0, '苹果')),此时必须写成item[0]和item[1]才能访问,失去了双变量解包的清晰性。 - 误解 start 参数的作用:
start=1只是让索引序号从 1 递增,它绝不会切掉列表的第 0 项。列表依旧是从头到尾完整遍历的。 - enumerate 对象是一次性迭代器:
enumerate()返回的是一个生成器式的迭代器对象。一旦被遍历完毕或使用list()消费后,再次对该对象执行遍历将不会输出任何内容。
结语
在 Python 的代码哲学中,简洁与直观始终处于首要位置。对于需要索引的遍历场景,enumerate() 不仅消除了额外维护计数器的冗余代码,还避开了传统 range(len()) 的多层嵌套与下标二次寻址开销。熟练使用 enumerate() 与 start 参数,是编写符合 Pythonic 风格代码的基础习惯。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









