

Python处理大规模稀疏矩阵:SciPy sparse模块使用指南
全面讲解在Python中如何使用SciPy sparse模块处理海量稀疏矩阵,深入剖析COO、CSR、CSC等存储格式底层原理、构建方法、代数运算与工程实战避坑指南。
在图神经网络、自然语言处理、推荐系统及有限元分析等场景中,数据构成的二维矩阵往往规模庞大,且其中 99% 以上的元素均为零。若直接使用 NumPy 稠密数组(Dense Array)存储,计算机内存将瞬间耗尽。Python 科学计算生态中的 scipy.sparse 模块,通过仅记录非零元素的数值与对应坐标位置,将存储与计算复杂度降低了数个数量级。本文将系统梳理 scipy.sparse 模块的底层格式机制、选型差异、构造方式与计算优化,提供一份能够在实际工程中直接复用的操作指南。
一、稀疏矩阵的存储本质与内存收益
理解稀疏矩阵的价值,最直观的方式是观察内存占用的量级差异。假设需要处理一个维度为 100,000 × 100,000 的浮点数矩阵。若使用标准的 NumPy 稠密数组,每个双精度浮点数占用 8 字节,整体内存消耗为:
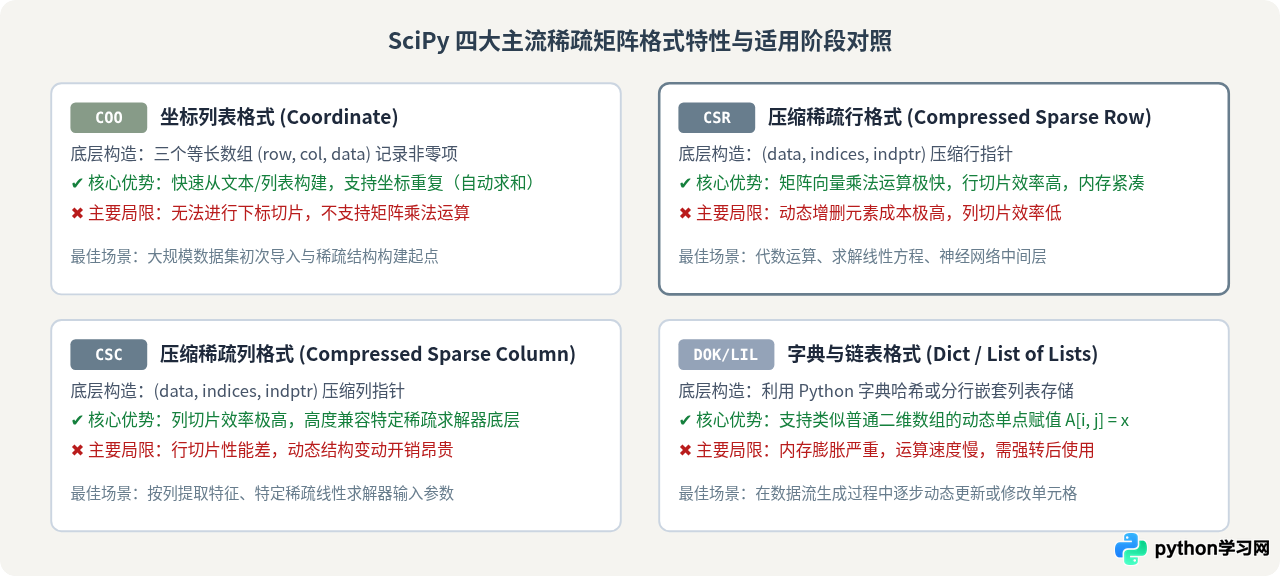
100,000 × 100,000 × 8 字节 ≈ 80,000,000,000 字节 ≈ 74.5 GB对于大部分常规计算设备而言,74.5 GB 的内存分配会导致程序崩溃或严重的虚拟内存交换。然而,若该矩阵的稀疏度为 99.99%(即非零元素仅有 1,000,000 个),稀疏存储只需记录这 100 万个非零数值及其行列位置,总内存占用通常不足 20 MB。这种存储效率的飞跃,来源于稀疏矩阵摒弃了对“零元素”的显式记录。
二、SciPy 支持的常见稀疏格式与选型考量
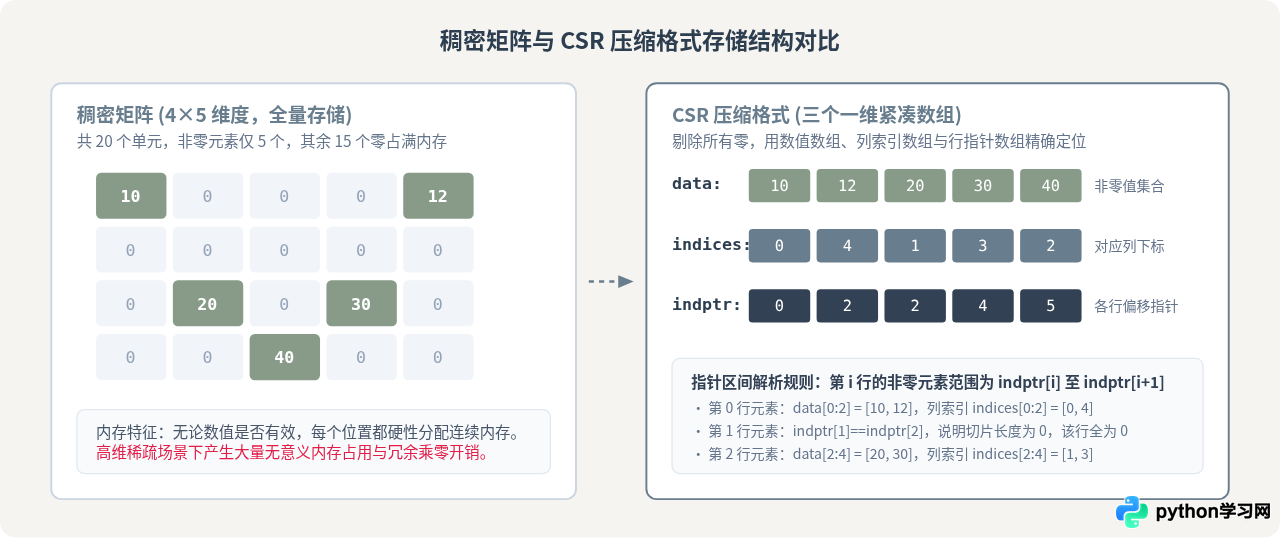
在 scipy.sparse 模块中,并没有单一的“通用最优”数据结构。根据底层内存排列方式与索引机制的不同,SciPy 提供了 7 种稀疏矩阵格式。实际工程中最常用的是以下四种:
- COO (Coordinate format):坐标格式。内部维护三个形状相同的一维数组
(data, row, col)。它的实现最为直观,追加新元素速度快,且支持在相同坐标处存在重复值(转换时会自动累加求和)。但它不支持任何切片操作与算术计算。 - CSR (Compressed Sparse Row):压缩稀疏行格式。采用
(data, indices, indptr)存储。由于同一行内的元素在内存中紧凑连续分布,行切片操作极其高效,且高度适配矩阵向量乘法(SpMV)与线性求解器。缺点是修改矩阵结构(增删非零元)需要大规模重排数组。 - CSC (Compressed Sparse Column):压缩稀疏列格式。结构与 CSR 完全对称,只是指针数组按列压缩。列切片操作与按列提取特征极快,很多底层 Fortran/C 求解器(如 SuperLU)强制要求输入 CSC 格式。
- DOK (Dictionary of Keys) / LIL (List of Lists):字典格式与链表格式。DOK 使用 Python 字典
{(i, j): val}映射非零元,LIL 使用两个嵌套 Python 列表按行记录列坐标和值。它们适合在构建阶段逐点动态修改元素,但内存开销大、计算性能差。
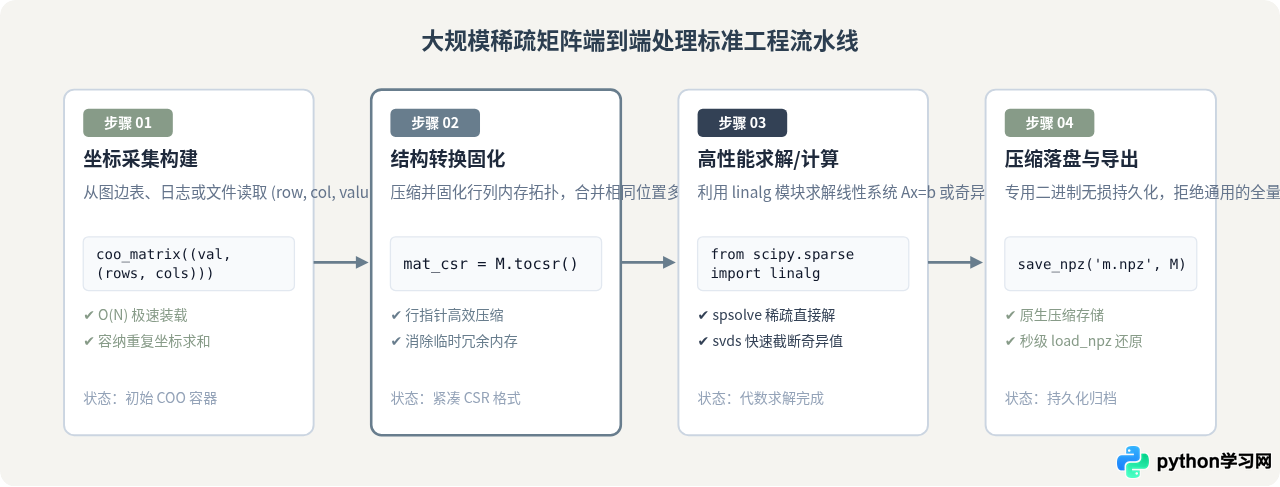
在统一构建 100 万条图边(非零项)的场景下,若直接向 CSR 矩阵逐个执行 A[u, v] = w,由于 CSR 底层采用连续数组存储指针,每次新增一个先前不存在的非零元素都会引发整块内存的重新申请与数组元素搬迁,时间复杂度将退化为 \(O(N^2)\),导致整个程序陷入假死。而采用 COO 方式,只需将 (u, v, w) 追加至普通的 Python 列表或 NumPy 数组中,构建耗时仅为 \(O(N)\)。构建完成后调用 tocsr() 仅需一次排序与压缩,耗时不到 0.1 秒。这种两阶段工作流是处理超大规模稀疏数据的核心准则。
三、构造稀疏矩阵的具体方法与代码示例
在实际编码中,创建稀疏矩阵主要有三种途径:通过三元组坐标直接构造、从 NumPy 稠密数组转换,以及利用内置生成函数构造特殊结构矩阵。
1. 通过坐标元组构造 COO 矩阵并固化为 CSR
这是最推荐的生产级构造方式。提供三个等长的一维数组:data(数值)、row(行索引)、col(列索引),并指定最终矩阵的尺寸 shape。
import numpy as np
from scipy import sparse

# 准备坐标数据:在 (0, 0), (0, 4), (1, 2), (2, 3) 处设置数值
row_indices = np.array([0, 0, 1, 2], dtype=np.int32)
col_indices = np.array([0, 4, 2, 3], dtype=np.int32)
values = np.array([10.5, 2.0, 5.0, 8.2], dtype=np.float64)

# 指定矩阵总维度为 3 行 5 列
# 注意:若未指定 shape,SciPy 会自动推断为 (max(row)+1, max(col)+1)
mat_coo = sparse.coo_matrix((values, (row_indices, col_indices)), shape=(3, 5))

# 转换格式为 CSR 用于后续运算
mat_csr = mat_coo.tocsr()

print("稀疏矩阵形状:", mat_csr.shape)
print("非零元素总数 (nnz):", mat_csr.nnz)
print("CSR 内部 data 数组:", mat_csr.data)
print("CSR 内部 indices 数组:", mat_csr.indices)
print("CSR 内部 indptr 数组:", mat_csr.indptr)
输出示例(标明内部存储数组):
稀疏矩阵形状: (3, 5)
非零元素总数 (nnz): 4
CSR 内部 data 数组: [10.5  2.   5.   8.2]
CSR 内部 indices 数组: [0 4 2 3]
CSR 内部 indptr 数组: [0 2 3 4]
2. 快速生成特殊结构矩阵
对于对角矩阵、单位矩阵或分块矩阵,无需手动组装坐标,scipy.sparse 提供了高效的内置构造工具:
# 1. 构造 10000x10000 的稀疏单位矩阵(直接返回 CSR 格式)
identity_sparse = sparse.eye(10000, format='csr')

# 2. 构造三对角矩阵(常用于微分方程离散化)
main_diag = np.full(5, -2.0)
off_diag = np.full(4, 1.0)
diagonals = [main_diag, off_diag, off_diag]
offsets = [0, 1, -1]  # 主对角线、上对角线、下对角线
tridiag_mat = sparse.diags(diagonals, offsets, shape=(5, 5), format='csr')

# 3. 构造随机分布的稀疏矩阵
# density=0.01 表示仅 1% 的位置填充非零随机数
random_sparse = sparse.random(1000, 1000, density=0.01, format='csr', random_state=42)
四、稀疏代数运算与高效切片
一旦稀疏矩阵转换为 CSR 或 CSC 格式,便可像操作常规矩阵一样执行标准数学运算,同时保持计算的高效性。
1. 算术运算与矩阵乘法
在 Python 3.5+ 中,使用 @ 符号可直接调用高度优化的稀疏矩阵乘法:
# 矩阵乘法 (SpMM / SpMV)
vector_x = np.ones((5, 1))

# 稀疏矩阵与稠密向量相乘:结果自动保持稠密一维/二维数组
res_vector = mat_csr @ vector_x

# 稀疏矩阵与稀疏矩阵相乘:结果自动返回新的 CSR 稀疏矩阵
mat_squared = mat_csr @ mat_csr.T

print("矩阵乘积格式:", type(mat_squared))
print("乘积非零元个数:", mat_squared.nnz)
2. 切片访问的性能差异
稀疏格式决定了切片的耗时级别:
mat_csr[i, :](提取第 i 行):直接通过indptr[i]与indptr[i+1]截取连续数组,复杂度为 \(O(1)\),速度极快。mat_csr[:, j](提取第 j 列):需要遍历所有行的非零元去匹配列索引,开销很大。如果必须频繁进行列切片,应提前调用mat_csc = mat_csr.tocsc()。
五、端到端工程实践流水线
在生产系统中,稀疏矩阵通常贯穿“数据抽取 -> 坐标聚合 -> 固化 CSR -> 线性求解 -> 压缩落盘”的完整链路。下图展示了这一标准处理流程:
流水线完整执行代码
from scipy import sparse
from scipy.sparse import linalg as sla
import numpy as np

# 步骤 1:构造大规模稀疏线性系统 Ax = b (模拟有限元离散或网络拉普拉斯矩阵)
n_dim = 100000  # 10万维矩阵

# 主对角线设为 4.0,上下相邻项设为 -1.0
main_val = np.full(n_dim, 4.0)
side_val = np.full(n_dim - 1, -1.0)

# 使用 diags 直接得到 CSR 格式
A_sparse = sparse.diags([main_val, side_val, side_val], [0, 1, -1], format='csr')

# 构造目标右端项向量 b
b_dense = np.ones((n_dim, 1), dtype=np.float64)

# 步骤 2:使用 scipy.sparse.linalg 快速求解稀疏线性方程 Ax = b
# 对于大型稀疏对称正定系统,使用共轭梯度法 (cg)
x_solution, exit_code = sla.cg(A_sparse, b_dense, atol=1e-8)

print("求解器退出状态 (0表示正常收敛):", exit_code)
print("解向量前 5 个分量:", x_solution[:5])

# 步骤 3:持久化存储
sparse.save_npz('laplacian_system.npz', A_sparse)
print("矩阵已成功持久化至 laplacian_system.npz")
六、生产环境常见陷阱与避坑指南
-
陷阱 1:在循环中直接向 CSR / CSC 赋值
常见错误写法形如for u, v in edges: A[u, v] = 1。这会导致SparseEfficiencyWarning报警,耗时随着数据增长呈现指数级爆炸。正确做法是永远先用rows.append(u); cols.append(v); data.append(1)收集,再调用coo_matrix一次性转换。 -
陷阱 2:不经意调用
.toarray()或.todense()
为了打印查看数据或喂给只支持 NumPy 的第三方模型,不少开发者习惯性写上mat.toarray()。如果矩阵维度是数万以上,这行代码会瞬间申请数十 GB 内存直接引发 OOM。打印前必须先切片限定视野,例如print(mat[:10, :10].toarray())。 -
陷阱 3:运算填充现象(Fill-in)导致稀疏性丧失
两个稀疏矩阵相乘,或者对稀疏矩阵进行直接求逆(如np.linalg.inv),求逆后的逆矩阵几乎 100% 会退化为稠密矩阵。面对线性系统求解,应始终使用scipy.sparse.linalg.spsolve或迭代法cg / gmres,而不是求出逆矩阵后再相乘。 -
陷阱 4:使用标准 pickle 序列化稀疏矩阵
虽然 pickle 支持序列化稀疏对象,但其序列化文件庞大且速度缓慢。SciPy 原生提供了scipy.sparse.save_npz和scipy.sparse.load_npz,底层基于紧凑压缩算法,速度更快且在跨版本时兼容性更优。
七、格式选型决策指南与总结
为了帮助在不同业务场景中做出精准选择,可参考如下决策树与对照表:
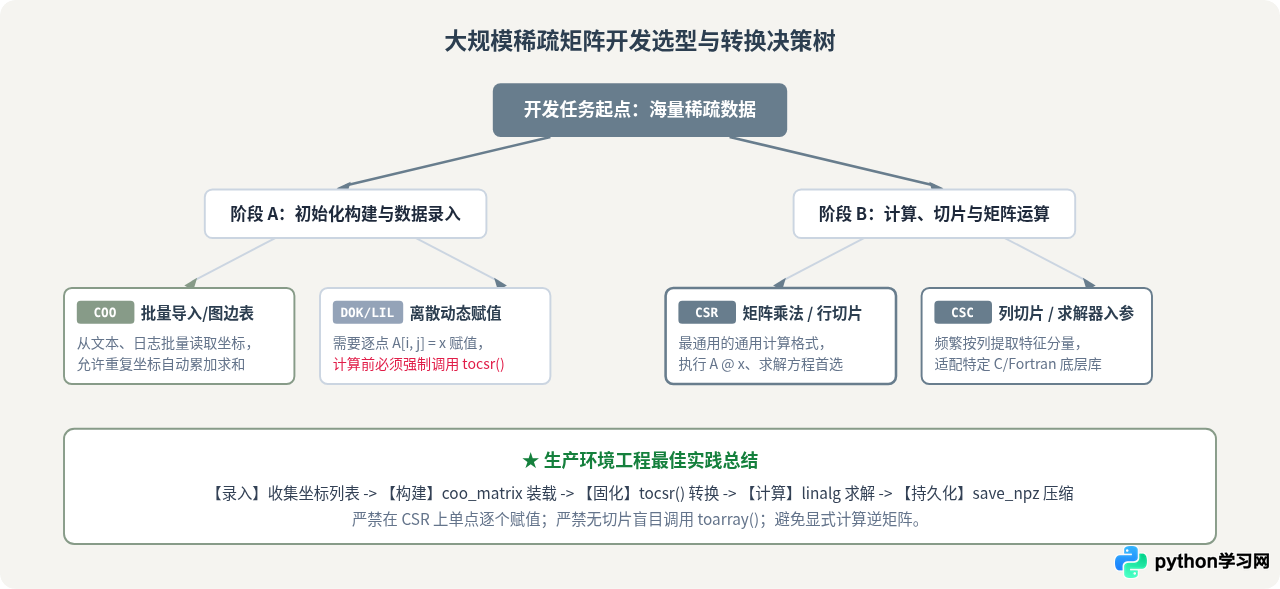
| 矩阵格式 | 初始化复杂度 | 行切片速度 | 列切片速度 | 矩阵向量乘法 (SpMV) | 推荐使用场景 |
|---|---|---|---|---|---|
| COO | \(O(1)\) / 极快 | 不支持 | 不支持 | 慢(需预先转换) | 初始数据构建、批量坐标导入 |
| CSR | 较慢(需排序) | \(O(1)\) / 极快 | 较慢 | 极快(行指针连续) | 代数运算、求解器、模型前向传播 |
| CSC | 较慢(需排序) | 较慢 | \(O(1)\) / 极快 | 较快 | 列特征提取、部分特定求解器输入 |
| DOK / LIL | 单点赋值快 | 中等 | 慢 | 慢 | 算法中逐点动态修改矩阵非零元结构 |
掌握 scipy.sparse 模块的精髓,核心在于理解不同稀疏格式所做出的时空取舍。通过将“动态构建”与“紧凑计算”明确划分为两个阶段,能够以最小的内存成本和极高的运行效率,轻松驾驭千万级维度的大规模科学计算任务。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









