

Python中Winsorize缩尾处理:空值与无效值的正确处理方法

本文记录Python中使用scipy.stats.mstats.winsorize进行数据缩尾处理时的常见陷阱。直接应用会导致空值被填充,介绍通过np.where、masked_invalid或布尔索引mask三种方式屏蔽空值与无效值的正确做法,并说明如何处理后续出现的负无穷值问题,确保缩尾后数据长度不变且空值保留。
Winsorize缩尾处理中的空值问题
在近期处理数据的过程中发现,若直接进行缩尾操作,原本为空值或无效值的位置会被填充上具体数值。传统研究通常先剔除空值再进行缩尾,但对于某些必须保留空值且需剔除极端值的数据集,直接省略缩尾并不可行。基于实际操作经验,现将几种处理方案整理如下:
Excel数据示例与直接应用的风险
以下以从Excel文件读取的数据为例进行说明:
from scipy.stats.mstats import winsorize
import pandas as pd
df = pd.read_excel('Excel.xlsx', engine='openpyxl', header=0)
df_list=["a","b","c"]#需要进行缩尾的列名
方案1:直接应用Winsorize函数,不区分空值和无效值。这种方式可能导致部分原本为空的数值被填充,从而改变数据结构。
for i in df_list():
    df[i]=winsorize(df[i],limits=[0.01, 0.01])#对指定列中的连续数据进行1%和99%的缩尾(Winsorize)处理
屏蔽空值与无效值的处理方案
方案2.1:通过屏蔽空值和无效值,仅对有效数值进行Winsorize处理。此方法能保持原有空值和无效值不变,但需注意其对数据长度的影响。
for i in df_list():
    df[i]=np.where(df[i].isnull(), np.nan, winsorize(np.ma.masked_invalid(df[i]),limits=(0.01,0.01)))
#np.where(condition, x, y),满足condition是x,否则y
#此处判断是否空值,是的话为空,否的话进行屏蔽空值和无效值的1%和99%缩尾处理
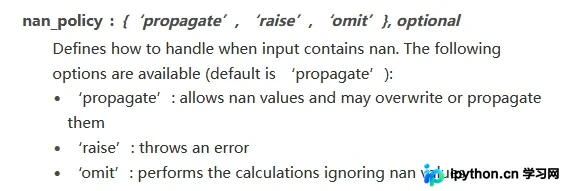
方案2.2:利用winsorize函数提供的nan_policy参数。尽管该方法在理论上可行,但作者在实际测试中未成功,此处仅供参考。
for i in df_list():
    df[i]=winsorize(df[i],limits=[0.01, 0.01], nan_policy='omit')
保持数据长度的缩尾方法
方案3:同样屏蔽空值和无效值,并对所有值进行Winsorize处理。与方案2的主要区别在于,方案3不会改变需要缩尾的数据长度,同时保持原有空值和无效值不变。
for i in df_list():
    mask = df[i].notna()
    df.loc[mask,i] = winsorize(df[i].loc[mask],limits=[0.01, 0.01])
    #这个mask就是一个bool index,指示哪些位置上是nan
    #比如一列数据是[1, NaN, 2],如果用df['A'].isnan()得到的就是一个[False, True, False]的数组
    #这个数组就是所谓的mask,它可以把dataframe中的特定数据挑出来
负无穷值的替换处理
在后续进行描述性统计时,若发现存在负无穷值(-np.Inf),需将其替换为空值(np.NaN)以消除影响。
#如果需要将无穷值换为空值
df=df.replace(-np.Inf,np.NaN)
在此特别感谢张老师、李老师和孙老师在过程中提供的耐心指导与参考建议。
参考资源如下:
1. Python中忽略NaN的Winsorize正确方法
2. numpy.ma.masked_invalid函数的具体用法
3. Python数据分析中的缩尾处理技巧
总结
本文介绍了Python中应用Winsorize缩尾处理的几种策略,重点解决了空值与无效值的处理难题。更多关于Python应用Winsorize缩尾的内容,欢迎查阅本站过往文章或继续浏览后续相关教程,感谢大家的支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









