

Python使用csv模块读取CSV文件表头的方法
详细讲解在Python中使用内置csv模块读取CSV文件表头的标准方法,包括csv.reader配合next()函数与csv.DictReader读取fieldnames属性的具体用法、BOM编码与空文件防御处理及技术选型对比。
在 Python 中读取 CSV 文件的表头,最直接且高效的方法是使用内置的 csv 模块。无需安装第三方库,通常有两种主要解决路径:一种是创建 csv.reader 对象后使用 Python 内置函数 next() 单独提取第一行,另一种是创建 csv.DictReader 对象直接读取其 fieldnames 属性。本文将具体讲解这两种方法的实现步骤、核心原理、常见边界陷阱以及选型建议。
一、使用 csv.reader 结合 next() 读取表头
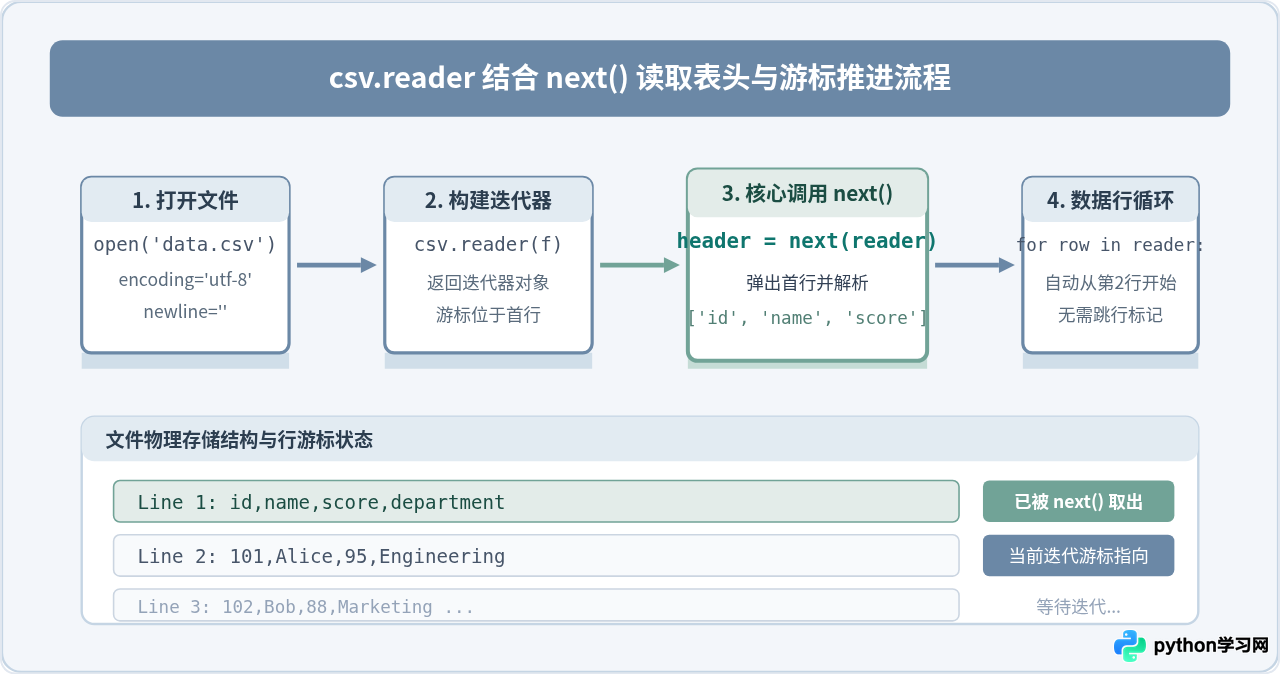
使用 csv.reader 是处理 CSV 最基础也最通用的方式。调用 csv.reader(file) 后,返回的是一个行迭代器。因为文件的首行通常是字段说明,所以直接对该迭代器调用 next() 即可获取表头列表。
1. 完整代码示例
import csv

# 打开CSV文件,注意声明 encoding 和 newline
with open('data.csv', mode='r', encoding='utf-8', newline='') as f:
    reader = csv.reader(f)

    # 获取表头列表
    header = next(reader)
    print("CSV表头内容:", header)

    # 此时迭代器指针已移动到第二行,可继续按行遍历实际数据
    for row in reader:
        print("数据行:", row)
2. 运行原理解释
csv.reader 遵循 Python 的迭代器协议。每次调用 next(reader),底层解析器就会读取文件的一行,并根据逗号(或其他指定的分隔符)将其拆解为字符串列表(list[str])。
当通过 next(reader) 弹出第一行后,文件读取指针与 reader 迭代器的游标已经同步前进到第二行。这意味着在后续的 for row in reader 循环中,遍历会自动从真实数据行开始,不需要额外编写 if index == 0: continue 之类的过滤逻辑。
二、使用 csv.DictReader 读取 fieldnames 属性
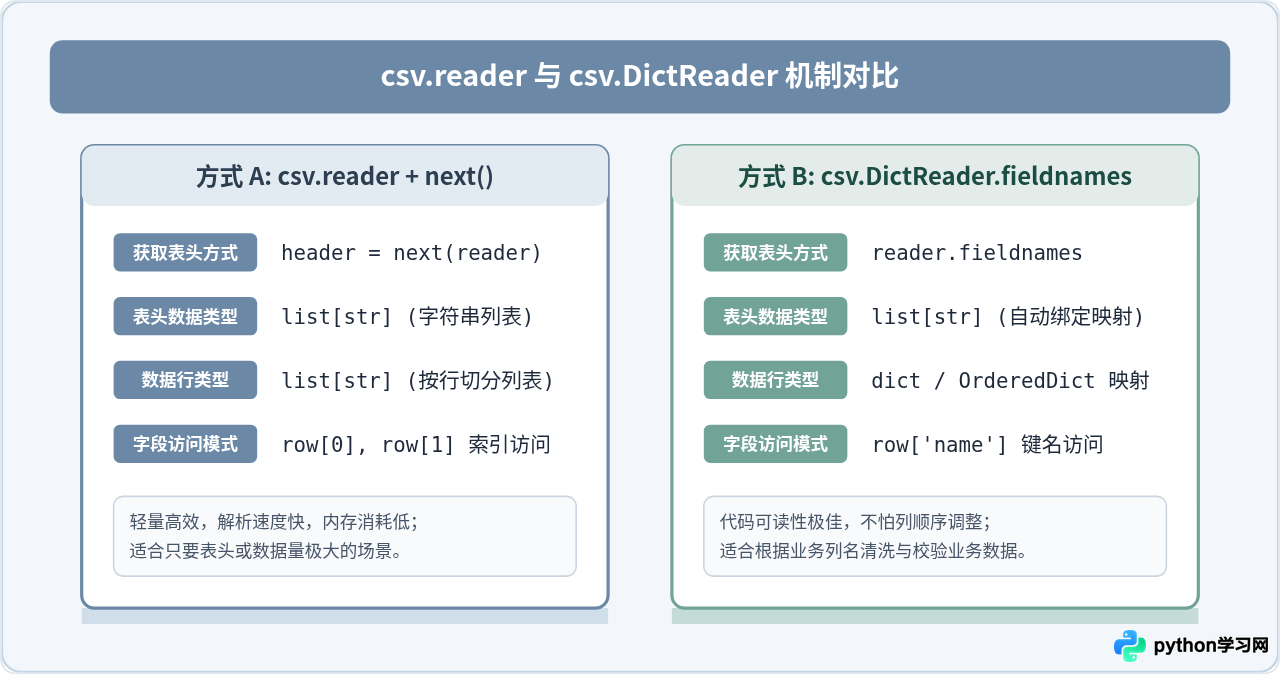
如果后续需要按列名而非数字索引处理数据行,推荐使用 csv.DictReader。DictReader 在内部将首行解析为字段映射标准,并将其作为列表保存在 fieldnames 属性中。
1. 完整代码示例
import csv

with open('data.csv', mode='r', encoding='utf-8', newline='') as f:
    dict_reader = csv.DictReader(f)

    # 直接通过 fieldnames 属性获取表头
    header = dict_reader.fieldnames
    print("通过 DictReader 获取的表头:", header)

    # 数据行会自动解析为以表头为 Key 的字典
    for row in dict_reader:
        print(f"姓名: {row['name']}, 分数: {row['score']}")
2. 原理解析与注意点
与普通 csv.reader 不同,csv.DictReader 不需要手动执行 next()。当其实例化时,如果没有显式指定 fieldnames 形参,它会自动从文件首行读取并生成字段列表。
注意:在 Python 3.8 及之后版本中,dict_reader.fieldnames 直接返回普通 list。如果在实例化 csv.DictReader(f, fieldnames=['col1', 'col2']) 时手动传入了自定义字段列表,那么原文件第一行会被当做普通数据行处理,而不是表头。
三、常见陷阱与防御性处理
在生产环境中读取 CSV 表头时,常会遇到空文件、特殊编码或格式不规则的情况。如果不做针对性防御,代码容易发生静默错误或直接崩溃。
1. 空文件导致 StopIteration 崩溃
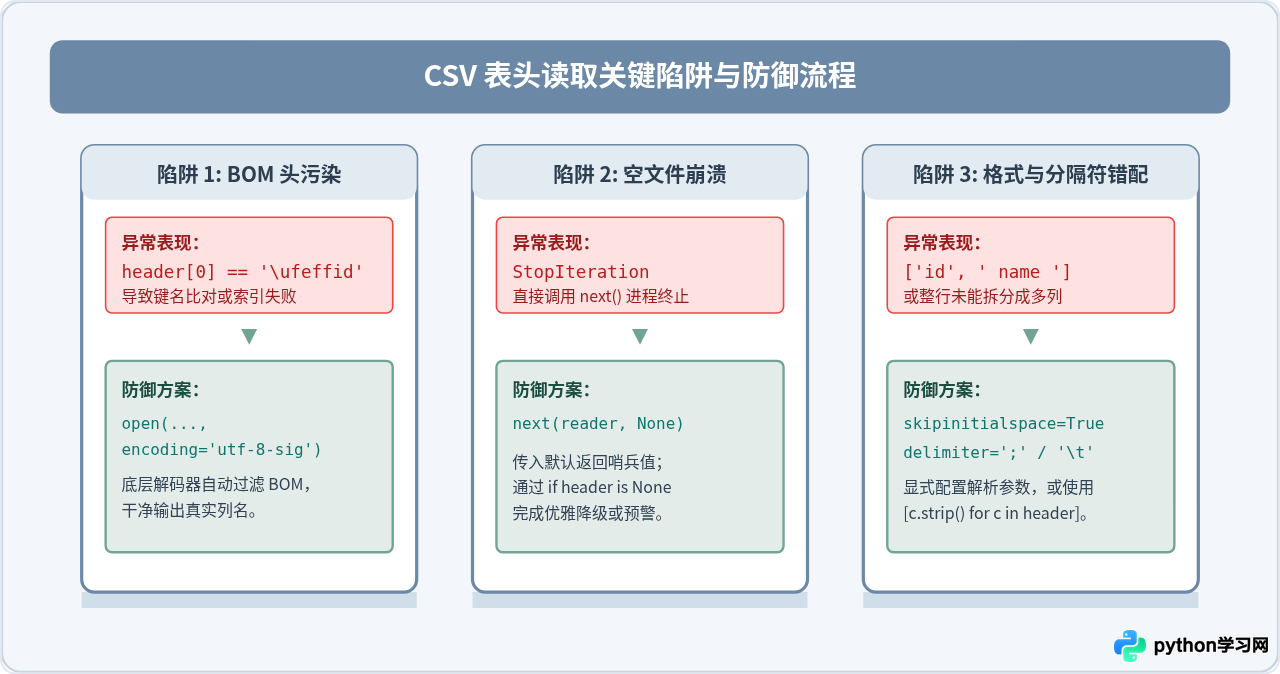
当 CSV 文件为 0 字节或仅有空换行时,直接调用 next(reader) 会抛出 StopIteration 异常。推荐传入 next() 的第二个参数作为默认容错值:
with open('empty.csv', mode='r', encoding='utf-8', newline='') as f:
    reader = csv.reader(f)
    # 提供默认值 None,文件为空时不抛出异常而是安全返回 None
    header = next(reader, None)
    if header is None:
        print("警告:文件为空,不存在有效表头!")
2. UTF-8 BOM 导致首个字段带有不可见字符(\ufeff)
使用 Windows Excel 创建或导出的 CSV 文件通常包含 UTF-8 BOM 头。如果使用标准的 encoding='utf-8' 打开,表头的第一个字段名会被污染为 '\ufeffid',导致 row['id'] 抛出 KeyError。
解决方案:在 open() 函数中指定 encoding='utf-8-sig',Python 会自动识别并移除开头的 BOM 标记。
3. 表头含有首尾空格或非标准分隔符
部分 CSV 字段之间包含格式化空格(如 id, name, score),默认会使字段名成为 ' name'。可以通过 skipinitialspace=True 或列表推导式去除空格:
# 方案一:在 reader 中开启 skipinitialspace
reader = csv.reader(f, skipinitialspace=True, delimiter=',')

# 方案二:手动清洗列表中的空格
clean_header = [col.strip() for col in header] if header else []
四、选型对比与综合总结
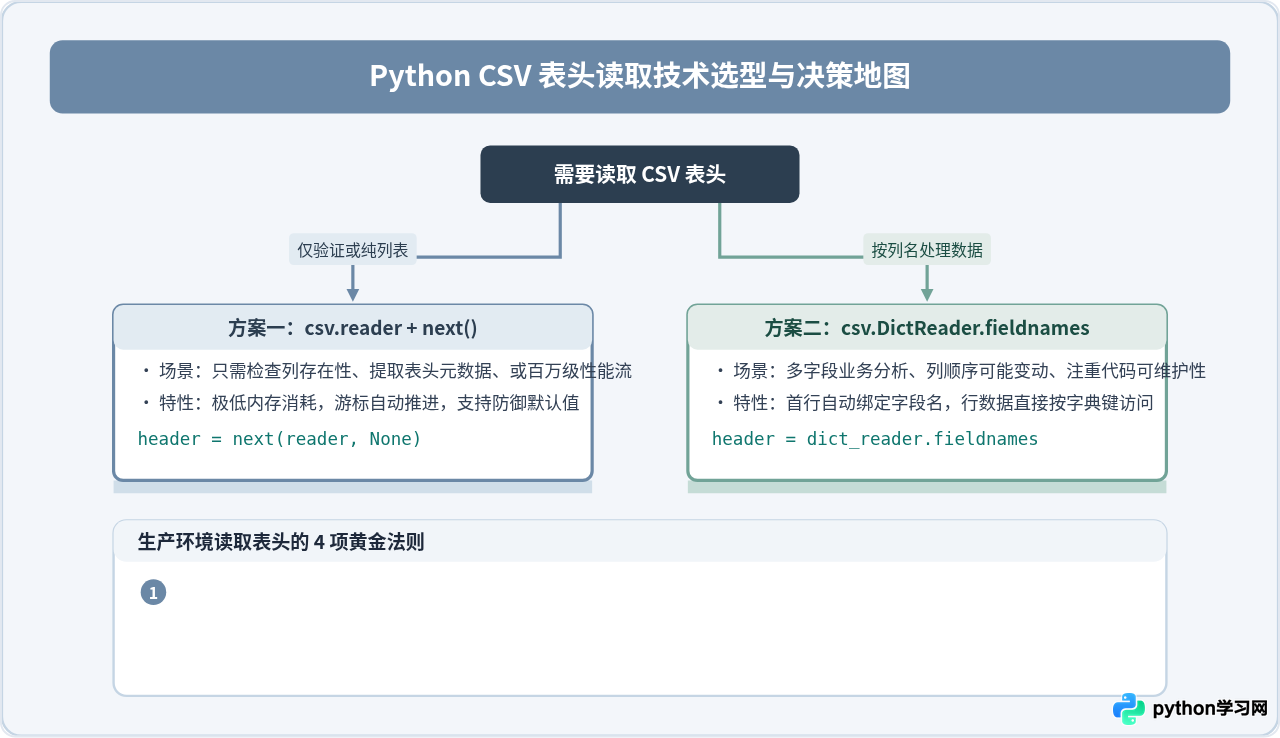
为了在实际开发中快速确定合适方案,可参考下表总结的对比维度:
| 对比维度 | csv.reader + next() | csv.DictReader.fieldnames |
|---|---|---|
| 表头获取方式 | header = next(reader, None) |
header = dict_reader.fieldnames |
| 后续遍历类型 | 列表(list[str]) |
字典(dict[str, str]) |
| 列变动鲁棒性 | 低(列位置改变时,原有 row[2] 易取错) |
高(按字段名称读取,不受列顺序变动影响) |
| 性能与内存开销 | 极低,纯元组/列表切分,适合超大规模数据 | 略高,每行都要封装字典映射对象 |
| 推荐场景 | 仅需校验表头、快速读取列名、大批量轻量流式处理 | 包含复杂业务字段、按列名处理数据的常规业务 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









