

Python将字典数据写入CSV文件的完整指南

本文详细介绍如何使用Python将字典列表写入CSV文件。通过解析csv模块的open参数(如'a'追加模式、newline和encoding),结合writeheader与writerows方法,实现自动化处理大量数据。示例展示了如何动态提取表头并保存为UTF-8编码的CSV,避免Excel打开时的乱码问题,适用于数据分析归档场景。
Python将字典数据写入CSV文件的完整指南
在数据分析的实际工作中,处理海量数据时通常需要将原始数据转换为Python对象,其中字典是最为常见的数据结构之一。
假设面对几十万条数据记录(尽管此类规模数据通常建议直接使用数据库,而非全部加载至CPU内存中),依靠Excel函数进行计算显然不切实际。Excel的优势在于处理小规模数据的便捷与快速,但对于大规模数据的解析、转换、分析及最终归档写入CSV文件的需求,则需要借助编程手段。接下来将演示如何将处理后的数据字典写入CSV文件。
将此项目与之前编写的成绩计算系统相关联,此前该系统将结果保存为包含字典内容的txt文件。现在的改进目标是将这份分析后的数据以CSV格式存储,以便归档并分享给其他人员查看。
定义写入函数与提取表头
首先,我们定义一个专门用于写入CSV文件的函数。
def csv_writer():
在函数内部,第一步是提取数据的键作为CSV的表头。这里使用遍历算法获取所有键。有人可能会问为何不手动输入,毕竟只有几行数据可以直接复制。但如果键的数量多达几十个,手动复制显然缺乏自动化。Python的价值正在于解决此类办公难题,将原本需要一小时的工作缩短至一分钟。
a=[]
  dict=student_infos[0]
  for headers in sorted(dict.keys()):#把字典的键取出来
    a.append(headers)
  header=a#把列名给提取出来,用列表形式呈现
此时,变量header是一个包含所有键名的列表。
文件打开参数详解
接下来打开文件准备写入,下面对open函数的参数进行逐一解释。
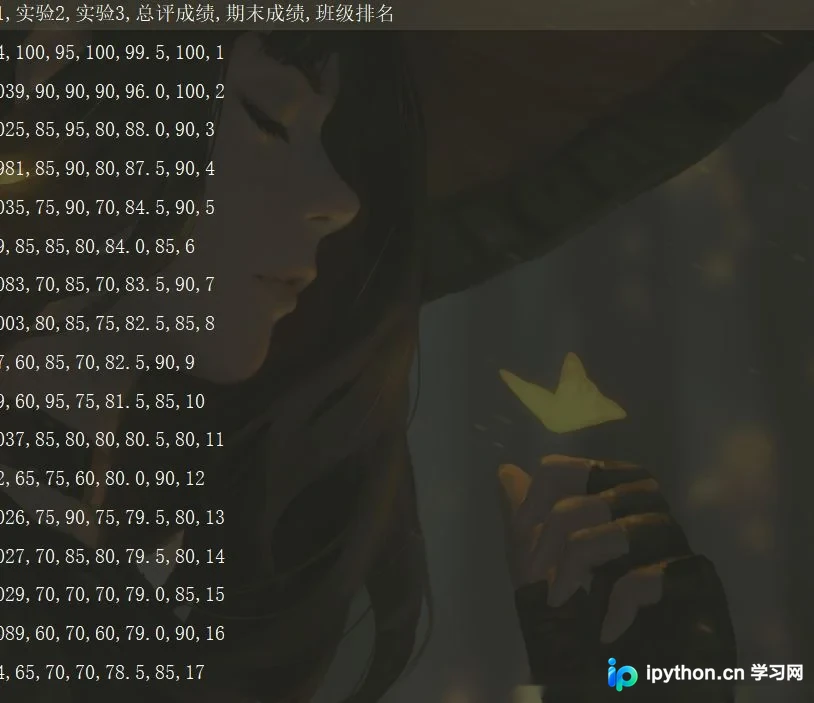
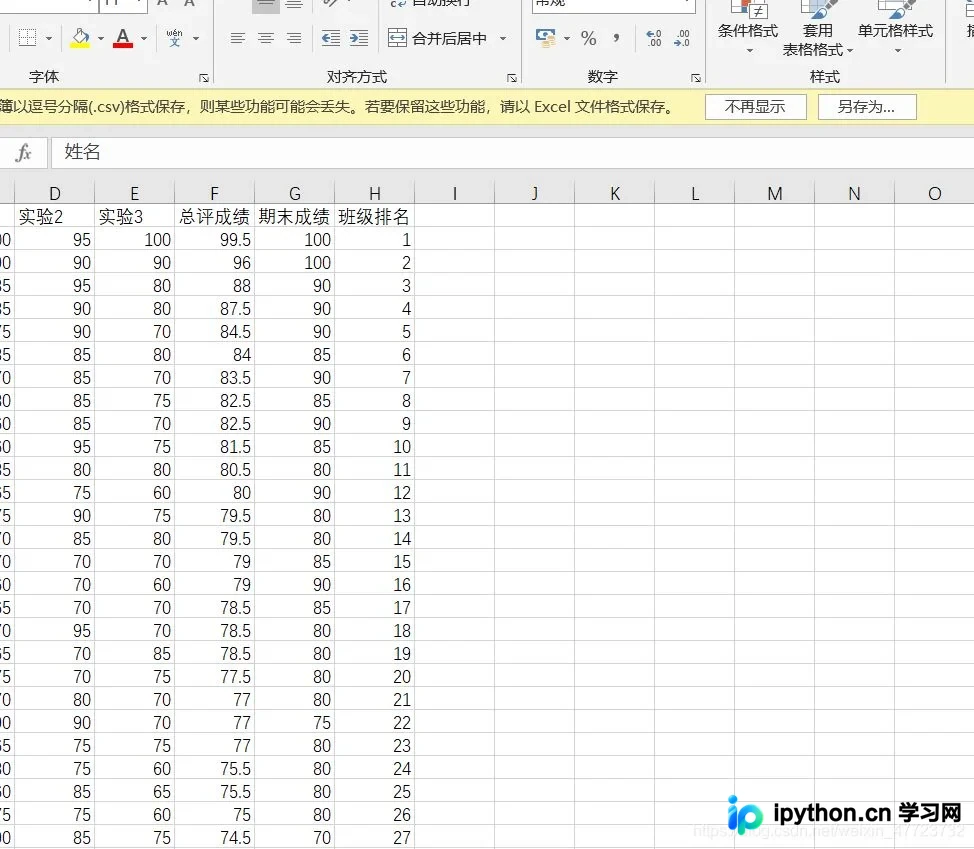
参数'a'表示以追加模式写入,若使用'w'则会在写入前清空原文件内容。参数newline=''确保数据行之间不插入额外的空行。encoding='utf-8'指定编码格式为UTF-8,若不希望Excel打开CSV文件时出现中文乱码,建议保留此参数。虽然PyCharm中查看CSV文件可能涉及编码兼容性问题,但Excel默认使用GBK编码,两者不兼容,因此加上encoding='utf-8'是推荐做法。若仍出现乱码,可尝试用记事本打开CSV文件并另存为ANSI格式。
with open('成绩更新.csv', 'a', newline='', encoding='utf-8') as f:
    writer = csv.DictWriter(f, fieldnames=header) # 提前预览列名,当下面代码写入数据时,会将其一一对应。
    writer.writeheader() # 写入列名
    writer.writerows(student_infos) # 写入数据
  print("数据已经写入成功!!!")
执行写入操作
这里的字典数据是之前已在内存中解析处理好的结果。最后一行代码直接使用writerows()方法写入字典列表,表头则通过writeheader()方法写入。
整个过程非常简洁,有效解决了繁琐的手动操作问题。
至此,关于Python将字典写入CSV文件的方法示例介绍完毕。如需了解更多Python字典与CSV相关的内容,可搜索本站往期文章或继续浏览后续文章,感谢支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









